Um analista testa uma variável para prever o Ibovespa e não encontra nada. Testa outra, e outra. Na vigésima, aparece uma relação com p-valor abaixo de 0,05, e o resultado vira descoberta. Neste artigo mostramos quanta "descoberta" uma busca assim produz quando nenhuma das variáveis tem relação com o alvo.
O p-valor de um teste é a probabilidade de observar um resultado tão extremo quanto o obtido, supondo que não exista relação alguma. Adotar o corte de 5% significa aceitar, de antemão, errar em 5% das vezes.
Esse risco é de cada teste tomado isoladamente. Quando se repete o teste muitas vezes e se reporta apenas o melhor resultado, o risco real passa a ser outro.
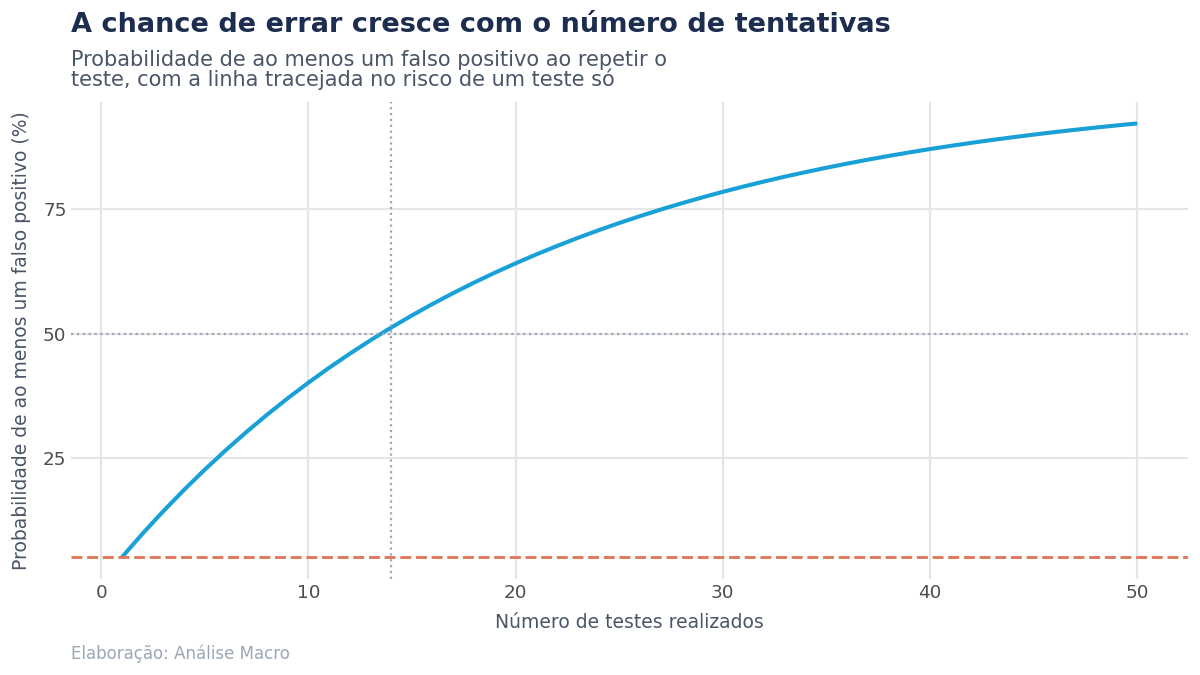
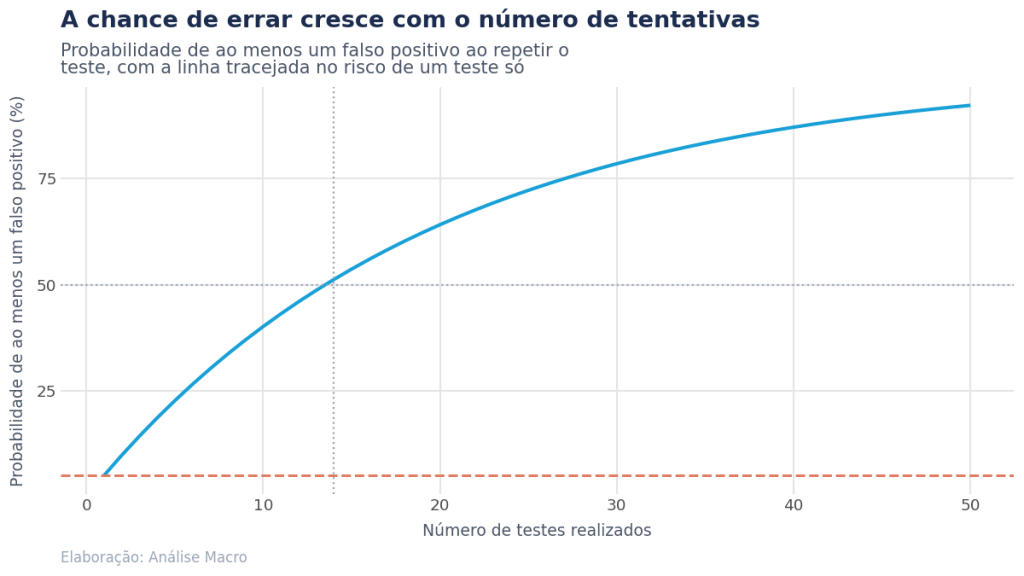
A linha tracejada marca os 5% de risco de um teste isolado, que é o valor em que a maioria das pessoas pensa ao ver um p-valor. A curva mostra o risco de quem faz vários testes e reporta o melhor.
📩 O modelo continua valendo. O que mudou é a velocidade
Quem já sabe econometria tem a parte difícil resolvida: saber qual pergunta fazer e como checar se a resposta faz sentido. No Boletim AM eu mostro, todo dia, como a IA entra nesse trabalho, sem substituir o julgamento de quem entende o modelo.
Todo dia no seu e-mail. Gratuito, e sai num clique.
A aritmética da repetição
Se cada teste tem probabilidade α de dar falso positivo, e os testes são independentes, a probabilidade de nenhum deles acusar nada é (1−α) elevado ao número de testes. A chance de ao menos um acusar é o complemento disso.
Aqui α é o corte de significância adotado em cada teste, e m é o número de testes realizados.
Com α de 5%, bastam catorze testes para a chance de pelo menos um falso positivo passar de metade. Com vinte, ela fica perto de dois terços.
Essa quantidade é a taxa de erro por família: a probabilidade de cometer ao menos um erro no conjunto de testes, ou seja, de acusar relação onde não existe nenhuma. Ela cresce com o número de tentativas, enquanto o risco de cada teste individual permanece em 5%.
O garimpo na série do Ibovespa
A curva descreve a teoria. O exercício reproduz a busca sobre a série mensal do Ibovespa, com candidatas que são números aleatórios, sorteados sem nenhuma relação com o mercado.
Sabemos de antemão que a relação verdadeira de cada candidata com o retorno é zero. Qualquer resultado significante que apareça é falso positivo.
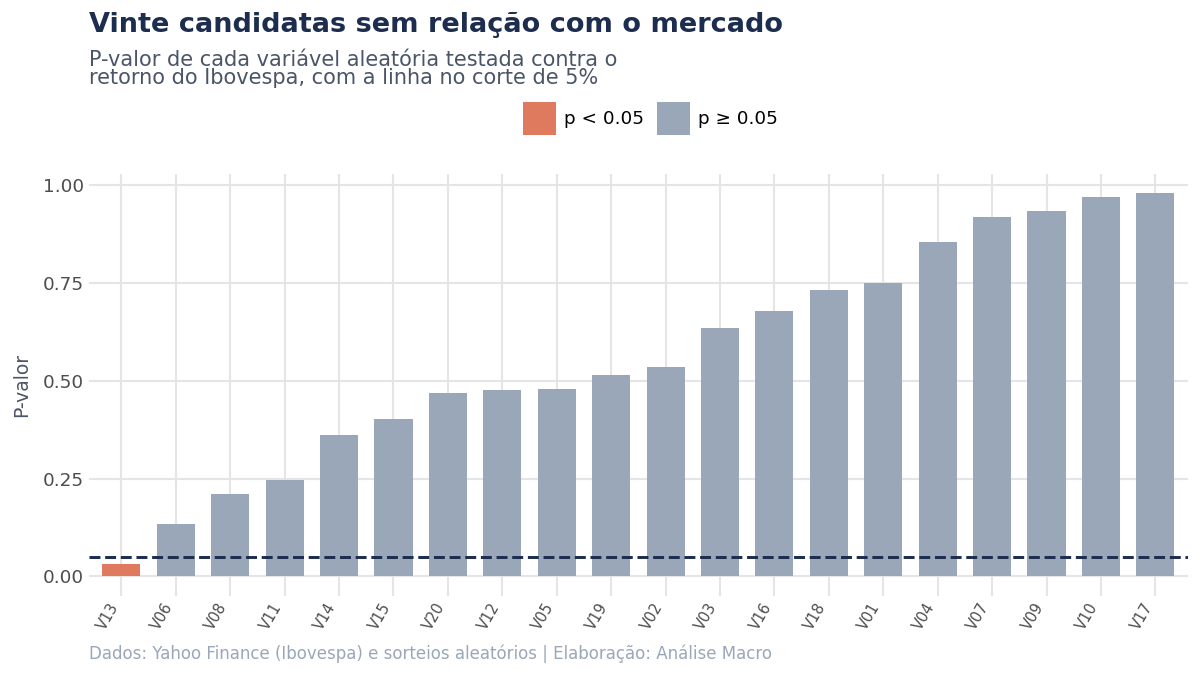
As barras cinza ficam acima da linha de corte, que é o esperado para variáveis sem relação com o alvo. A barra em destaque passou pelo corte e seria reportada como achado.
A diferença entre as duas situações não é de qualidade da variável, porque todas foram geradas pelo mesmo processo. A diferença é sorte no sorteio.
Repetir a busca inteira
Uma execução pode ter sido azarada ou sortuda. Para medir a frequência com que a busca produz um falso positivo, o exercício repete o garimpo completo milhares de vezes e conta.
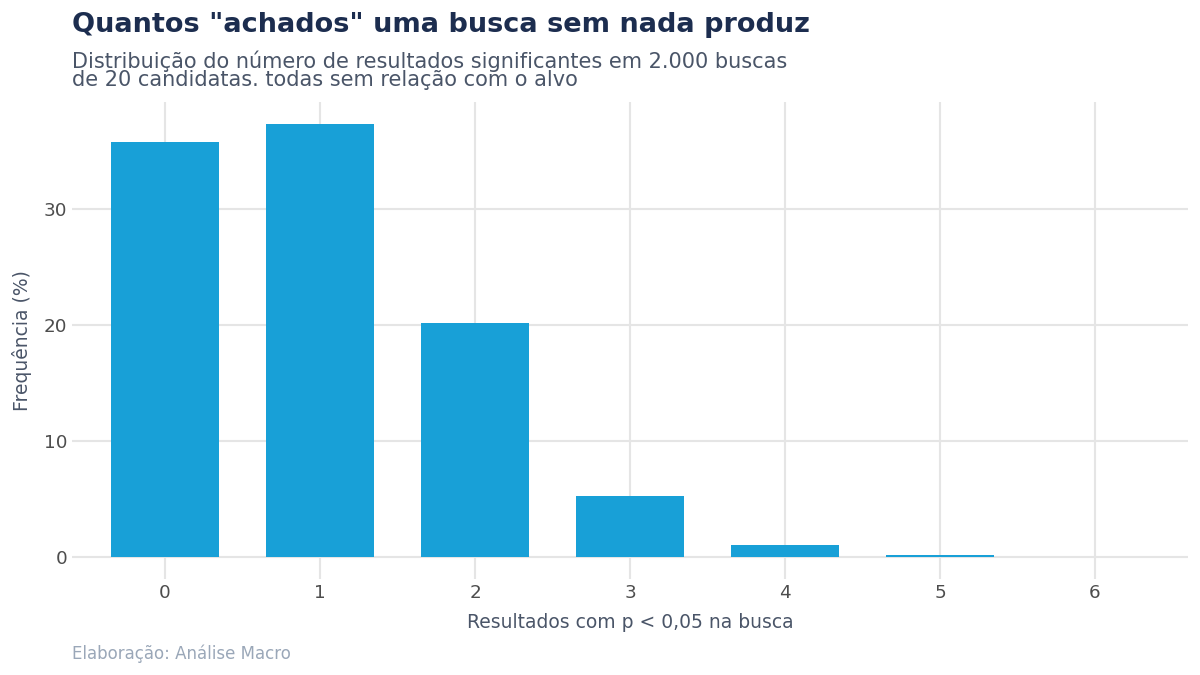
A barra da esquerda reúne as buscas que não produziram nada, e é minoria. A maior parte devolve ao menos um resultado significante, e uma fração relevante devolve dois ou mais.
A frequência observada na simulação coincide com o valor previsto pela fórmula, que parte apenas do corte de 5% e do número de testes. A média de achados por busca também bate com o esperado.
Quem publica apenas o melhor resultado de uma busca dessas está publicando a cauda favorável de um sorteio, com a aparência de uma estimativa única.
A correção pelo número de testes
O conserto estatístico é ajustar o corte ao número de testes realizados. A correção mais simples é a de Bonferroni, que divide o nível de significância pelo número de testes.
A ideia é distribuir o risco total de 5% entre as m tentativas, de modo que a taxa de erro por família volte ao patamar pretendido.
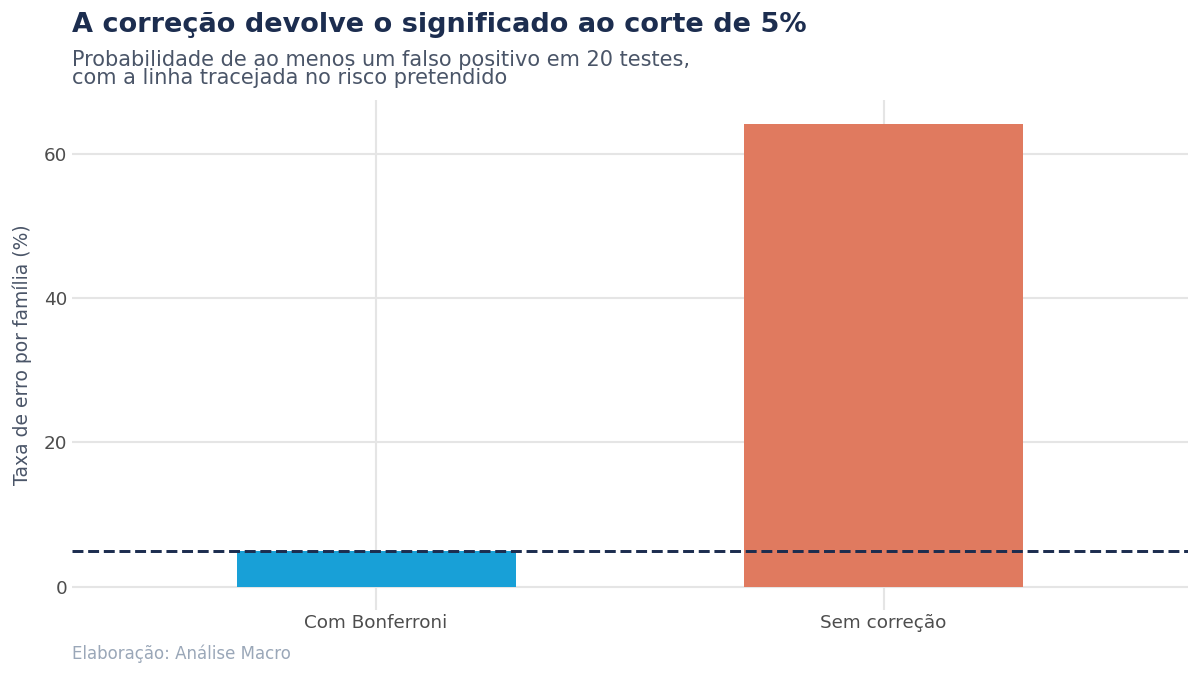
No exercício, o achado que havia passado no corte original desaparece com o corte corrigido, que é o resultado correto para uma variável sem relação com o alvo.
A contrapartida é perder sensibilidade. Um corte muito exigente aumenta a chance de descartar uma relação existente, e esse custo cresce com o número de testes.
Bonferroni é a correção mais conservadora e a mais fácil de aplicar. Quando o número de testes é grande, procedimentos como o de Benjamini-Hochberg controlam a proporção de falsas descobertas entre as rejeições, e costumam ser preferíveis.
Os limites do que o exercício mostra
Há ainda um ponto sobre intenção. O p-hacking nem sempre é deliberado: testar várias especificações e ficar com a que funcionou é um procedimento natural de quem explora dados. O problema aparece ao reportar o resultado final como se fosse o primeiro teste.
O roteiro para não publicar ruído
| Passo | O que fazer |
|---|---|
| 1 | Registre quantas especificações foram testadas, incluindo as descartadas. |
| 2 | Reporte o número de tentativas junto com o p-valor da vencedora. |
| 3 | Corrija o corte pelo número de testes, por Bonferroni ou por Benjamini-Hochberg. |
| 4 | Separe uma parte dos dados antes da busca e só use no fim. |
| 5 | Se o achado não sobreviver fora da amostra, trate-o como ruído. |
O quarto passo distingue uma descoberta de um garimpo. As correções estatísticas ajustam o corte, e só o teste em dados que não participaram da escolha da especificação confirma o achado.
Considerações finais
A crise de replicação em várias áreas da ciência tem nesse mecanismo uma de suas causas documentadas. Em finanças, o problema aparece na longa lista de fatores de risco publicados que não se sustentam fora da amostra original.
Fazer a verificação em Python é barato: a correção cabe numa linha, e separar dados de teste antes da busca é uma decisão de organização, não de técnica.
- Analista de dados: testa dezenas de segmentações num teste A/B e corrige o corte antes de declarar que um segmento respondeu melhor.
- Economista: reporta quantas especificações foram estimadas antes da que entrou no texto final.
- Gestor de risco: desconfia de fator de risco descoberto por varredura e exige validação fora da amostra.
- Trader: reserva um período de dados que não participa da otimização da estratégia.
- Pesquisador: registra as hipóteses antes de olhar os dados, o que torna a contagem de testes verificável.
Em todos os casos a defesa é a mesma: contar as tentativas e guardar dados que a busca não viu.
Você viu o problema; aprenda a inferência que resiste
De estatística descritiva a testes de hipótese e regressão, com Python aplicado a dados econômicos reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
BENJAMINI, Y.; HOCHBERG, Y. Controlling the False Discovery Rate: A Practical and Powerful Approach to Multiple Testing. Journal of the Royal Statistical Society: Series B, v. 57, n. 1, p. 289-300, 1995.
HARVEY, C. R.; LIU, Y.; ZHU, H. ... and the Cross-Section of Expected Returns. The Review of Financial Studies, v. 29, n. 1, p. 5-68, 2016.
IOANNIDIS, J. P. A. Why Most Published Research Findings Are False. PLoS Medicine, v. 2, n. 8, e124, 2005.
LEAMER, E. E. Let's Take the Con Out of Econometrics. The American Economic Review, v. 73, n. 1, p. 31-43, 1983.
SIMMONS, J. P.; NELSON, L. D.; SIMONSOHN, U. False-Positive Psychology. Psychological Science, v. 22, n. 11, p. 1359-1366, 2011.
Leia também: Viés de sobrevivência e censura na amostra