Um teste A/B é um experimento que compara duas ou mais versões de algo, sorteando quem recebe cada uma. O sorteio é o que diferencia esse método de uma comparação qualquer: ele permite atribuir a diferença observada à versão testada, e não às características de quem a recebeu.
Neste artigo vemos por que a aleatorização resolve o problema de identificação, como conduzir a análise quando há mais de duas versões, e o que fazer quando o teste não aponta um vencedor. O exemplo usa dados de uma campanha de marketing real, em R.
Por que o sorteio muda tudo
Uma rede que oferece promoção e compara as vendas das lojas que aderiram com as que não aderiram mistura dois efeitos na mesma conta: o da promoção e o do perfil das lojas que decidiram participar.
Lojas em regiões movimentadas talvez adiram mais, e já venderiam mais de qualquer forma. Esse é o problema de seleção, e é o mesmo que impede concluir causa a partir de correlação em dados observacionais.
O sorteio elimina esse problema por construção. Quando a versão é atribuída ao acaso, os grupos ficam parecidos em tudo que não seja o tratamento, tanto no que conseguimos medir quanto no que não conseguimos. Qualquer diferença sistemática nos resultados passa a ter uma explicação só.
Os dados: três promoções em 137 lojas
A rede testou três promoções diferentes. Cada loja recebeu uma delas por sorteio, e as vendas foram acompanhadas por quatro semanas, totalizando 548 observações de venda semanal.
library(dplyr)   # manipulação de dados
library(readr)   # leitura de arquivos CSV

wa_mkt <- read_csv("WA_Marketing-Campaign.csv") |>
  mutate(Promotion = as.factor(Promotion))   # a promoção é categórica, não número

wa_mkt |>
  group_by(Promotion) |>                     # separa por promoção
  summarise(
    n       = n(),                           # quantas observações
    media   = mean(SalesInThousands),        # a venda semanal média
    dp      = sd(SalesInThousands),          # o desvio padrão
    mediana = median(SalesInThousands)       # a venda mediana
)| Promoção | Observações | Venda média | Desvio padrão | Mediana |
|---|---|---|---|---|
| 1 | 172 | 58,10 | 16,55 | 55,38 |
| 2 | 188 | 47,33 | 15,11 | 45,36 |
| 3 | 188 | 55,36 | 16,76 | 51,16 |
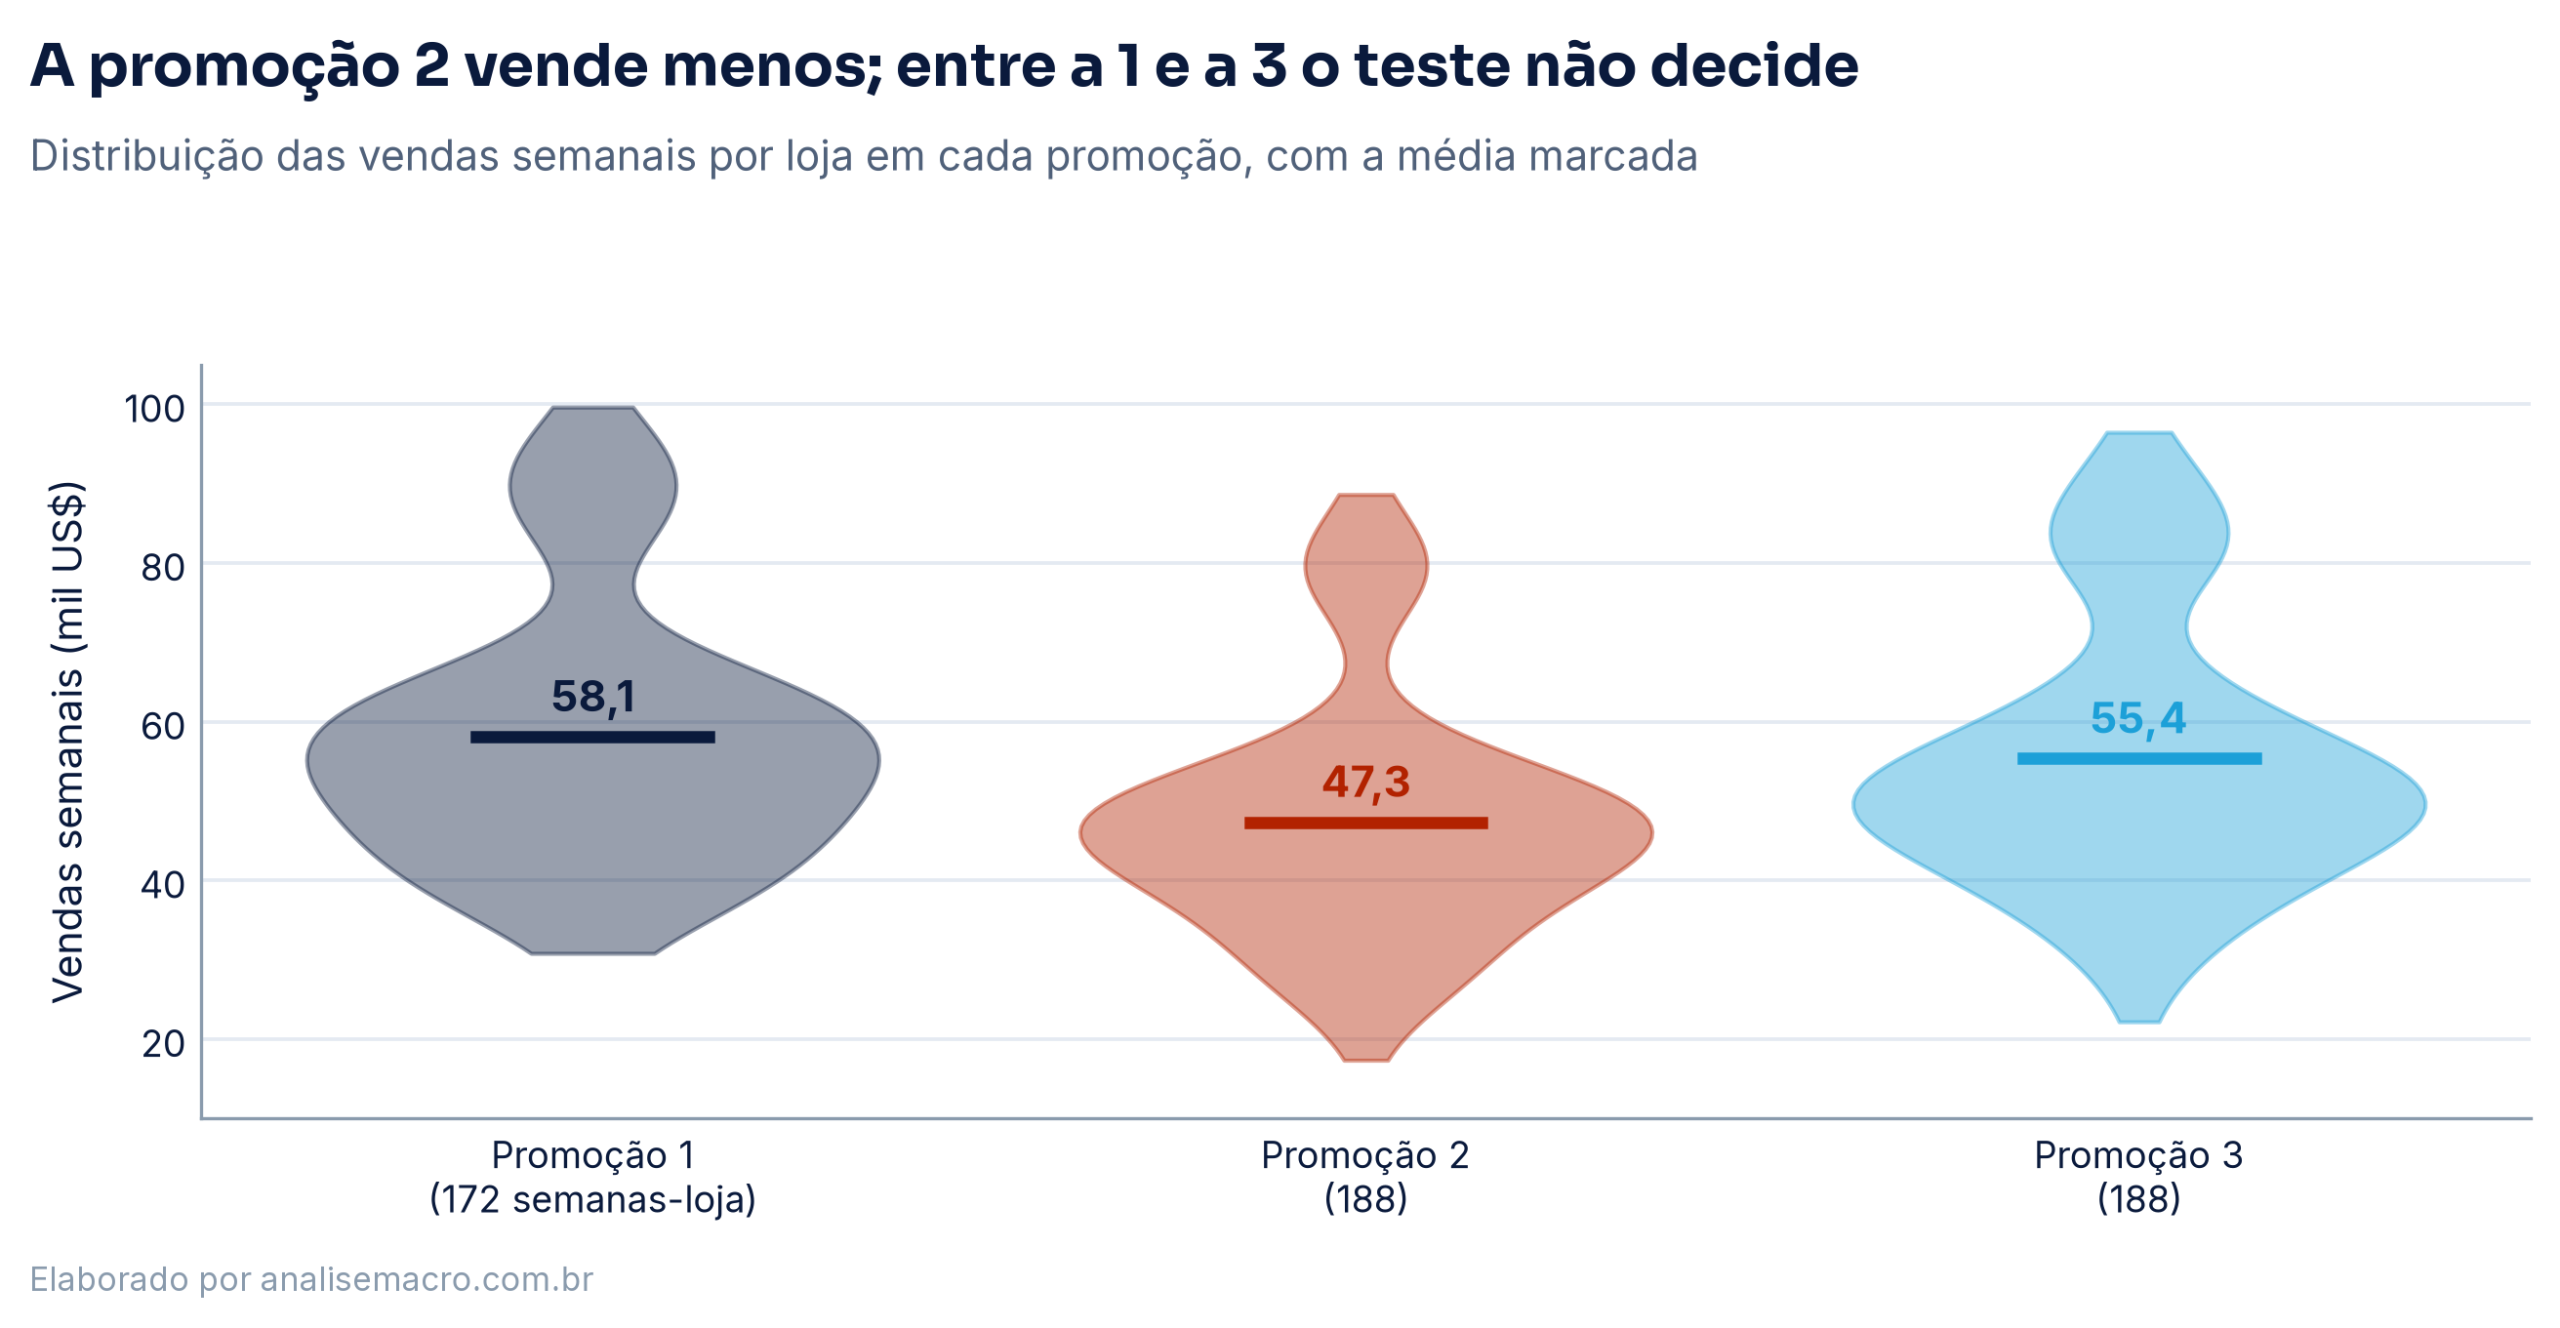
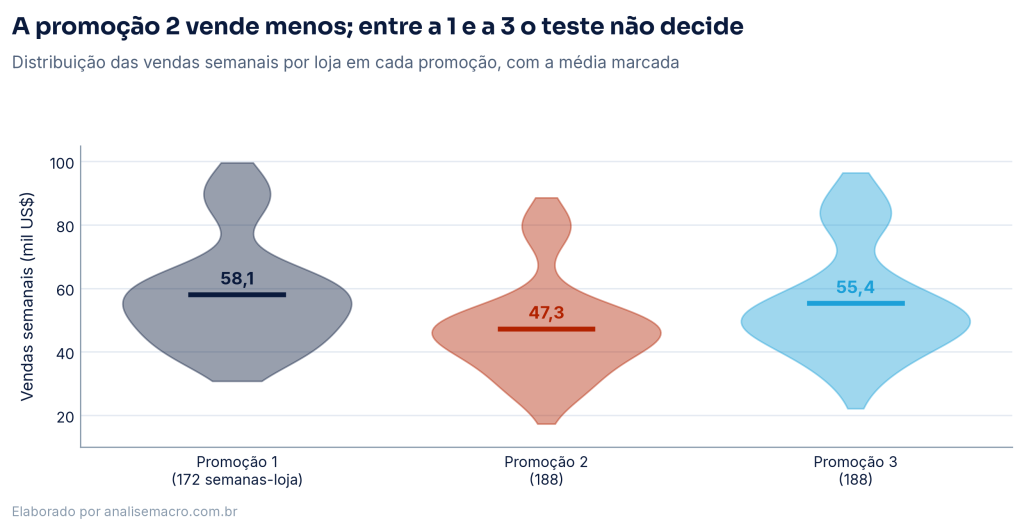
A promoção 1 lidera com 58,10 mil dólares semanais, seguida pela 3 com 55,36 e pela 2 com 47,33. Mas as distribuições se sobrepõem bastante, e a pergunta é quais dessas diferenças resistem à variação natural entre lojas e semanas.
📩 Acompanhe nossas análises
O Boletim AM traz análises de conjuntura, exercícios em R e Python e material de estudo, direto no seu e-mail.
A ANOVA pergunta se existe alguma diferença
Com três grupos, comparar todos os pares de uma vez aumenta a chance de encontrar uma diferença por acaso. A análise de variância, ou ANOVA, contorna isso fazendo uma pergunta única: existe alguma diferença entre as promoções?
O método compara a variação entre os grupos com a variação dentro de cada grupo. Quando a primeira supera a segunda por margem suficiente, concluímos que os grupos se distinguem.
modelo <- aov(SalesInThousands ~ Promotion, data = wa_mkt)   # ajusta a ANOVA

summary(modelo)   # estatística F e valor-p
A estatística F é de 21,95, com valor-p de 6,8 × 10⁻¹⁰. A variação entre as promoções supera com folga a variação interna de cada uma, então ao menos uma delas difere das outras.
O que a ANOVA não diz é qual. Para isso, precisamos comparar os pares.
O teste de Tukey compara os pares
O teste de Tukey examina cada par de promoções e corrige o nível de significância pelo número de comparações. Sem essa correção, testar três pares a 5% cada eleva o risco conjunto de falso positivo para cerca de 14%.
TukeyHSD(modelo) # diferença, intervalo de confiança e valor-p de cada par| Comparação | Diferença | Intervalo de 95% | Valor-p |
|---|---|---|---|
| Promoção 2 − Promoção 1 | −10,77 | [−14,77 ; −6,77] | < 0,001 |
| Promoção 3 − Promoção 1 | −2,73 | [−6,74 ; +1,27] | 0,244 |
| Promoção 3 − Promoção 2 | +8,04 | [+4,12 ; +11,95] | < 0,001 |
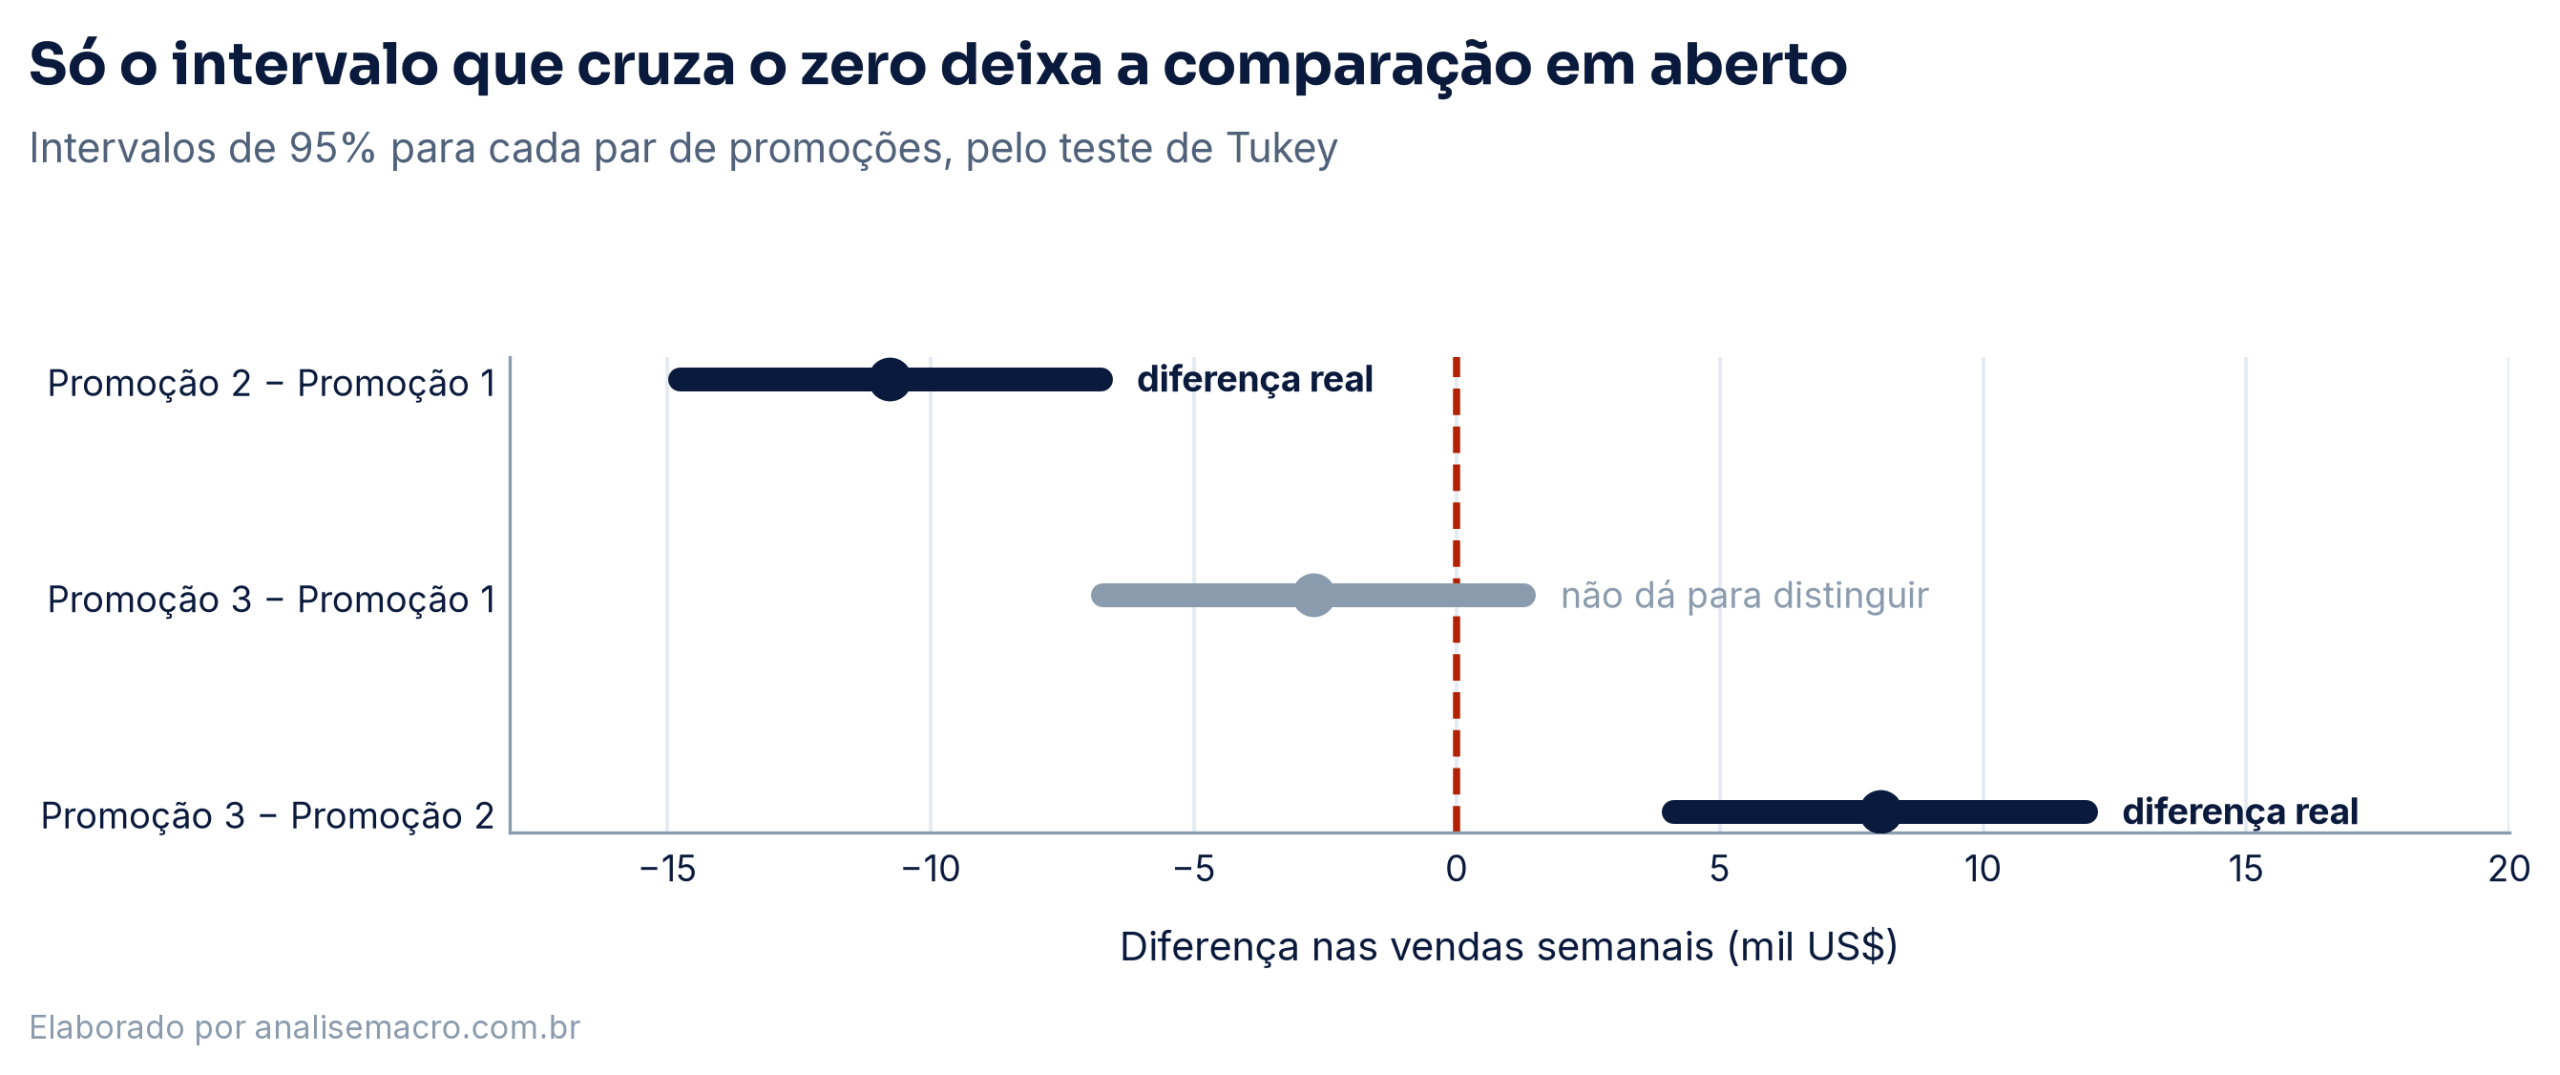
Duas conclusões se sustentam. A promoção 2 vende menos que as outras duas, com diferenças de 10,8 e 8,0 mil dólares semanais. E as promoções 1 e 3 não se distinguem: o intervalo da diferença vai de −6,74 a +1,27, incluindo o zero.
Quando o teste não elege um vencedor
O experimento identificou a pior opção com segurança, e deixou as duas melhores empatadas. Esse resultado parcial é comum, e a leitura correta depende de entender por que ele acontece.
A diferença entre as promoções 1 e 3 é de 2,73 mil dólares, menor que a variação entre lojas dentro de cada grupo. Com 137 lojas e quatro semanas, o experimento não tem precisão para separar um efeito desse tamanho do ruído.
Três caminhos se abrem a partir daí. Aumentar a amostra, se a diferença de 2,73 justificar o custo de um experimento maior. Escolher entre 1 e 3 por outro critério, como custo de execução. Ou tratar as duas como equivalentes, que é o que os dados sustentam.
O que o resultado não autoriza é anunciar a promoção 1 como vencedora porque ficou na frente. Essa diferença não se distingue do acaso nesta amostra.
O que pode invalidar o teste
A aleatorização precisa funcionar. Conferimos se as características observáveis ficaram equilibradas entre os grupos: porte das lojas, idade, região. Desequilíbrio grande sugere falha no sorteio.
O tamanho da amostra deve ser definido antes de olhar os resultados. Interromper o teste assim que a diferença fica significativa infla o falso positivo, prática conhecida como peeking.
O período precisa cobrir a sazonalidade relevante. Quatro semanas captam variação entre semanas do mês, mas não diferenças entre meses ou entre épocas do ano.
Resta um ponto sobre a leitura do resultado. Uma diferença de 0,5 mil dólares pode alcançar significância estatística numa amostra enorme e ainda assim não cobrir o custo de implantar a mudança.
Onde o teste A/B é usado
Em produto digital, duas versões de uma tela são sorteadas entre os usuários, e a métrica de conversão decide qual fica.
Em varejo, lojas recebem layouts ou promoções diferentes por sorteio, como no exemplo deste artigo.
Em crédito, uma política de concessão nova é aplicada a uma parcela sorteada da carteira antes de valer para todos, o que limita o risco da mudança.
Em políticas públicas, programas-piloto com atribuição aleatória medem o efeito antes da expansão, e é o desenho por trás de boa parte da avaliação de impacto moderna.
Considerações finais
Percorremos o teste A/B completo: a aleatorização que permite falar em causa, a ANOVA que detecta se existe diferença, e o teste de Tukey que identifica entre quais grupos ela está.
No nosso exemplo, o experimento descartou a promoção 2 com segurança e deixou as promoções 1 e 3 empatadas. Reconhecer esse empate é parte da análise, e não uma falha dela.
Conduzir experimentos muda o trabalho conforme a área:
- Profissional de produto: decide por evidência em vez de opinião sobre o comportamento do usuário.
- Analista de marketing: mede o efeito da campanha separado do perfil de quem a recebeu.
- Cientista de dados: dimensiona a amostra antes de rodar o teste, pela diferença mínima que importa detectar.
- Economista: aplica o mesmo desenho em avaliação de impacto de políticas.
- Gestor: pergunta se o teste tinha poder suficiente antes de aceitar um resultado nulo como ausência de efeito.
Do experimento à análise de impacto
Rodar um teste A/B é o primeiro passo; medir efeito quando o sorteio é inviável exige outros métodos. O AM Black é a assinatura anual que dá acesso a todos os cursos da Análise Macro, em R e em Python, da estatística básica à econometria aplicada.