
Uma regressão pode explicar quase toda a variação da variável dependente e, ao mesmo tempo, devolver coeficientes que não conseguimos interpretar. Basta acrescentar uma variável para que o coeficiente de outra diminua, tenha o erro-padrão inflado ou mude de sinal. Neste exercício, vamos ver de onde vem essa instabilidade e como medi-la antes de interpretar qualquer coeficiente.
Essa instabilidade aparece quando há multicolinearidade, ou seja, quando uma variável explicativa pode ser aproximada por uma combinação das demais variáveis explicativas do modelo. Nesse caso, os dados trazem pouca informação para distinguir o efeito de cada variável.
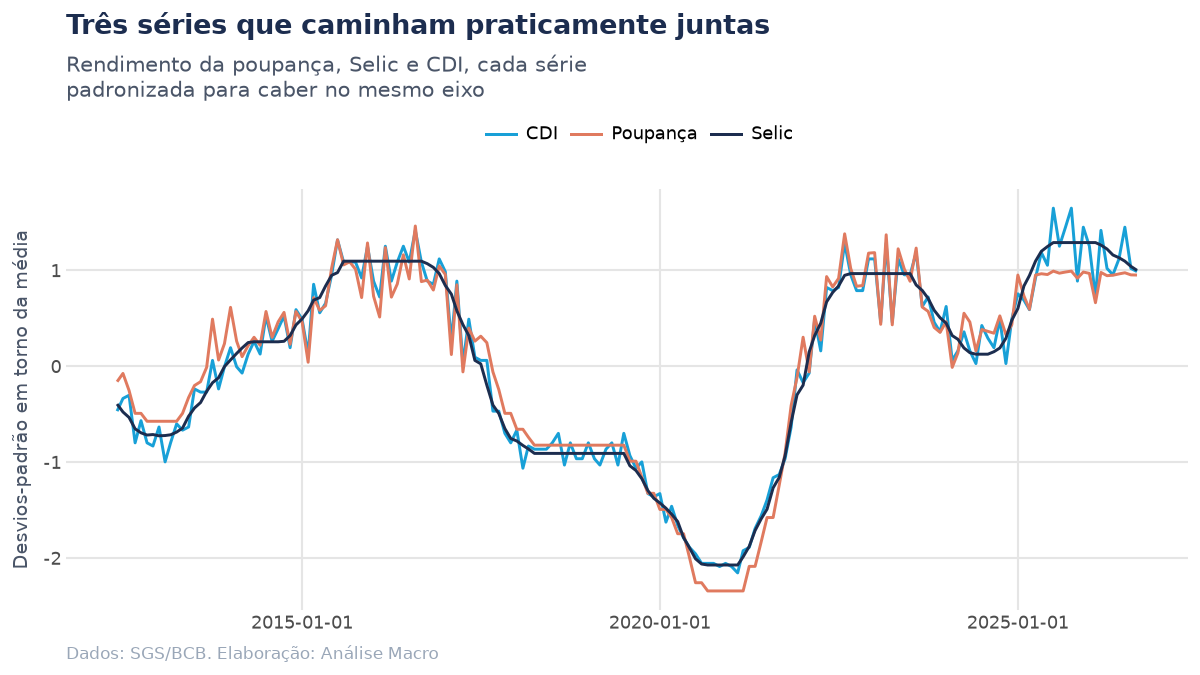
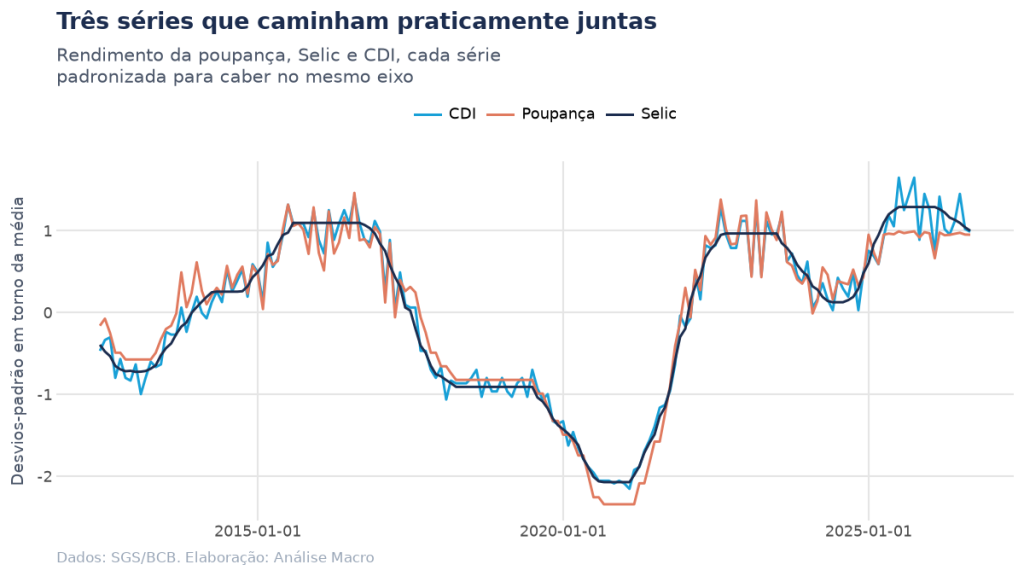
Na figura acima, cada linha representa uma taxa de juros, padronizada para que as três fiquem na mesma escala. As linhas se sobrepõem em quase todo o período e só se afastam em alguns trechos de transição da política monetária.
O que esses trechos de separação oferecem à regressão? Eles são os únicos momentos em que uma taxa se move sem a outra. Por isso, uma regressão que use duas dessas taxas como explicativas depende desses trechos para distinguir o efeito de cada taxa.
📩 O modelo continua valendo. O que mudou é a velocidade
Quem já sabe econometria tem a parte difícil resolvida: saber qual pergunta fazer e como checar se a resposta faz sentido. No Boletim AM eu mostro, todo dia, como a IA entra nesse trabalho, sem substituir o julgamento de quem entende o modelo.
Todo dia no seu e-mail. Gratuito, e sai num clique.
Por que a variância do coeficiente cresce com a correlação
Para estimar o efeito de cada regressor, o método de mínimos quadrados usa apenas a parte da variação daquele regressor que não é compartilhada com os outros regressores do modelo.
Quando duas variáveis explicativas se movem juntas, essa parte exclusiva é pequena, e a estimativa de cada efeito se apoia em pouca informação. A fórmula da variância do coeficiente estimado mostra esse mecanismo:
No numerador está σ², a variância do erro da regressão. No denominador está SQTj, a soma dos quadrados dos desvios do regressor j em relação à sua média, multiplicada pelo termo (1 − R²j).
O R²j é o coeficiente de determinação de uma regressão auxiliar, em que o regressor j é explicado por todos os outros regressores do modelo. Ele mede quanto da variação do regressor j as demais variáveis conseguem reproduzir.
Quanto mais as demais variáveis reproduzem o comportamento do regressor j, mais o R² auxiliar se aproxima de um. Com isso, o termo entre parênteses se aproxima de zero, e a variância do coeficiente cresce sem limite superior.
O fator de inflação da variância
Podemos isolar o efeito da correlação sobre a variância invertendo o termo entre parênteses. O resultado é o fator de inflação da variância, ou VIF, sigla do inglês variance inflation factor:
O VIF mede quantas vezes a variância do coeficiente é maior do que seria se aquele regressor não tivesse correlação com os demais. Um VIF igual a 1 indica ausência de correlação, e um VIF de 5 indica uma variância cinco vezes maior.
Como o erro-padrão é a raiz quadrada da variância, um VIF de 10 corresponde a um erro-padrão cerca de três vezes maior. As referências de corte mais usadas são 5 e 10. Elas são convenções práticas, sem uma distribuição estatística por trás que as justifique.
Como a colinearidade aparece na estatística t
O diagnóstico mais direto compara o que cada variável indica quando entra sozinha na regressão com o que ela indica na presença da outra.
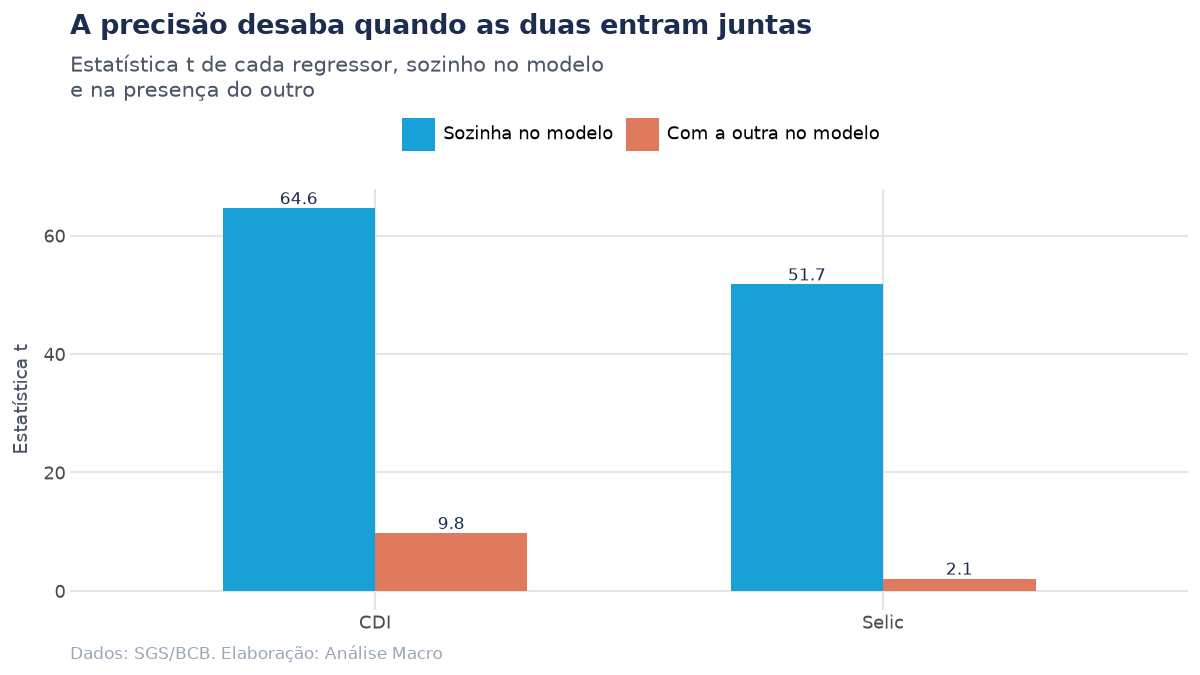
A estatística t é o coeficiente dividido pelo seu erro-padrão, e mede quantos erros-padrão a estimativa está distante de zero. Na figura acima, as barras em ciano mostram a estatística t de cada taxa numa regressão com um regressor só.
Avaliada isoladamente, cada taxa aparece com estatística t de várias dezenas, o que indicaria um efeito estimado com muita precisão. As barras em coral mostram as mesmas taxas quando entram juntas no mesmo modelo.
Com as duas taxas no modelo, os coeficientes diminuem, os erros-padrão aumentam e as estatísticas t caem. Um dos regressores chega perto de perder a significância estatística, embora sozinho tenha aparecido como uma das estimativas mais precisas do exercício.
Enquanto isso, o ajuste global do modelo melhora, porque acrescentar um regressor nunca reduz o R². Ou seja, a regressão parece melhor justamente quando a leitura individual de cada coeficiente deixa de ser possível.
Quando o sinal deixa de ser confiável
Com dados observados, não escolhemos a correlação entre as variáveis. Por isso, recorremos a uma simulação: fixamos os coeficientes verdadeiros e variamos apenas a correlação entre dois regressores, com valores que começam em zero e se aproximam de um.
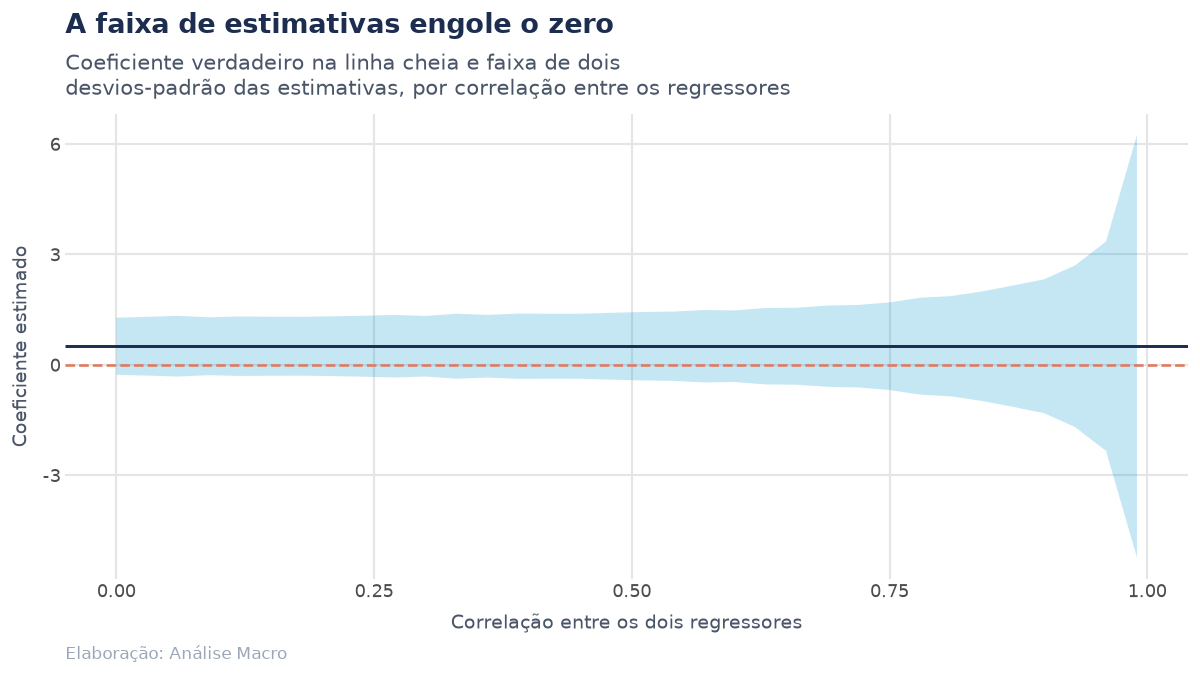
Na figura acima, a linha cheia representa o coeficiente verdadeiro, que é positivo e igual em todo o eixo. A faixa sombreada cobre dois desvios-padrão em torno das estimativas, a região em que cai a maior parte delas.
À esquerda, com regressores pouco correlacionados, a faixa é estreita e as estimativas ficam próximas do valor verdadeiro. À direita, conforme a correlação se aproxima de um, a faixa se alarga rapidamente.
Onde a faixa ultrapassa a linha tracejada do zero, o sinal do coeficiente estimado deixa de ser confiável. Ou seja, amostras geradas pelo mesmo processo, com coeficiente positivo, podem devolver uma estimativa negativa.
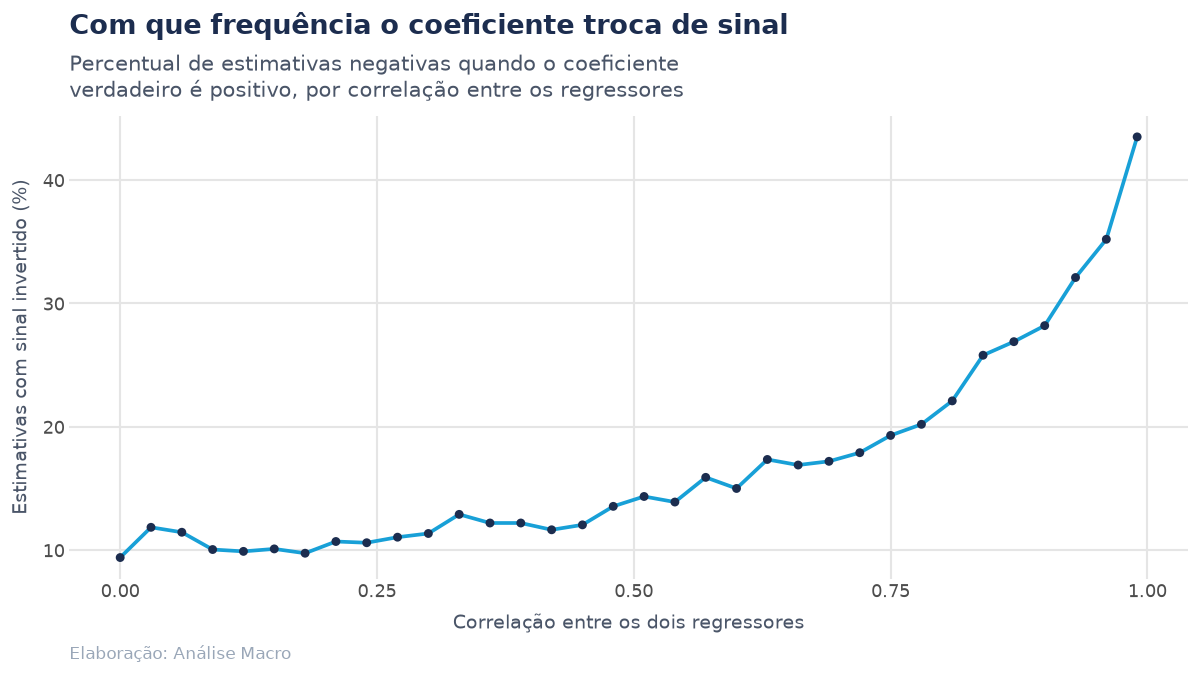
A curva da figura acima mostra o percentual de simulações em que a estimativa saiu com sinal contrário ao verdadeiro. Esse percentual é baixo quando a correlação é pequena e cresce rapidamente quando a correlação se aproxima de um.
Na prática, temos uma única amostra. Um pesquisador que estimasse esse modelo uma vez, com regressores muito correlacionados, teria uma probabilidade alta de reportar um efeito com o sinal errado, e a saída da regressão não traria nenhum aviso sobre o problema.
O que a multicolinearidade afeta e o que ela preserva
E se retirarmos uma das variáveis correlacionadas? Remover a variável só resolve quando ela não pertence ao modelo.
Retirar um regressor correlacionado reduz o VIF dos regressores que ficam. Se o regressor retirado afeta a variável dependente, porém, o efeito dele passa para o coeficiente das variáveis que ficaram, o que chamamos de viés de variável omitida. Ou seja, trocamos imprecisão por um erro sistemático.
As alternativas são ampliar a amostra, buscar períodos em que as variáveis se movem de forma independente, combinar as variáveis correlacionadas numa única medida ou estimar apenas o efeito conjunto delas.
O roteiro para diagnosticar colinearidade
| Passo | O que fazer |
|---|---|
| 1 | Calcular a matriz de correlação dos regressores antes de estimar o modelo. |
| 2 | Estimar o VIF de cada regressor pela regressão auxiliar sobre os demais. |
| 3 | Comparar o coeficiente de interesse estimado sozinho e na presença dos outros regressores. Um coeficiente que diminui muito, com erro-padrão maior, indica colinearidade. |
| 4 | Verificar se o intervalo de confiança do coeficiente de interesse inclui o zero e valores de sinal oposto. |
| 5 | Decidir pelo objetivo: para previsão, a correção é dispensável; para interpretar coeficientes, é preciso ampliar os dados, combinar as variáveis ou reportar apenas o efeito conjunto. |
O terceiro passo mostra o efeito da colinearidade na própria estimativa que será reportada, enquanto o VIF resume o problema num índice calculado por uma regressão auxiliar.
Considerações finais
A multicolinearidade é um problema de informação disponível nos dados. O modelo pode estar bem especificado, mas os dados registram poucos episódios em que as variáveis se movem separadamente, e apenas esses episódios permitem distinguir duas influências que andam juntas.
Por isso, a estimação continua informando com precisão o efeito conjunto das variáveis, enquanto o efeito isolado de cada uma fica impreciso.
- Economista: verifica o VIF antes de interpretar o coeficiente de uma variável macroeconômica que caminha com outras do modelo.
- Analista de dados: identifica por que um coeficiente trocou de sinal ao acrescentar uma variável de controle, em vez de atribuir a mudança a um efeito real.
- Gestor de risco: entende por que fatores correlacionados numa carteira não permitem atribuir a exposição a um deles isoladamente.
- Pesquisador: decide entre reportar o efeito conjunto ou buscar variação independente, com base no VIF e na comparação das estimativas.
- Profissional de marketing: avalia por que canais de mídia acionados em conjunto não têm contribuição separável num modelo de atribuição.
Em todos esses casos, a pergunta é a mesma: os dados contêm informação suficiente para separar este efeito dos demais?
Você viu o diagnóstico; aprenda a estimar o modelo
De estatística descritiva a testes de hipótese e regressão, com Python aplicado a dados econômicos reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
BELSLEY, D. A.; KUH, E.; WELSCH, R. E. Regression Diagnostics: Identifying Influential Data and Sources of Collinearity. New York: John Wiley & Sons, 1980.
FARRAR, D. E.; GLAUBER, R. R. Multicollinearity in Regression Analysis: The Problem Revisited. The Review of Economics and Statistics, v. 49, n. 1, p. 92-107, 1967.
GREENE, W. H. Econometric Analysis. 8. ed. New York: Pearson, 2018.
GUJARATI, D. N.; PORTER, D. C. Basic Econometrics. 5. ed. New York: McGraw-Hill Irwin, 2009.
WOOLDRIDGE, J. M. Introductory Econometrics: A Modern Approach. 7. ed. Boston: Cengage Learning, 2020.
Leia também: Heterocedasticidade e erros-padrão robustos




