
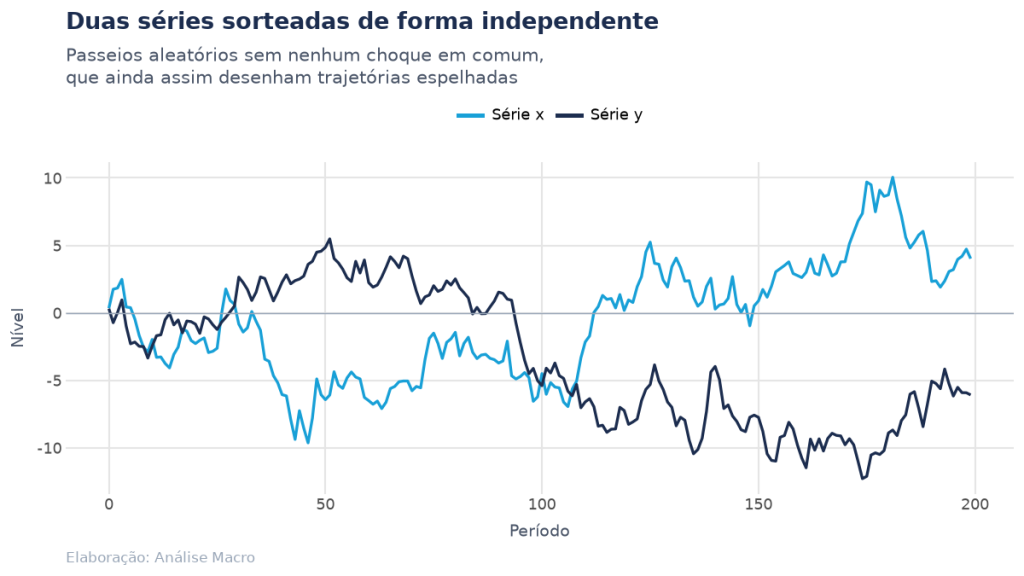
Vamos sortear duas séries temporais de forma independente, sem que uma tenha qualquer influência sobre a outra. Mesmo assim, a regressão de uma contra a outra pode devolver R² alto, coeficiente significante e p-valor muito abaixo de 5%. Neste exercício, vamos ver por que isso acontece e o que fazer antes de regredir uma série temporal contra outra.
Esse resultado é uma regressão espúria, ou seja, uma regressão que indica uma relação estatisticamente significante entre variáveis sem relação alguma. Ela aparece quando as séries têm raiz unitária, e a saída do modelo fica parecida com a de uma relação verdadeira.
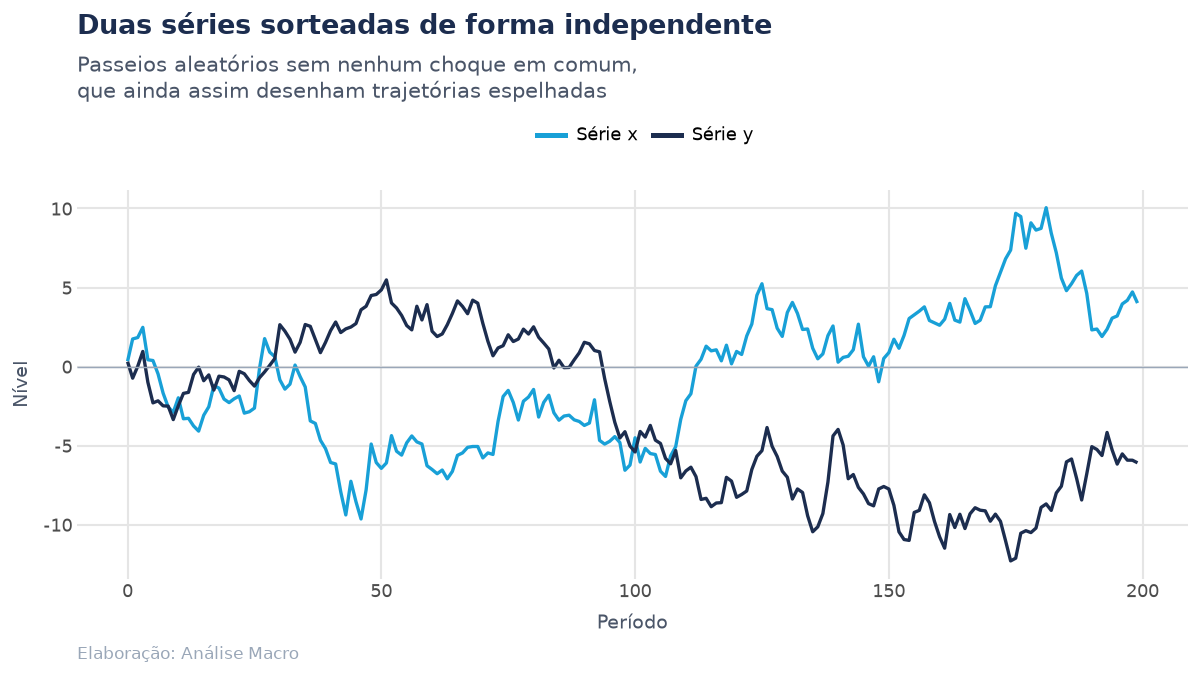
Na figura acima, cada linha representa uma série simulada. Em trechos longos, as séries sobem ou descem ao mesmo tempo, e a regressão interpreta esse movimento comum como uma relação forte entre as variáveis.
De onde vem esse movimento comum? Da persistência de cada série: cada uma acumula os próprios choques e se afasta da origem por longos períodos, embora os sorteios tenham sido feitos sem nenhuma ligação entre eles.
📩 O modelo continua valendo. O que mudou é a velocidade
Quem já sabe econometria tem a parte difícil resolvida: saber qual pergunta fazer e como checar se a resposta faz sentido. No Boletim AM eu mostro, todo dia, como a IA entra nesse trabalho, sem substituir o julgamento de quem entende o modelo.
Todo dia no seu e-mail. Gratuito, e sai num clique.
O que é uma raiz unitária
Uma série tem raiz unitária quando o valor de hoje é igual ao valor de ontem somado a um choque que permanece na série em todos os períodos seguintes. O caso mais simples é o passeio aleatório, em que o nível da série muda apenas pelo choque do período:
Nessa equação, εt é um choque de média zero e sem correlação ao longo do tempo. Como cada choque é somado ao nível da série, ele continua presente em todos os períodos seguintes.
Se aplicarmos a equação período após período, desde o início, o nível da série em cada período é a soma de todos os choques passados. Por isso, a variância cresce na proporção do tempo decorrido:
Uma série assim se afasta do ponto de partida sem tendência de voltar a uma média de longo prazo, e por isso é chamada de não estacionária. Essa variância, que cresce com o tempo, causa o problema na regressão.
Por que o teste t falha com séries não estacionárias
A estatística t é a razão entre o coeficiente estimado e o seu erro-padrão, e a fórmula usual do erro-padrão pressupõe que a variância dos dados não dependa do tempo.
Quando as séries são passeios aleatórios, a soma dos quadrados dos desvios cresce com a amostra mais rápido do que a fórmula supõe. Com isso, o erro-padrão calculado fica pequeno demais, e a estatística t, que divide o coeficiente por esse erro-padrão, fica grande demais.
Granger e Newbold (1974) documentaram esse resultado ao simular pares de passeios aleatórios independentes: a hipótese nula foi rejeitada com frequência muito acima do nível nominal do teste.
Phillips (1986) explicou o resultado pela teoria assintótica. Com séries não estacionárias, a estatística t cresce com a raiz do tamanho da amostra, em vez de convergir para a distribuição t usual.
Com que frequência o teste erra
Um único par de séries pode produzir qualquer resultado, dependendo do sorteio. Para medir o tamanho do problema, repetimos o experimento milhares de vezes e contamos com que frequência o teste rejeita a hipótese nula.
A hipótese nula afirma que o coeficiente é zero, e ela é verdadeira em todas as repetições, porque as séries foram sorteadas de forma independente. Por isso, um teste ao nível de 5% deveria rejeitá-la em cerca de 5% das repetições.
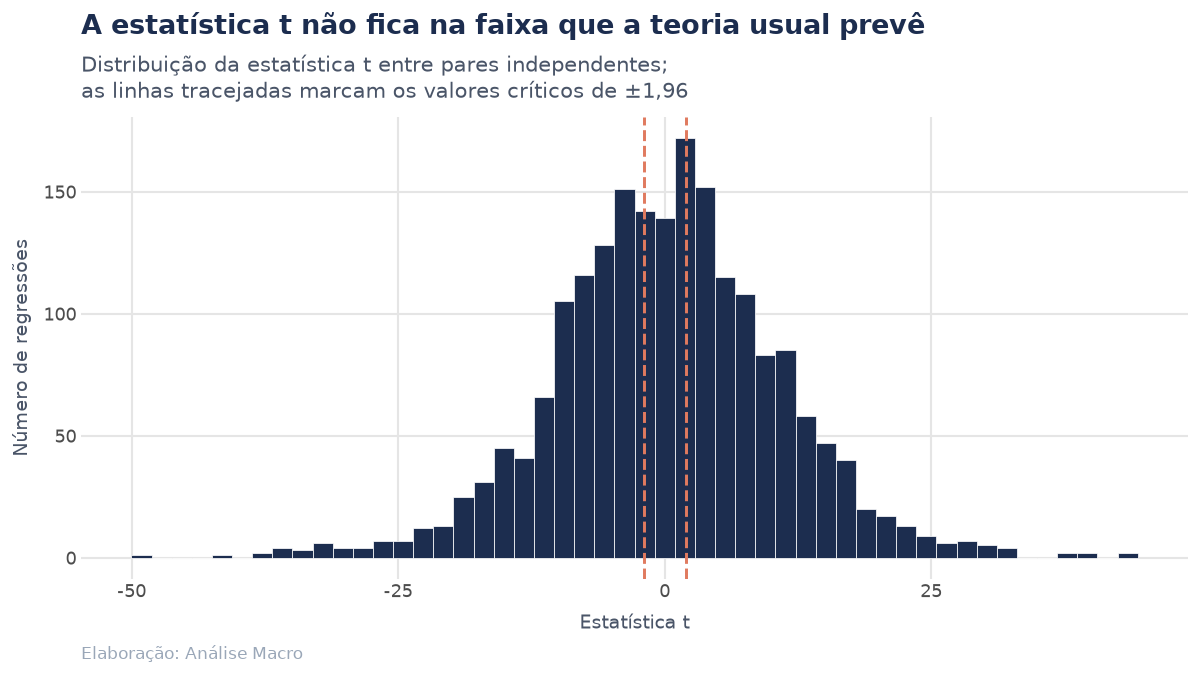
Na figura acima, o histograma mostra a estatística t de cada repetição, e as linhas tracejadas marcam os valores críticos usuais, −1,96 e 1,96. Com séries estacionárias e a hipótese nula verdadeira, 95% das estatísticas ficariam entre esses dois valores.
No nosso exemplo, a maior parte das estatísticas fica fora da faixa entre os valores críticos, que ocupa apenas uma região estreita em torno de zero. Ou seja, o teste rejeita a hipótese nula verdadeira em mais de oito de cada dez repetições.
A distribuição fica larga porque, como mostrou Phillips, a estatística t cresce com a raiz do tamanho da amostra. Por isso, aumentar a amostra piora o diagnóstico em vez de corrigi-lo.
O R² também indica uma relação inexistente
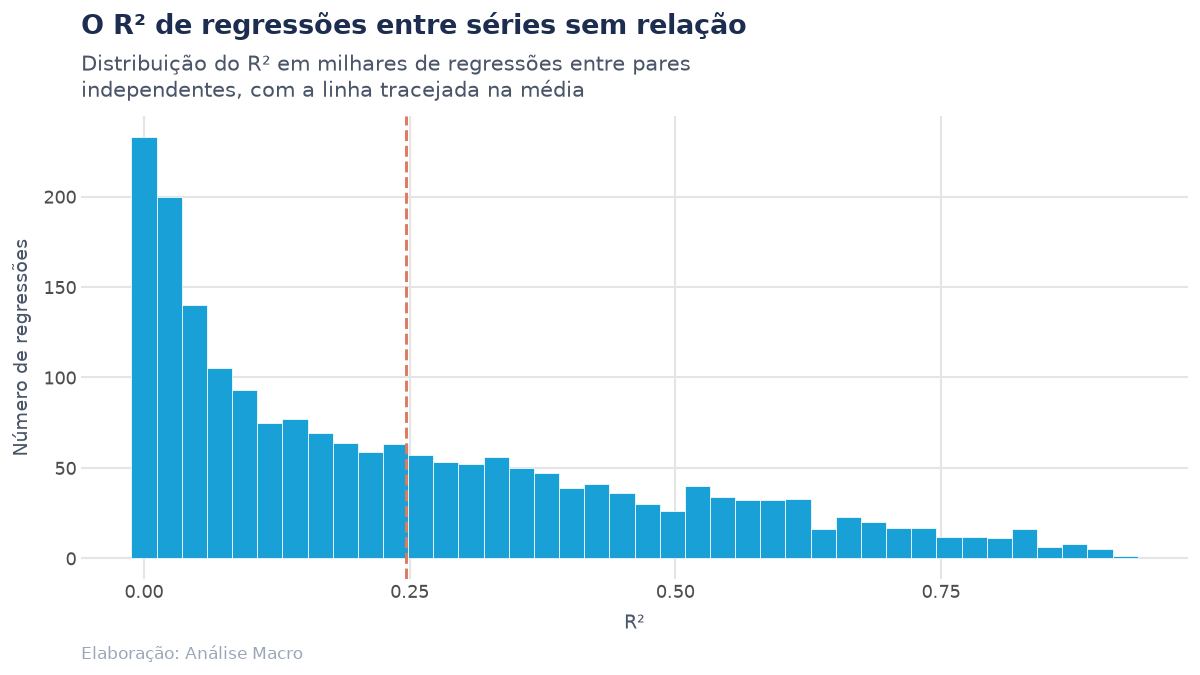
Na figura acima, o histograma mostra o R² de cada repetição. Os valores se espalham por quase todo o intervalo entre zero e um, com frequência que diminui devagar da esquerda para a direita. Por isso, um R² alto, sozinho, não permite distinguir uma relação verdadeira de um par de séries sorteadas em separado.
Na cauda direita da distribuição, o R² ultrapassa 0,5, valor que muitos trabalhos aplicados leem como evidência de bom ajuste. Ou seja, parte das repetições produz uma regressão aparentemente bem ajustada entre séries sem relação.
O mesmo experimento com séries estacionárias
Se a raiz unitária causa o problema, o mesmo experimento com séries estacionárias deveria produzir uma taxa de rejeição próxima do nível nominal de 5%. Por isso, vamos repetir a simulação com séries estacionárias, que funcionam como grupo de controle.
As séries do controle são ruído branco, ou seja, sorteios independentes de média zero e variância constante. Elas são estacionárias porque nem a média nem a variância dependem do tempo.
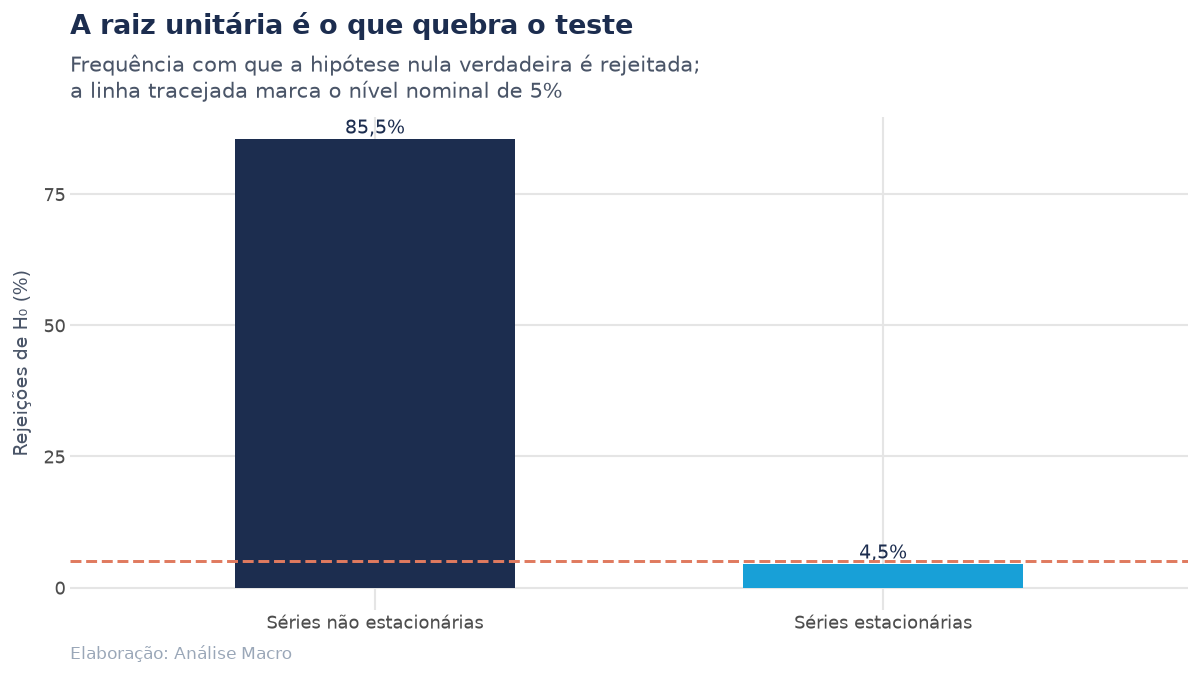
Na figura acima, cada barra mostra a taxa de rejeição em regressões cujo coeficiente verdadeiro é zero. A barra das séries estacionárias fica junto da linha tracejada do nível nominal, enquanto a barra das séries não estacionárias fica mais de dez vezes acima dela.
Os choques sorteados são os mesmos nos dois experimentos, e a única diferença é a soma acumulada que transforma o ruído branco em passeio aleatório. Ou seja, o problema surge quando aplicamos o teste t usual a séries cuja variância cresce ao longo do tempo.
A primeira diferença e a cointegração
Como corrigir o problema? A primeira diferença de uma série é a variação entre um período e o anterior. Num passeio aleatório, essa variação é o próprio choque εt, porque subtrair o valor anterior elimina a soma dos choques passados. Por isso, a primeira diferença de uma série com raiz unitária é estacionária.
Quando repetimos o experimento com as séries em primeira diferença, a taxa de rejeição volta para perto de 5%, e o R² médio cai para perto de zero. O processo que gerou os dados continua o mesmo; a diferenciação apenas coloca as séries na condição em que a fórmula do erro-padrão é correta.
A diferenciação tem um custo quando as séries têm uma relação de longo prazo. Duas séries com raiz unitária são cointegradas quando existe uma combinação linear entre elas que é estacionária. Por exemplo, os preços de dois ativos parecidos podem se afastar no curto prazo, mas a diferença entre eles tende a voltar a uma média. Nesse caso, a regressão em nível estima essa combinação de forma consistente.
Quando há cointegração, a diferenciação remove a relação de longo prazo entre as séries, que é justamente a informação procurada. Por isso, usamos o modelo de correção de erros, que inclui as séries em diferença e o desvio da relação de longo prazo, conforme Engle e Granger (1987).
Antes de diferenciar ou de usar o modelo de correção de erros, precisamos saber se as séries têm raiz unitária. O teste de Dickey-Fuller aumentado tem como hipótese nula que a série tem raiz unitária, e rejeitá-la indica que a série é estacionária.
Cuidados na leitura do diagnóstico
O próprio teste de Dickey-Fuller aumentado tem dificuldade para distinguir uma raiz unitária de um processo muito persistente, mas estacionário, e essa dificuldade aumenta quanto menor a amostra.
Por isso, em séries curtas, comparamos a conclusão do teste com a de outros testes de raiz unitária e com o que sabemos do processo econômico por trás da série.
O roteiro para regredir duas séries temporais
| Passo | O que fazer |
|---|---|
| 1 | Fazer o gráfico das duas séries ao longo do tempo. Um nível que se afasta da média sem voltar a ela é o primeiro indício de raiz unitária. |
| 2 | Aplicar o teste de Dickey-Fuller aumentado em cada série, em nível e em primeira diferença. |
| 3 | Se as duas forem integradas de ordem um, ou seja, estacionárias em primeira diferença, testar a cointegração entre elas antes de escolher a especificação. |
| 4 | Se não houver cointegração, estimar a regressão em primeira diferença; se houver, usar o modelo de correção de erros. |
| 5 | Reportar o teste de raiz unitária e o de cointegração junto da regressão, com as estatísticas e as defasagens usadas. |
O quinto passo permite que o leitor avalie a especificação, porque, sem o diagnóstico de estacionariedade, não há como distinguir uma estimativa válida de uma regressão espúria.
Considerações finais
A regressão espúria surge quando aplicamos o estimador a séries que violam a hipótese sobre a qual a fórmula do erro-padrão foi construída. O estimador de mínimos quadrados funciona como deveria; o erro está em usar o teste t usual com séries cuja variância cresce com o tempo.
Por isso, testamos a raiz unitária antes de qualquer estimativa. O teste é rápido de aplicar e evita que uma conclusão seja construída sobre uma relação inexistente.
- Economista: testa raiz unitária antes de relacionar câmbio, juros ou nível de preços, que raramente são estacionários em nível.
- Analista de dados: desconfia de R² alto entre duas séries que só compartilham o fato de crescerem ao longo do tempo.
- Gestor de risco: evita construir sinal de carteira sobre uma correlação entre preços que desaparece na primeira diferença.
- Pesquisador: reporta os testes de raiz unitária e de cointegração junto da regressão, permitindo a avaliação da especificação.
- Profissional de mercado: distingue um par cointegrado, que sustenta estratégia de reversão, de um par de séries que se moveram juntas por acaso.
Em todos esses casos, a pergunta é a mesma: as séries satisfazem as condições sob as quais este teste é válido?
Você viu o problema; aprenda a modelar séries temporais
De estatística descritiva a testes de hipótese e regressão, com Python aplicado a dados econômicos reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
DICKEY, D. A.; FULLER, W. A. Distribution of the Estimators for Autoregressive Time Series with a Unit Root. Journal of the American Statistical Association, v. 74, n. 366, p. 427-431, 1979.
ENGLE, R. F.; GRANGER, C. W. J. Co-Integration and Error Correction: Representation, Estimation, and Testing. Econometrica, v. 55, n. 2, p. 251-276, 1987.
GRANGER, C. W. J.; NEWBOLD, P. Spurious Regressions in Econometrics. Journal of Econometrics, v. 2, n. 2, p. 111-120, 1974.
HAMILTON, J. D. Time Series Analysis. Princeton: Princeton University Press, 1994.
PHILLIPS, P. C. B. Understanding Spurious Regressions in Econometrics. Journal of Econometrics, v. 33, n. 3, p. 311-340, 1986.
Leia também: Multicolinearidade




