Pré-processamento de dados: lidando com valores extremos e valores ausentes
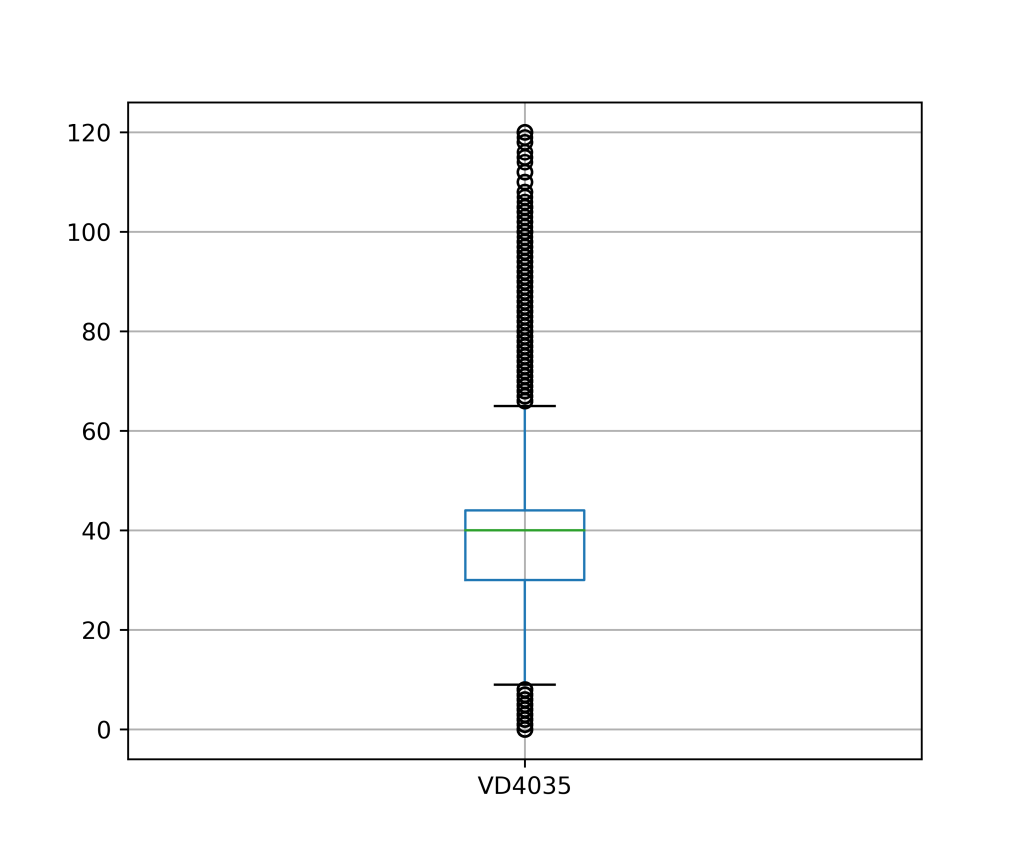
No contexto de ciência de dados, é comum ter que lidar com problemas nos dados de um modelo preditivo, tais como valores extremos (outliers) ou valores ausentes (missing data). Em muitos casos, é preciso aplicar pré-processamentos para validar e utilizar um modelo, ao mesmo tempo que é necessário evitar o vazamento de dados (data leakage). Abordamos estes desafios neste artigo mostrando exemplos com dados reais em aplicações nas linguagens de programação R e Python.
Reamostragem em modelos preditivos: separação treino e teste

Nesse artigo abordamos técnicas de reamostragem de dados, conhecidas como separação treino/validação/teste, úteis para avaliar a acurácia de modelos preditivos. Mostramos exemplos e aplicações das técnicas, destacando o contexto e os desafios que podem emergir, usando problemas de regressão e de classificação com dados temporais e de corte transversal. Códigos dos exemplos são expostos nas linguagens de programação R e Python.
Fluxo de trabalho para Modelagem Preditiva

Neste artigo, apresentamos um guia de trabalho para desenvolver modelos preditivos, percorrendo as principais etapas para se ter uma visão geral do processo. Mostramos um exemplo prático de ponta a ponta, usando as linguagens de programação R e Python.
Análise Exploratória de Séries Temporais

Neste artigo, vamos apresentar técnicas e métodos úteis para analisar séries temporais e entender suas características. Mostramos as aplicações e interpretações de cada técnica com exemplos de dados reais, usando as linguagens de programação R e Python.
Análise de Correlação em Estatística
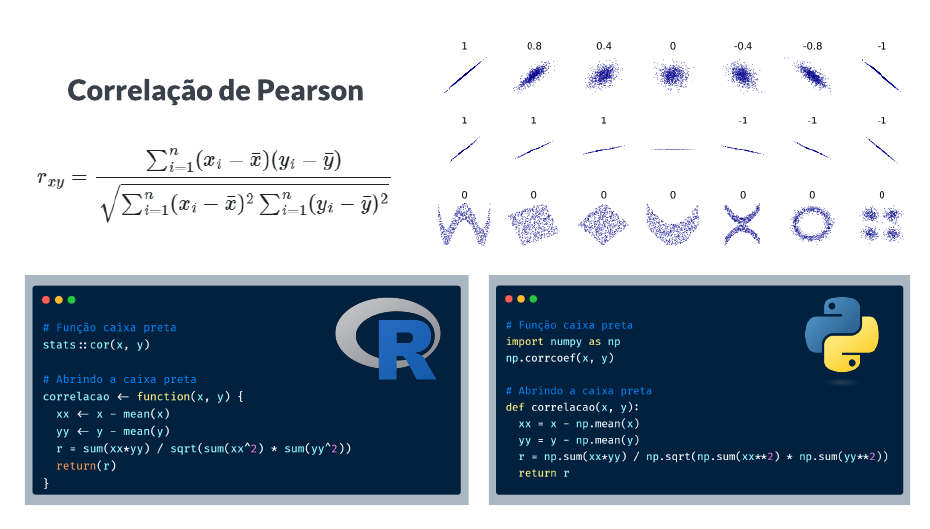
Neste artigo, vamos apresentar o conceito de correlação na estatística, avaliar sua aplicabilidade no mundo real, verificar como estimar e interpretar o coeficiente de correlação e, por fim, vamos ver como aplicar a análise de correlação com dados macro-financeiros do Brasil.