Um banco de dados é uma coleção de registros integrados, organizados de forma a permitir consulta e atualização confiáveis. Na prática, o banco resolve um problema de todo cadastro que cresce: guardar informação de um jeito que não se contradiga nem se perca conforme o volume cresce.
Neste artigo explicamos como um banco de dados se estrutura, o que faz o sistema que o gerencia e por que os bancos relacionais dividem a informação em várias tabelas em vez de guardar tudo numa só.
📩 Acompanhe nossas análises
O Boletim AM traz análises de conjuntura, exercícios em R e Python e material de estudo, direto no seu e-mail.
Registros, atributos e dados
Um registro representa um objeto físico ou conceitual: um cliente, um pedido, uma transação. Cada atributo é uma característica desse objeto, como nome, endereço ou região. E os dados são os valores que cada atributo assume em cada registro.
Numa tabela, o registro é a linha, o atributo é a coluna e o dado é a célula. A tabela abaixo guarda cinco clientes, cada um com seus atributos de nome, região e endereço:
| ID_CLIENTE | NOME | REGIAO | RUA | CIDADE | ESTADO | CEP |
|---|---|---|---|---|---|---|
| 1 | LITE Ind | Sudeste | RUA ROQUE | SAO PAULO | SP | 85429674 |
| 2 | Rex LTDA | Sudeste | RUA JOAO | RIO DE JANEIRO | RJ | 75014542 |
| 3 | Re Construcao | Sudeste | RUA PADRE | BELO HORIZONTE | MG | 14527869 |
| 4 | PR Materiais | Sudeste | RUA CHEREZE | CAMPINAS | SP | 32015692 |
| 5 | Metais Lane | Sudeste | RUA MINAS | VARGINHA | MG | 01236471 |
Uma tabela de clientes: cada linha é um registro, cada coluna um atributo. Elaboração: Análise Macro.
A primeira coluna é a chave primária da tabela. O ID_CLIENTE identifica cada registro de forma única, e é por ele que outras tabelas vão se referir a esse cliente.
Estruturados e não estruturados
Os dados nem sempre chegam em formato de tabela, e essa diferença determina as ferramentas de análise disponíveis.
Dados estruturados têm formato tabular definido, com linhas e colunas de tipos conhecidos. É o caso de uma planilha, de um arquivo CSV ou de uma tabela em banco de dados.
Dados não estruturados não seguem esse formato: documentos de texto, imagens, áudios e vídeos. Eles carregam informação, mas exigem processamento antes de entrar numa análise quantitativa.
A maior parte das ferramentas de análise de dados trabalha com dados estruturados, o que explica por que boa parte do trabalho de um analista consiste em transformar o não estruturado em tabela.
O tamanho muda o problema
Um banco de dados pode ir de uma coleção de poucos registros a sistemas com milhões deles. Além do volume, a escala muda quantas pessoas precisam acessar a informação ao mesmo tempo, e essa exigência define a categoria do banco.
O acesso simultâneo aparece a partir do segundo caso e traz um problema próprio. Quando duas pessoas alteram o mesmo registro ao mesmo tempo, é preciso um mecanismo que decida o que prevalece, e esse mecanismo não existe numa planilha compartilhada.
O que é um SGBD
Quando alguém diz que a empresa "usa um banco de dados", em geral está se referindo ao sistema que o gerencia. O Sistema Gerenciador de Banco de Dados, ou SGBD, é o conjunto de programas que define, administra e processa o banco e suas aplicações.
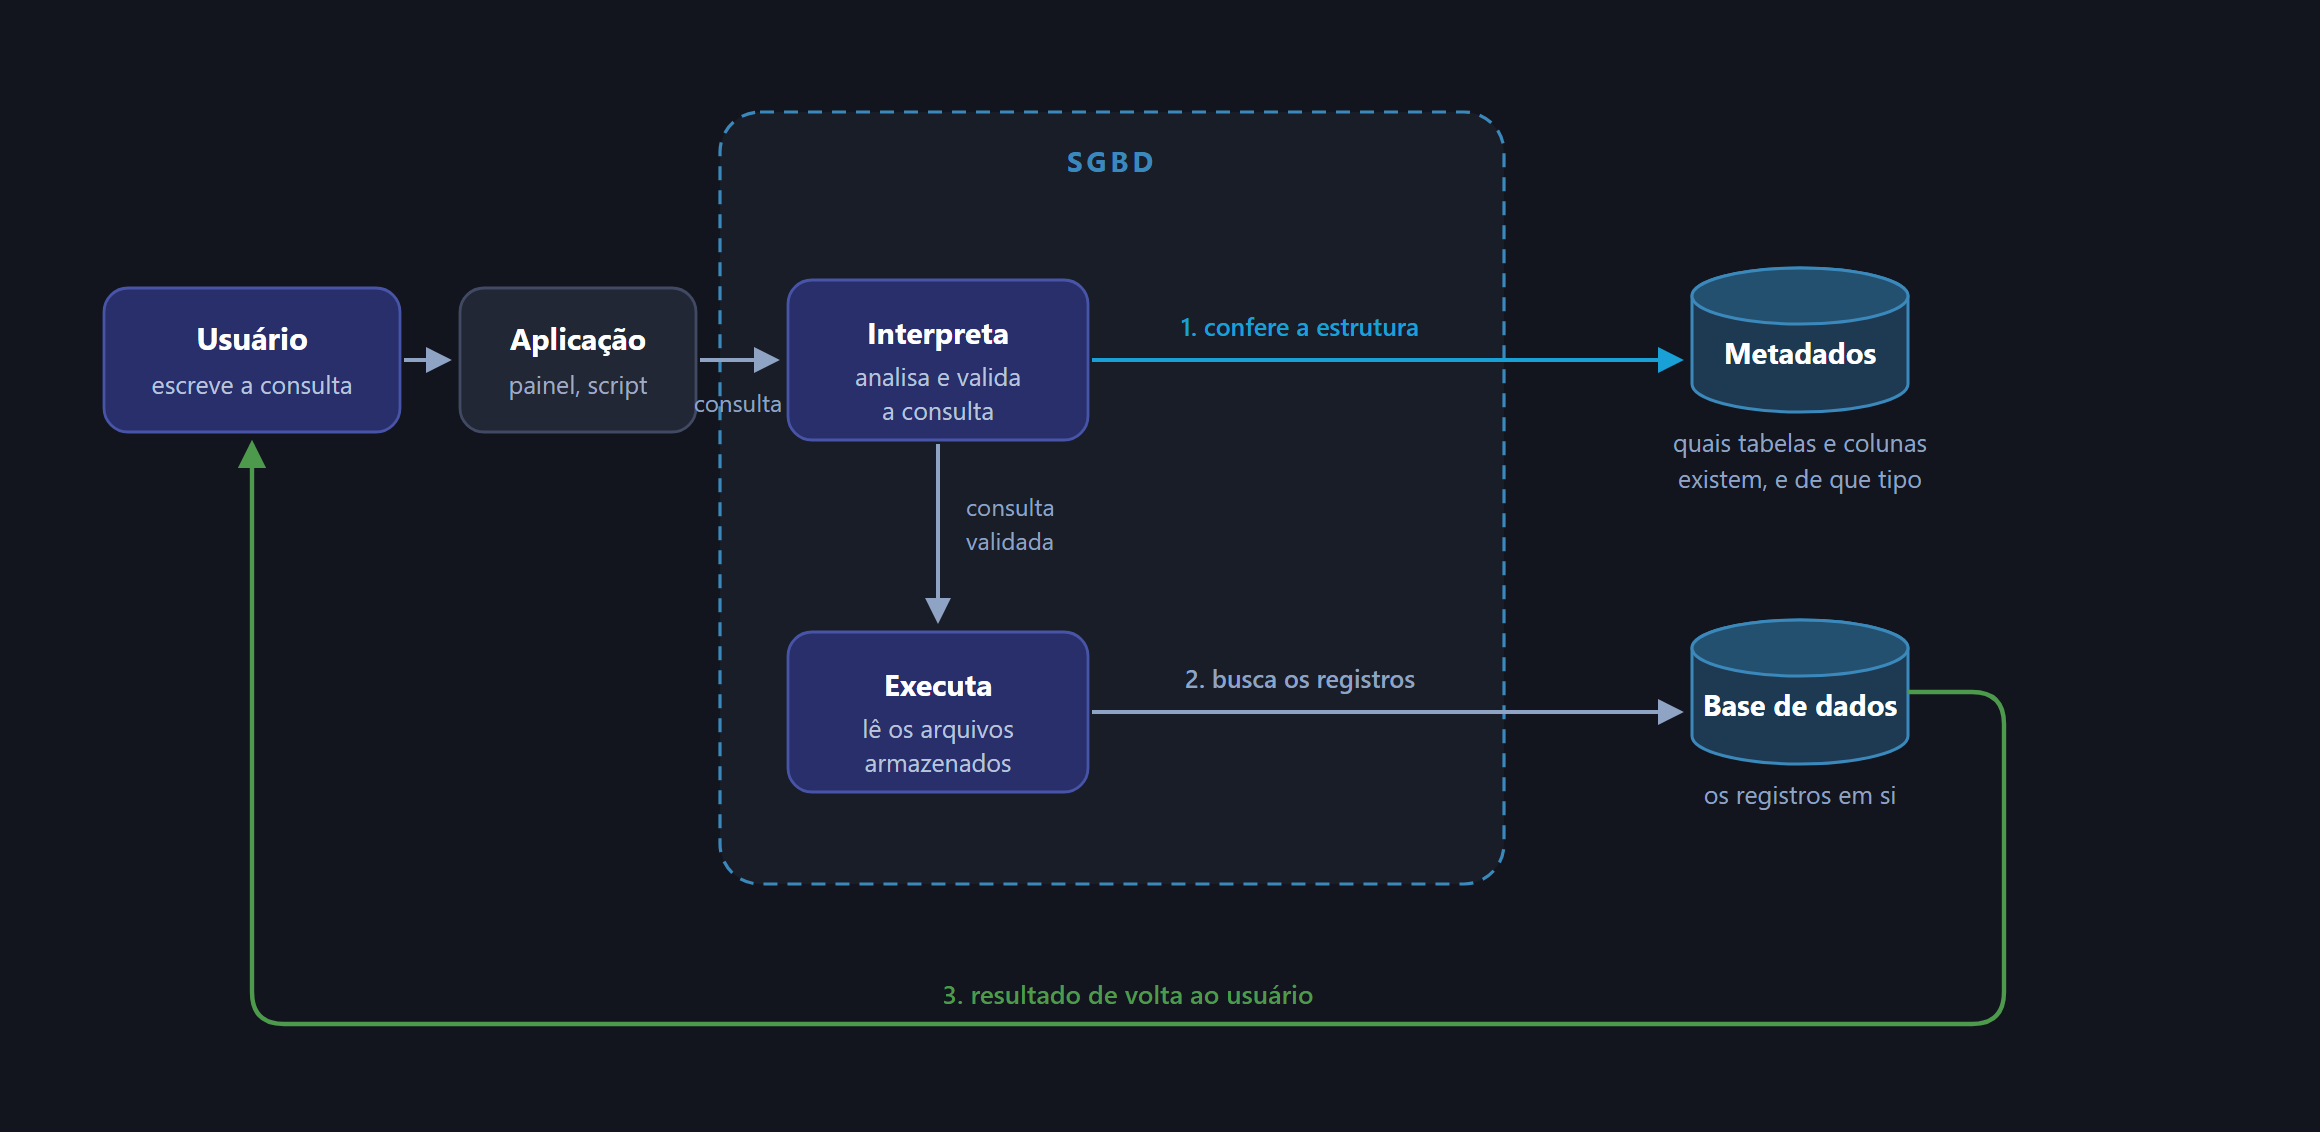
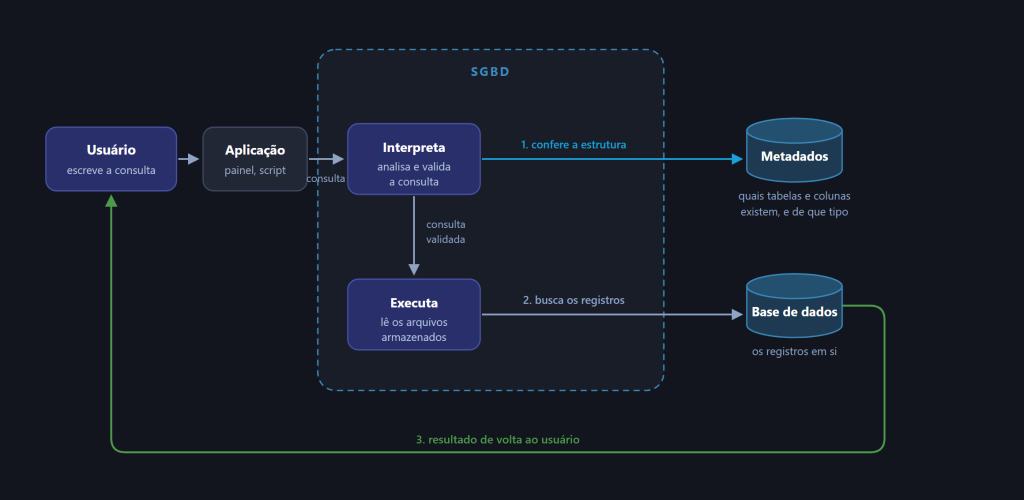
O diagrama mostra o percurso. O usuário faz uma consulta pela aplicação, o SGBD a interpreta e a traduz em acesso aos arquivos, e devolve o resultado. O usuário nunca toca diretamente nos arquivos.
Repare que o SGBD acessa duas coisas distintas: a base de dados e os metadados. Os metadados descrevem a estrutura do próprio banco, dizendo quais tabelas existem, quais colunas têm e de que tipo é cada uma. Essa camada permite ao sistema validar uma consulta antes de executá-la.
Os SGBDs se dividem em dois grupos conforme a escala. Os leves, como SQLite e Microsoft Access, atendem soluções simples e poucos usuários. Os centralizados, como PostgreSQL, MySQL, SQL Server e Oracle, sustentam muitos acessos simultâneos.
Por mais que os programas difiram entre si, quase todos falam a mesma língua: o SQL. Tratamos do essencial dela em Entendendo o basicão de SQL para usuários de Python, com versões para usuários de R e de Excel.
Por que tabelas separadas
Os bancos relacionais dominam o mercado, e sua característica central é dividir a informação em várias tabelas ligadas entre si. À primeira vista isso complica o que poderia ser simples. Por que não guardar tudo numa tabela só?
A tabela abaixo guarda os pedidos de uma empresa numa tabela única, com os dados do cliente repetidos em cada linha. As colunas são um recorte do original:
| ID_PEDIDO | NOME | RUA | CIDADE | CEP | DATA_PEDIDO | QTD |
|---|---|---|---|---|---|---|
| 1 | LITE Ind | RUA ROQUE | SAO PAULO | 85429674 | 2015-04-15 | 450 |
| 2 | Re Construcao | RUA PADRE | BELO HORIZONTE | 14527869 | 2015-04-18 | 600 |
| 3 | Re Construcao | RUA PADRE | BELO HORIZONTE | 14527869 | 2015-04-20 | 300 |
| 4 | Metais Lane | RUA MINAS | VARGINHA | 01236471 | 2015-04-18 | 375 |
| 5 | Re Construcao | RUA PADRE | BELO HORIZONTE | 14527869 | 2015-04-17 | 500 |
Tabela com redundância: os dados do cliente "Re Construcao" aparecem três vezes (linhas destacadas). Elaboração: Análise Macro.
O endereço da Re Construcao está gravado três vezes. Se a empresa mudar de rua, é preciso alterar as três linhas, e esquecer uma delas deixa o banco com duas versões do mesmo endereço, sem indicação de qual é a correta.
Esse defeito se chama anomalia de atualização, e a tabela única provoca mais dois. A anomalia de inserção impede cadastrar um cliente novo antes que ele faça o primeiro pedido, porque não haveria linha onde gravá-lo. A de exclusão apaga o cadastro junto com o último pedido dele.
A solução relacional guarda clientes e pedidos em tabelas diferentes. Os dados do cliente ficam na tabela de clientes, vista no início do artigo, e a tabela de pedidos guarda apenas a referência:
| ID_PEDIDO | DATA_PEDIDO | DATA_ENVIO | ID_CLIENTE | ID_PRODUTO | QTD |
|---|---|---|---|---|---|
| 1 | 2015-04-15 | 2015-04-18 | 1 | 1 | 450 |
| 2 | 2015-04-18 | 2015-04-21 | 3 | 2 | 600 |
| 3 | 2015-04-20 | 2015-04-23 | 3 | 5 | 300 |
| 4 | 2015-04-18 | 2015-04-22 | 5 | 4 | 375 |
| 5 | 2015-04-17 | 2015-04-20 | 3 | 2 | 500 |
Tabela de pedidos sem redundância: o cliente aparece só pelo código em ID_CLIENTE. Elaboração: Análise Macro.
Agora o endereço da Re Construcao existe num lugar só. Os três pedidos dela apenas apontam para o ID_CLIENTE igual a 3, e uma mudança de endereço se resolve alterando uma linha.
Essa coluna que aponta para a chave primária de outra tabela é a chave estrangeira, e ela registra a ligação entre as duas tabelas. Reconstruir a visão completa do pedido, com nome e endereço do cliente, é trabalho de uma operação chamada junção, que tratamos em SQL: JOINS.
Decidir como repartir a informação entre tabelas é o que se chama de modelagem, ou design de banco de dados, assunto de Design de Banco de dados.
Quando o banco de dados entra na análise
Para quem trabalha com dados, o banco costuma ser a origem do material, e conhecer sua estrutura muda o trabalho.
- A consulta filtra antes de trazer. Em vez de baixar a tabela inteira e filtrar depois, o SQL traz só o recorte necessário, o que importa quando a tabela tem milhões de linhas.
- A junção substitui o procv. Cruzar informação de tabelas diferentes é operação nativa do banco, resolvida numa única consulta.
- A agregação acontece no servidor. Somas e médias por grupo são calculadas antes de os dados chegarem ao computador de quem analisa.
- O tipo de cada coluna é garantido. Uma coluna de data guarda datas, o que evita o problema clássico da planilha em que o mesmo campo mistura texto e número.
Quando os dados estão espalhados em arquivos soltos, podemos montar um banco local antes de analisar, como mostramos em Transformando dezenas de CSVs em um banco de dados SQL.
Considerações finais
Um banco de dados organiza registros para que a informação continue confiável conforme cresce. O SGBD é o programa que faz essa mediação, e o modelo relacional divide a informação em tabelas para evitar que a mesma coisa seja gravada em dois lugares com valores diferentes.
Entender essa estrutura muda a relação com os dados no trabalho. Em vez de pedir uma exportação e tratá-la na planilha, dá para consultar o banco e obter exatamente o recorte necessário.
O uso varia conforme a área:
- Analista de dados: consulta a origem diretamente, sem depender de exportações prontas.
- Economista: organiza séries e bases públicas num banco próprio, em vez de dezenas de planilhas.
- Contador: cruza lançamentos e cadastros sem repetir informação em cada registro.
- Gestor: entende por que um relatório demora e o que o time precisa para acelerá-lo.
Aprenda a consultar bancos de dados
A formação Do Zero à Análise de Dados Econômicos e Financeiros ensina a coletar, tratar e analisar dados com Python, incluindo o acesso a bancos de dados e a organização das bases. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Leia também: