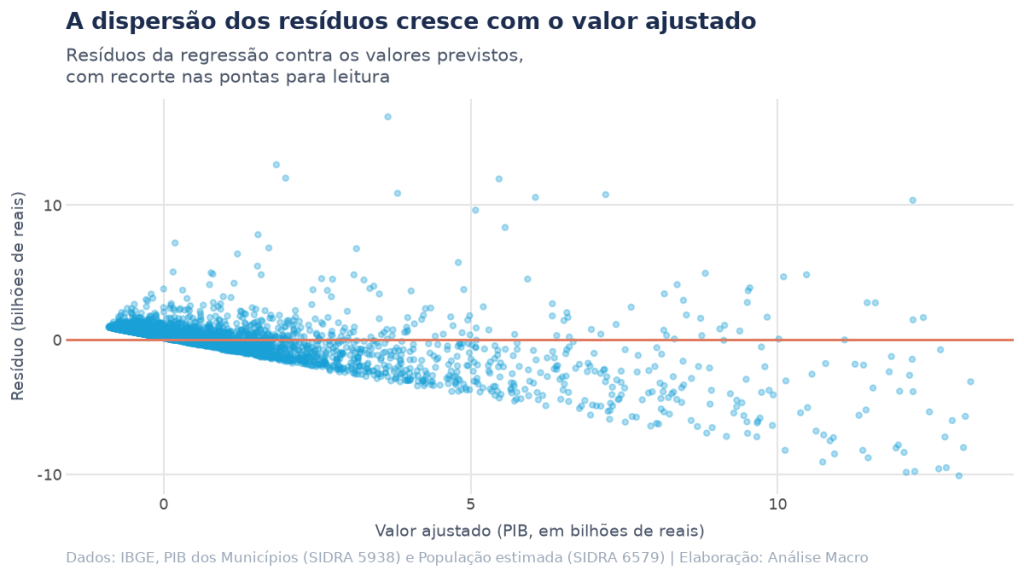
Uma regressão devolve um coeficiente com estatística t acima de 200. O mesmo coeficiente, com o erro-padrão calculado de outra forma, tem estatística t perto de 9. A estimativa do efeito é idêntica nos dois casos, e o que muda é a medida da incerteza em torno dela. Neste exercício, vamos ver por que o erro-padrão muda tanto e como corrigi-lo.
A diferença vem da heterocedasticidade, que acontece quando a variância dos erros da regressão muda ao longo dos dados. Ou seja, algumas observações ficam, em média, muito mais longe da reta estimada do que outras.
No nosso exemplo, a regressão relaciona o PIB de cada município brasileiro à sua população. Municípios mais populosos tendem a ter PIB maior, e a dificuldade está na dispersão dos pontos em torno da reta estimada.
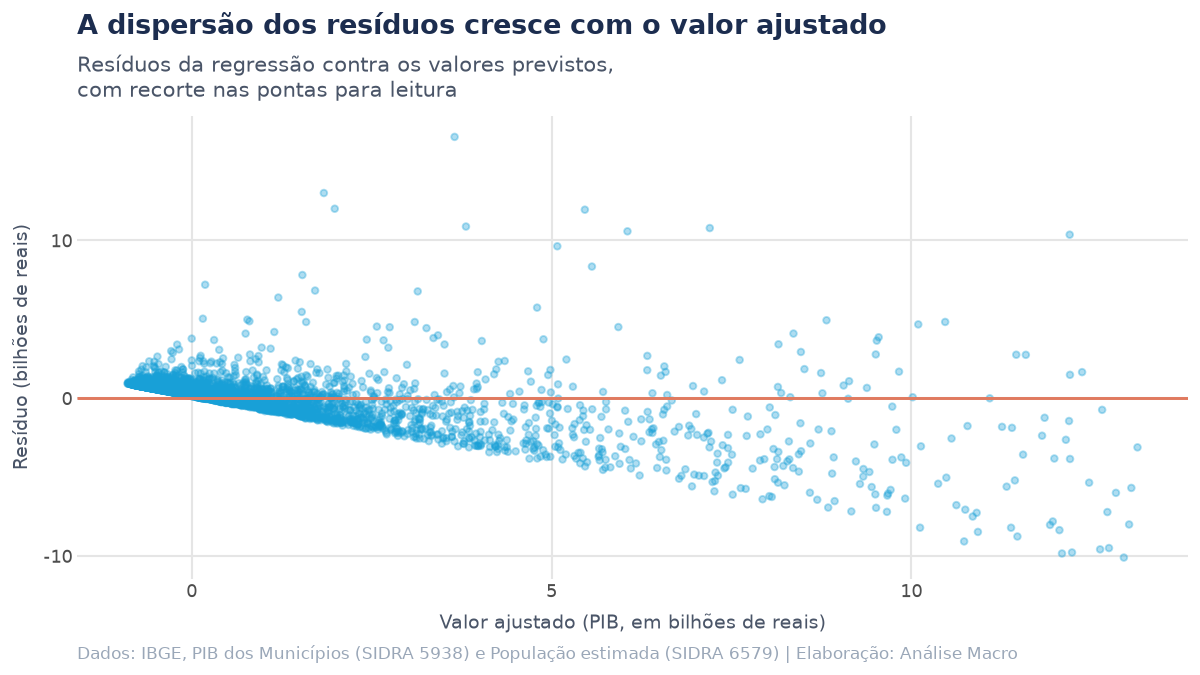
Na figura acima, cada ponto é um município, com o valor previsto pela regressão no eixo horizontal e o resíduo no eixo vertical. O resíduo é a diferença entre o PIB observado e o PIB previsto.
Os pontos formam um leque que se abre da esquerda para a direita. Para municípios pequenos, os resíduos se concentram perto de zero, e para municípios grandes eles se espalham por uma faixa muito mais larga.
O formato de leque é o sinal visual mais comum da heterocedasticidade. Se a variância fosse constante, a nuvem de pontos teria largura parecida em toda a extensão do eixo horizontal.
📩 O modelo continua valendo. O que mudou é a velocidade
Quem já sabe econometria tem a parte difícil resolvida: saber qual pergunta fazer e como checar se a resposta faz sentido. No Boletim AM eu mostro, todo dia, como a IA entra nesse trabalho, sem substituir o julgamento de quem entende o modelo.
Todo dia no seu e-mail. Gratuito, e sai num clique.
O que a heterocedasticidade afeta na regressão?
O método de mínimos quadrados supõe que os erros da regressão têm variância constante, condição chamada de homocedasticidade.
Na equação, εi é o erro da observação i, Xi são suas variáveis explicativas e σ2 é a variância comum a todas as observações.
Quando essa variância depende das variáveis explicativas, a suposição de homocedasticidade falha. O que acontece então com a regressão?
O estimador de mínimos quadrados continua não viesado: em média, ele acerta o coeficiente verdadeiro. O problema aparece na fórmula do erro-padrão, que foi derivada supondo variância constante.
Na fórmula, β̂ é o coeficiente estimado e X é a matriz das variáveis explicativas. Como a fórmula usa um único σ2 para todas as observações, a incerteza calculada fica errada quando a variância muda entre observações, e em geral fica menor do que a verdadeira.
O erro-padrão robusto
O erro-padrão robusto corrige o cálculo trocando o σ2 único por uma estimativa que usa o resíduo de cada observação.
O termo entre as duas matrizes (X′X)−1 soma o quadrado do resíduo de cada observação, e por isso cada observação contribui com a sua própria variância. Pelo formato da expressão, com esse termo entre duas matrizes iguais, o estimador também é chamado de estimador sanduíche.
As variantes HC0, HC1, HC2 e HC3 diferem apenas no ajuste aplicado aos resíduos.
Quanto o erro-padrão muda no nosso exemplo?
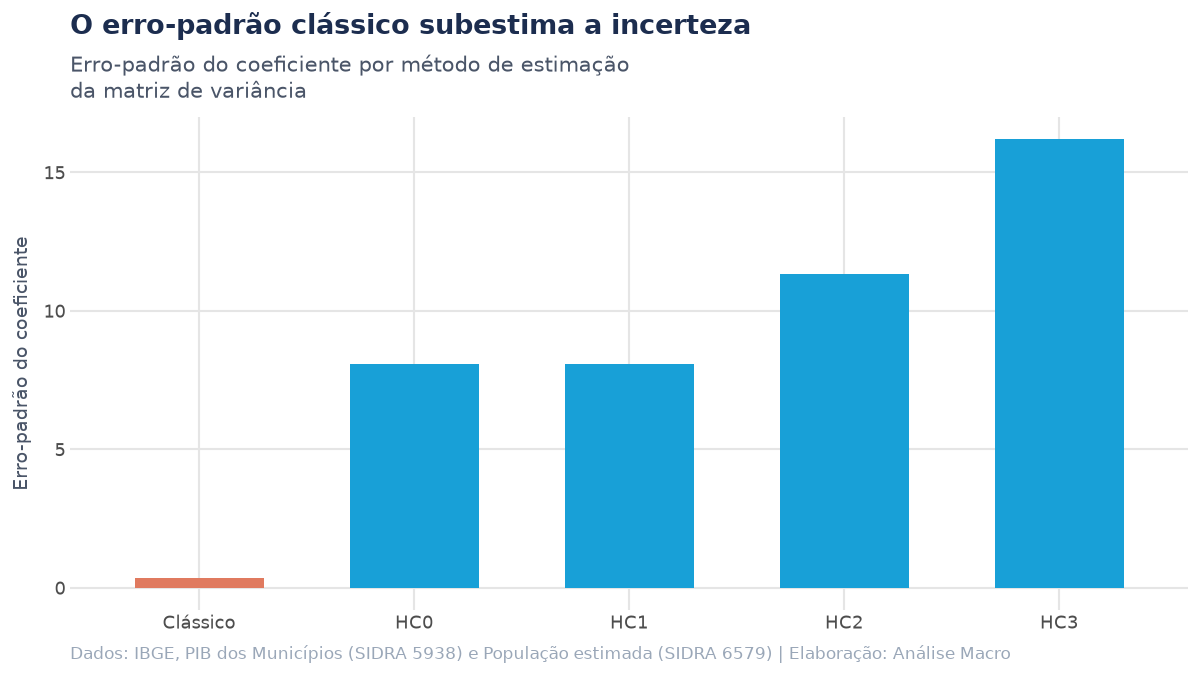
Na figura acima, cada barra mostra o erro-padrão do coeficiente calculado por um método. A barra do método clássico é muito menor que as demais.
Entre as variantes robustas, HC0 e HC1 ficam próximas, enquanto HC2 e HC3 sobem mais, porque dão peso maior aos resíduos de observações com alta alavancagem, aquelas cujas variáveis explicativas ficam longe da média e por isso puxam a reta estimada.
No nosso exemplo, os municípios de grande porte são as observações de alta alavancagem, porque a população deles fica muito acima da média. Na prática, a diferença entre os métodos aparece no intervalo de confiança, que é o resultado reportado ao leitor.
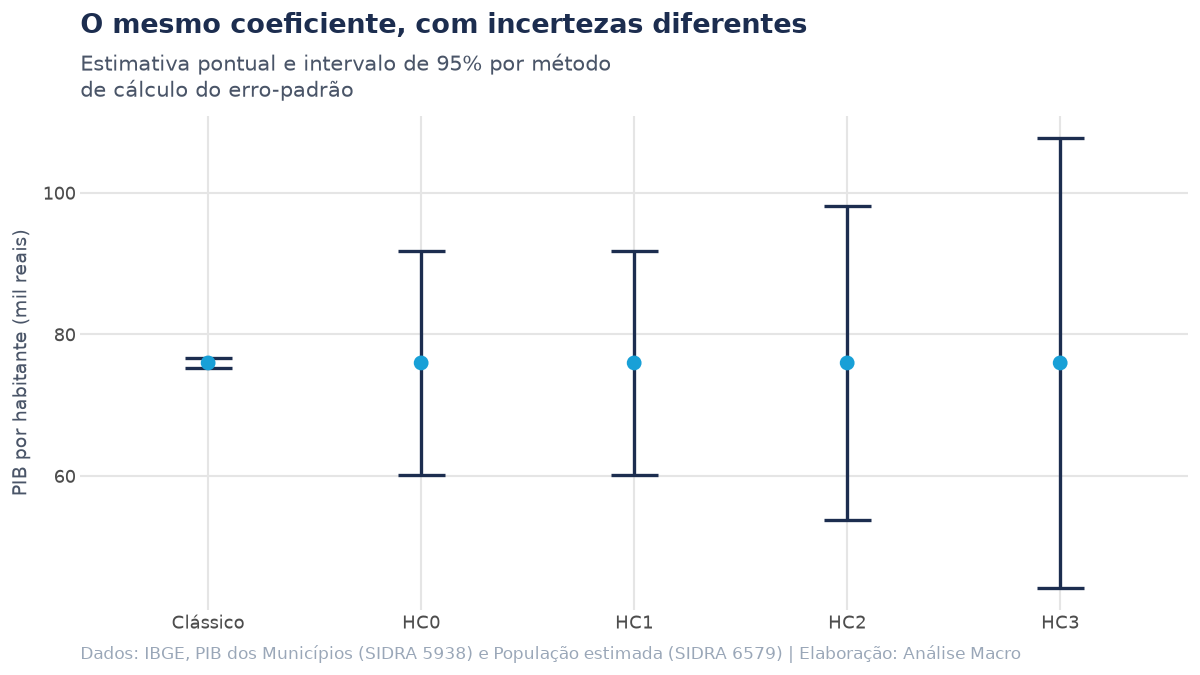
Na figura acima, cada ponto é a estimativa do coeficiente e cada barra vertical é o intervalo de confiança de 95% calculado por um método. Os pontos ficam todos na mesma altura, porque a estimativa pontual não depende do tipo de erro-padrão, enquanto as barras mudam de largura.
Um intervalo estreito demais leva a rejeitar hipóteses que deveriam ser mantidas, e informa ao leitor uma precisão maior do que os dados sustentam.
Quantas vezes o erro-padrão clássico rejeita uma hipótese verdadeira?
Podemos verificar por simulação que o erro-padrão clássico rejeita a hipótese nula com frequência excessiva. O exercício gera dados com heterocedasticidade em que o coeficiente verdadeiro é zero, e registra quantas vezes cada método rejeita a hipótese nula.
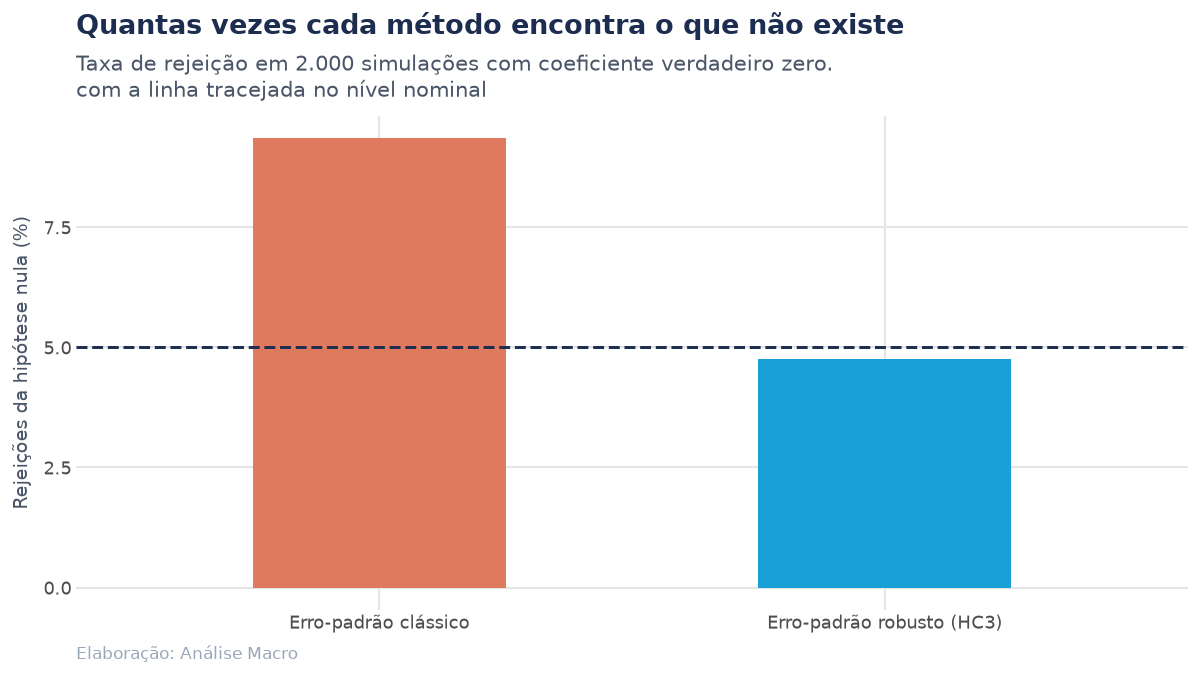
Na figura acima, a linha tracejada marca o nível nominal de 5%, a taxa de rejeição que esperamos quando a hipótese nula é verdadeira. A barra do método clássico fica bem acima dessa linha, e a barra do método robusto fica perto dela.
Ou seja, com o erro-padrão clássico encontramos relações que não existem numa proporção maior do que os 5% aceitos ao escolher o corte.
Os limites do que o exercício mostra
O tamanho da amostra também afeta a escolha da variante. Em amostras pequenas, o HC0 tende a subestimar a variância, e o HC3 costuma ser a escolha mais segura.
O roteiro para tratar a heterocedasticidade
| Passo | O que fazer |
|---|---|
| 1 | Estime o modelo e plote os resíduos contra os valores ajustados. |
| 2 | Procure o formato de leque, que indica variância crescente. |
| 3 | Confirme com o teste de Breusch-Pagan ou de White. |
| 4 | Considere transformar a variável dependente antes de corrigir. |
| 5 | Reporte erros-padrão robustos, e agrupados quando houver estrutura de grupo. |
O quarto passo vem antes do quinto porque corrigir o erro-padrão mantém a especificação como está. Transformar a variável, por exemplo com o logaritmo, pode reduzir a heterocedasticidade e melhorar o ajuste do modelo ao mesmo tempo.
Considerações finais
O diagnóstico da heterocedasticidade começa por um gráfico dos resíduos, e a correção do erro-padrão exige uma mudança pequena na estimação. Quando ignoramos o problema, publicamos intervalos estreitos demais e testes que rejeitam hipóteses verdadeiras com frequência acima do corte escolhido.
Os testes formais, como o de Breusch-Pagan, complementam o gráfico dos resíduos e confirmam o diagnóstico.
- Analista de dados: plota os resíduos antes de reportar qualquer coeficiente, e reconhece o leque de imediato.
- Economista: usa erro-padrão agrupado em regressão com microdados, em que domicílios do mesmo setor censitário se parecem.
- Gestor de risco: desconfia de significância obtida em dados cuja dispersão cresce com o tamanho da exposição.
- Trader: trata séries de retorno sabendo que a volatilidade varia no tempo, o que é a versão temporal do mesmo problema.
- Atuária: modela sinistro por apólice considerando que a variância cresce com o valor segurado.
Em todos esses casos, olhamos os resíduos antes de confiar no erro-padrão.
Você viu o diagnóstico; aprenda a regressão inteira
De estatística descritiva a testes de hipótese e regressão, com Python aplicado a dados econômicos reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
ANGRIST, J. D.; PISCHKE, J.-S. Mostly Harmless Econometrics: An Empiricist's Companion. Princeton: Princeton University Press, 2009.
BREUSCH, T. S.; PAGAN, A. R. A Simple Test for Heteroscedasticity and Random Coefficient Variation. Econometrica, v. 47, n. 5, p. 1287-1294, 1979.
MACKINNON, J. G.; WHITE, H. Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, v. 29, n. 3, p. 305-325, 1985.
WHITE, H. A Heteroskedasticity-Consistent Covariance Matrix Estimator and a Direct Test for Heteroskedasticity. Econometrica, v. 48, n. 4, p. 817-838, 1980.
WOOLDRIDGE, J. M. Econometric Analysis of Cross Section and Panel Data. 2. ed. Cambridge: MIT Press, 2010.
Leia também: Poder estatístico: o que um resultado não significante deixa de dizer