Para resolver multicolinearidade em um modelo preditivo, podemos retirar variáveis redundantes, penalizar o tamanho dos coeficientes com ridge, lasso ou elastic net, ou trocar as variáveis por componentes principais. A pergunta que decide entre elas é uma só: qual reduz o erro de previsão em dados que o modelo nunca viu?
Neste exercício, prevemos o IPCA do mês seguinte com oito índices de preços brasileiros que andam quase juntos, mais a Selic e o câmbio. Comparamos o Mínimos Quadrados Ordinários (MQO) com cinco alternativas, todas avaliadas fora da amostra nos últimos 60 meses, com dados até setembro de 2026.
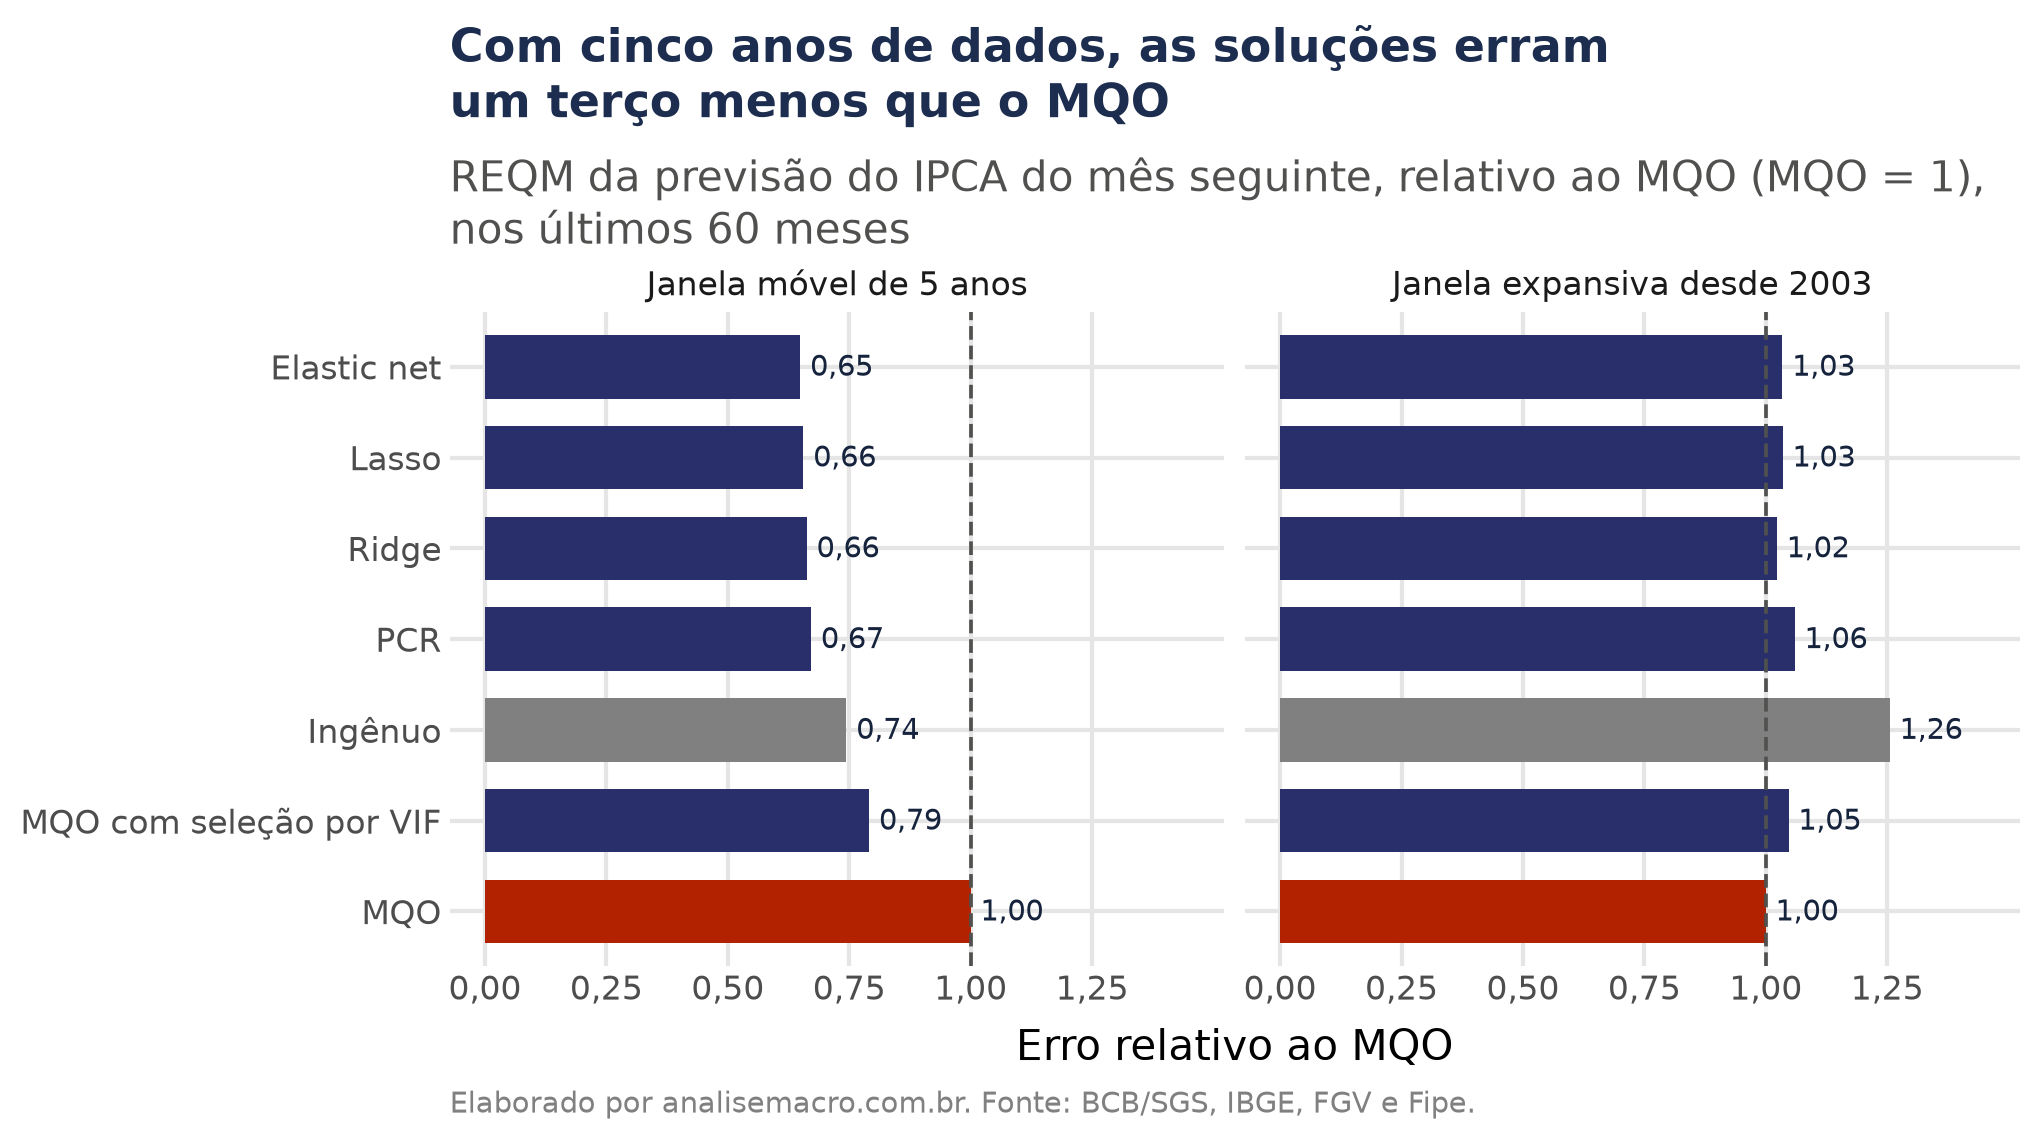
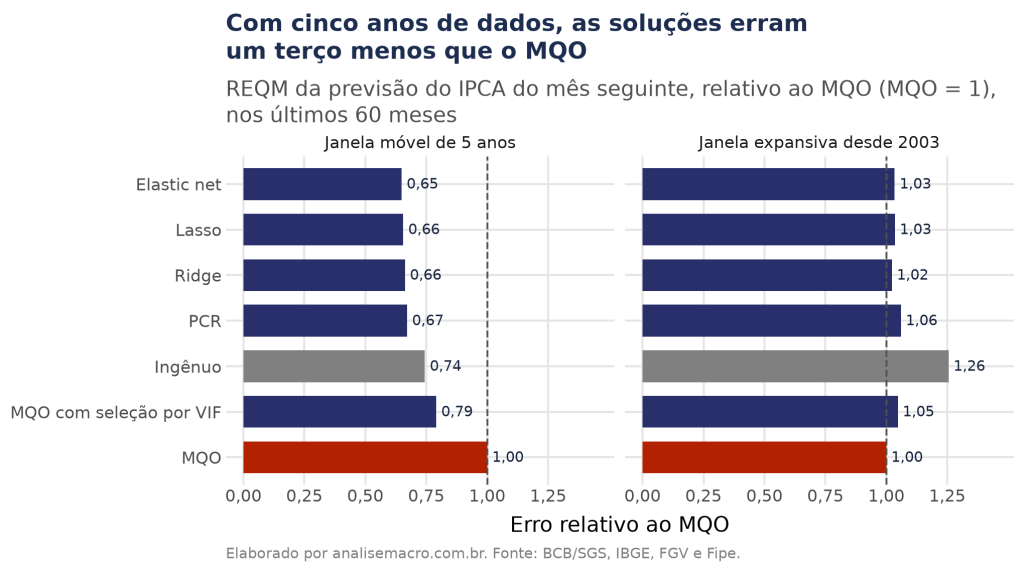
No nosso exemplo, com cinco anos de dados, as soluções erram cerca de um terço menos que o MQO, que perde até para a regra ingênua de repetir o IPCA do mês. Com todo o histórico desde 2003, a vantagem desaparece. Ao longo do post, vamos ver de onde vem essa diferença.
📩 Boletim AM
Receba análises e conteúdos sobre modelos estatísticos clássicos, econometria feita com hipóteses sérias e LLMs acessados em ambientes de trabalho reais, tudo aplicado à economia, ao mercado financeiro e à análise de dados.
O que a multicolinearidade faz com um modelo preditivo
A multicolinearidade acontece quando duas ou mais variáveis explicativas de uma regressão carregam quase a mesma informação. Um exemplo clássico é precificar imóveis usando, ao mesmo tempo, a área e o número de cômodos: as duas medem o tamanho do imóvel.
Quando isso acontece, o modelo tem dificuldade de separar o efeito de cada variável. As consequências aparecem em três lugares:
- Erros-padrão maiores, ou seja, estimativas menos precisas.
- Coeficientes sensíveis a pequenas variações dos dados, a ponto de trocar de sinal.
- Efeitos individuais difíceis de separar, mesmo com o ajuste global excelente.
O mecanismo por trás desses sintomas, com a variância do coeficiente crescendo conforme a correlação entre os regressores aumenta, é parte da teoria de mínimos quadrados, que revisamos em Regressão Linear para Séries Temporais.
Em previsão, a pergunta muda. Um coeficiente instável é um problema para quem quer interpretar o modelo, mas o que importa para quem prevê é o erro no mês seguinte. E a instabilidade só vira erro de previsão quando os coeficientes estimados mudam muito de uma amostra para outra.
Como diagnosticar: VIF e número de condição
A identificação do problema pode ser feita por algumas estatísticas, como o teste de Farrar e Glauber, a tolerância e o fator de inflação da variância (VIF). O VIF é a mais usada e mede quanto a variância do coeficiente de uma variável aumenta por causa da correlação dela com as demais.
Para calculá-lo, regredimos a variável k contra todas as outras explicativas e guardamos o R² dessa regressão:
Aqui R²k é a fração da variação da variável k que as outras explicativas conseguem reproduzir. Se elas não reproduzem nada, R²k = 0 e o VIF é 1. Se reproduzem 90%, o VIF é 10, e a variância do coeficiente fica dez vezes maior do que seria sem a colinearidade.
Com o VIF em mãos, costuma-se usar as seguintes regras de bolso:
- VIF = 1: sem multicolinearidade;
- VIF entre 1 e 10: multicolinearidade aceitável;
- VIF acima de 10: multicolinearidade problemática.
O limiar de 10 é uma convenção, sem derivação teórica. Ele funciona como alerta, e não diz sozinho se a previsão vai piorar.
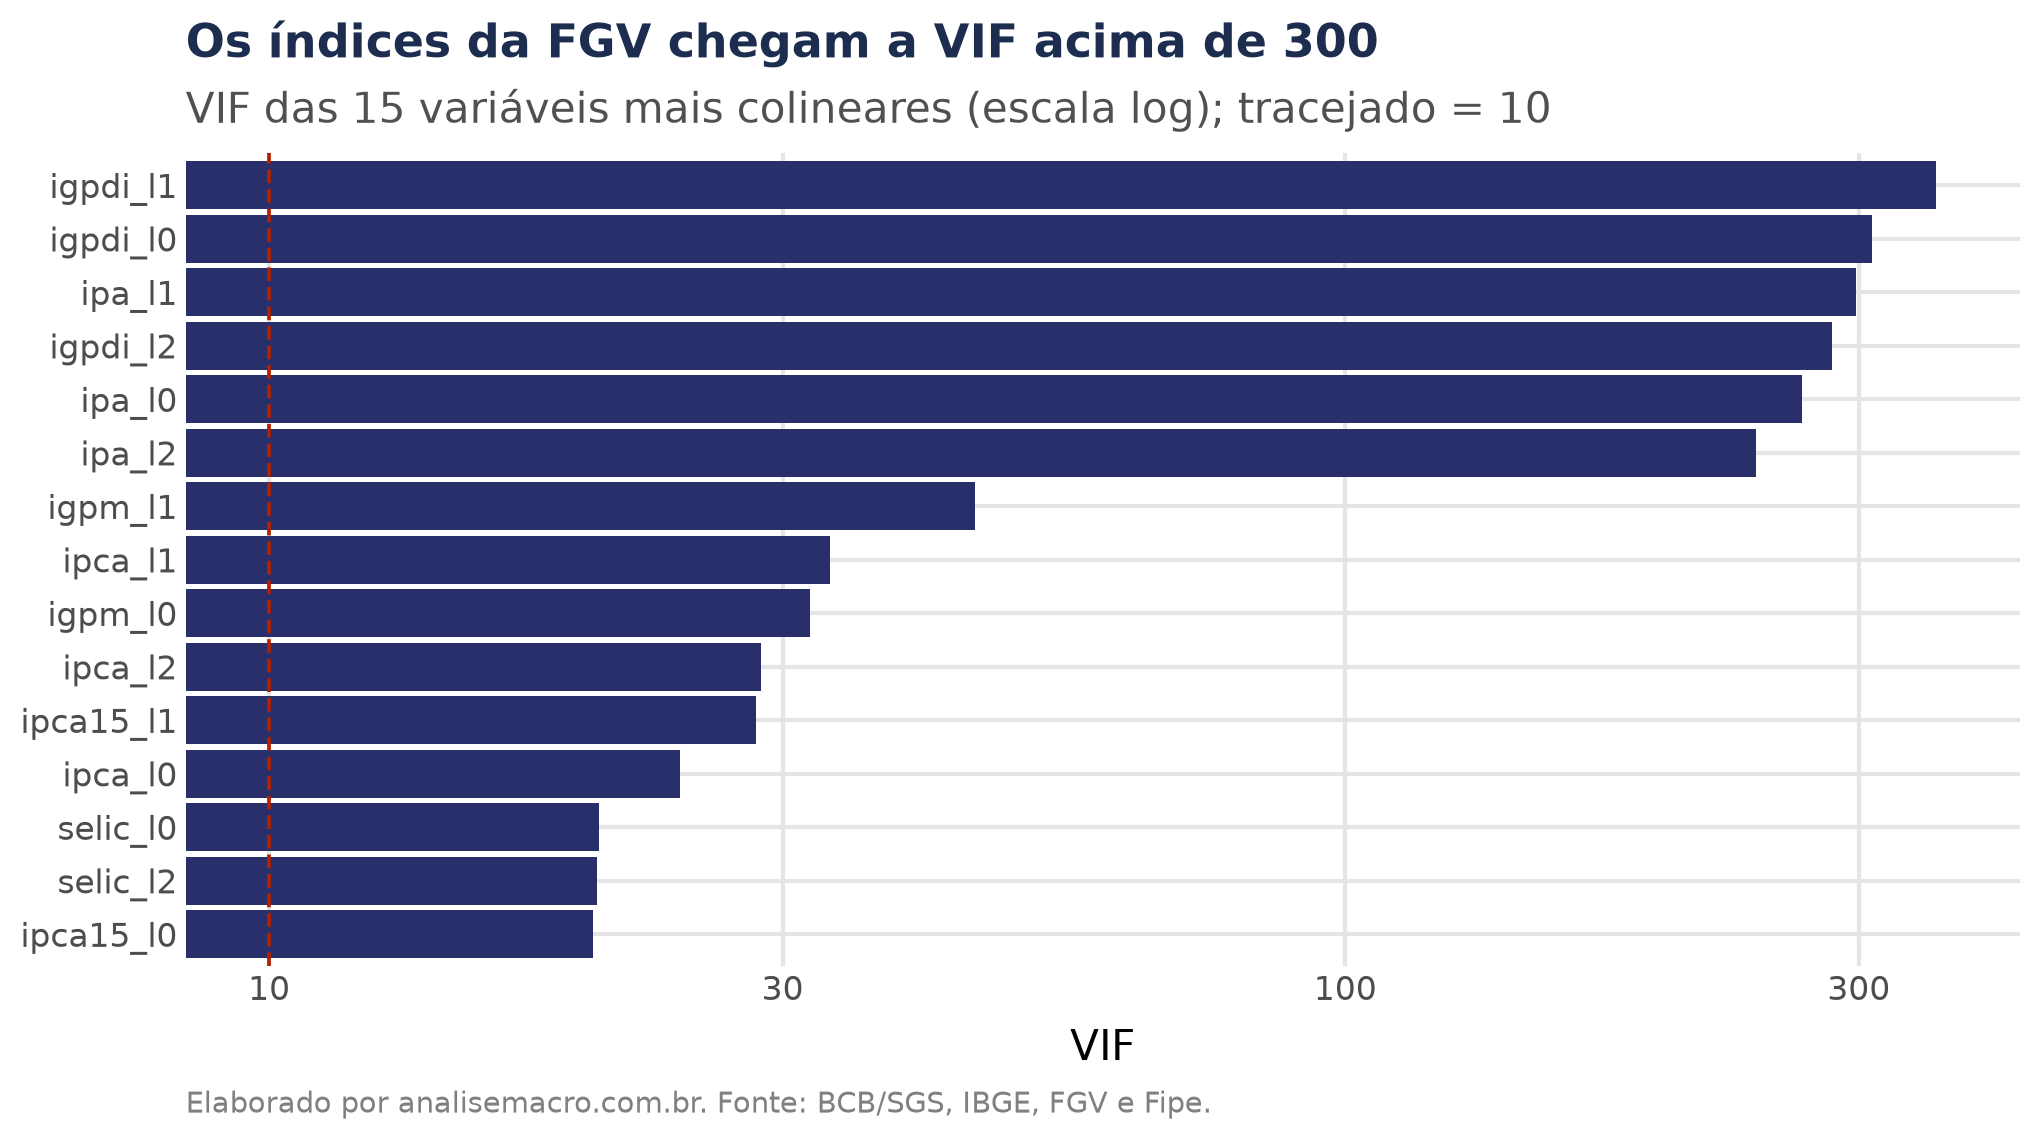
No nosso exemplo, o IGP-DI defasado em um mês chega a VIF de 354. O IPA, que é o componente de preços ao produtor e responde por 60% do IGP-DI, passa de 260. Já o IPCA e o IPCA-15 ficam entre 20 e 33, ainda bem acima do limiar.
O VIF olha uma variável por vez. O número de condição olha a matriz inteira de variáveis padronizadas: é a razão entre o maior e o menor valor singular dela.
Um valor singular σmín pequeno indica uma combinação de variáveis que é quase constante. O MQO precisa inverter a matriz Z⊤Z, e nessa direção a inversão amplifica qualquer ruído dos dados.
Belsley, Kuh e Welsch propuseram que valores acima de 30 indicam colinearidade forte. No nosso exemplo, o número de condição é de 97.
Como resolver multicolinearidade: as soluções
As soluções se dividem em três famílias. Todas aceitam um pouco de viés nos coeficientes em troca de uma redução grande na variância deles.
Seleção de variáveis pelo VIF
A solução mais direta é retirar variáveis: calculamos o VIF, retiramos a de maior valor e repetimos até todos ficarem abaixo de 10.
O problema é que o VIF decide pela redundância entre as explicativas, sem olhar para o alvo. No nosso exemplo, a seleção retira 11 das 30 variáveis econômicas, e o próprio IPCA do mês está entre elas.
Ridge, lasso e elastic net
A regularização mantém todas as variáveis e muda o critério de estimação. Além de minimizar a soma dos erros ao quadrado, o modelo paga uma penalidade pelo tamanho dos coeficientes. A ridge penaliza a soma dos quadrados:
Aqui yt é o IPCA a prever, xt as variáveis explicativas, β os coeficientes e λ a força da penalidade. Com λ = 0, voltamos ao MQO; conforme λ cresce, os coeficientes encolhem em direção a zero.
Por que isso resolve a colinearidade? A ridge soma λ à diagonal da matriz Z⊤Z antes de invertê-la. Isso afasta de zero as direções quase constantes, e a inversão deixa de amplificar o ruído. Na prática, variáveis colineares passam a dividir o peso entre si.
O lasso troca o quadrado pelo valor absoluto, λ Σ|βj|. Com isso, alguns coeficientes chegam exatamente a zero, e o modelo seleciona variáveis enquanto estima. Diante de um grupo colinear, porém, ele tende a escolher uma variável e zerar as outras de forma pouco estável. A mesma ideia de seleção aparece em Seleção de Fatores via Machine Learning.
O elastic net combina as duas penalidades, com um peso α entre elas:
A parte absoluta zera variáveis, como no lasso; a parte quadrática mantém juntas as variáveis colineares, como na ridge.
A padronização vem antes da regularização. A penalidade soma os coeficientes de todas as variáveis, e o tamanho de um coeficiente depende da unidade da variável. Sem padronizar, a Selic e a variação do dólar seriam penalizadas de forma diferente só pela escala. E a média e o desvio usados na padronização saem só da amostra de treino, para que o modelo não enxergue o futuro.
Regressão por componentes principais (PCR)
A análise de componentes principais reescreve as variáveis como combinações lineares não correlacionadas entre si, ordenadas pela variância que explicam. A PCR estima o MQO com os primeiros componentes, que são ortogonais por construção. A técnica está explicada passo a passo em Como usar o PCA para Analisar Ações.
O custo é parecido com o da seleção pelo VIF: os componentes são escolhidos pela variância das explicativas, sem olhar para o alvo.
Como escolher o λ: validação cruzada temporal
O λ da ridge e do lasso, o par (λ, α) do elastic net e o número de componentes da PCR não saem da estimação. São hiperparâmetros, e o critério para escolhê-los é o erro de previsão fora da amostra de estimação, medido por validação cruzada.
Em dados de corte transversal, como imóveis, a validação usual é o k-fold: a amostra é dividida em partes aleatórias, e cada parte serve uma vez como teste. Em série temporal, embaralhar as observações faz o modelo treinar com o futuro para prever o passado, e o erro estimado sai otimista.
Por isso, usamos a validação temporal. A amostra é cortada em blocos em ordem cronológica, e cada bloco é previsto por um modelo treinado só com os meses anteriores. As duas variantes estão comparadas em Validação Cruzada: técnicas para dados ordenados e não ordenados.
O exemplo: prever o IPCA com oito índices de preços
O Brasil tem vários índices de inflação. Cada um mede os preços com uma cesta, uma região ou um período de coleta diferente, mas todos respondem aos mesmos choques de alimentos, combustíveis, câmbio e energia. É isso que os torna colineares.
Coletamos do Sistema Gerenciador de Séries Temporais (SGS) do Banco Central, com a biblioteca python-bcb, as variações mensais de IPCA, INPC, IPCA-15, IPC-Fipe, IPC-Br, IGP-M, IGP-DI e IPA, desde 2003. Somamos a Selic acumulada no mês e a variação do dólar.
Cada série entra no mês corrente e defasada em um e dois meses, o que dá 30 variáveis. Mais 11 indicadoras de mês capturam a sazonalidade do IPCA. Ficamos com 281 meses e 41 variáveis para prever o IPCA do mês seguinte, numa regressão linear com estrutura de Regressão Linear para Séries Temporais.
Os modelos foram estimados com o scikit-learn, sempre num pipeline que padroniza antes de estimar. Para cada um dos últimos 60 meses, de outubro de 2021 a setembro de 2026, reestimamos todos os modelos só com os dados disponíveis até ali e guardamos o erro da previsão.
Fizemos isso com duas janelas de estimação. A janela móvel usa só os cinco anos mais recentes, o que acompanha mudanças de regime, mas deixa 60 observações para 41 variáveis. A janela expansiva usa todo o histórico desde 2003, com mais de 220 observações.
O erro de cada modelo é resumido pela raiz do erro quadrático médio (REQM), em pontos percentuais do IPCA mensal:
Aqui πh é o IPCA efetivo, π̂h a previsão e H = 60 o número de meses avaliados.
| Modelo | REQM, janela móvel (p.p.) | Relativo ao MQO | REQM, janela expansiva (p.p.) | Relativo ao MQO |
|---|---|---|---|---|
| Elastic net | 0,366 | 0,65 | 0,346 | 1,03 |
| Lasso | 0,370 | 0,66 | 0,346 | 1,03 |
| Ridge | 0,374 | 0,66 | 0,342 | 1,02 |
| PCR | 0,379 | 0,67 | 0,354 | 1,06 |
| Ingênuo (repete o IPCA do mês) | 0,420 | 0,74 | 0,420 | 1,26 |
| MQO com seleção por VIF | 0,446 | 0,79 | 0,350 | 1,05 |
| MQO | 0,564 | 1,00 | 0,334 | 1,00 |
Erro de previsão do IPCA do mês seguinte, outubro de 2021 a setembro de 2026. Fontes: BCB/SGS, IBGE, FGV e Fipe.
Na janela móvel, o MQO é o pior modelo e erra mais que a previsão ingênua. Com 60 observações para 41 variáveis colineares, ele ajusta o ruído da amostra, e esse ajuste não se repete no mês seguinte. Todas as soluções o superam: o elastic net fica com 65% do erro do MQO, e a seleção pelo VIF, com 79%.
Na janela expansiva, o MQO estima as 41 variáveis com precisão suficiente, e as soluções ficam entre 2% e 6% acima dele. Os VIFs continuam os mesmos, mas a colinearidade deixou de custar previsão.
Ou seja, a multicolinearidade prejudica a previsão quando se soma a uma amostra curta em relação ao número de variáveis. É nesse caso que resolvê-la reduz o erro de previsão.
Por dentro da ridge
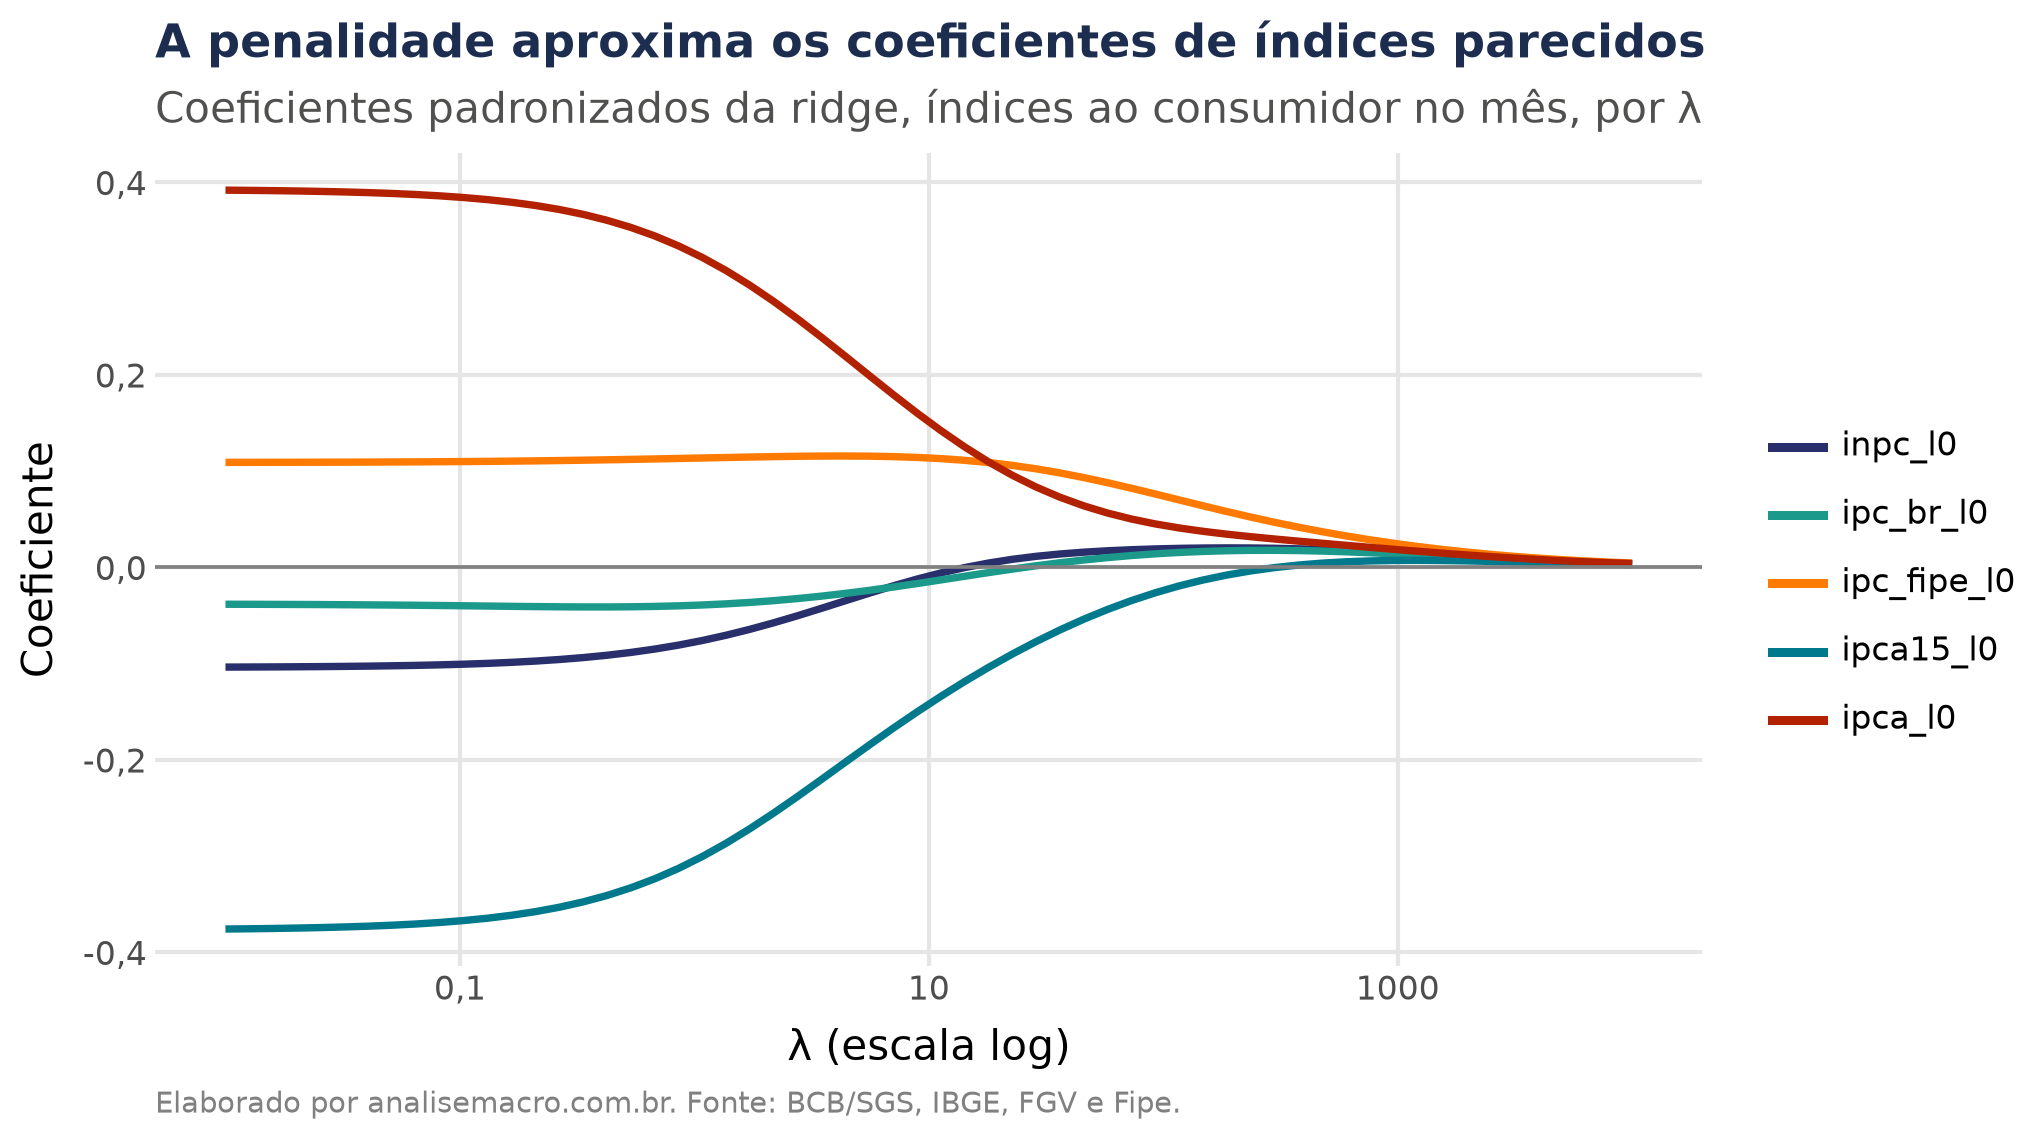
Com λ perto de zero, a ridge reproduz o MQO. Na figura acima, o IPCA do mês recebe coeficiente de 0,39 e o IPCA-15, de −0,37: o modelo compensa o peso positivo de um índice com o peso negativo de outro quase igual.
Conforme λ cresce, os dois coeficientes se aproximam e encolhem juntos. É essa compensação desfeita que deixa a previsão menos sensível a um movimento atípico de um único índice.
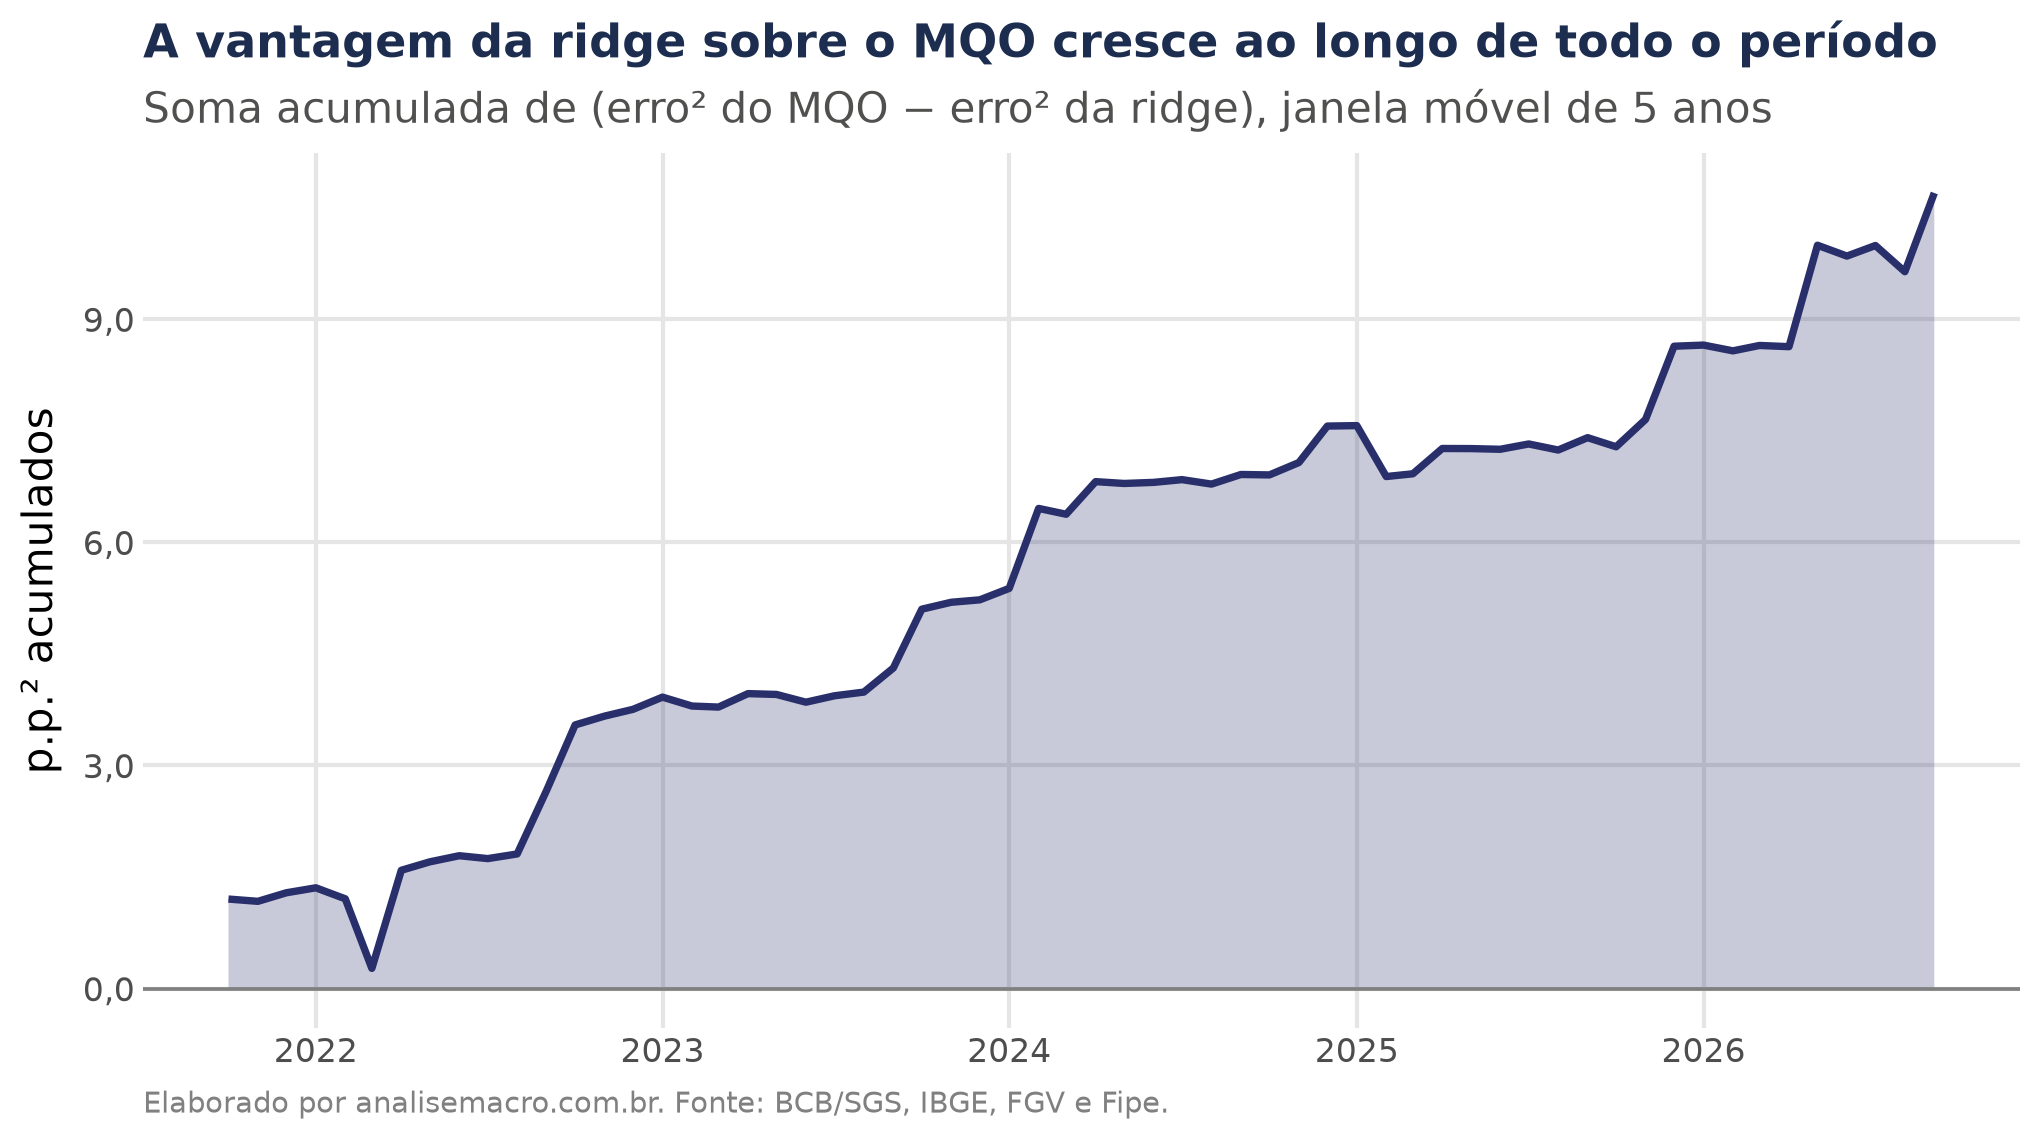
A curva soma, mês a mês, o erro quadrático do MQO menos o da ridge. Ela sobe ao longo dos cinco anos, com degraus nos meses em que o MQO se afastou muito do IPCA efetivo. A vantagem da ridge, portanto, se acumula em todo o período.
O exercício tem limites. Avaliamos 60 meses de um único alvo, e a diferença entre modelos próximos, como ridge e lasso, não passou por um teste formal de igualdade de previsões, como o de Diebold-Mariano. Também usamos as séries já revisadas.
Aplicações práticas
- Previsão de inflação: as projeções de curto prazo combinam dezenas de índices, núcleos e preços livres e administrados, quase todos correlacionados.
- Modelos de atividade e nowcasting: produção industrial, vendas, confiança e crédito andam juntos, e os modelos com muitas séries dependem de regularização ou de fatores.
- Fatores de risco em carteiras: retornos de ações do mesmo setor são colineares, e PCA e lasso ajudam a reduzir o número de fatores.
- Modelos de crédito: renda, patrimônio e limite de cartão medem coisas próximas, e a ridge estabiliza os pesos do escore.
Considerações finais
Diagnosticar a multicolinearidade é a parte mais simples: o VIF e o número de condição mostram onde ela está. Decidir se ela atrapalha a previsão exige outro passo, que é medir o erro fora da amostra, com validação temporal, contra o MQO e contra uma regra ingênua.
Em Python, esse caminho inteiro cabe em poucas bibliotecas: python-bcb para os dados, statsmodels para o diagnóstico, scikit-learn para os modelos e a validação, plotnine para os gráficos. O mesmo roteiro serve a quase todo problema de previsão com muitas variáveis:
- Economistas: projetar inflação e atividade com muitos indicadores sem coeficientes explosivos.
- Analistas de dados: escolher entre seleção de variáveis e regularização pelo erro de previsão.
- Gestores e analistas de risco: estimar fatores de risco estáveis em carteiras com ativos parecidos.
- Cientistas de dados em crédito: construir escores com variáveis redundantes sem perder estabilidade.
Aprenda a construir modelos de previsão em Python
Na Formação do Zero à Análise de Dados Econômicos e Financeiros usando Python e IA, você aprende a coletar, tratar, modelar e apresentar dados econômicos, do primeiro código até modelos como os deste post. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências: Belsley, Kuh e Welsch (1980), Regression Diagnostics; Hoerl e Kennard (1970), Technometrics; Tibshirani (1996), JRSS-B; Zou e Hastie (2005), JRSS-B; Hastie, Tibshirani e Friedman (2009), The Elements of Statistical Learning.
Leia também:
📩 A ferramenta é meio caminho. O outro é o método
Coletar e tratar o dado é a parte que a IA já encurtou. O que continua sendo seu é saber qual pergunta fazer e como checar a resposta. No Boletim AM eu mostro, todo dia, estatística, econometria e IA aplicadas à economia, mercado financeiro e análise de dados.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.