Uma regressão linear para séries temporais estima a relação entre variáveis observadas ao longo do tempo, como consumo e renda ou inflação e desemprego. A conta é a mesma dos mínimos quadrados, mas a ordem temporal faz os erros do modelo se comportarem de outro jeito, e é isso que precisamos diagnosticar e corrigir.
Neste exercício em Python, com séries do IBGE e do Banco Central, estimamos a relação entre o consumo das famílias e o PIB e uma Curva de Phillips com o IPCA e a taxa de desocupação, aplicamos os testes de Breusch-Pagan, White, Durbin-Watson e Breusch-Godfrey e recalculamos os erros padrão de forma robusta e pelo método de Newey-West.
📩 Boletim AM
Receba análises e conteúdos sobre modelos estatísticos clássicos, econometria feita com hipóteses sérias e LLMs acessados em ambientes de trabalho reais, tudo aplicado à economia, ao mercado financeiro e à análise de dados.
O que é uma série temporal
Uma série temporal é uma sequência de observações de uma mesma variável tomadas em intervalos regulares de tempo. A taxa de desemprego mensal, a Selic diária e o PIB trimestral são exemplos, e a econometria que lida com elas também é usada na engenharia, nas finanças e nas ciências naturais.
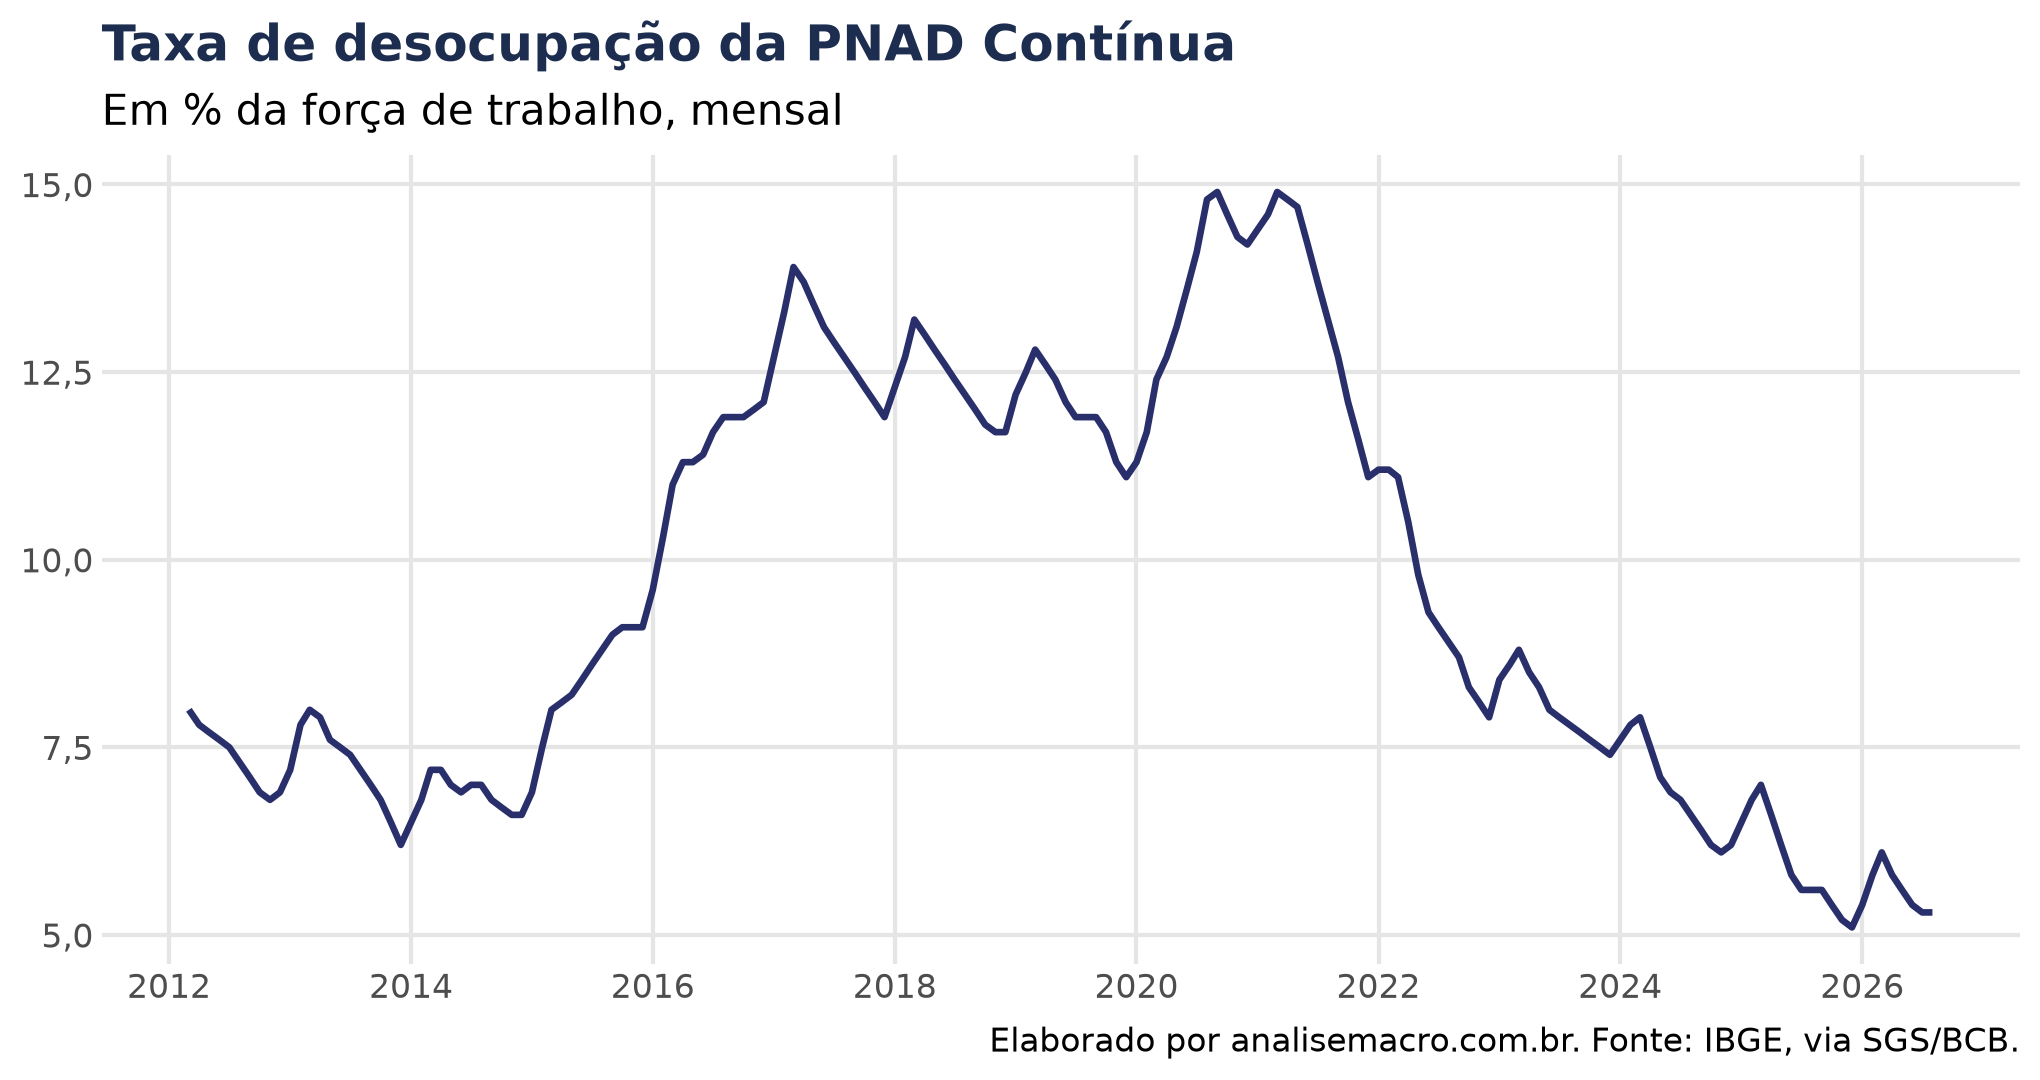
A forma natural de enxergar uma série temporal é o gráfico de linha, com o tempo no eixo horizontal. No exercício, a taxa de desocupação da PNAD Contínua vem direto da API do Banco Central pelo pacote python-bcb. Como o IBGE organiza esse indicador e como ele oscila ao longo do ciclo econômico está em Avaliando os Ciclos da Taxa de Desocupação Brasileira.
Processo estocástico e processo gerador dos dados
A taxa de desocupação de um mês é apenas um dos valores que poderiam ter ocorrido. Com outra safra ou outra política monetária, o IBGE teria registrado um número diferente.
Por isso tratamos cada observação yt como o valor sorteado de uma variável aleatória. A sequência dessas variáveis ao longo do tempo é um processo estocástico (Pfaff, 2008), e a série que observamos é uma única realização dele:
Aqui yt é o valor da série na data t, e T é o número de períodos observados.
O processo desconhecido que produziu essa trajetória é o processo gerador dos dados. Como só vemos uma realização, o trabalho do econometrista é inferir o processo a partir dela; quanto melhor essa inferência, melhores o modelo e as previsões (Bueno, 2011). Uma das propriedades que mais pesam nessa inferência é a estacionariedade, explicada em Estacionariedade de Séries Temporais.
Regressão linear com séries temporais: consumo e PIB no Brasil
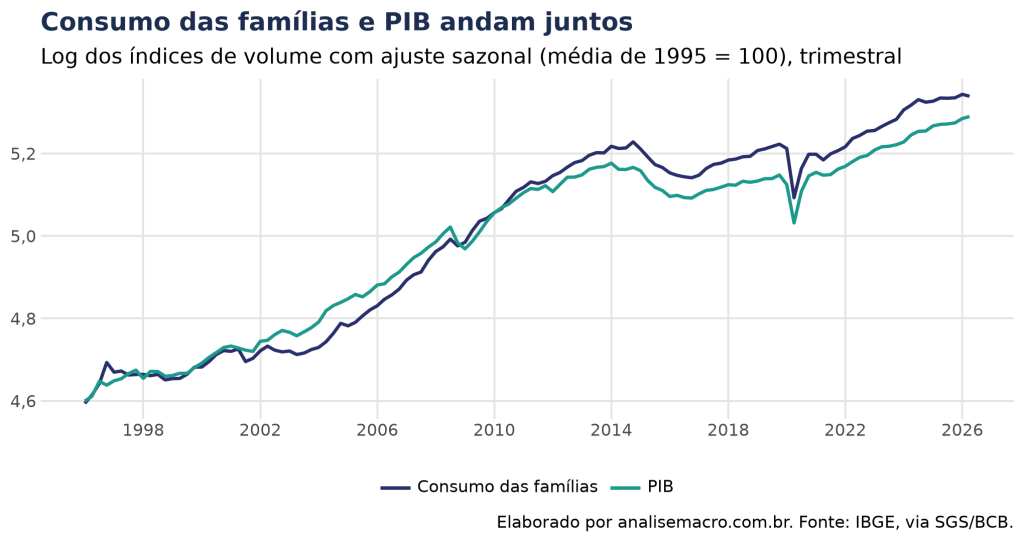
Quanto o consumo das famílias responde quando a renda da economia cresce? Para responder, usamos as Contas Nacionais Trimestrais do IBGE, que o Banco Central republica no SGS: o índice de volume do PIB (código 22109) e o da despesa de consumo das famílias (código 22110), com ajuste sazonal, desde 1996.
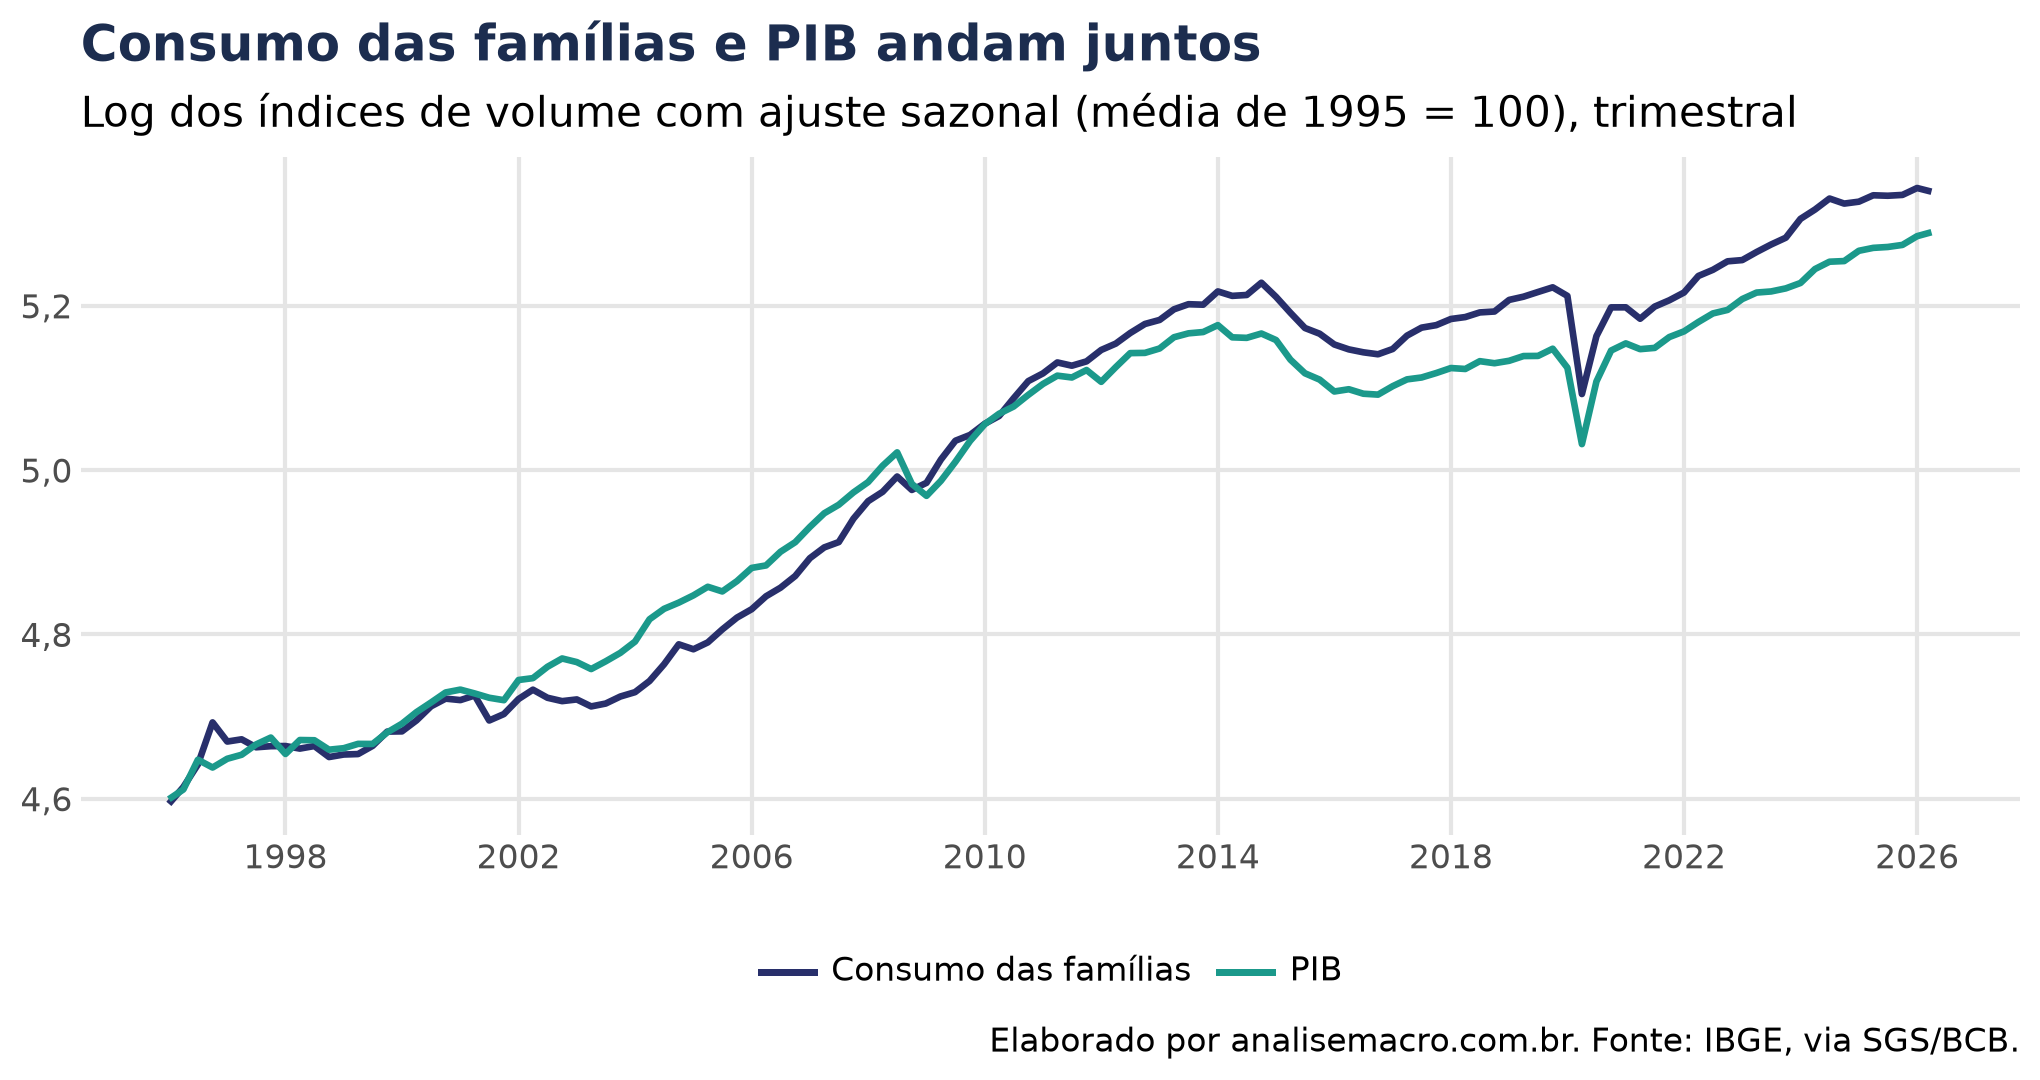
As duas séries crescem juntas, com as quedas da recessão de 2015 e 2016 e da pandemia aparecendo nas duas. Como são índices, trabalhamos com o logaritmo delas, e o coeficiente vira uma elasticidade: quantos por cento o consumo varia quando o PIB varia 1%. Com séries temporais, a regressão também pode incluir o passado das variáveis por meio de defasagens, isto é, o valor da variável no período anterior.
Usamos duas especificações clássicas (Greene, 2003). A primeira é um modelo de defasagens distribuídas, em que o consumo responde ao PIB de hoje e ao do trimestre anterior:
A segunda é um modelo autorregressivo com defasagem distribuída, em que o consumo de hoje depende do PIB de hoje e do próprio consumo do trimestre anterior, o que capta o hábito das famílias:
Nas duas equações, ct é o log do consumo das famílias no trimestre t, yt é o log do PIB, os β são os coeficientes estimados e εt é o erro, a parte do consumo que o modelo não explica.
No nosso exemplo, o modelo de defasagens dá elasticidade de 0,66 ao PIB do trimestre e de 0,49 ao do trimestre anterior, as duas significativas. No modelo autorregressivo, o consumo defasado tem coeficiente de 0,71 e a elasticidade do PIB corrente cai para 0,33: boa parte do consumo de um trimestre é explicada pelo consumo do trimestre anterior.
Valores ajustados e resíduos
O resíduo é a diferença entre o valor observado e o valor que o modelo prevê para cada período. É nele que aparecem os problemas de uma regressão com séries temporais.
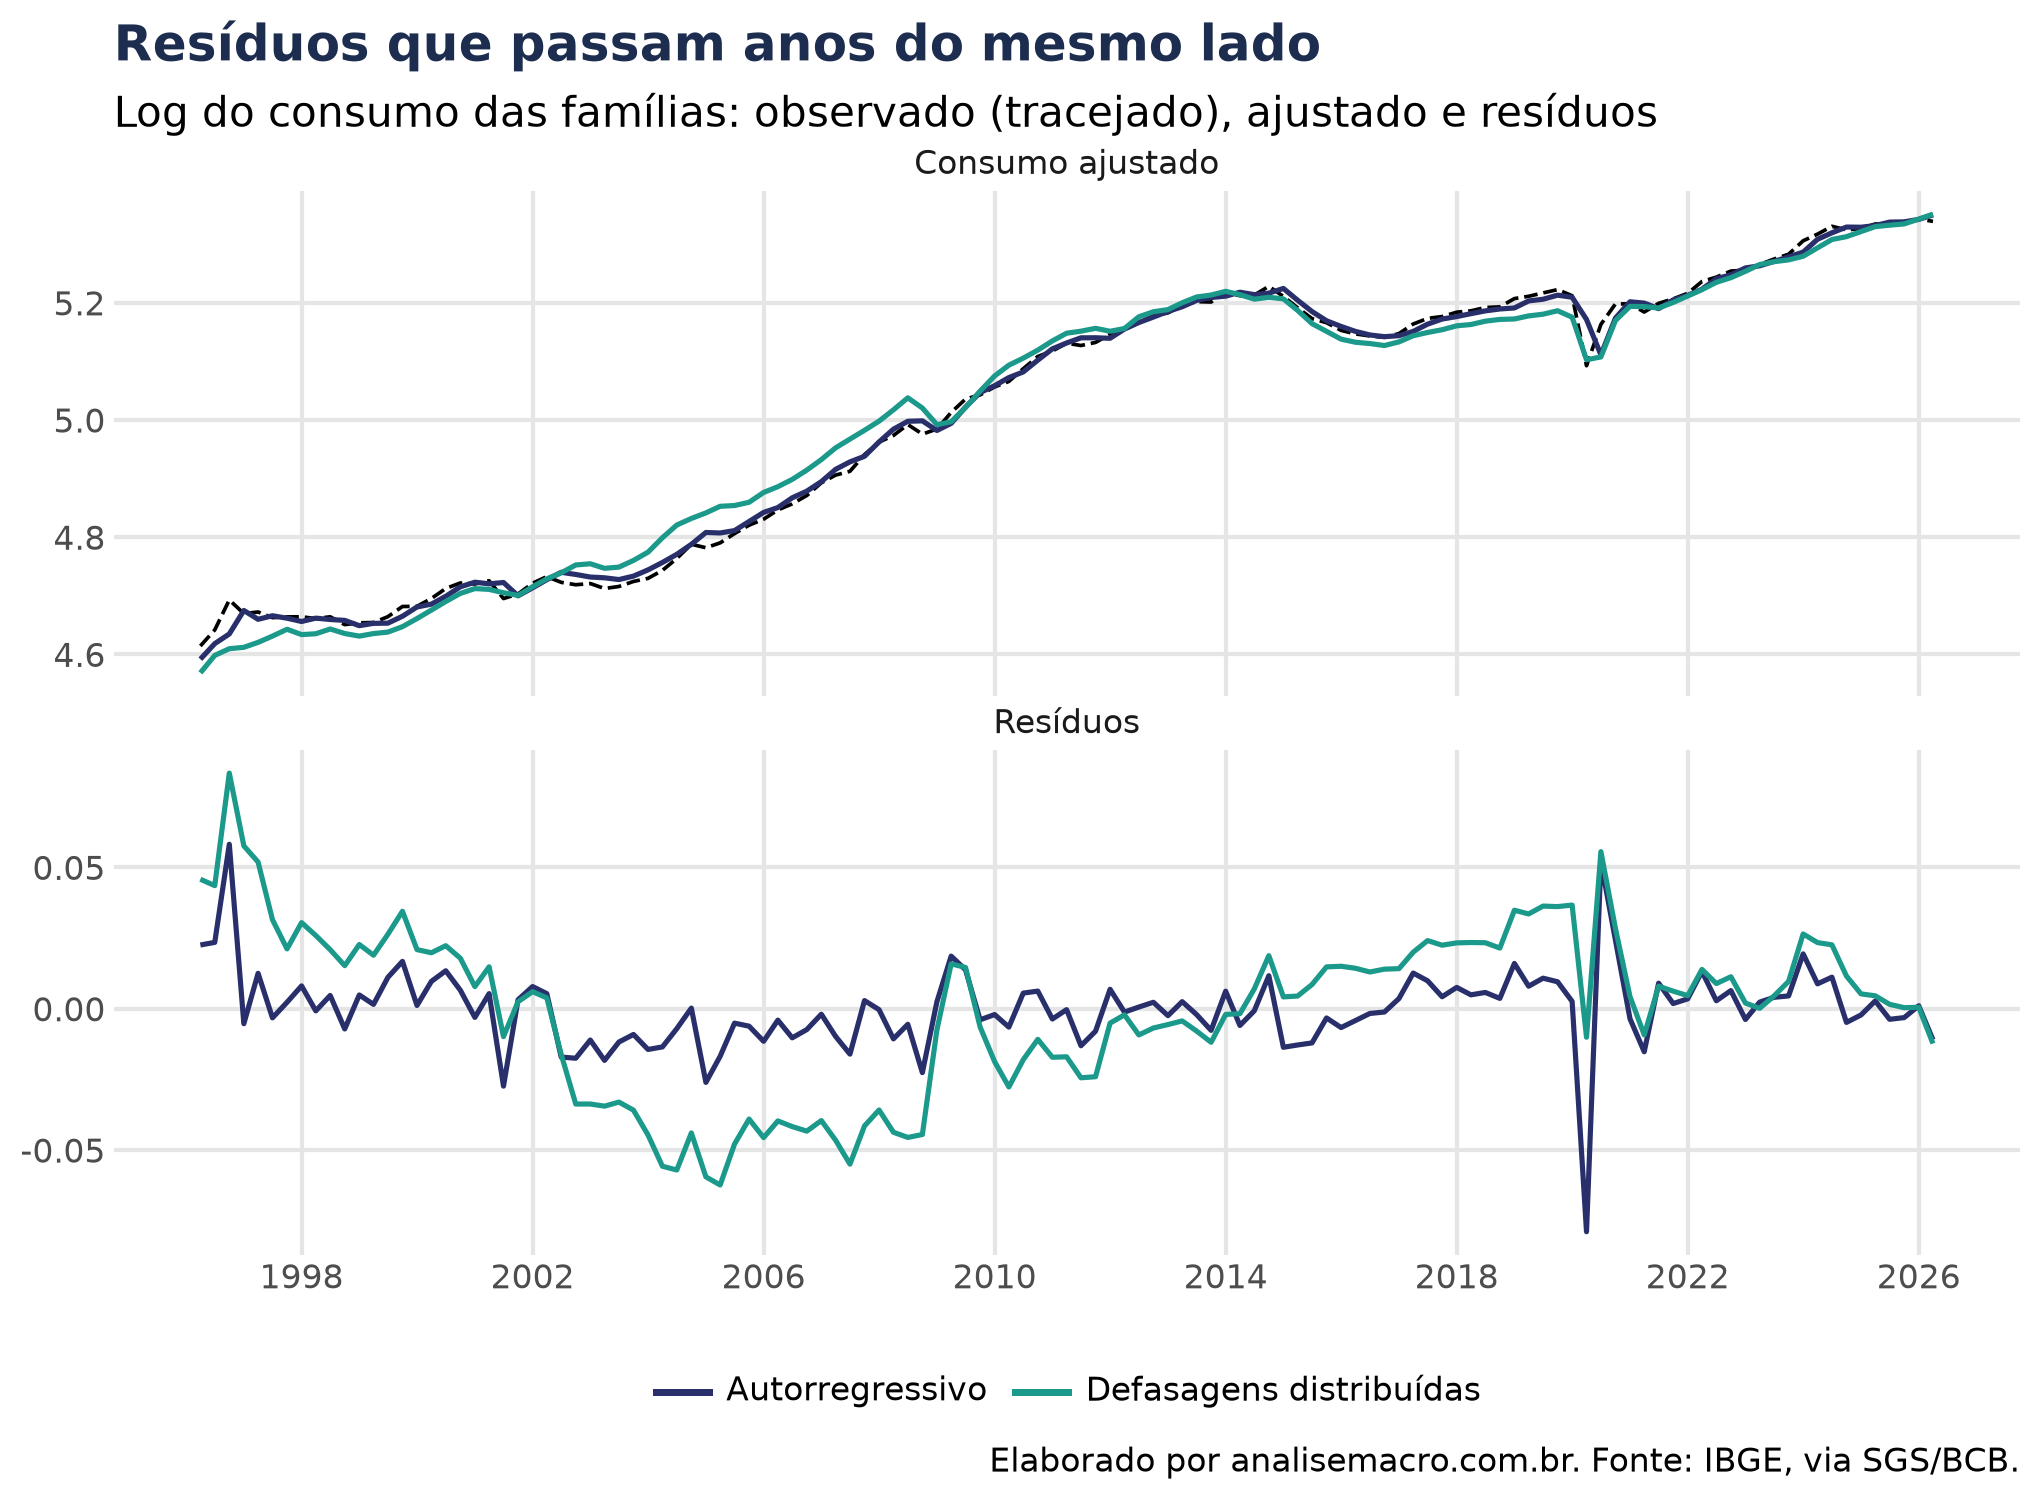
Os dois modelos acompanham o consumo de perto. Os resíduos do modelo de defasagens, porém, passam anos seguidos do mesmo lado do zero, enquanto os do modelo autorregressivo trocam de sinal com mais frequência, mas têm um salto visível na pandemia. A pergunta seguinte é se esses resíduos respeitam as hipóteses da regressão.
Heterocedasticidade e autocorrelação: o que a regressão supõe sobre os erros
Os mínimos quadrados supõem que todos os erros têm a mesma variância e que o erro de um período não carrega informação sobre o erro de outro. Essas duas hipóteses aparecem na matriz de covariância dos erros, que reúne a variância de cada erro na diagonal e a covariância entre cada par de erros fora dela:
σ2000σ2000σ2
Nessa matriz, σ2 é a variância comum dos erros e I é a matriz identidade. A diagonal igual expressa a variância constante; os zeros fora dela, a ausência de correlação entre erros.
Heterocedasticidade: a variância do erro muda entre as observações, ou seja, a diagonal da matriz deixa de ter o mesmo σ2. Em séries macroeconômicas, isso costuma acontecer quando crises, como a pandemia, trazem choques muito maiores que os de períodos calmos.
Autocorrelação: o erro de um período está correlacionado com o de outros períodos, ou seja, as células vizinhas da diagonal deixam de ser zero. É típica de séries temporais, porque um choque que tira a inflação da trajetória costuma persistir nos meses seguintes.
Os dois problemas não mudam os coeficientes estimados, que continuam válidos. O que fica errado são os erros padrão, e com eles os testes t, os p-valores e os intervalos de confiança. Ou seja, podemos declarar significativa uma variável que não é. Uma forma visual de procurar autocorrelação antes de qualquer teste é a função de autocorrelação, tema de Construindo uma análise exploratória envolvendo funções de autocorrelação.
Como testar a heterocedasticidade
O teste de Breusch-Pagan verifica se a variância dos resíduos depende das variáveis explicativas. Estimamos o modelo, guardamos os resíduos e regredimos os resíduos ao quadrado contra as mesmas variáveis explicativas:
Aqui ei é o resíduo da observação i, os x são as variáveis explicativas e n é o número de observações. A estatística LM multiplica o R2 dessa segunda regressão por n: se as variáveis explicam o tamanho dos resíduos, a variância não é constante. A hipótese nula é de homocedasticidade.
No exercício, aplicamos o teste aos dois modelos de consumo. Nos dois, o p-valor fica abaixo de 1% (LM de 25,2 no modelo de defasagens e de 14,7 no autorregressivo), e rejeitamos a homocedasticidade: a variância dos erros do consumo muda ao longo da amostra.
O teste de White é uma variação que usa, na segunda regressão, os valores ajustados ĉ e o seu quadrado, o que capta formas não lineares de heterocedasticidade. No modelo autorregressivo, ele não rejeita a homocedasticidade (p-valor de 0,86), ao contrário do Breusch-Pagan. A diferença está na segunda regressão: o Breusch-Pagan usa o PIB e o consumo defasado separadamente, e o White os resume no valor ajustado, perdendo essa informação. Na dúvida, a escolha prudente é corrigir os erros padrão.
Como testar a autocorrelação
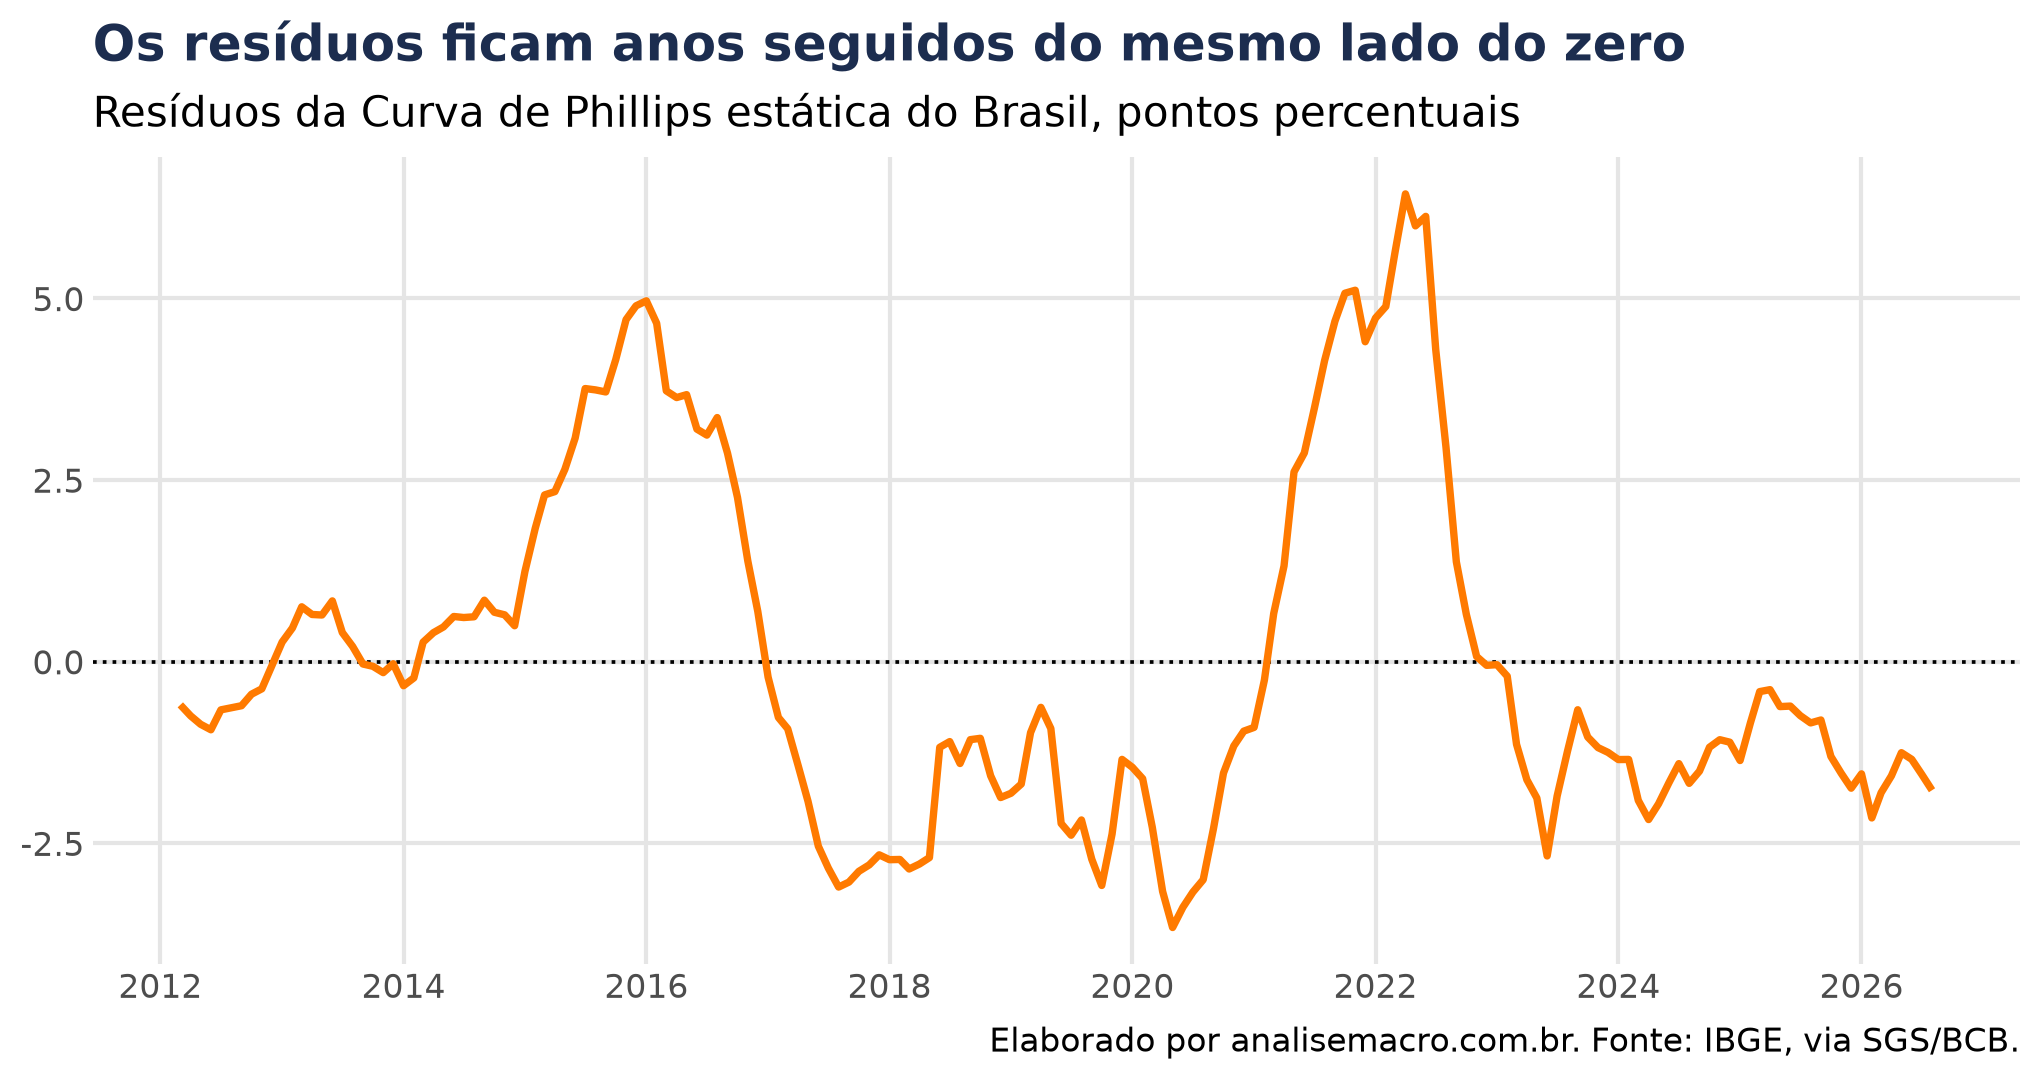
Na Curva de Phillips brasileira estimada por mínimos quadrados, os resíduos ficam acima do zero nos surtos inflacionários de 2015 e 2016 e de 2021 e 2022, e abaixo dele nos anos de inflação mais baixa. Erros que passam anos seguidos do mesmo lado do zero são o sinal visual da autocorrelação, e é isso que os testes desta seção medem.
O teste mais direto regride o resíduo de cada período contra o resíduo do período anterior (Wooldridge, 2013):
O coeficiente ρ mede quanto do erro de ontem passa para o erro de hoje. Na Curva de Phillips estática do gráfico acima, que explica o IPCA acumulado em 12 meses pela taxa de desocupação do mesmo mês, de 2012 até o dado mais recente, estimamos ρ de 0,98 com estatística t de 62,8. A Curva de Phillips em si, com versões mais completas para o Brasil, está em Estimando uma Curva de Phillips para o Brasil.
O teste de Durbin-Watson resume a mesma ideia numa estatística:
Sem autocorrelação, ρ̂ fica perto de zero e DW perto de 2; com autocorrelação positiva forte, DW se aproxima de 0. No nosso exemplo, DW foi de 0,04 na Curva de Phillips e de 0,20 no modelo de defasagens do consumo. No modelo autorregressivo, ficou em 1,77: incluir o consumo defasado absorve a persistência que, no outro modelo, sobrava nos resíduos.
Os dois testes olham só para a primeira defasagem. O teste de Breusch-Godfrey acrescenta mais defasagens dos resíduos e testa se todas são conjuntamente zero, o que capta autocorrelação de ordens maiores. Na Curva de Phillips, com 12 defasagens, ele também rejeita com folga a ausência de autocorrelação.
Como corrigir: erros padrão robustos e de Newey-West
A correção mais usada mantém os coeficientes e recalcula a matriz de covariância deles sem supor variância constante. Em vez de um σ2 único, cada observação entra com o seu próprio resíduo ao quadrado:
Aqui X é a matriz das variáveis explicativas e xi é a linha da observação i. A fórmula tem formato de sanduíche: o termo do meio carrega a variância de cada observação, e os dois (X′X)−1 são o pão. São os erros padrão robustos à heterocedasticidade, que no statsmodels saem com cov_type="HC3". No modelo autorregressivo do consumo, eles ficam cerca de três vezes maiores que os usuais: a estatística t do PIB cai de 7,9 para 2,8 e a do consumo defasado, de 20,0 para 6,9. As duas variáveis continuam significativas, mas a precisão que os erros usuais sugeriam era exagerada.
Quando há heterocedasticidade e autocorrelação ao mesmo tempo, o termo do meio também recebe as covariâncias entre resíduos próximos no tempo, com pesos que caem conforme a distância aumenta. São os erros padrão HAC (consistentes na presença de heterocedasticidade e autocorrelação), também chamados de Newey-West.
No exercício, aplicamos a correção às duas regressões com autocorrelação forte: a Curva de Phillips, com 12 defasagens por ser mensal, e o modelo de defasagens distribuídas do consumo, com 4 defasagens por ser trimestral.
| Regressão e variável | Coeficiente | Erro padrão usual | Erro padrão Newey-West | t usual | t Newey-West |
|---|---|---|---|---|---|
| Phillips: desocupação | −0,058 | 0,063 | 0,153 | −0,91 | −0,38 |
| Consumo: PIB do trimestre | 0,660 | 0,167 | 0,210 | 3,94 | 3,15 |
| Consumo: PIB do trimestre anterior | 0,489 | 0,166 | 0,208 | 2,94 | 2,35 |
Com Newey-West, os erros padrão aumentam nas duas regressões. Na Curva de Phillips, o erro padrão da desocupação mais que dobra, e o coeficiente, que já não era significativo, fica ainda mais longe disso. No consumo, as elasticidades do PIB corrente e defasado continuam significativas a 5%, com estatísticas t menores. Os erros usuais tratavam meses e trimestres correlacionados como se fossem informações independentes e exageravam a precisão das estimativas.
Como o exercício é feito em Python
O exercício segue quatro etapas, todas com bibliotecas abertas:
- Coleta: o python-bcb traz do SGS do Banco Central o PIB e o consumo das famílias trimestrais, o IPCA e a taxa de desocupação.
- Tratamento: o pandas cria as defasagens e organiza as tabelas.
- Estimação e testes: o statsmodels estima as regressões por fórmula e aplica Breusch-Pagan, White, Durbin-Watson, Breusch-Godfrey e as correções HC3 e HAC.
- Visualização: o plotnine desenha os gráficos com a gramática do ggplot2.
O passo que mais costuma ser pulado é o terceiro: estimar a regressão e ler os p-valores sem testar os resíduos. Os fundamentos da estimação por mínimos quadrados estão em Regressão Linear [R e Python], e quando o problema é uma variável explicativa correlacionada com o erro, a saída é outra, descrita em Mínimos Quadrados em 2 Estágios (TSLS).
Aplicações práticas
- Curva de Phillips e regra de juros: estimar a relação entre inflação, desemprego e juros com dados mensais ou trimestrais, em que a autocorrelação dos resíduos é quase certa.
- Repasse cambial e inércia inflacionária: medir quanto do câmbio e da inflação passada chega aos preços, com defasagens distribuídas.
- Consumo e atividade: medir quanto o consumo das famílias responde à renda e projetar o PIB pelo lado da demanda.
- Finanças: regressões de retornos contra fatores de risco, em que a volatilidade muda ao longo do tempo e os erros robustos são o padrão.
Considerações finais
Rodar uma regressão com séries temporais leva uma linha de código. Saber se o resultado merece confiança exige olhar os resíduos, testar heterocedasticidade e autocorrelação e, quando elas aparecem, recalcular os erros padrão. No nosso exemplo, essa etapa mostrou que a Curva de Phillips estática deixa de fora a dinâmica da inflação e que os erros usuais exageravam a precisão das elasticidades do consumo.
Esse roteiro serve a quem trabalha com dados ao longo do tempo:
- Economistas: estimar relações macroeconômicas com inferência confiável.
- Analistas de mercado: testar se um indicador antecedente explica de fato uma variável de interesse.
- Gestores e analistas de risco: estimar exposições a fatores sem subestimar a incerteza.
- Pesquisadores e estudantes: entregar trabalhos com diagnósticos que um parecerista vai cobrar.
Acesso a todos os cursos da Análise Macro
O AM Black é a assinatura anual da Análise Macro: dá acesso a todos os cursos, de econometria e séries temporais a inteligência artificial aplicada, com exercícios em R e Python sobre dados econômicos reais.
Referências: Bueno, R. L. S. (2011), Econometria de séries temporais; Greene, W. H. (2003), Econometric Analysis; Pfaff, B. (2008), Analysis of Integrated and Cointegrated Time Series with R; Wooldridge, J. M. (2013), Introductory Econometrics: A Modern Approach.
Leia também:
📩 Modelo, dado e ressalva — todo dia
Este exercício é um recorte. No Boletim AM eu mostro econometria aplicada o ano inteiro, e como a IA entra nesse trabalho sem substituir o julgamento de quem entende o modelo.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.