Teste de hipóteses é o método que decide se uma diferença observada entre dois grupos é real ou é o tipo de variação que apareceria de qualquer jeito, só porque os dados são uma amostra. Neste tutorial, mostramos o que é teste de hipóteses e como construí-lo no R com o pacote infer, montando a distribuição nula por simulação em vez de fórmula.
O exemplo é um experimento real: gerentes de banco avaliaram currículos idênticos que diferiam apenas pelo nome no cabeçalho, sugerindo um candidato homem ou uma candidata mulher.
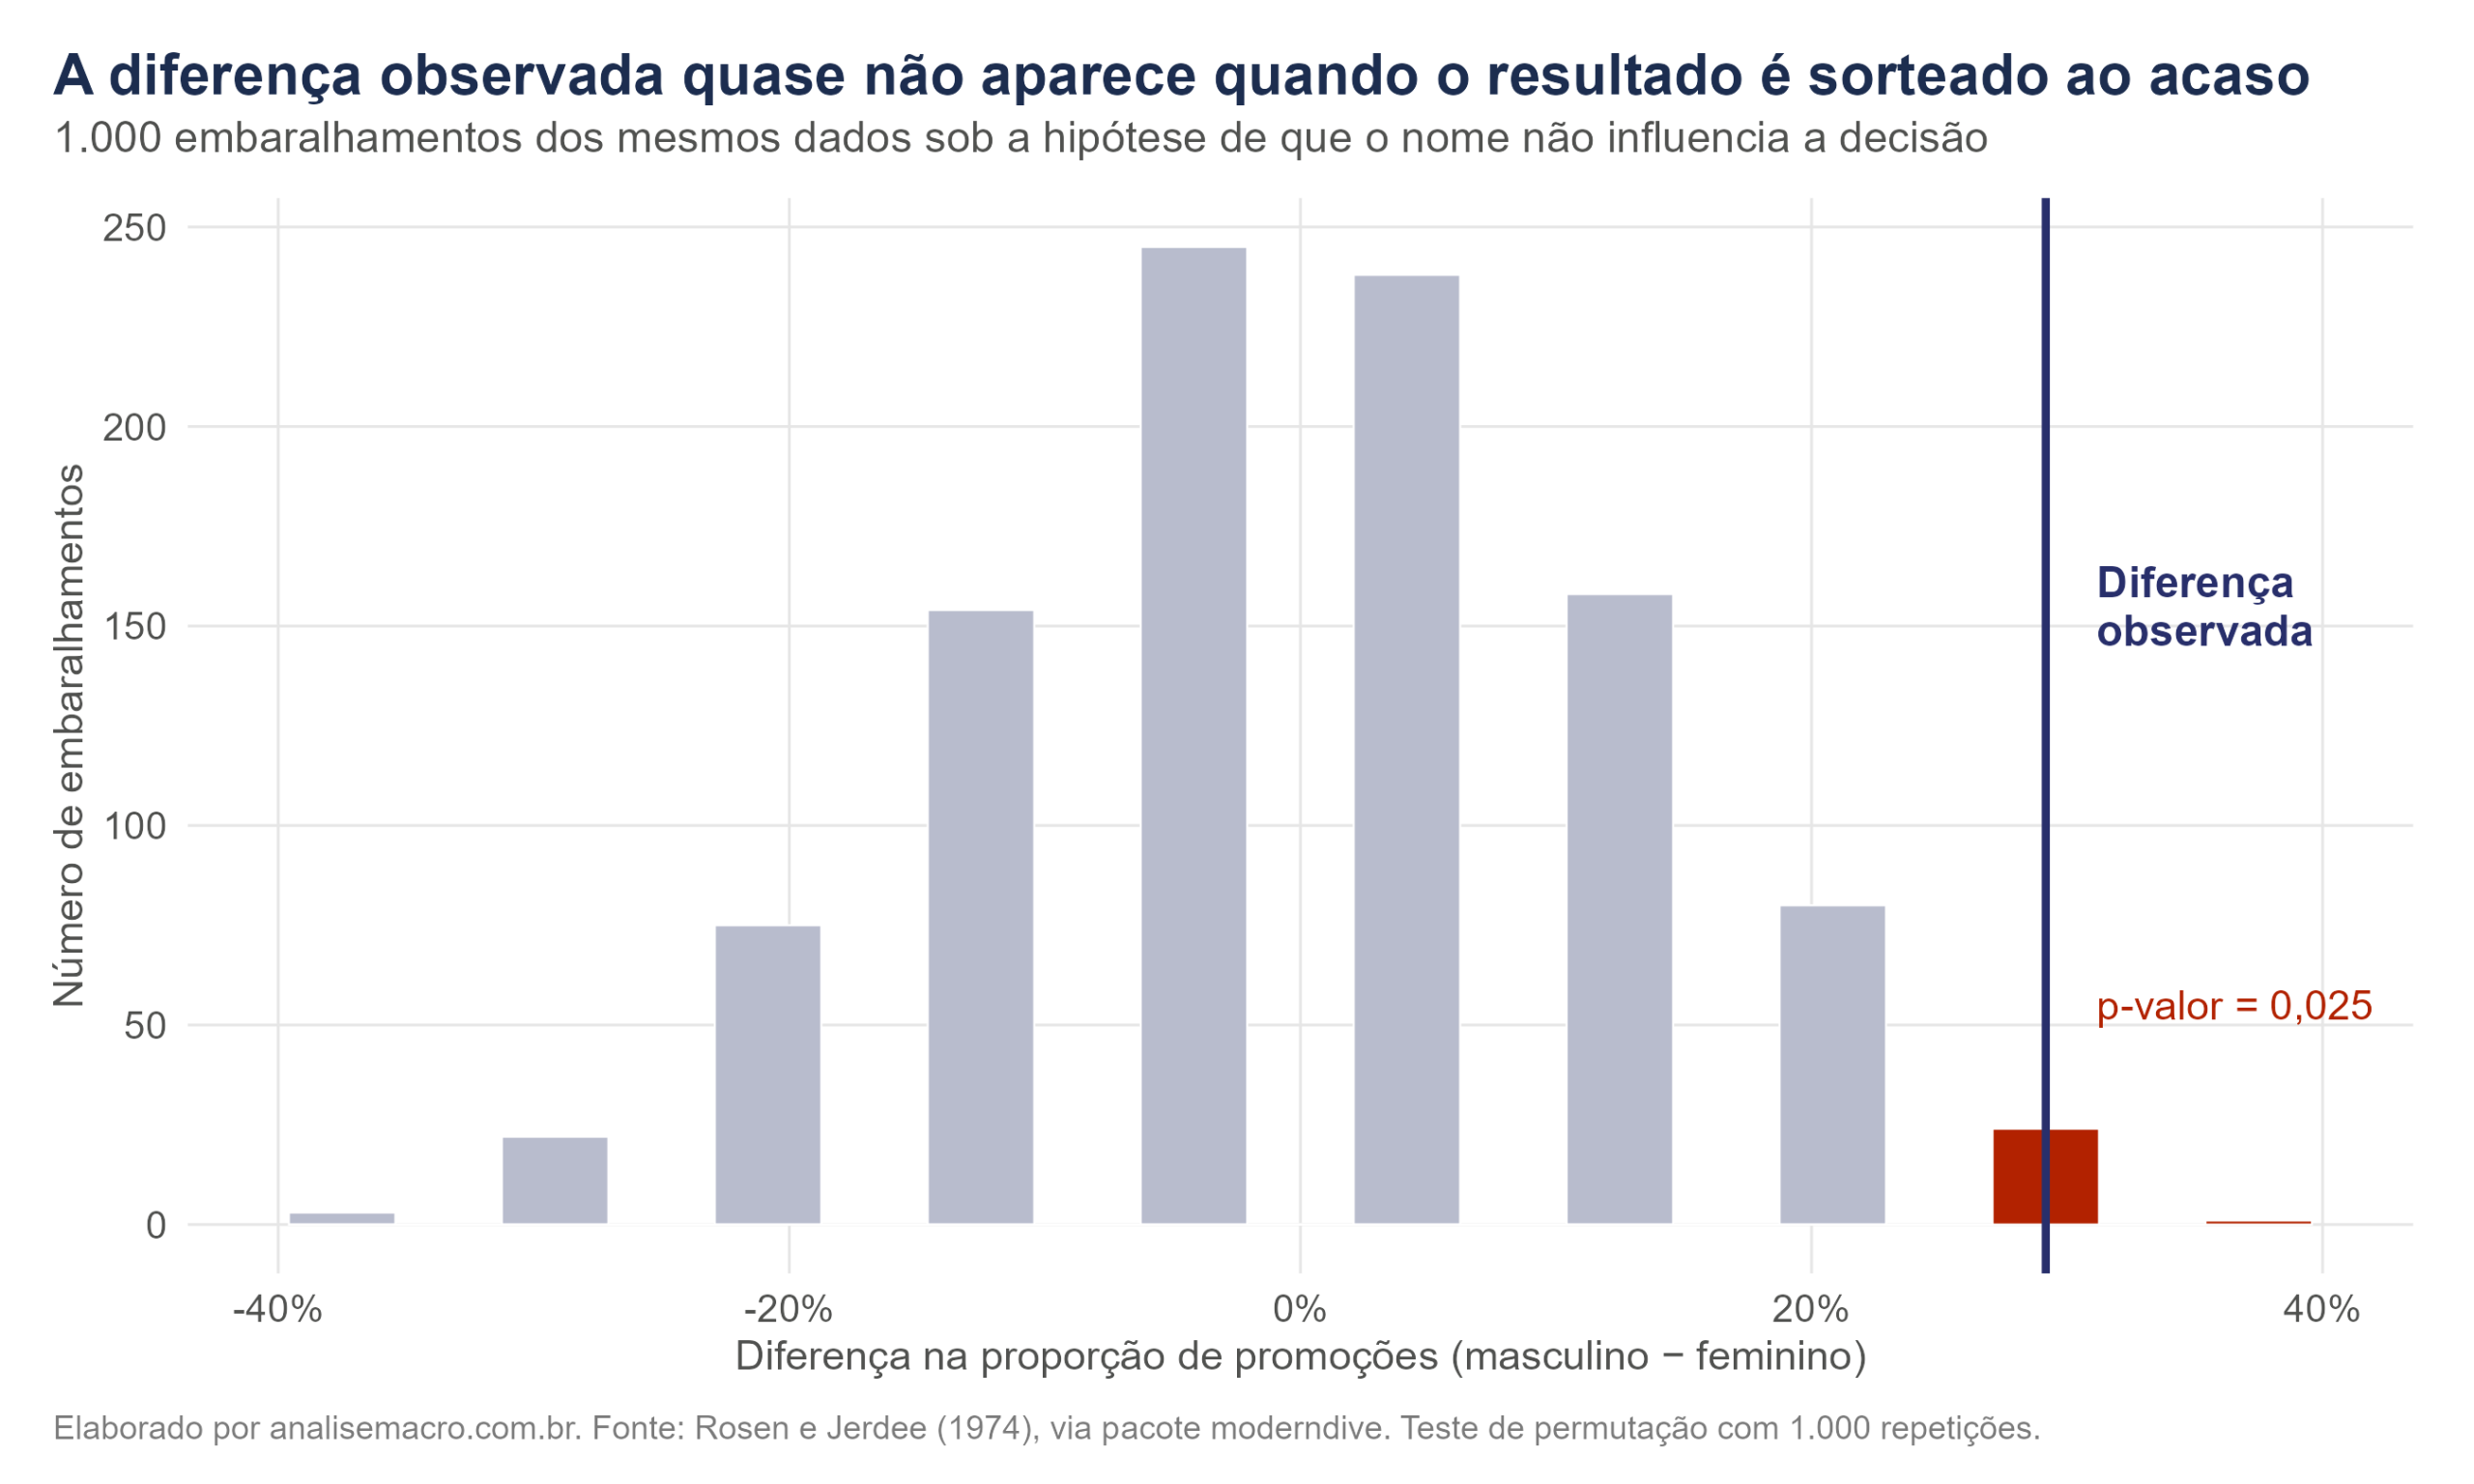
As mil simulações se concentram em torno de zero, como esperado num mundo onde o nome não importa. A linha vertical marca a diferença que os dados de fato produziram, e quase nenhuma simulação chega tão longe quanto ela. É essa fração que se chama p-valor.
📩 Acompanhe nossas análises
O Boletim AM traz análises de conjuntura, exercícios em R e Python e material de estudo, direto no seu e-mail.
O raciocínio por trás do teste
O teste de hipóteses responde por caminho indireto. Em vez de tentar provar que existe um efeito, ele supõe que não existe, calcula o que aconteceria nesse mundo e verifica se o resultado observado seria surpreendente ali. Se for surpreendente demais, a suposição cai.
Todo teste, qualquer que seja a fórmula, é montado a partir dos mesmos elementos:
⚖️
📊
🎲
📉
A hipótese nula é sempre a que afirma ausência de efeito, diferença ou associação. No experimento deste tutorial, ela diz que homens e mulheres são promovidos na mesma taxa; a alternativa diz que a taxa dos homens é maior. Como a alternativa aponta um sentido específico, o teste é unicaudal; se apenas afirmasse que existe alguma diferença, seria bicaudal.
O teste trabalha em dois níveis: o parâmetro é a quantidade desconhecida na população, e a estatística é o que se calcula na amostra para estimá-lo.
| Parâmetro populacional | Notação | Estimativa amostral |
|---|---|---|
| Proporção da população | p | Proporção da amostra |
| Média populacional | μ | Média amostral |
| Diferença de proporções | p₁ − p₂ | Diferença entre as proporções amostrais |
O experimento
Os dados vêm de um experimento conduzido por Rosen e Jerdee em 1974. Gerentes de banco receberam currículos idênticos e decidiram sobre promoção; a única diferença entre os documentos era o nome, que sugeria um candidato homem ou uma candidata mulher. São 48 currículos, metade com cada nome.
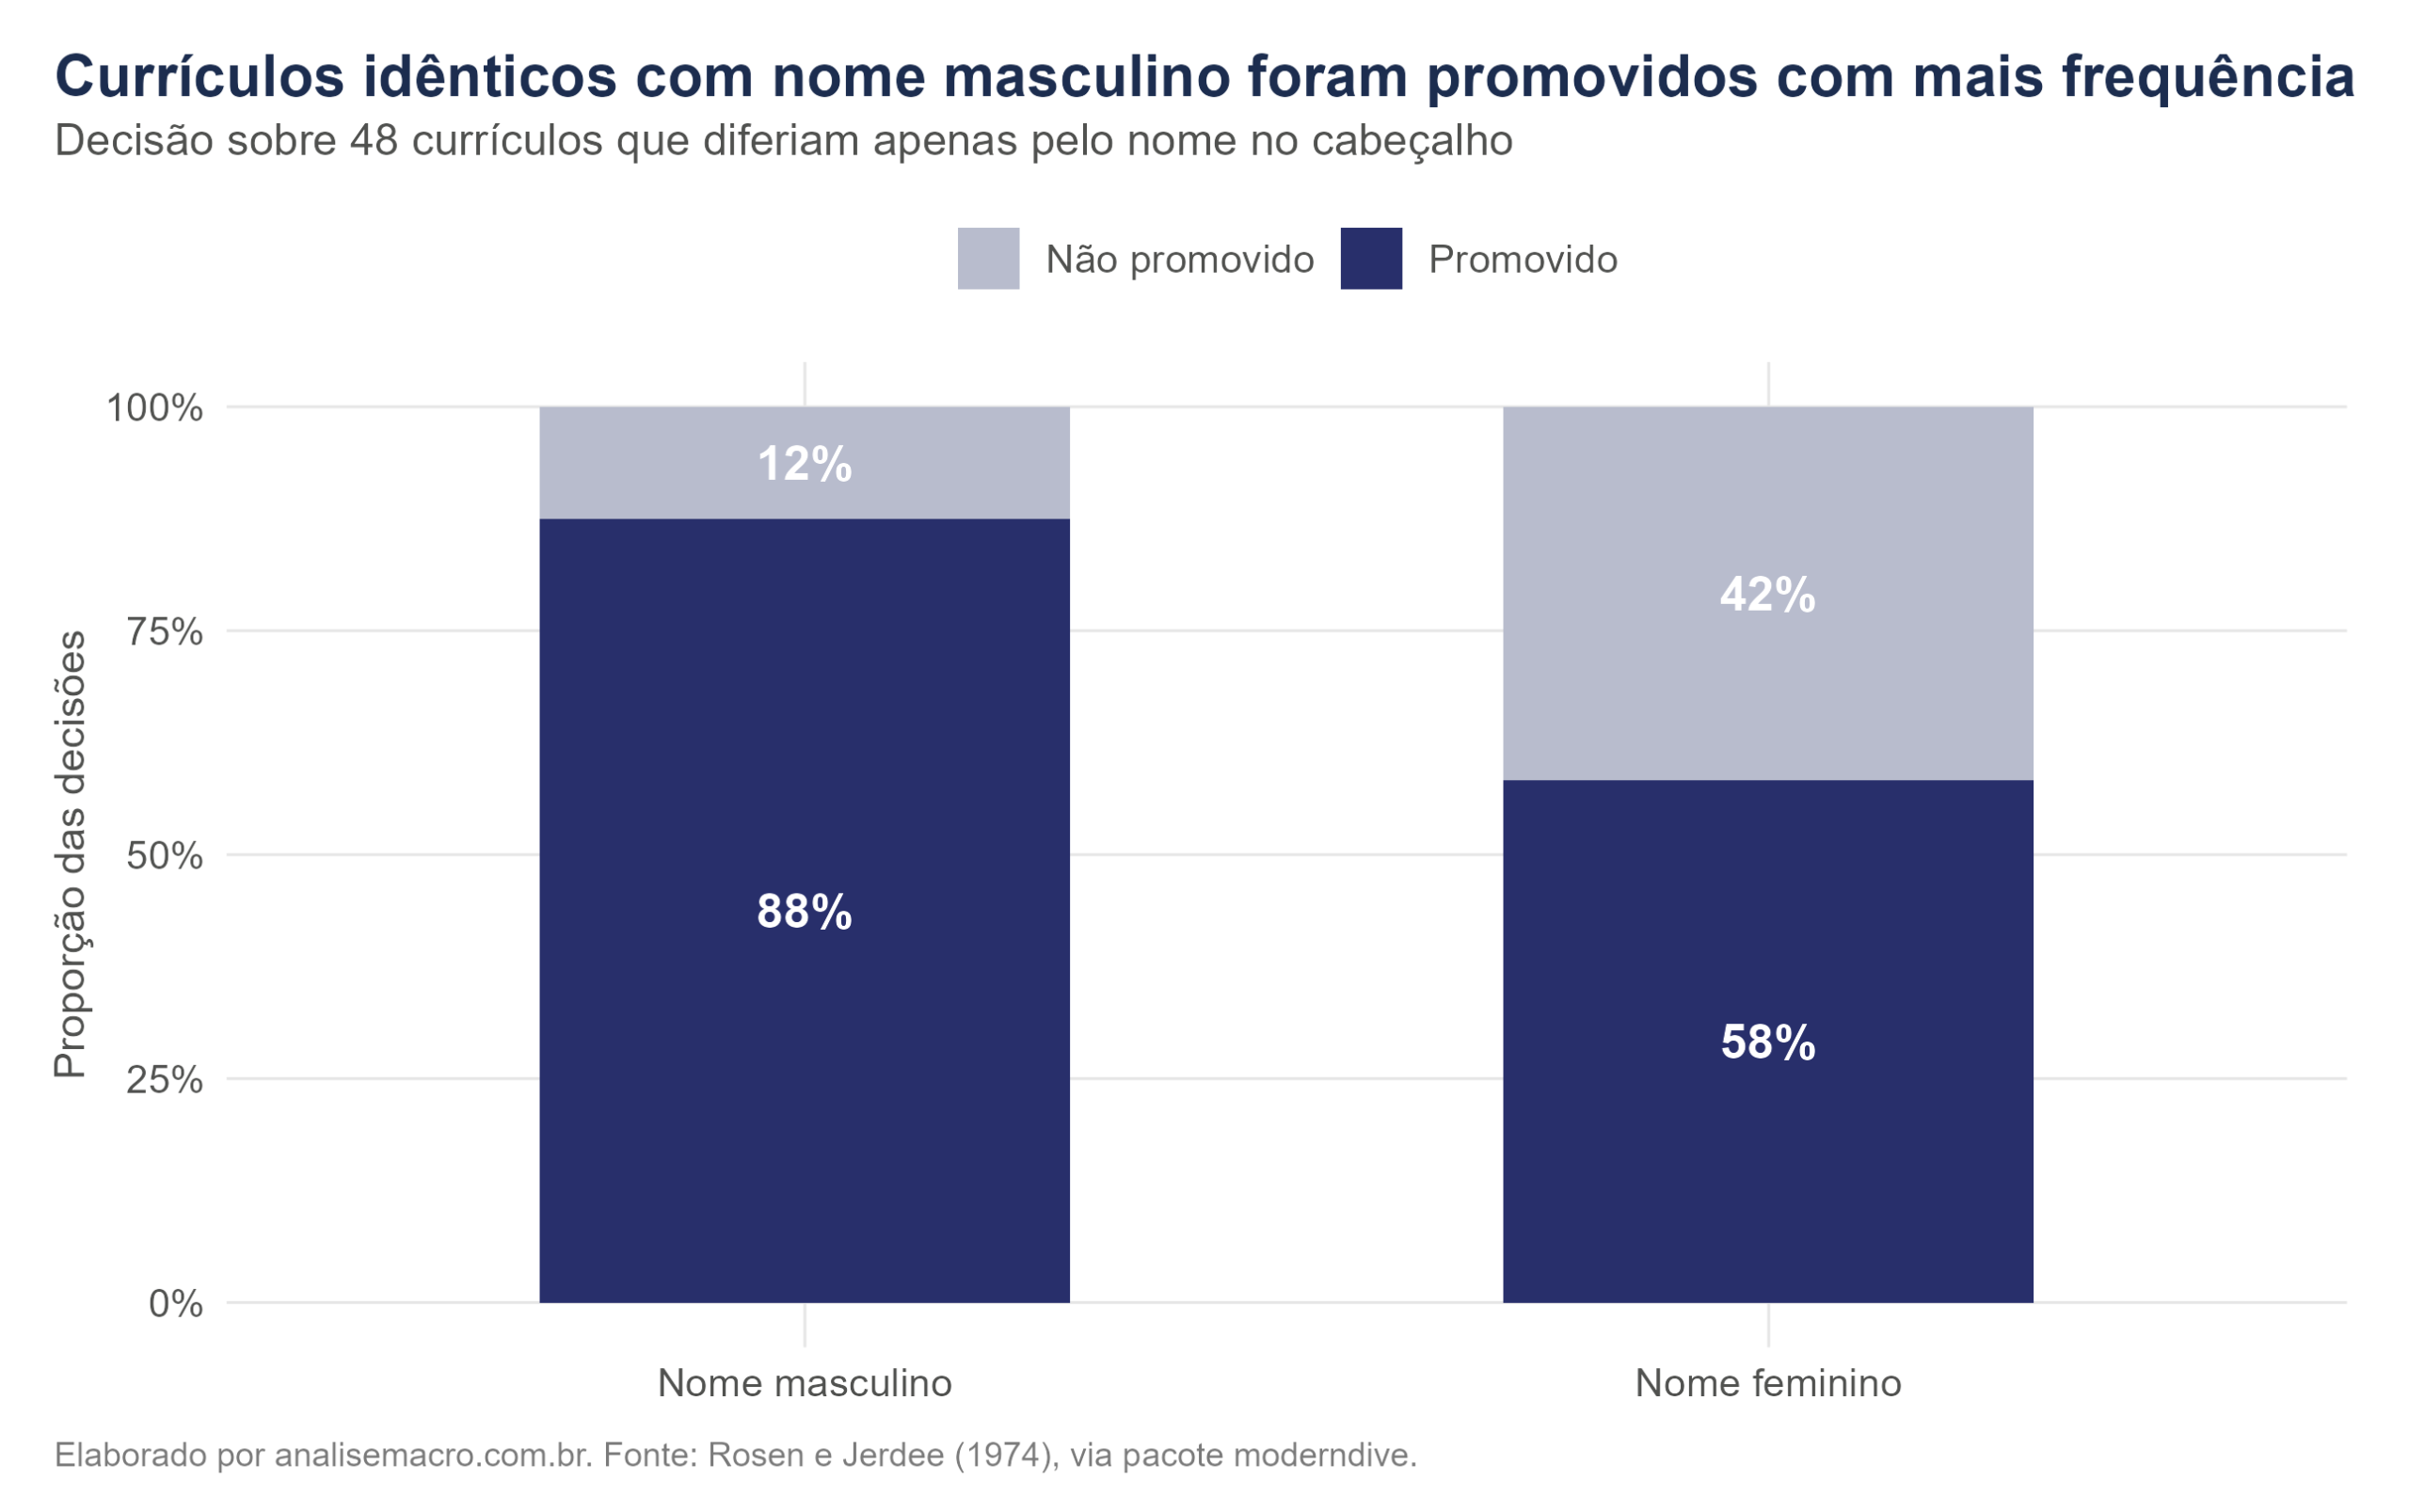
A diferença aparece com clareza no gráfico. A pergunta é se uma diferença desse tamanho poderia surgir por acaso, com uma amostra tão pequena.
Construindo a distribuição nula por simulação
Aqui está a parte mais elegante do método. Em vez de recorrer a uma fórmula, a distribuição nula pode ser construída diretamente a partir dos dados: se o nome no currículo não influencia a decisão, então trocar os nomes entre os currículos não deveria mudar nada.
É exatamente isso que a simulação faz. Embaralha os rótulos de gênero entre as 48 observações, recalcula a diferença entre as proporções, e repete mil vezes. O resultado é a distribuição de diferenças que o acaso produziria num mundo sem efeito, que é a definição de distribuição nula.
Qualquer teste percorre o mesmo caminho, e comparar médias, proporções ou variâncias muda apenas a medida calculada em cada repetição.
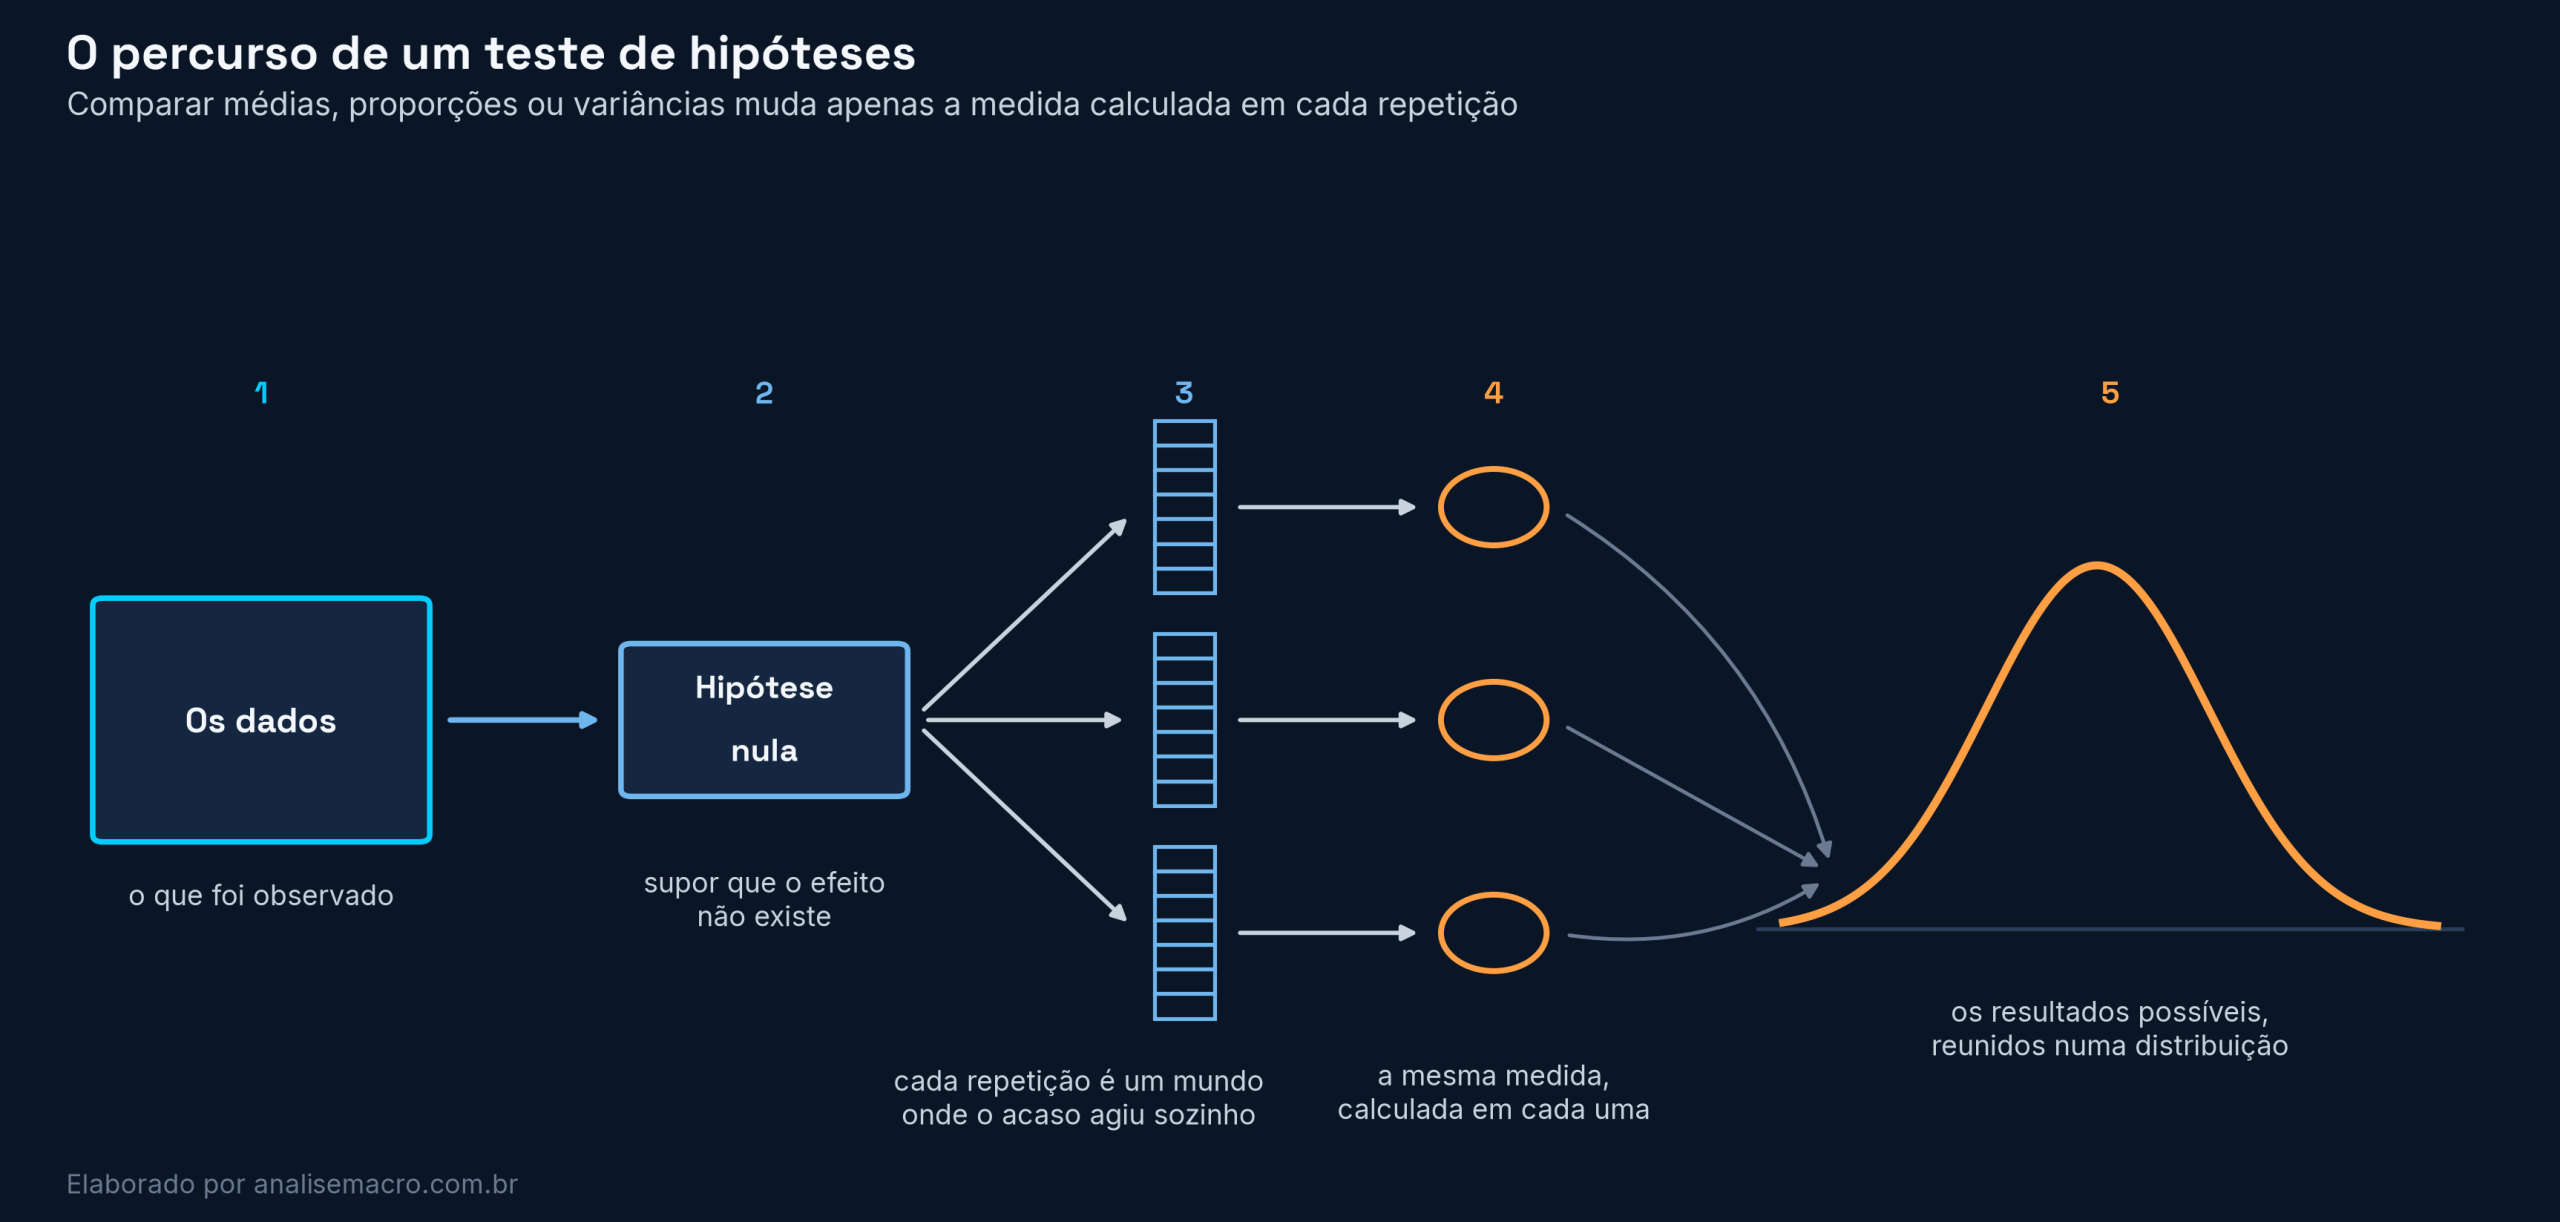
Esse encadeamento implementa o princípio "há apenas um teste", formulado por Allen Downey: testes com nomes diferentes compartilham a mesma estrutura, mudando apenas a estatística calculada.
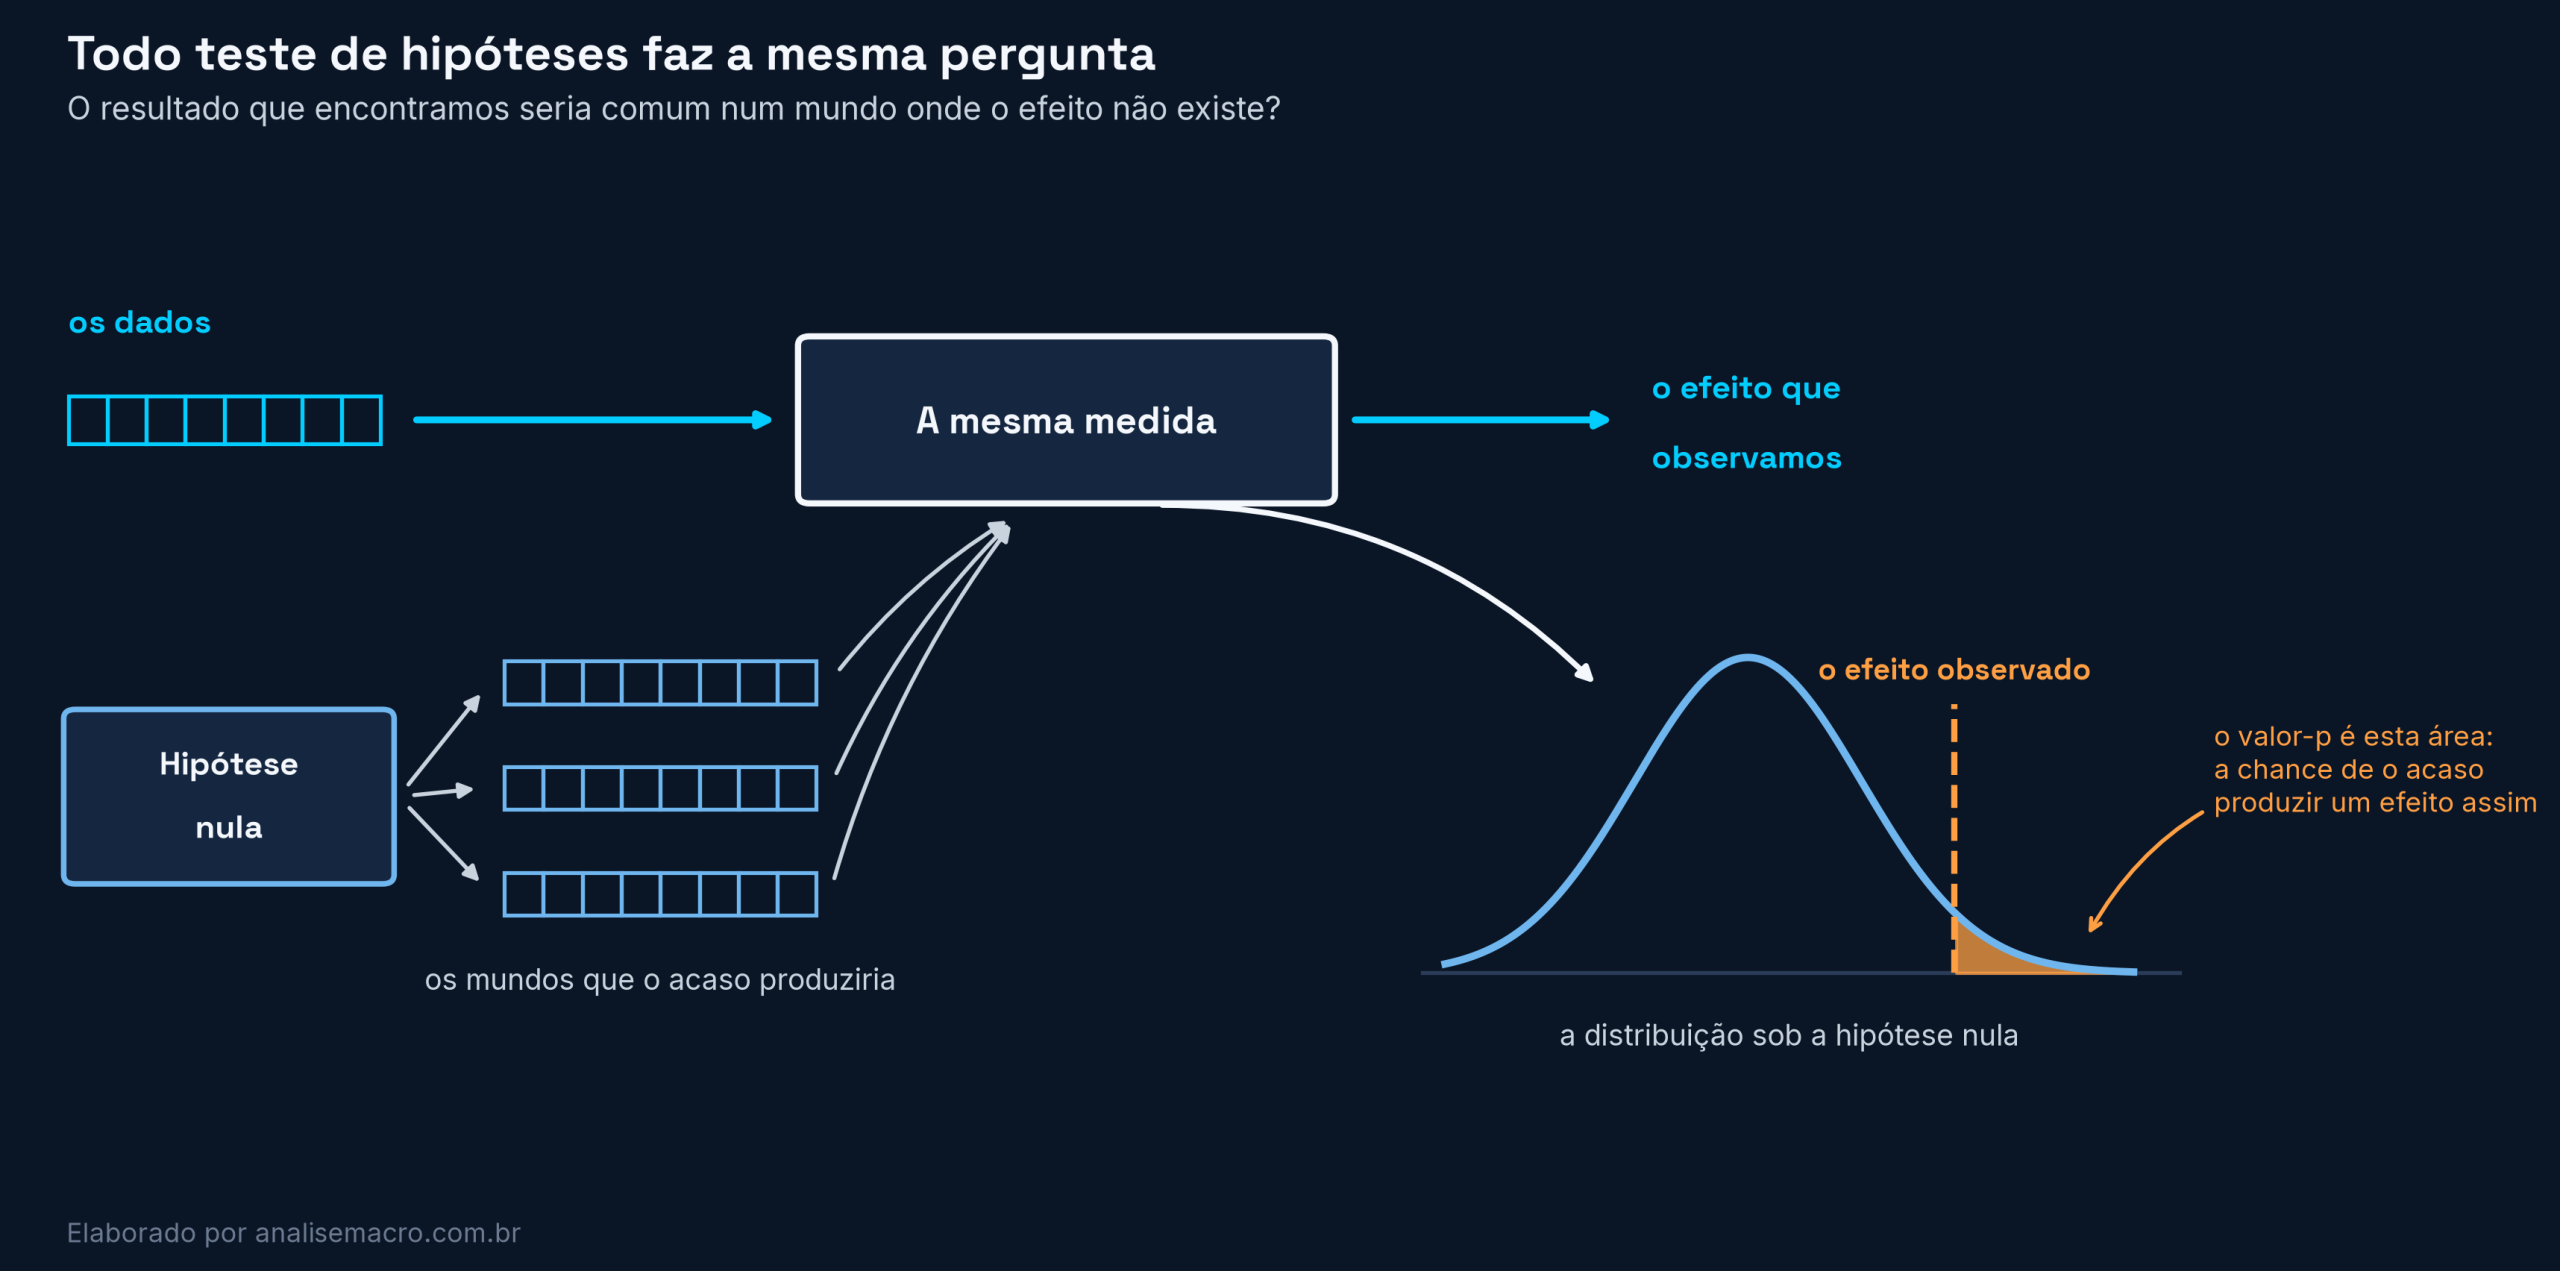
Um detalhe do código merece cuidado: a ordem dos grupos precisa ser idêntica no cálculo do valor observado e no da distribuição nula. Invertê-la troca o sinal da estatística e faz o teste unicaudal apontar para o lado errado, sem gerar erro algum.
O p-valor e a decisão
Com a distribuição nula construída, o p-valor é uma contagem: entre as mil simulações, quantas produziram uma diferença tão grande quanto a observada? No exercício, 2,5% delas. Como esse valor fica abaixo do nível de significância de 5% fixado antes do teste, a hipótese nula é rejeitada.
A conclusão: uma diferença desse tamanho seria rara demais para atribuir ao acaso, o que sustenta a afirmação de que o nome no currículo influenciou a decisão dos gerentes.
Os dois erros possíveis
A decisão de rejeitar ou não a nula pode errar de duas maneiras, e o teste controla apenas uma delas.
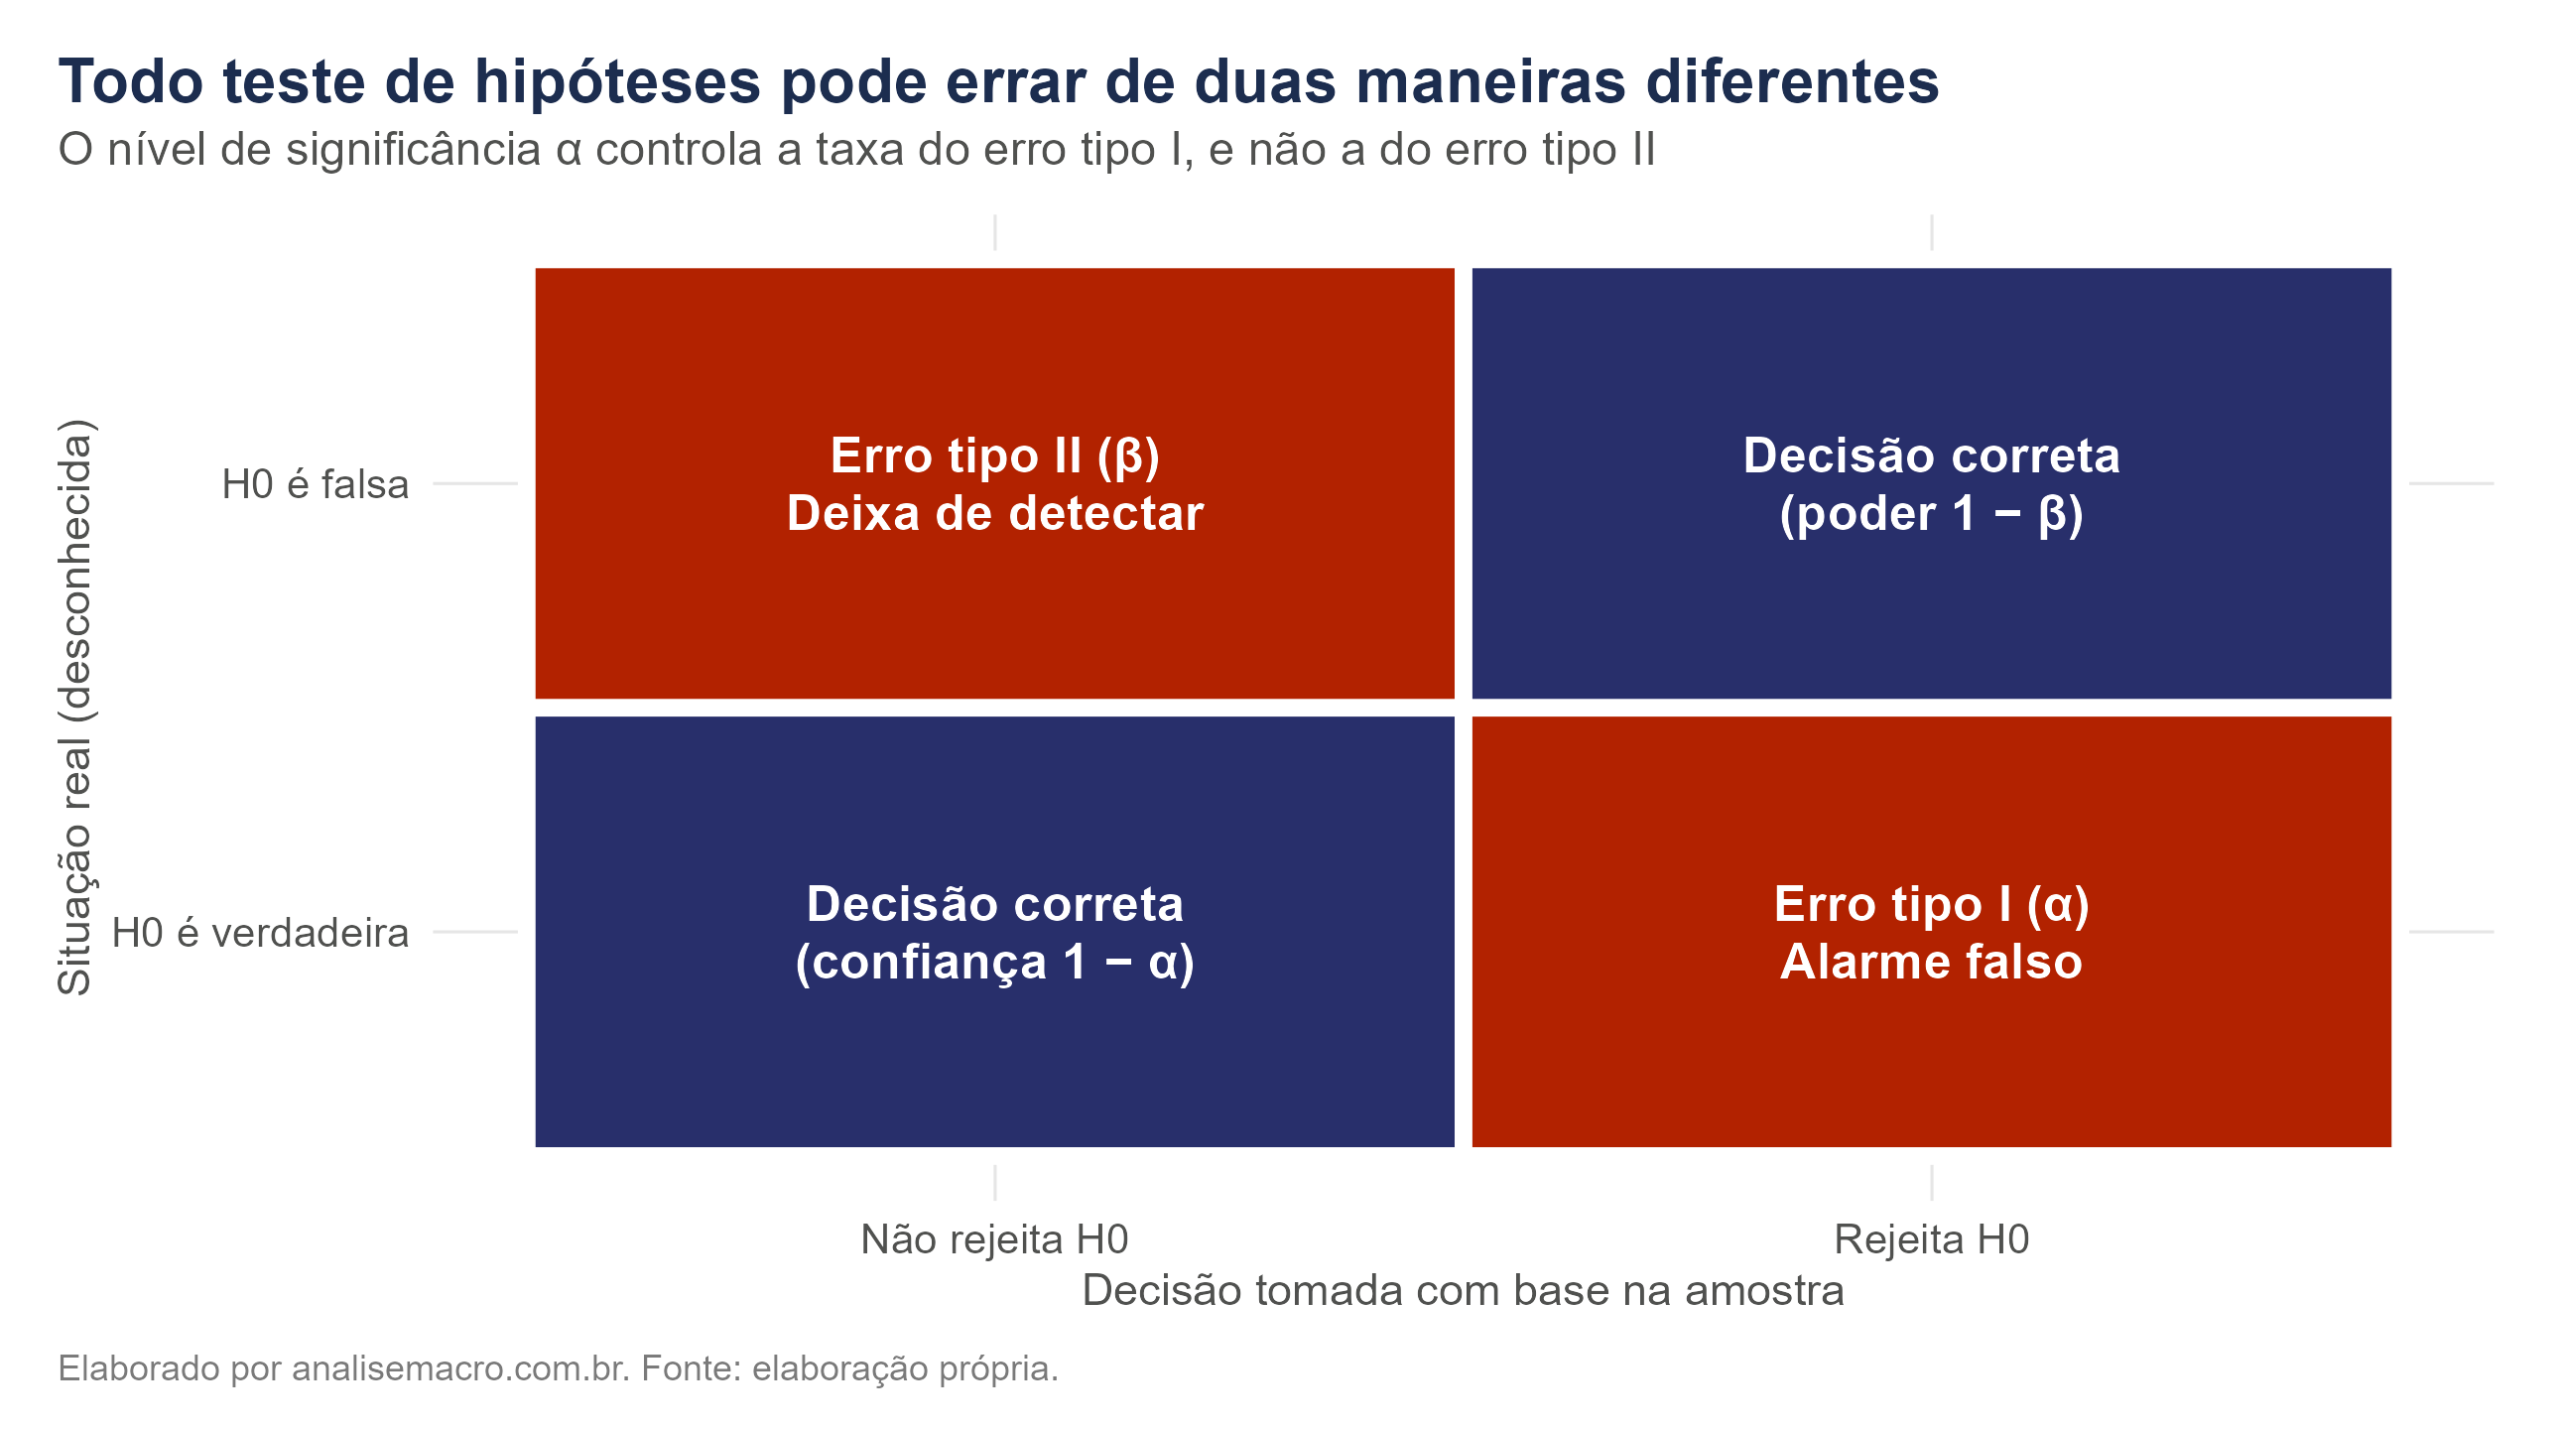
O erro tipo I é rejeitar uma nula verdadeira: enxergar efeito onde não há. Sua taxa é exatamente o nível de significância fixado, e usar 5% significa aceitar errar assim em 5% das vezes em que não existe efeito.
O erro tipo II é não rejeitar uma nula falsa: deixar de detectar um efeito real. Sua taxa não é fixada pelo pesquisador, e depende do tamanho do efeito, da variabilidade e, sobretudo, do tamanho da amostra. O complemento dessa taxa é o poder do teste: a probabilidade de detectar um efeito que de fato existe.
Por que "não rejeitar" não é "aceitar"
A assimetria entre as duas conclusões fica evidente na simulação abaixo, que testa a mesma diferença real de 3 pontos percentuais em amostras de tamanhos crescentes:
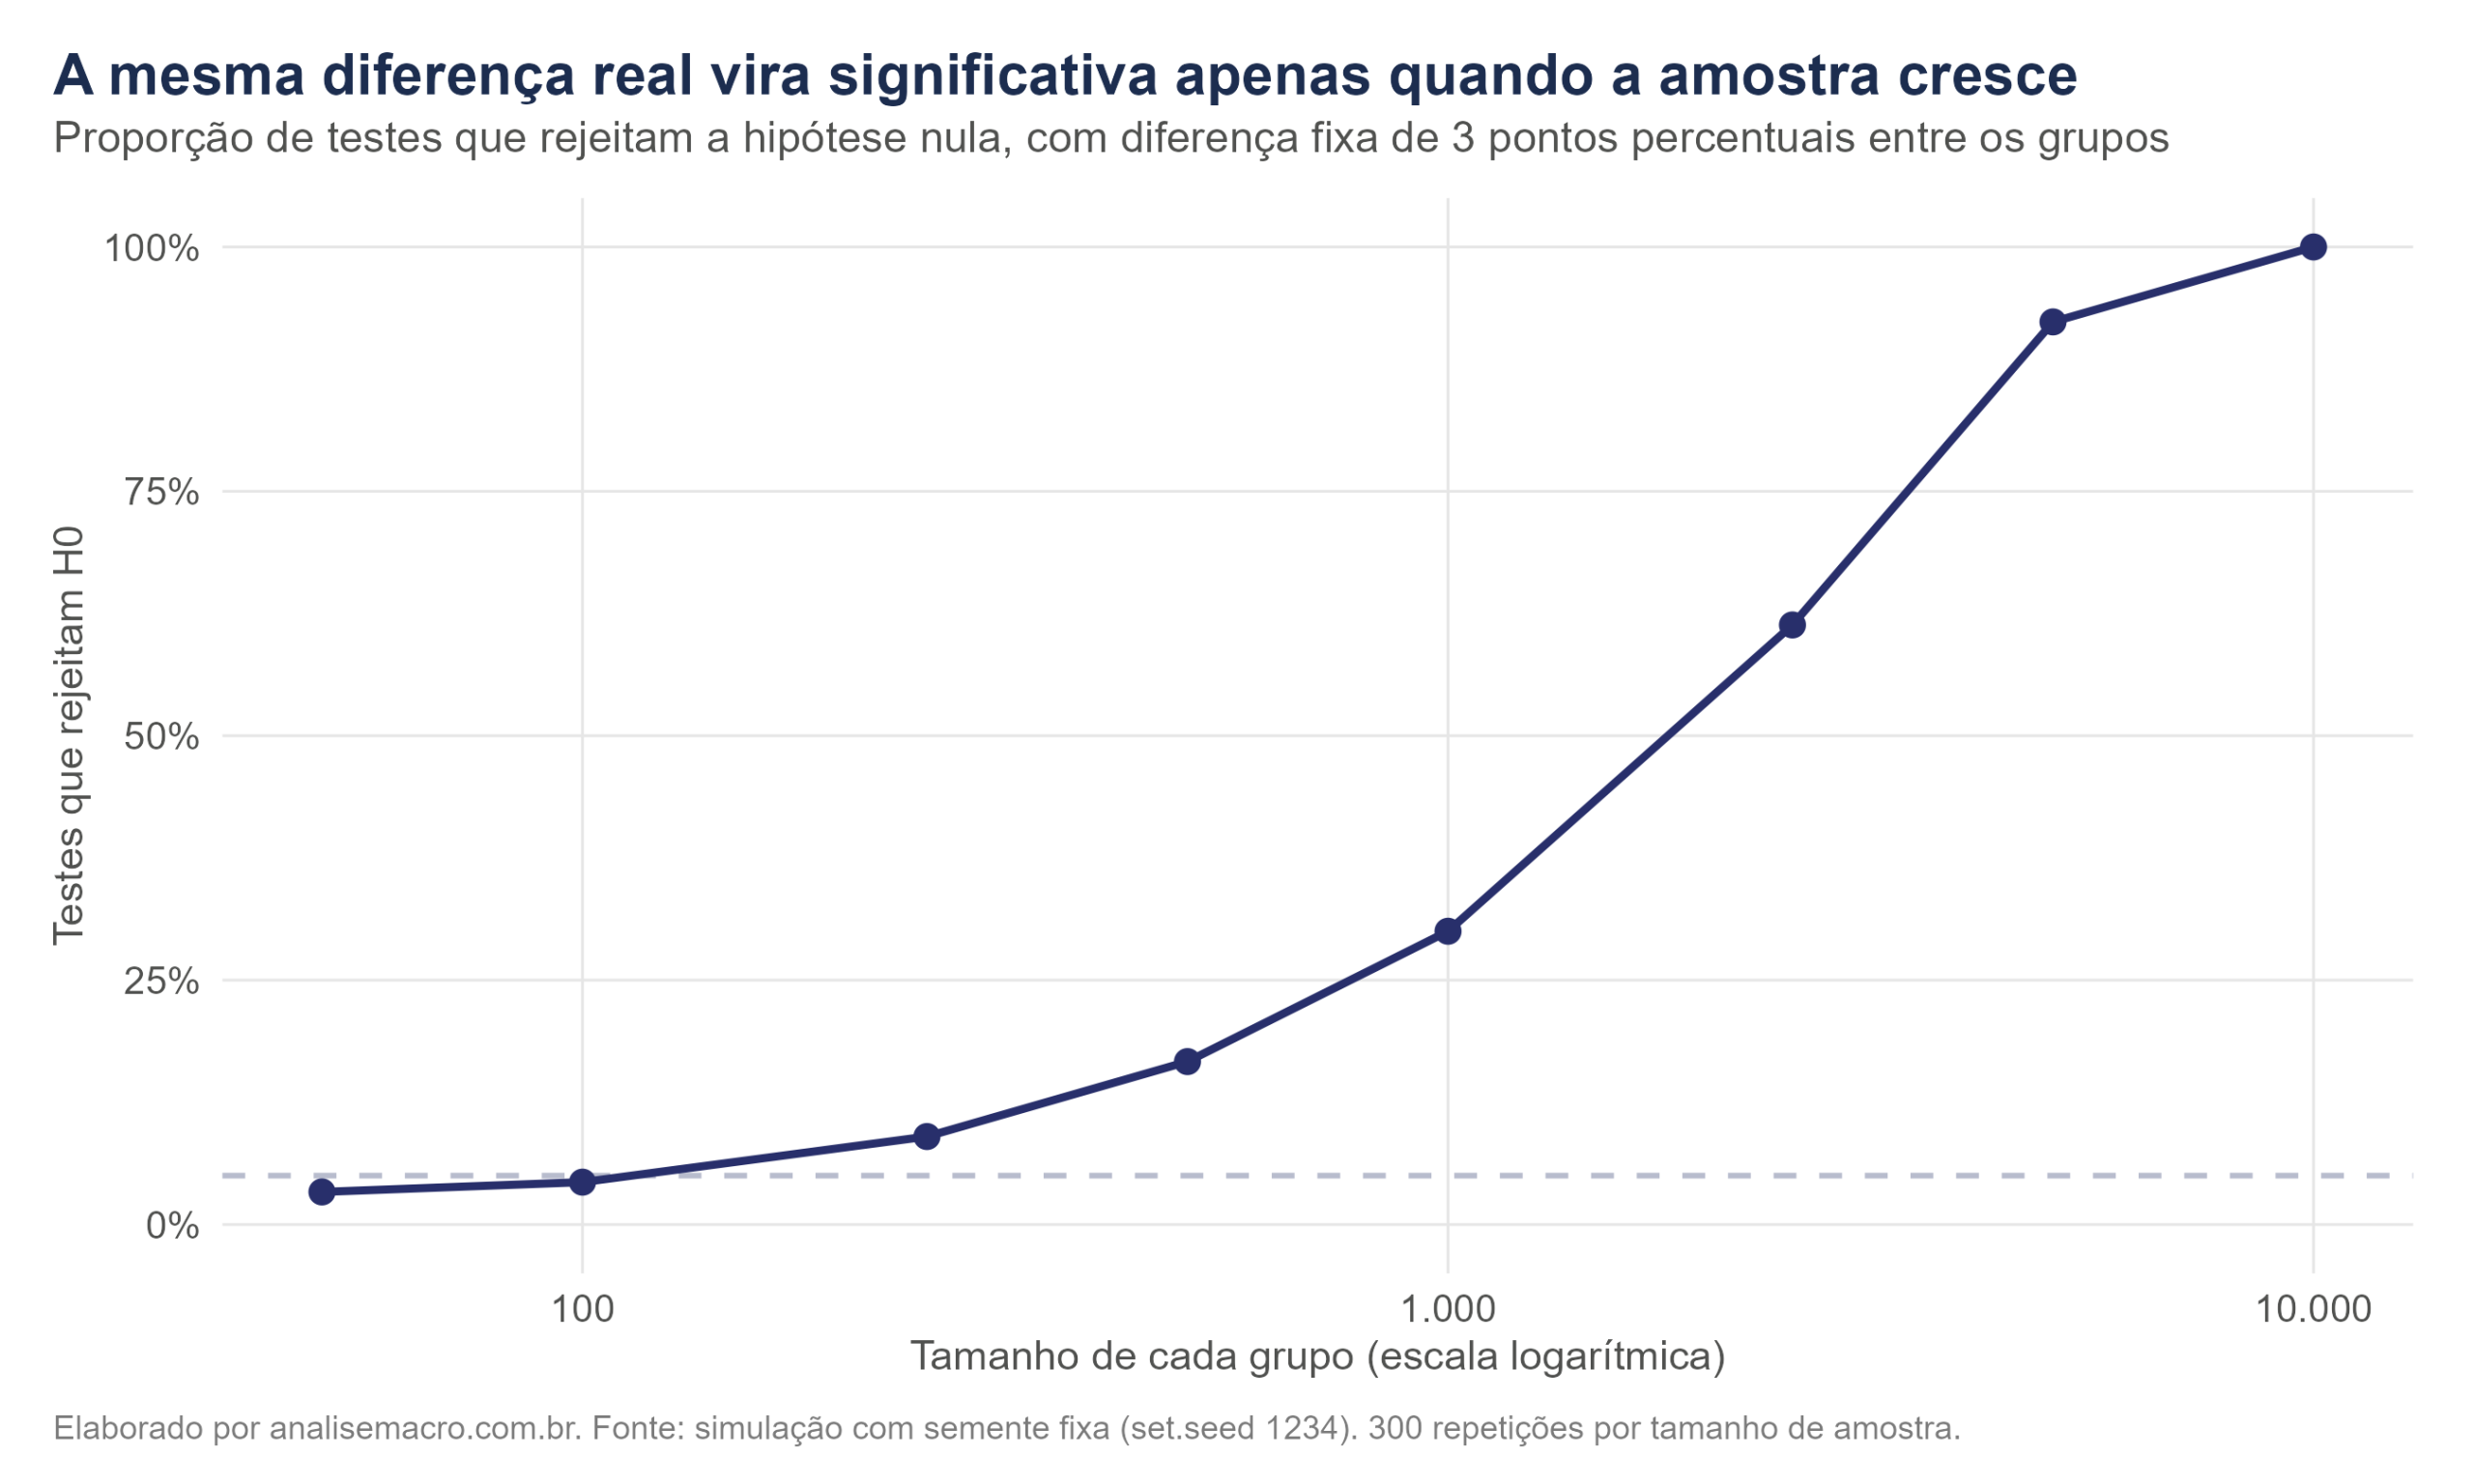
Com grupos pequenos, quase nenhum teste detecta a diferença, embora ela exista por construção. Com grupos grandes, todos detectam. O efeito é o mesmo nos dois casos; o que muda é a capacidade de enxergá-lo.
Daí a formulação cuidadosa: não rejeitar a nula não é evidência de que ela seja verdadeira. Pode significar que o efeito não existe, ou que a amostra era pequena demais para revelá-lo. Um resultado não significativo com amostra pequena é, sobretudo, inconclusivo.
O que o resultado revela
- A distribuição nula pode vir dos próprios dados. Embaralhar os rótulos mil vezes constrói a referência sem nenhuma fórmula, e torna visível o que o p-valor mede.
- O p-valor é uma contagem, não um veredito. Ele mede a fração das simulações tão extremas quanto o observado, supondo que a nula seja verdadeira.
- O teste controla um erro, não os dois. O nível de significância fixa a taxa de falso positivo; a taxa de falso negativo depende do tamanho da amostra.
- Resultado não significativo com amostra pequena é inconclusivo. A mesma diferença real passa despercebida em grupos pequenos e é detectada em grupos grandes.
Considerações finais
Com um conjunto de dados público e o pacote infer, o exercício constrói um teste de hipóteses completo sem recorrer a tabelas ou fórmulas fechadas: a distribuição nula sai de mil embaralhamentos dos dados reais, e o p-valor é a fração delas que chega ao valor observado.
Essa construção por simulação torna concreto um raciocínio que costuma ser apresentado de forma abstrata. As aplicações mudam conforme a área:
- Analistas de dados: todo teste A/B é um teste de hipóteses, e calcular o poder antes de rodar evita experimentos que não podem concluir nada.
- Economistas: avaliação de políticas públicas depende de distinguir efeito real de variação amostral, com a mesma estrutura lógica.
- Profissionais de mercado financeiro: comparar o desempenho de duas estratégias exige testar se a diferença sobrevive ao acaso.
- Pesquisadores e estudantes: entender o que o p-valor mede evita as duas leituras erradas mais comuns, que o tomam por probabilidade da hipótese ou por medida de tamanho de efeito.
Aprender a linguagem é o que abre a porta para todas essas frentes.
Você viu o método; aprenda a aplicá-lo
Do teste de hipóteses à modelagem de dados econômicos e financeiros, com R aplicado a dados reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Leia também: