Inferência estatística é o conjunto de métodos que nos permite afirmar algo sobre um grupo inteiro a partir de uma parte dele. Medimos 546 casas e concluímos sobre o mercado imobiliário; entrevistamos duas mil pessoas e projetamos o resultado de uma eleição.
A pergunta que a inferência responde é quanta confiança podemos depositar nessa passagem. Neste artigo percorremos o raciocínio completo, da amostra ao teste de hipóteses, usando dados reais de preços de imóveis em R.
A população que não conseguimos medir
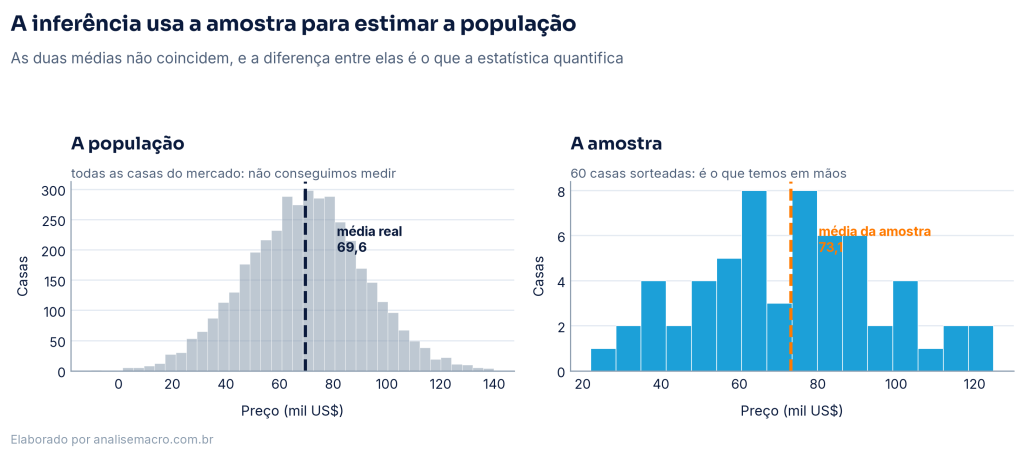
Chamamos de população o conjunto completo que nos interessa: todas as casas de uma cidade, todos os eleitores, todas as empresas de um setor. Quase nunca conseguimos medi-la por inteiro, seja por custo, por tempo ou porque ela nem existe toda ao mesmo tempo.
A amostra é o subconjunto que conseguimos observar. Dela calculamos uma estatística, como a média dos preços, e a usamos para estimar o parâmetro correspondente da população, que permanece desconhecido.
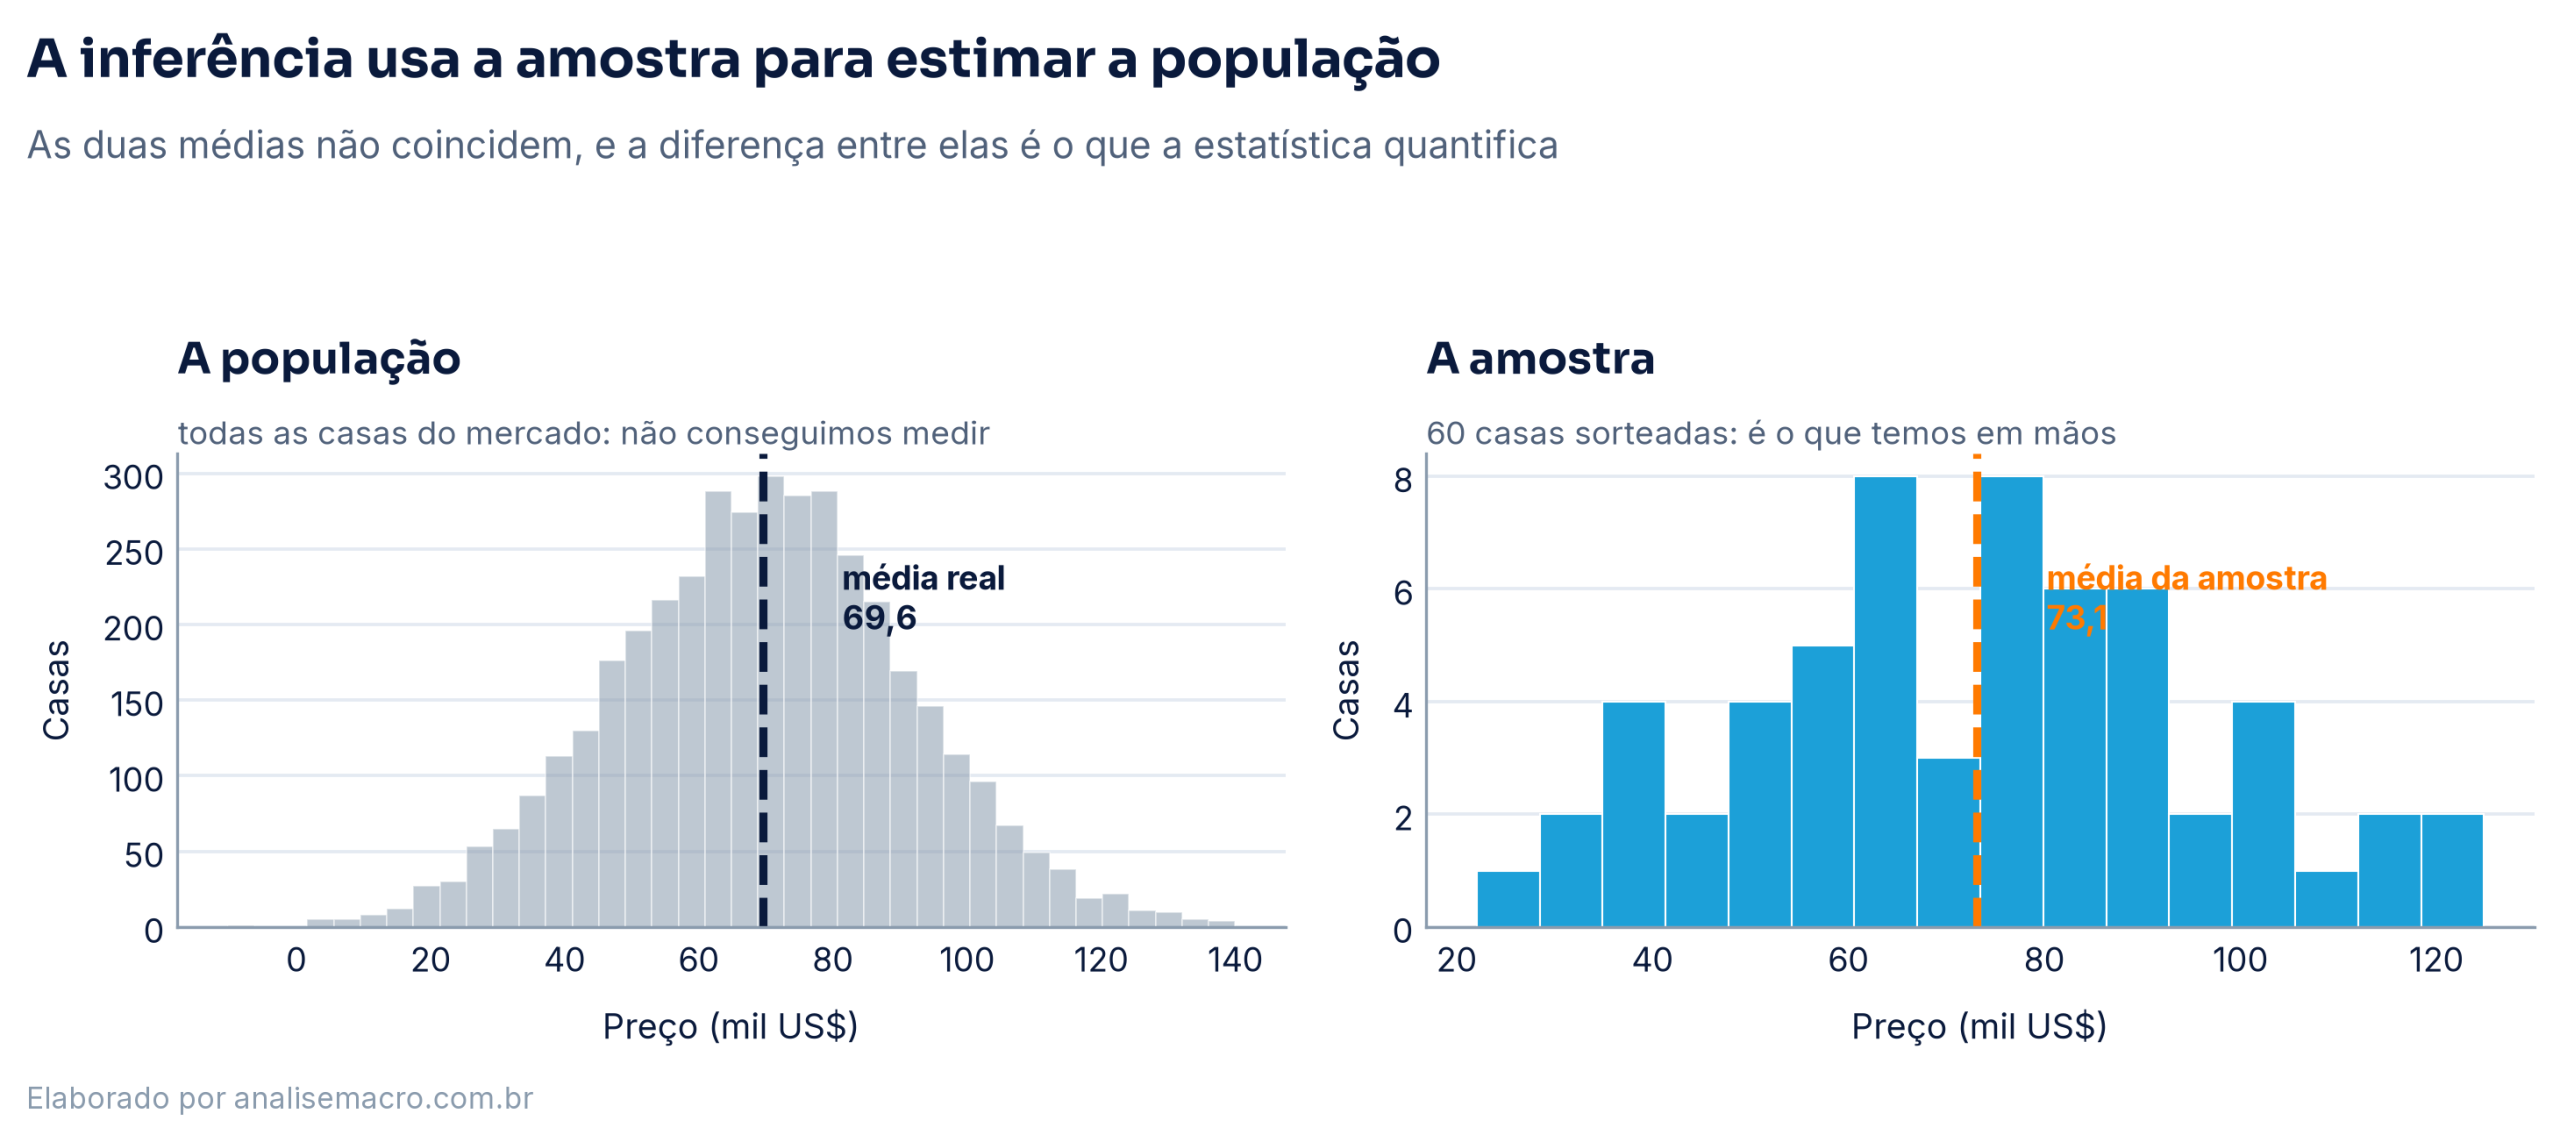
As duas médias da figura não coincidem, e isso é esperado. Se sorteássemos outra amostra de 60 casas, chegaríamos a um terceiro valor. Essa variação de amostra para amostra chama-se erro amostral, e tem tamanho mensurável.
O erro padrão mede a variação entre amostras
O erro padrão é o desvio padrão da distribuição das médias amostrais. Ele responde quanto a nossa estimativa tende a oscilar se repetíssemos a coleta muitas vezes.
Aqui σ é o desvio padrão da variável na população e n é o tamanho da amostra. A raiz no denominador tem consequência prática: para reduzir o erro padrão pela metade, precisamos de uma amostra quatro vezes maior.
Os dados: preços de casas e ar-condicionado
Usaremos o conjunto Housing, do pacote {Ecdat}, com 546 casas vendidas em Windsor, no Canadá. A pergunta é direta: casas com ar-condicionado custam mais?
library(dplyr)   # manipulação de dados
library(Ecdat)   # conjuntos de dados de econometria

data(Housing)                      # disponibiliza o conjunto
house <- as_tibble(Housing)        # converte para tibble, de leitura mais fácil

house |>
  group_by(airco) |>               # separa pelos dois grupos de casas
  summarise(
    n       = n(),                 # quantas casas em cada grupo
    media   = mean(price),         # o preço médio
    dp      = sd(price),           # o desvio padrão dos preços
    mediana = median(price)        # o preço mediano
)| Grupo | Casas | Preço médio | Desvio padrão | Mediana |
|---|---|---|---|---|
| Sem ar-condicionado | 373 | US$ 59.885 | 21.339 | US$ 55.500 |
| Com ar-condicionado | 173 | US$ 85.881 | 28.463 | US$ 82.000 |
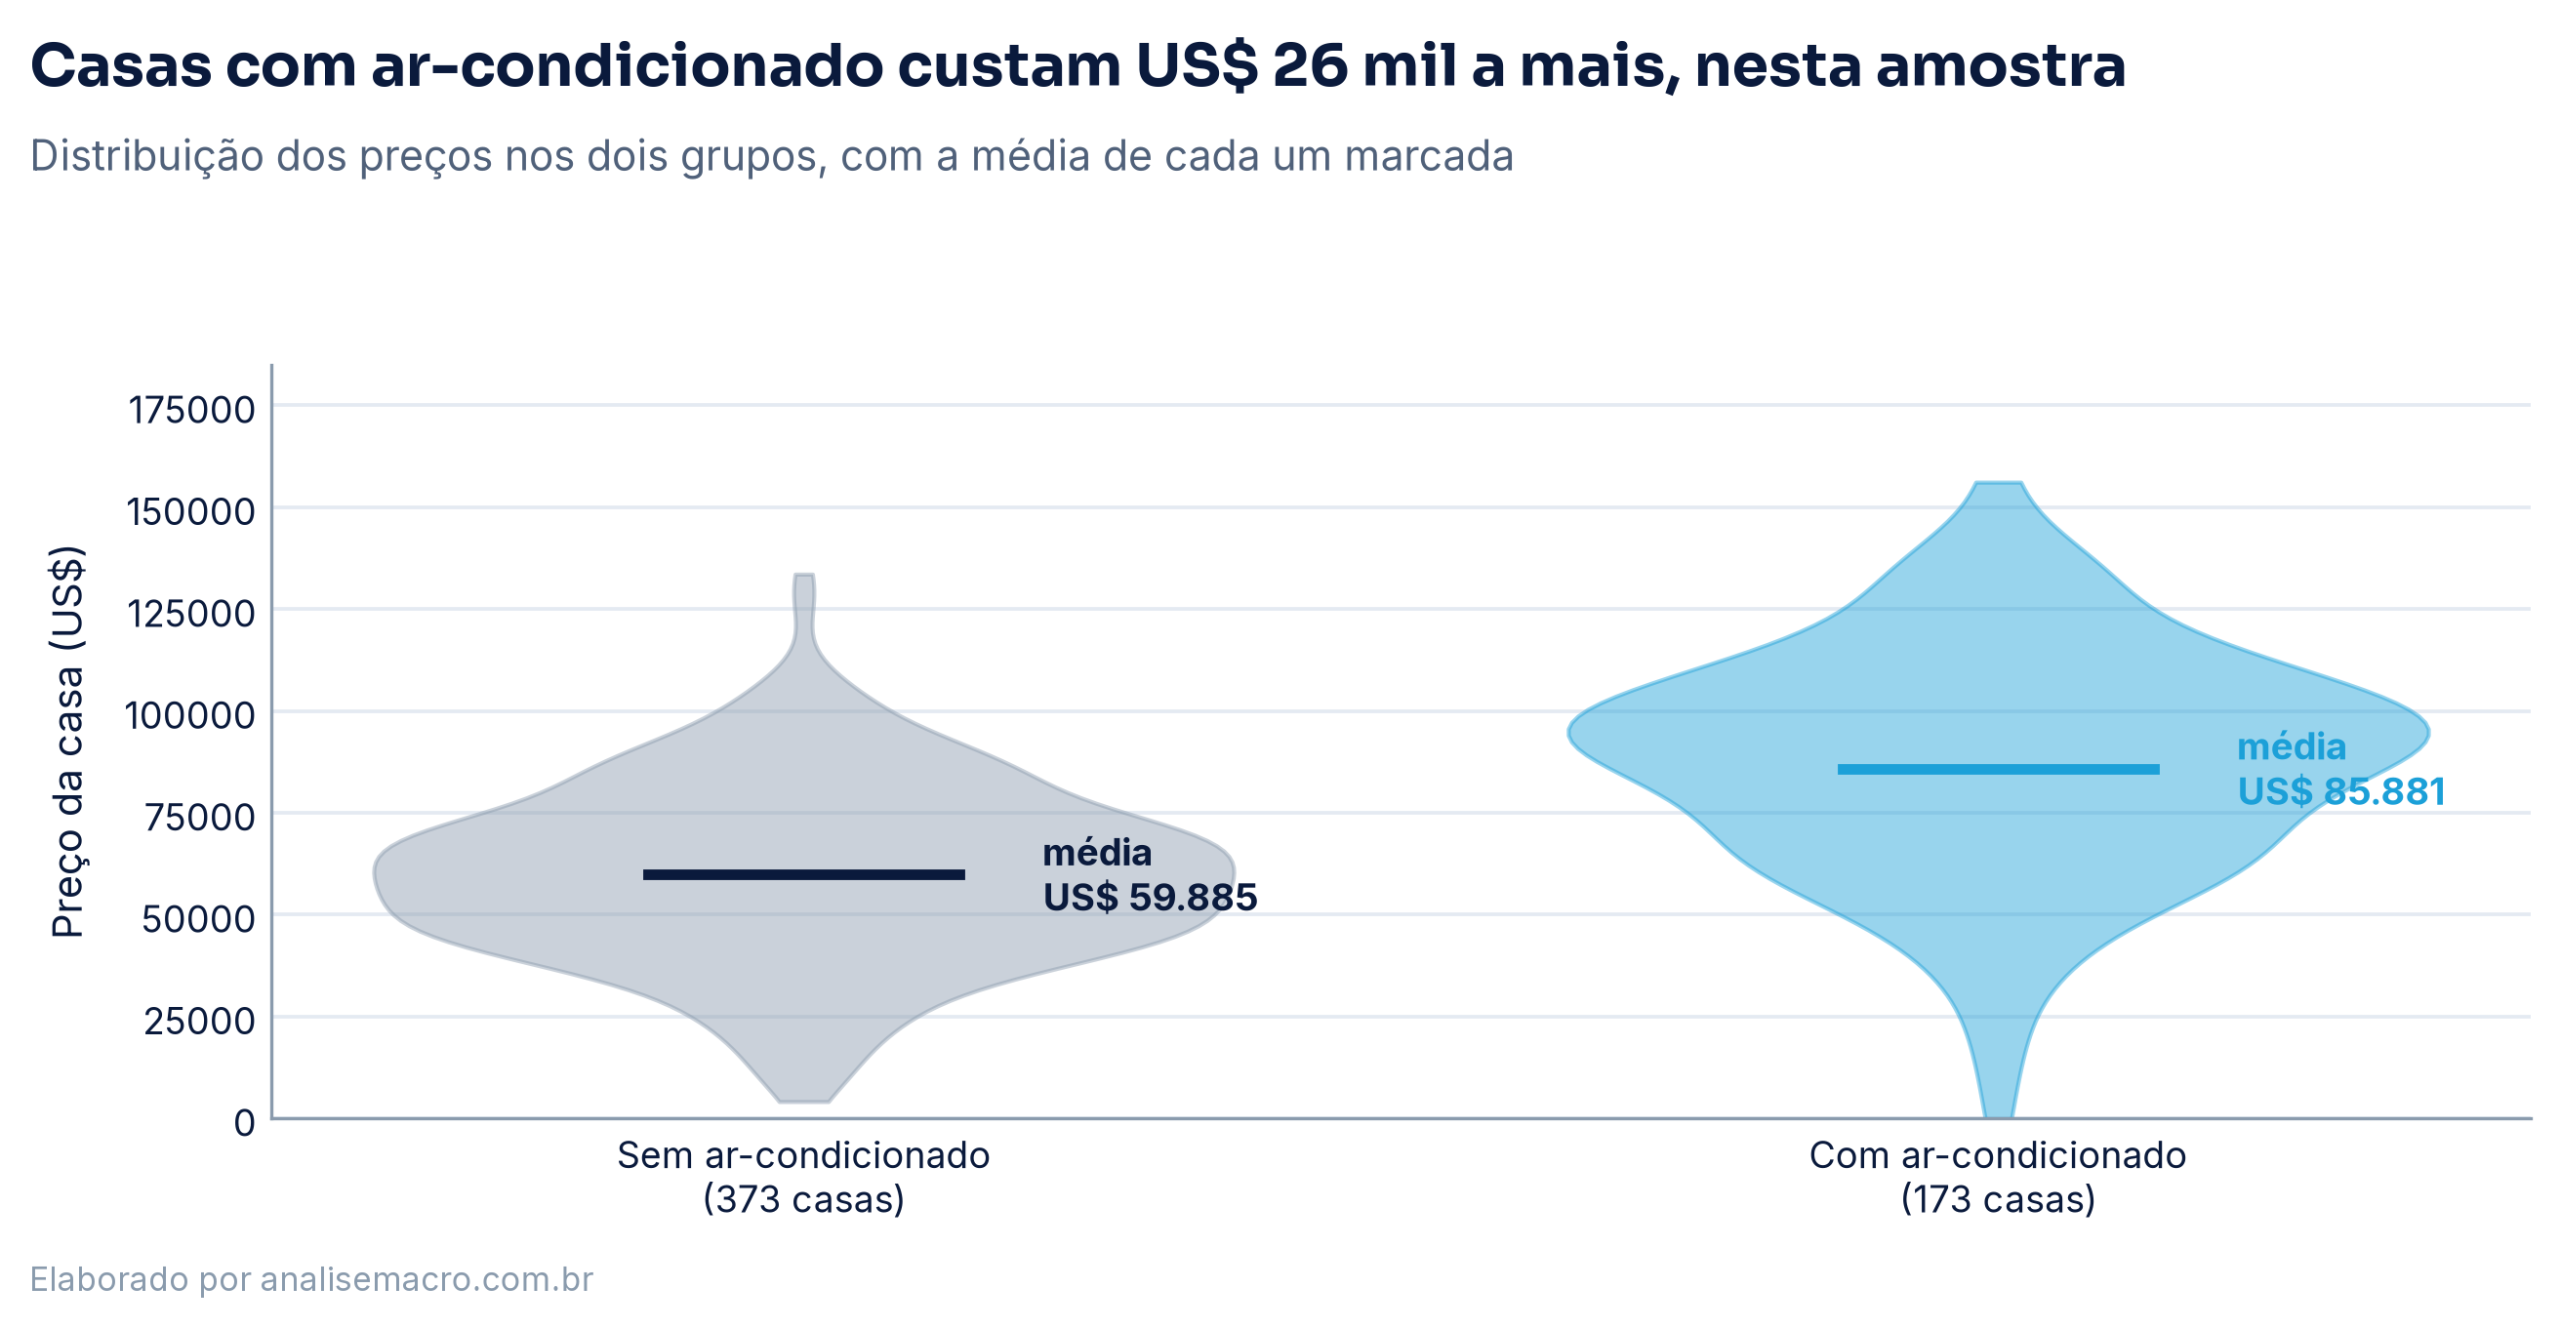
A diferença na amostra é de US$ 25.996. Mas sorteamos 546 casas de um mercado muito maior, e outra amostra daria outro número. A diferença que observamos reflete o mercado ou é produto do sorteio?
📩 Acompanhe nossas análises
O Boletim AM traz análises de conjuntura, exercícios em R e Python e material de estudo, direto no seu e-mail.
O teste de hipóteses responde à pergunta
Para decidir, partimos de uma suposição conservadora. A hipótese nula afirma que não existe diferença entre os grupos na população, e que os US$ 26 mil vieram do acaso do sorteio. A hipótese alternativa afirma o contrário.
O teste calcula quão improvável seria observar uma diferença desse tamanho num mundo em que a hipótese nula fosse verdadeira. Essa probabilidade é o valor-p.
t.test(
  price ~ airco,       # compara o preço entre os dois grupos
  var.equal = FALSE,   # não supõe variâncias iguais: é o teste de Welch
  data = house
)
O resultado traz t = −10,70, com 265 graus de liberdade e valor-p abaixo de 0,0001. Num mundo sem diferença real entre os grupos, uma amostra como a nossa apareceria em menos de uma vez a cada dez mil. Rejeitamos a hipótese nula.
Usamos a versão de Welch, com var.equal = FALSE, porque os desvios padrão dos dois grupos diferem (21.339 contra 28.463). Supor variâncias iguais quando elas não são infla a confiança no resultado.
O intervalo de confiança mostra a precisão
O valor-p responde se existe diferença, mas não diz de que tamanho ela é. Quem responde isso é o intervalo de confiança, que entrega uma faixa de valores compatíveis com os dados.
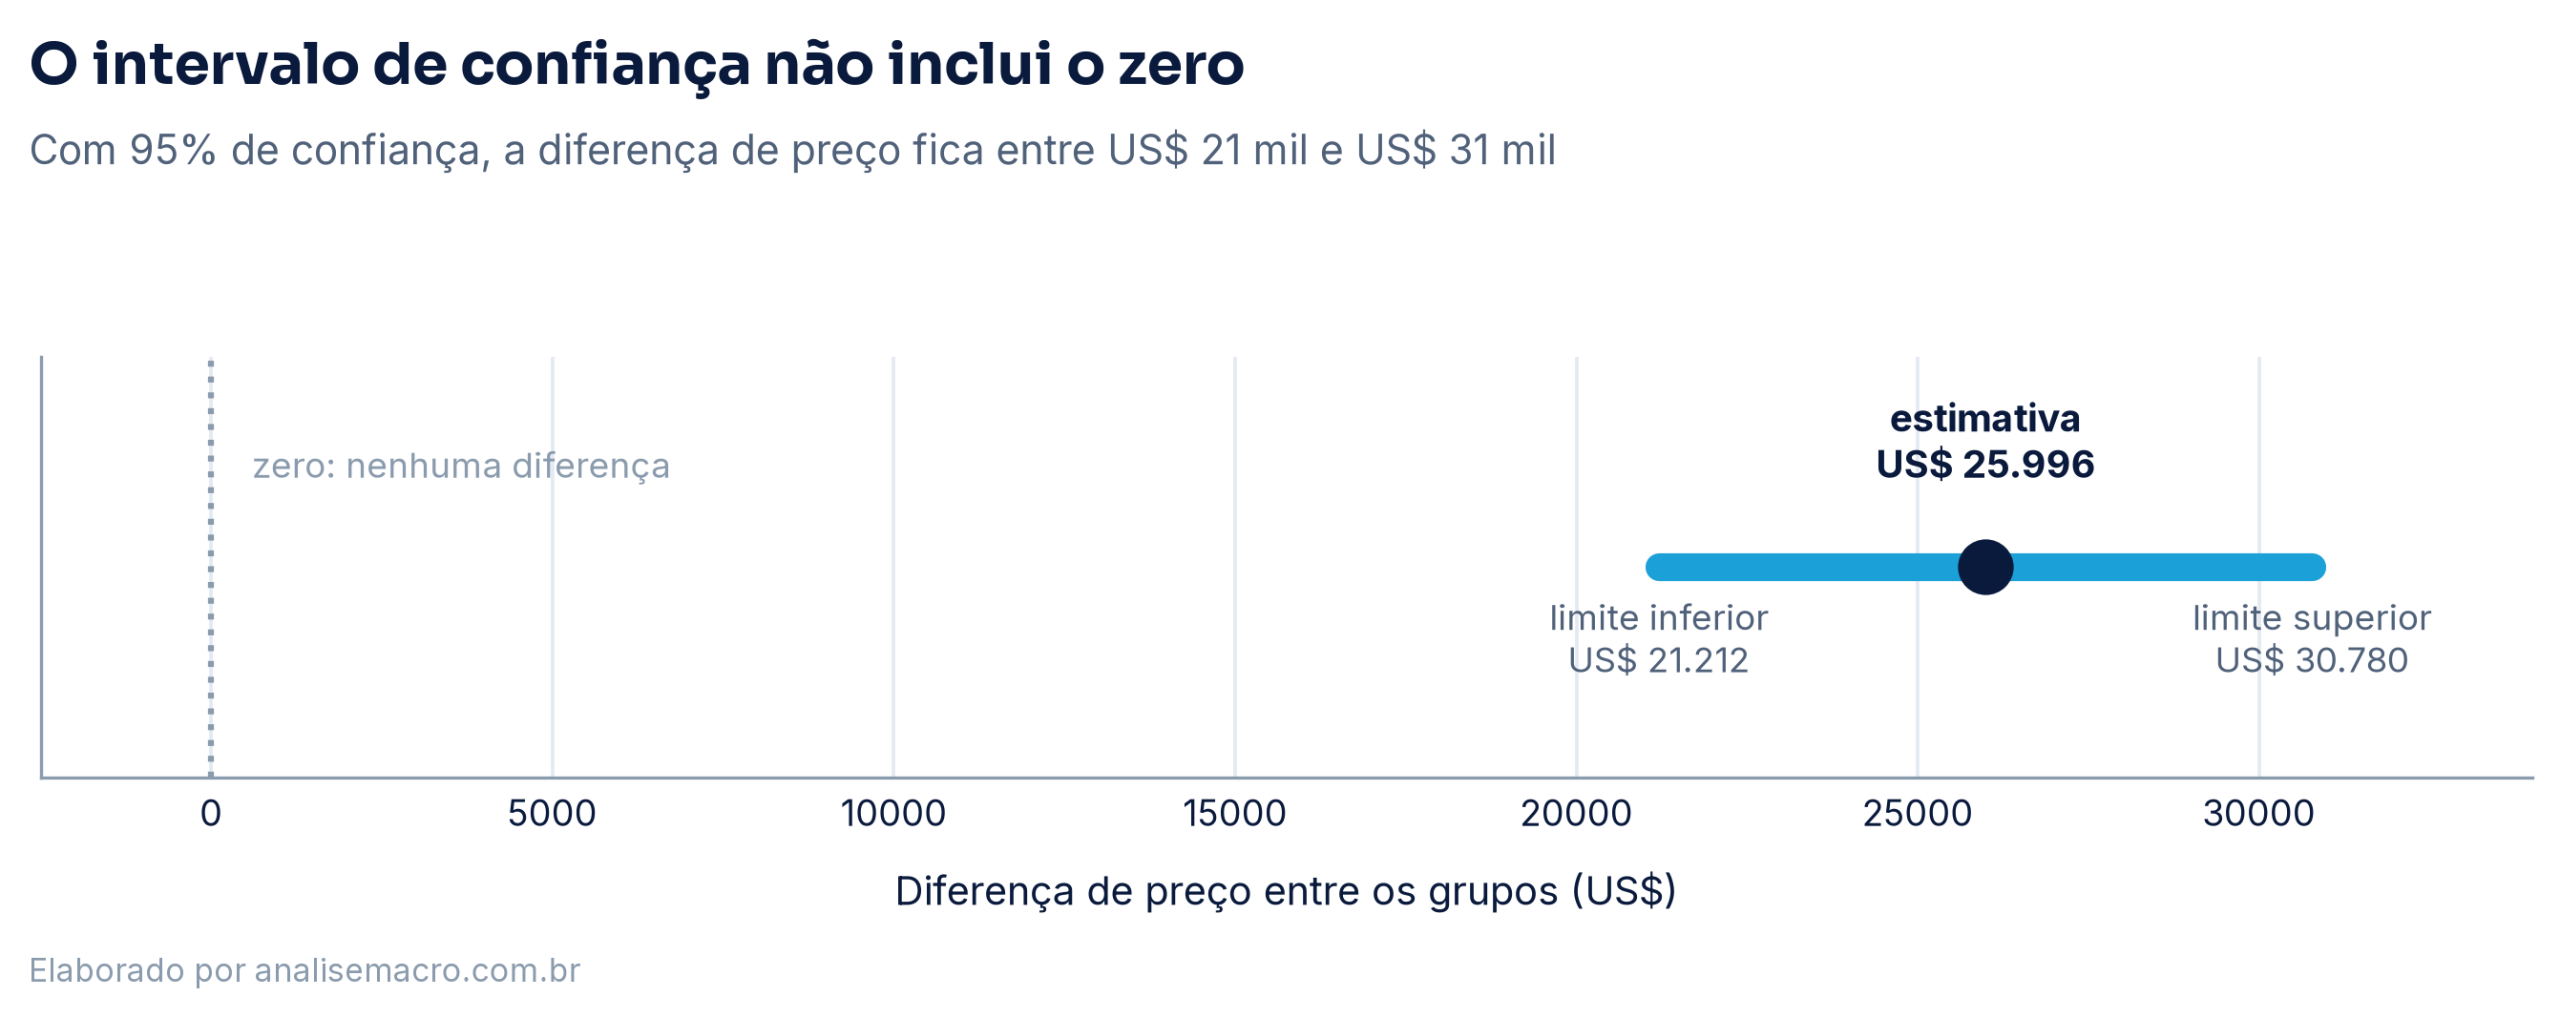
O intervalo informa mais que o teste. Além de dizer que a diferença existe, delimita sua magnitude: entre 21 e 31 mil dólares. Se o zero estivesse dentro da faixa, os dados seriam compatíveis com ausência de diferença.
O que o teste não responde
Rejeitar a hipótese nula estabelece associação, e não causa. Casas com ar-condicionado também tendem a ser maiores e mais novas, e qualquer uma dessas características explicaria parte da diferença de preço. Tratamos desse problema em correlação não implica causalidade.
O valor-p também não mede a importância prática do achado. Com amostra suficientemente grande, diferenças minúsculas atingem significância estatística sem qualquer relevância econômica. O tamanho do efeito e o intervalo respondem a essa pergunta, o valor-p não.
Toda a conclusão depende, ainda, de a amostra representar a população. Se as 546 casas vierem só de um bairro, a inferência vale para aquele bairro.
Onde a inferência aparece no dia a dia
Na pesquisa de mercado e eleitoral, a margem de erro divulgada é um intervalo de confiança. Dois candidatos dentro da margem estão tecnicamente empatados, por mais que a manchete aponte um vencedor.
No controle de qualidade, inspecionar toda a produção é inviável, então testa-se uma amostra e se decide sobre o lote inteiro. O método calcula o risco de rejeitar um lote bom e o de aprovar um lote ruim.
Em experimentos de produto, o teste A/B compara duas versões e usa inferência para decidir se a diferença observada justifica mudar o produto.
Na avaliação de políticas públicas, comparamos quem recebeu o programa com um grupo de controle, e a inferência estima o efeito do programa descontando a variação natural entre as pessoas.
Considerações finais
Percorremos o caminho completo: a distinção entre amostra e população, o erro padrão que mede a variação entre amostras, o teste de hipóteses que decide se a diferença se sustenta, e o intervalo de confiança que mostra sua magnitude.
No nosso exemplo, concluímos que casas com ar-condicionado custam entre US$ 21 mil e US$ 31 mil a mais em Windsor, com 95% de confiança. A frase traz a estimativa, a incerteza e o escopo, que é o formato de uma conclusão estatística honesta.
Dominar esse raciocínio muda o trabalho conforme a área:
- Analista de dados: reporta estimativa e incerteza juntas, em vez de um número solto.
- Economista: avalia se o efeito estimado de uma política se distingue de zero.
- Profissional de produto: decide com base em experimento, e não em impressão sobre o comportamento do usuário.
- Pesquisador de mercado: dimensiona a amostra necessária para a precisão que o cliente pede.
- Gestor: lê uma pesquisa sabendo que resultados dentro da margem de erro não distinguem os concorrentes.
Da inferência ao modelo
Estimar e testar é o primeiro passo; o seguinte é modelar a relação entre as variáveis. O AM Black é a assinatura anual que dá acesso a todos os cursos da Análise Macro, em R e em Python, da estatística básica à econometria aplicada.