Medir a incerteza da política monetária com IA significa pedir a um modelo de linguagem que leia cada discurso do banco central e devolva uma nota de 0 a 1 para o quanto aquele texto comunica dúvida sobre os juros.
Neste tutorial explicamos o que é incerteza de política monetária, como a literatura a mede pela contagem de palavras e por que um modelo de linguagem lê o mesmo texto de outra forma. O exemplo usa 250 discursos de Chairs e Vice Chairs do Federal Reserve, de 2017 a 2023, em Python.

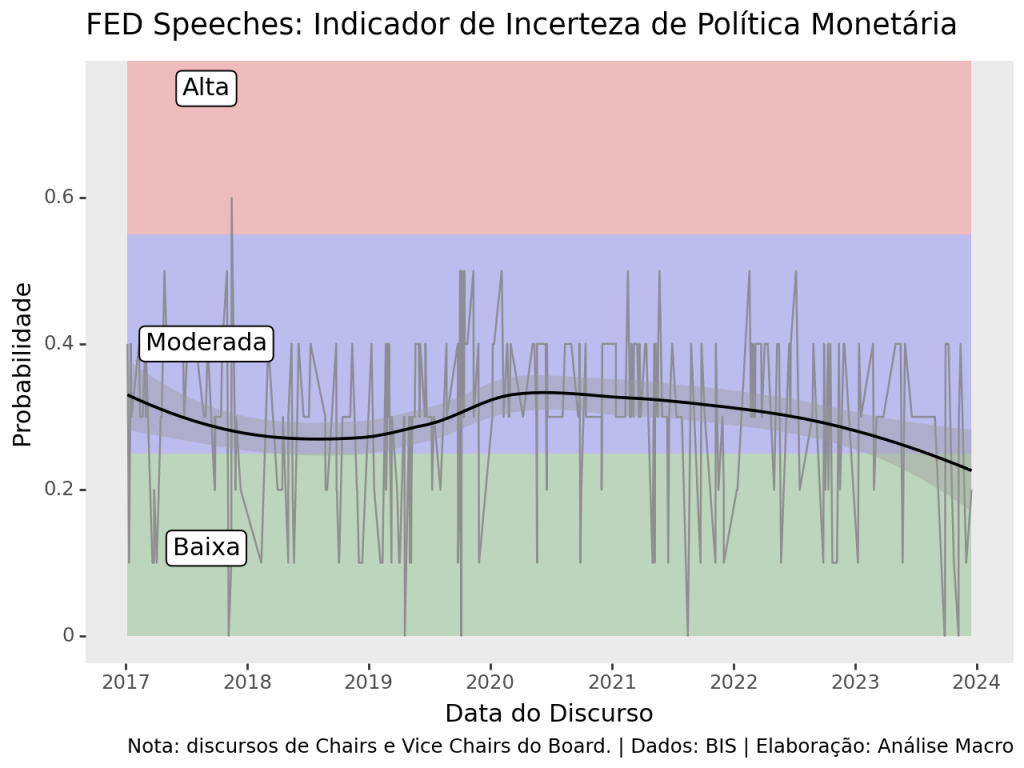
O gráfico acima é o indicador construído na execução de 2024 do exercício, com o Gemini 1.5 Pro. Cada linha cinza é a nota de um discurso, e a curva preta é a tendência: ela fica perto de 0,33 no início de 2017, recua para cerca de 0,27 entre 2018 e 2019, volta a 0,33 em 2020 e 2021 e cai para perto de 0,23 no fim de 2023.
Quase todas as notas ficam entre 0,1 e 0,5, na faixa moderada, e só um discurso, no fim de 2017, chega a 0,6. A subida de 2020 coincide com o choque da pandemia e o corte dos juros a zero.
A medida tradicional, por contagem de palavras, quase não registra esse movimento: nos mesmos discursos, a média de termos de incerteza por mil palavras foi de 5,1 em 2020, abaixo dos 6,5 de 2017. A contagem soma as palavras sem distinguir se o "risk" do texto fala de juros ou de supervisão bancária.
📬 Boletim AM
Receba análises e conteúdos sobre modelos estatísticos clássicos, econometria feita com hipóteses sérias e LLMs acessados em ambientes de trabalho reais, tudo aplicado à economia, ao mercado financeiro e à análise de dados.
O que é incerteza de política monetária
Incerteza de política monetária é a dúvida dos agentes sobre o caminho futuro dos juros, do balanço do banco central e das regras que orientam essas decisões.
Ela pesa sobre a economia porque empresas e famílias tendem a adiar investimento e consumo quando não sabem quanto vai custar o dinheiro nos próximos meses.
O banco central é, ao mesmo tempo, a fonte dessa dúvida e quem pode reduzi-la. Por isso os discursos dos seus dirigentes são lidos frase a frase pelo mercado.
Como a literatura mede a incerteza
A medida mais difundida é o índice de incerteza da política econômica (Economic Policy Uncertainty, EPU), de Baker, Bloom e Davis. Ele conta, em grandes jornais, a fração de reportagens que trazem ao mesmo tempo termos de economia, de política e de incerteza.
Aqui t é o mês, o numerador conta os artigos que atendem aos três critérios e o denominador é o volume total de notícias publicadas no mesmo mês.
Dividir pelo total evita que um mês com mais páginas publicadas pareça mais incerto apenas por isso. Ou seja, o índice mede a proporção do noticiário dedicada à dúvida sobre a política.
A versão de política monetária troca o critério de "política" por termos ligados ao banco central, como "Federal Reserve" e "interest rates". Detalhamos a construção de um índice desse tipo para o Brasil em Construindo um indicador alternativo de incerteza para a economia brasileira.
Aplicada a discursos, a mesma ideia vira uma taxa: termos de incerteza por mil palavras de cada texto. É a medida que usamos como referência no exercício.
O índice i identifica o discurso. A lista de termos vem de dicionários construídos para textos financeiros, como o Loughran-McDonald, que separa uma categoria específica de palavras de incerteza.
Por que usar um modelo de linguagem
Um modelo de linguagem, ou LLM (large language model), é um modelo treinado em grandes volumes de texto para prever a continuação de uma frase. Esse treino o faz capturar o sentido de uma palavra pelo contexto em volta, como explicamos em O que são LLMs?.
A contagem trata essas ocorrências da mesma forma. Em "the risk of higher inflation" e em "risk management at community banks" a palavra é a mesma, mas só a primeira frase diz algo sobre a trajetória dos juros.
Contagem de palavras e LLM, lado a lado
Contagem: transparente, rápida e sem custo por documento. Trata cada palavra isoladamente, então mede o vocabulário do texto.
LLM: lê o contexto e segue uma definição escrita no prompt, então consegue dar nota baixa a um discurso sobre supervisão que cita "risk" vinte vezes. Tem custo por chamada e depende da versão do modelo.
As duas medidas se complementam. A contagem funciona como referência: se a nota do modelo não tiver relação nenhuma com ela, há algo errado no prompt ou nos dados.
O método, etapa por etapa
| Etapa | O que se faz | Por que importa |
|---|---|---|
| Coletar | Reunir os discursos compilados pelo BIS e filtrar Chairs e Vice Chairs do Fed | Define de quem é a voz que o indicador mede |
| Medir por contagem | Contar termos de incerteza por mil palavras | Dá a referência transparente para validar o modelo |
| Escrever o prompt | Definir incerteza de política monetária e a escala da nota | O modelo mede o que a instrução descreve |
| Pontuar | Uma chamada ao Gemini por discurso, com resposta em JSON | Cada texto é avaliado isoladamente e vira dado |
| Comparar | Correlação entre a nota do modelo e a contagem | Verifica a coerência da nota |
O prompt é a peça que mais define o resultado. Ele traz o papel do modelo, a definição de incerteza ancorada na literatura do EPU, a escala de 0 a 1 e a instrução de dar nota baixa a temas alheios aos juros. As técnicas para escrever essa instrução estão em Introdução a Prompt Engineering para Inteligência Artificial.
Duas configurações tornam a resposta utilizável como série de dados. A temperatura, que controla a aleatoriedade da resposta, fica em zero, para que o mesmo discurso tenda a receber a mesma nota.
A segunda é o esquema de resposta: em vez de texto livre, o modelo devolve um JSON com a nota e uma justificativa de uma frase. A justificativa permite auditar, discurso a discurso, o que o modelo enxergou.
No exercício, as chamadas usam a biblioteca oficial google-genai com o modelo Gemini 2.5 Flash, e os gráficos são feitos em plotnine. O passo a passo para obter a chave de API está em Como usar o Google AI Studio e o Gemini?.
O exemplo: discursos do Fed de 2017 a 2023
Os discursos vêm do Bank for International Settlements (BIS), que compila as falas de dirigentes dos principais bancos centrais. A amostra reúne 250 discursos de seis Chairs e Vice Chairs do Board of Governors.

Na base completa do BIS desde 2000, Ben Bernanke lidera com cerca de 250 discursos, seguido por Jerome Powell e Lael Brainard, ambos acima de 100. Na amostra do indicador, restrita a Chairs e Vice Chairs de 2017 a 2023, Powell soma 91 discursos e Brainard, 85: juntos, 176 dos 250, então o indicador agregado reflete sobretudo a comunicação dos dois.

O ritmo de discursos também muda no tempo. A tendência sobe de perto de 1 por mês em 2000 para cerca de 7 por volta de 2008, recua para perto de 4,5 em meados da década de 2010 e volta a subir depois, com picos isolados acima de 15 discursos num mesmo mês.
Os discursos têm, em média, cerca de 17,5 mil caracteres. Enviar todos num único pedido esbarraria no limite de contexto do modelo; com uma chamada por discurso, cada texto cabe com folga e a amostra pode crescer sem esse limite.
No exercício, a nota é recalculada com uma chamada por discurso e temperatura zero, e os discursos mais incertos aparecem listados com a justificativa do modelo ao lado.
Onde esse tipo de indicador é usado
- Acompanhamento de bancos centrais. Uma série de incerteza dos discursos complementa a leitura das decisões e ajuda a identificar quando o próprio banco central sinaliza dúvida sobre os próximos passos. A mesma lógica classifica o tom hawkish ou dovish da política monetária.
- Modelos macroeconômicos. Índices de incerteza entram como variável em modelos de investimento, consumo e atividade, na linha aberta pelo EPU.
- Mercado financeiro. Picos de incerteza na comunicação tendem a coincidir com maior volatilidade de juros futuros e câmbio, o que interessa a quem gere risco.
- Outros bancos centrais. O BIS publica discursos de dezenas de instituições, e o mesmo procedimento se aplica a qualquer uma delas, inclusive a textos em português do Banco Central do Brasil.
Esses usos fazem parte de uma área mais ampla, a mineração de textos e sua relação com IA, que transforma documentos em séries que podem ser analisadas como qualquer outro dado econômico.
Considerações finais
A incerteza de política monetária pode ser medida de duas formas complementares. A contagem de palavras é transparente e barata, mas lê o vocabulário. O modelo de linguagem lê o contexto e segue uma definição escrita.
Nos discursos do Fed, o indicador por IA sobe em 2020, enquanto a contagem de palavras quase não reage ao ano mais turbulento da amostra. Essa diferença é o argumento para pedir a leitura a um LLM.
O resultado do modelo depende do prompt e do método de chamada. Uma chamada por discurso, temperatura zero e resposta em JSON com justificativa transformam a leitura do modelo em dado auditável.
Dominar esse ferramental muda o trabalho de quem acompanha comunicação institucional:
- Economista: constrói uma série de incerteza da comunicação oficial e a usa em modelos de atividade.
- Analista de research: resume centenas de discursos em uma medida comparável entre períodos e dirigentes.
- Cientista de dados: monta a etapa de classificação de textos com LLM, com saída estruturada pronta para análise.
- Gestor de risco: acompanha sinais de dúvida do banco central antes que eles apareçam nos preços.
Linguagem Econômica: mineração de textos de Bancos Centrais
Os dez capítulos do livro digital percorrem o caminho completo: dos primeiros tratamentos de texto ao indicador de sentimentos do COPOM e à classificação do tom da política monetária com IA generativa. Exercícios aplicados, em Python.
Leia também
- O que é análise de similaridade e como aplicar no Python?: como comparar documentos e medir a distância entre textos de bancos centrais.
- O que é e como aplicar análise de sentimentos no Python?: o método de dicionário em detalhe, com o Loughran-McDonald.
Referências
BAKER, Scott R.; BLOOM, Nicholas; DAVIS, Steven J. Measuring economic policy uncertainty. The Quarterly Journal of Economics, v. 131, n. 4, p. 1593-1636, 2016.
HUSTED, Lucas; ROGERS, John; SUN, Bo. Monetary policy uncertainty. Journal of Monetary Economics, v. 115, p. 20-36, 2020.
LOUGHRAN, Tim; McDONALD, Bill. When is a liability not a liability? Textual analysis, dictionaries, and 10-Ks. The Journal of Finance, v. 66, n. 1, p. 35-65, 2011.
📩 Análise de dados aplicada, todo dia
Este exercício é um recorte. No Boletim AM eu mostro o trabalho com dado do jeito que ele acontece — coletar, limpar, rodar o modelo e ler o resultado, em R, Python e agora com IA no meio do caminho.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.