Dois textos podem tratar do mesmo assunto sem que um tenha copiado o outro. A análise de similaridade mede o quanto dois documentos se parecem, e as medidas que ela oferece respondem a perguntas diferentes.
O Índice de Jaccard compara vocabulários: quais palavras os dois textos usam. As sequências idênticas comparam a ordem: quais trechos aparecem na mesma forma nos dois.
Neste tutorial explicamos as duas e mostramos o que cada uma consegue distinguir, aplicando-as a um caso real de acusação de plágio.
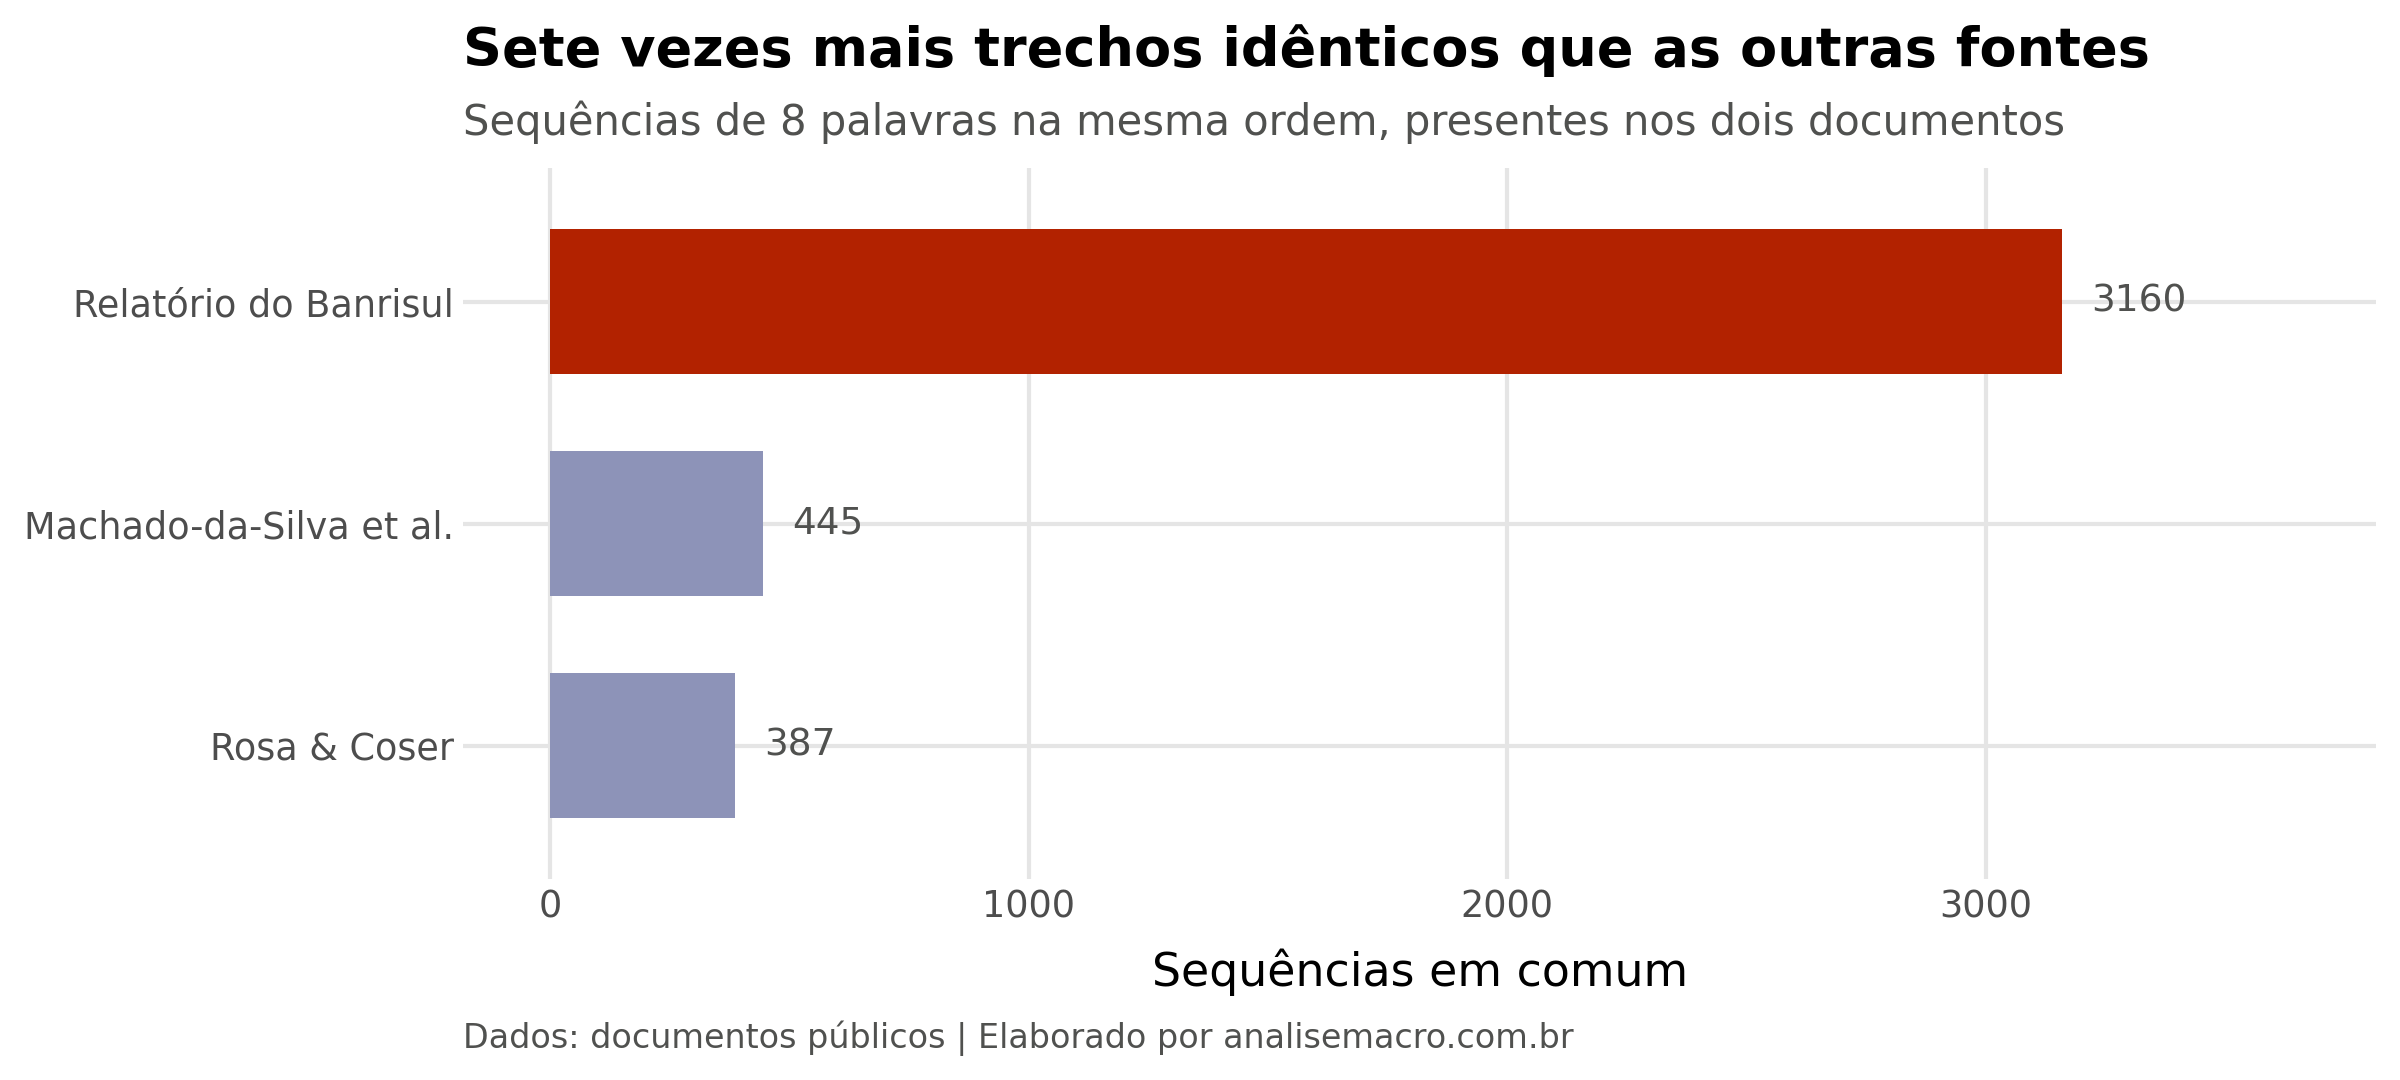
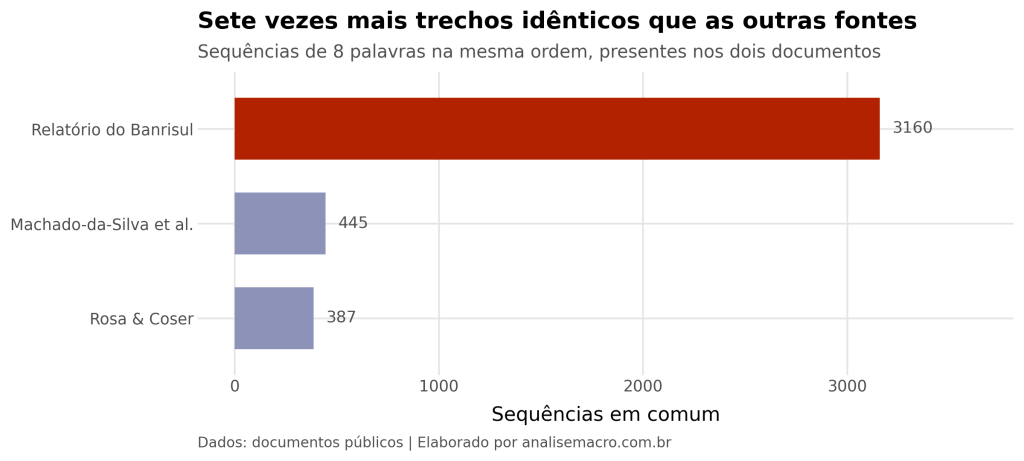
O gráfico acima resume o exercício. Comparamos um documento com três possíveis fontes e contamos quantas sequências de oito palavras aparecem na mesma ordem nos dois textos.
Uma das fontes destoa por uma ordem de grandeza. Sequências longas assim não acontecem por coincidência entre textos independentes.
📬 Estatística, econometria e IA aplicada. Todo dia, no seu e-mail.
O Boletim AM traz modelos estatísticos, econometria e LLMs aplicados a Economia, Finanças e análise de dados, com exemplos em R e Python. Todo domingo, às 20h, uma leitura mais longa que reúne as fontes da semana.
O que é o Índice de Jaccard?
O Índice de Jaccard mede a sobreposição entre dois conjuntos. Ele divide o que os dois têm em comum pelo total de elementos distintos que aparecem em pelo menos um deles.
Aplicado a texto, A e B são os conjuntos de palavras distintas de cada documento. O numerador conta as palavras presentes nos dois; o denominador, as palavras que aparecem em qualquer um deles.
O resultado fica entre 0 e 1. Dois documentos sem nenhuma palavra em comum dão 0, e dois documentos com exatamente o mesmo vocabulário dão 1.
A medida é barata de calcular, o que permite varrer acervos grandes. É por isso que ela aparece em detecção de duplicatas, sistemas de recomendação e agrupamento de documentos.
O que o Jaccard não vê
Transformar um documento em conjunto descarta duas informações: a ordem das palavras e quantas vezes cada uma aparece.
As frases "o banco financiou a empresa" e "a empresa financiou o banco" têm Jaccard igual a 1, porque usam exatamente as mesmas palavras. A medida indica proximidade temática, e é isso que ela se propõe a fazer.
O caso que serve de exemplo
Em junho de 2020, apontou-se publicamente que a dissertação de mestrado do então Ministro da Educação, Carlos Decotelli, continha indícios de plágio. O episódio terminou com a demissão antes da posse.
Para o exercício, o que interessa é a estrutura do problema: um documento sob suspeita e três fontes apontadas como origem dos trechos. É o formato em que a análise de similaridade se aplica.
Os quatro documentos são públicos. Convertidos de PDF para texto, descartando capa, sumário e referências, eles somam entre 4,9 mil e 21 mil palavras.
Do PDF ao número
| Etapa | O que se faz | O que acontece sem ela |
|---|---|---|
| Converter | PDF para texto, sem capa nem referências | A bibliografia comum infla a semelhança |
| Limpar | Minúsculas, sem pontuação e sem dígitos | "Banco" e "banco" contam como palavras distintas |
| Tokenizar | Separar o texto em palavras | Não há unidade sobre a qual comparar |
| Comparar | Calcular o índice entre cada par | — |
As três primeiras etapas são as do pré-processamento de dados textuais, e a escolha de descartar as referências importa: duas teses da mesma área citam os mesmos autores, e isso elevaria a semelhança sem relação com o corpo do texto.
O resultado do Jaccard
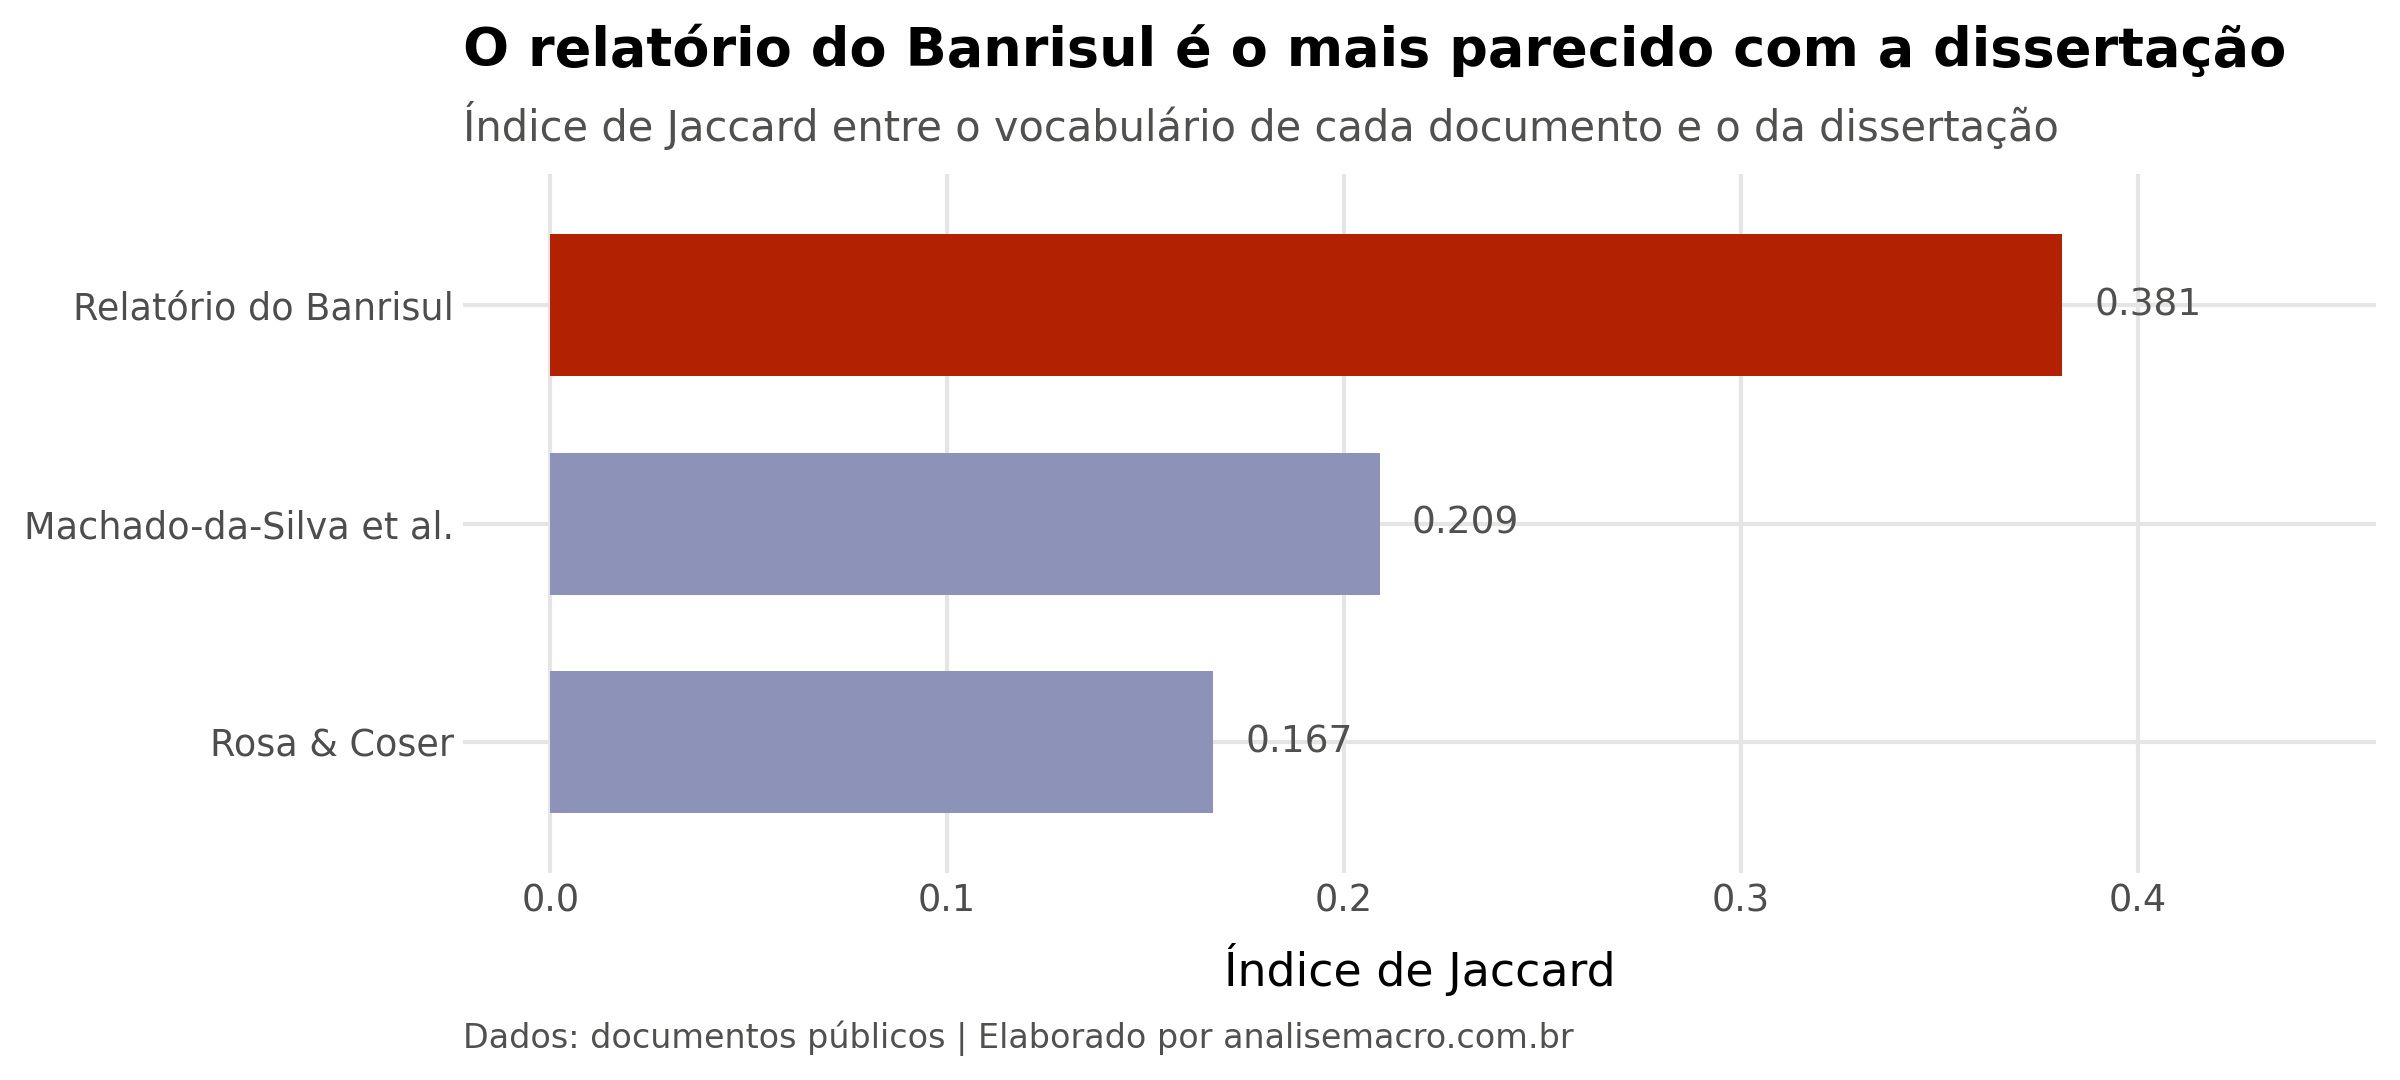
O relatório do Banrisul tem índice de 0,38 contra a dissertação. Os dois artigos acadêmicos ficam em 0,21 e 0,17.
A ordem coincide com o que havia sido apontado publicamente em 2020, o que já é um resultado. Mas falta responder a uma pergunta antes de concluir qualquer coisa.
0,38 é alto?
Um índice só significa alguma coisa contra uma referência. E há um detalhe que atrapalha a leitura direta: documentos de tamanhos diferentes têm um teto de Jaccard menor por construção.
Se um texto tem o dobro do vocabulário do outro, a união cresce e o índice cai, mesmo que todas as palavras do menor estejam presentes no maior.
Para medir esse efeito, comparamos a dissertação com um trecho dela mesma, sorteado no tamanho do relatório. O resultado foi 0,68.
| Comparação com a dissertação | Índice de Jaccard |
|---|---|
| Um trecho da própria dissertação, mesmo tamanho | 0,68 — o teto que o tamanho permite |
| Relatório do Banrisul | 0,38 |
| Machado-da-Silva et al. | 0,21 |
| Rosa & Coser | 0,17 |
O 0,38 fica bem abaixo do teto e bem acima das outras fontes. A medida aponta uma direção, sem fechar a questão.
Sequências idênticas: quando a ordem entra
Para distinguir tema compartilhado de cópia, precisamos de uma medida que leve a ordem das palavras em conta.
Um n-grama é uma sequência de n palavras consecutivas. A frase "o cálculo do índice de basileia considera o patrimônio" contém várias sequências de oito palavras, cada uma começando em uma posição diferente.
Duas pessoas escrevendo sobre o mesmo banco usam as mesmas palavras. Montar a mesma sequência de oito palavras por acaso é outra coisa.
O Jaccard pergunta "estes textos falam do mesmo assunto?". Os n-gramas perguntam "este trecho foi reproduzido?".
No exercício, o relatório compartilha 3.160 sequências de oito palavras com a dissertação, contra 445 e 387 das outras duas fontes. Os trechos em comum são prosa corrida, não jargão que qualquer texto da área usaria.
Como as duas medidas se combinam
O Jaccard é rápido e serve de triagem: percorre o acervo inteiro e aponta os pares suspeitos.
Os n-gramas custam mais para calcular, mas distinguem cópia de tema compartilhado. Na prática, usa-se o primeiro para filtrar e o segundo para confirmar.
Onde a análise de similaridade é usada
- Detecção de duplicatas. Em bases de clientes, processos ou produtos, o mesmo registro cadastrado duas vezes com grafias diferentes tem similaridade alta e pode ser agrupado automaticamente.
- Comparação de documentos ao longo do tempo. Medir a similaridade entre comunicados sucessivos separa a reunião em que o texto foi reescrito daquela em que ele apenas repetiu o anterior.
- Recomendação por conteúdo. Sugerir um artigo parecido com o que a pessoa acabou de ler passa por medir a proximidade entre os textos.
- Verificação de originalidade. O uso que motivou este exercício, e o mesmo princípio por trás das ferramentas comerciais de detecção de plágio.
O segundo caso é o mais próximo da análise econômica. Comparar comunicados de bancos centrais entre reuniões revela se houve mudança de linguagem, e mudança de linguagem costuma anteceder mudança de política.
Considerações finais
A análise de similaridade transforma a comparação entre documentos em um número, o que permite percorrer acervos que ninguém leria por completo.
O Índice de Jaccard mede sobreposição de vocabulário, e por isso responde à pergunta sobre o tema. No exercício, ele destacou uma das fontes com 0,38 contra 0,21 e 0,17.
As sequências idênticas medem reprodução literal, e a diferença entre as fontes passou a ser de sete vezes. Duas medidas, duas perguntas distintas, respostas que convergem.
Nenhuma delas substitui a análise humana de um caso concreto. O que elas fazem é apontar onde olhar.
Dominar esse ferramental muda o trabalho de quem lida com texto em volume:
- Economista — compara comunicados e atas entre datas para detectar mudança de linguagem antes da mudança de decisão.
- Cientista de dados — encontra registros duplicados em bases grandes sem depender de correspondência exata.
- Analista de research — identifica quando um relatório apenas reciclou o anterior, sem leitura integral.
- Pesquisador — verifica originalidade em um acervo de trabalhos antes da revisão humana.
Linguagem Econômica: mineração de textos de Bancos Centrais
Os dez capítulos do livro digital percorrem o caminho completo: dos primeiros tratamentos de texto ao indicador de sentimentos do COPOM e à classificação do tom da política monetária com IA generativa. Exercícios aplicados, em Python.
Quer acesso a todos os cursos da Análise Macro? Conheça o AM Black, a assinatura anual.
Leia também
- Técnicas de extração de informação com text mining — TF-IDF e Lei de Zipf, as medidas que pesam termos dentro de um documento.
- Técnicas de machine learning para mineração de textos — o Naive Bayes classificando textos a partir das mesmas contagens.
Referências
LESKOVEC, Jure; RAJARAMAN, Anand; ULLMAN, Jeffrey. Mining of Massive Datasets. Cambridge: Cambridge University Press, 2011. Capítulo 3.
📩 Análise de dados aplicada, todo dia
Este exercício é um recorte. No Boletim AM eu mostro o trabalho com dado do jeito que ele acontece — coletar, limpar, rodar o modelo e ler o resultado, em R, Python e agora com IA no meio do caminho.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.