Quando lemos um documento, usamos nossa compreensão do sentido das palavras para inferir se o tom é otimista ou pessimista. "Recessão" puxa para um lado, "crescimento" para o outro.
A análise de sentimentos faz essa mesma inferência de forma quantitativa. Em vez de ler, o computador conta: quantas palavras positivas e quantas negativas o texto contém, segundo uma lista classificada previamente.
Neste tutorial explicamos como a medida é construída, por que a escolha do dicionário decide o resultado, e aplicamos o método a cem atas do COPOM.
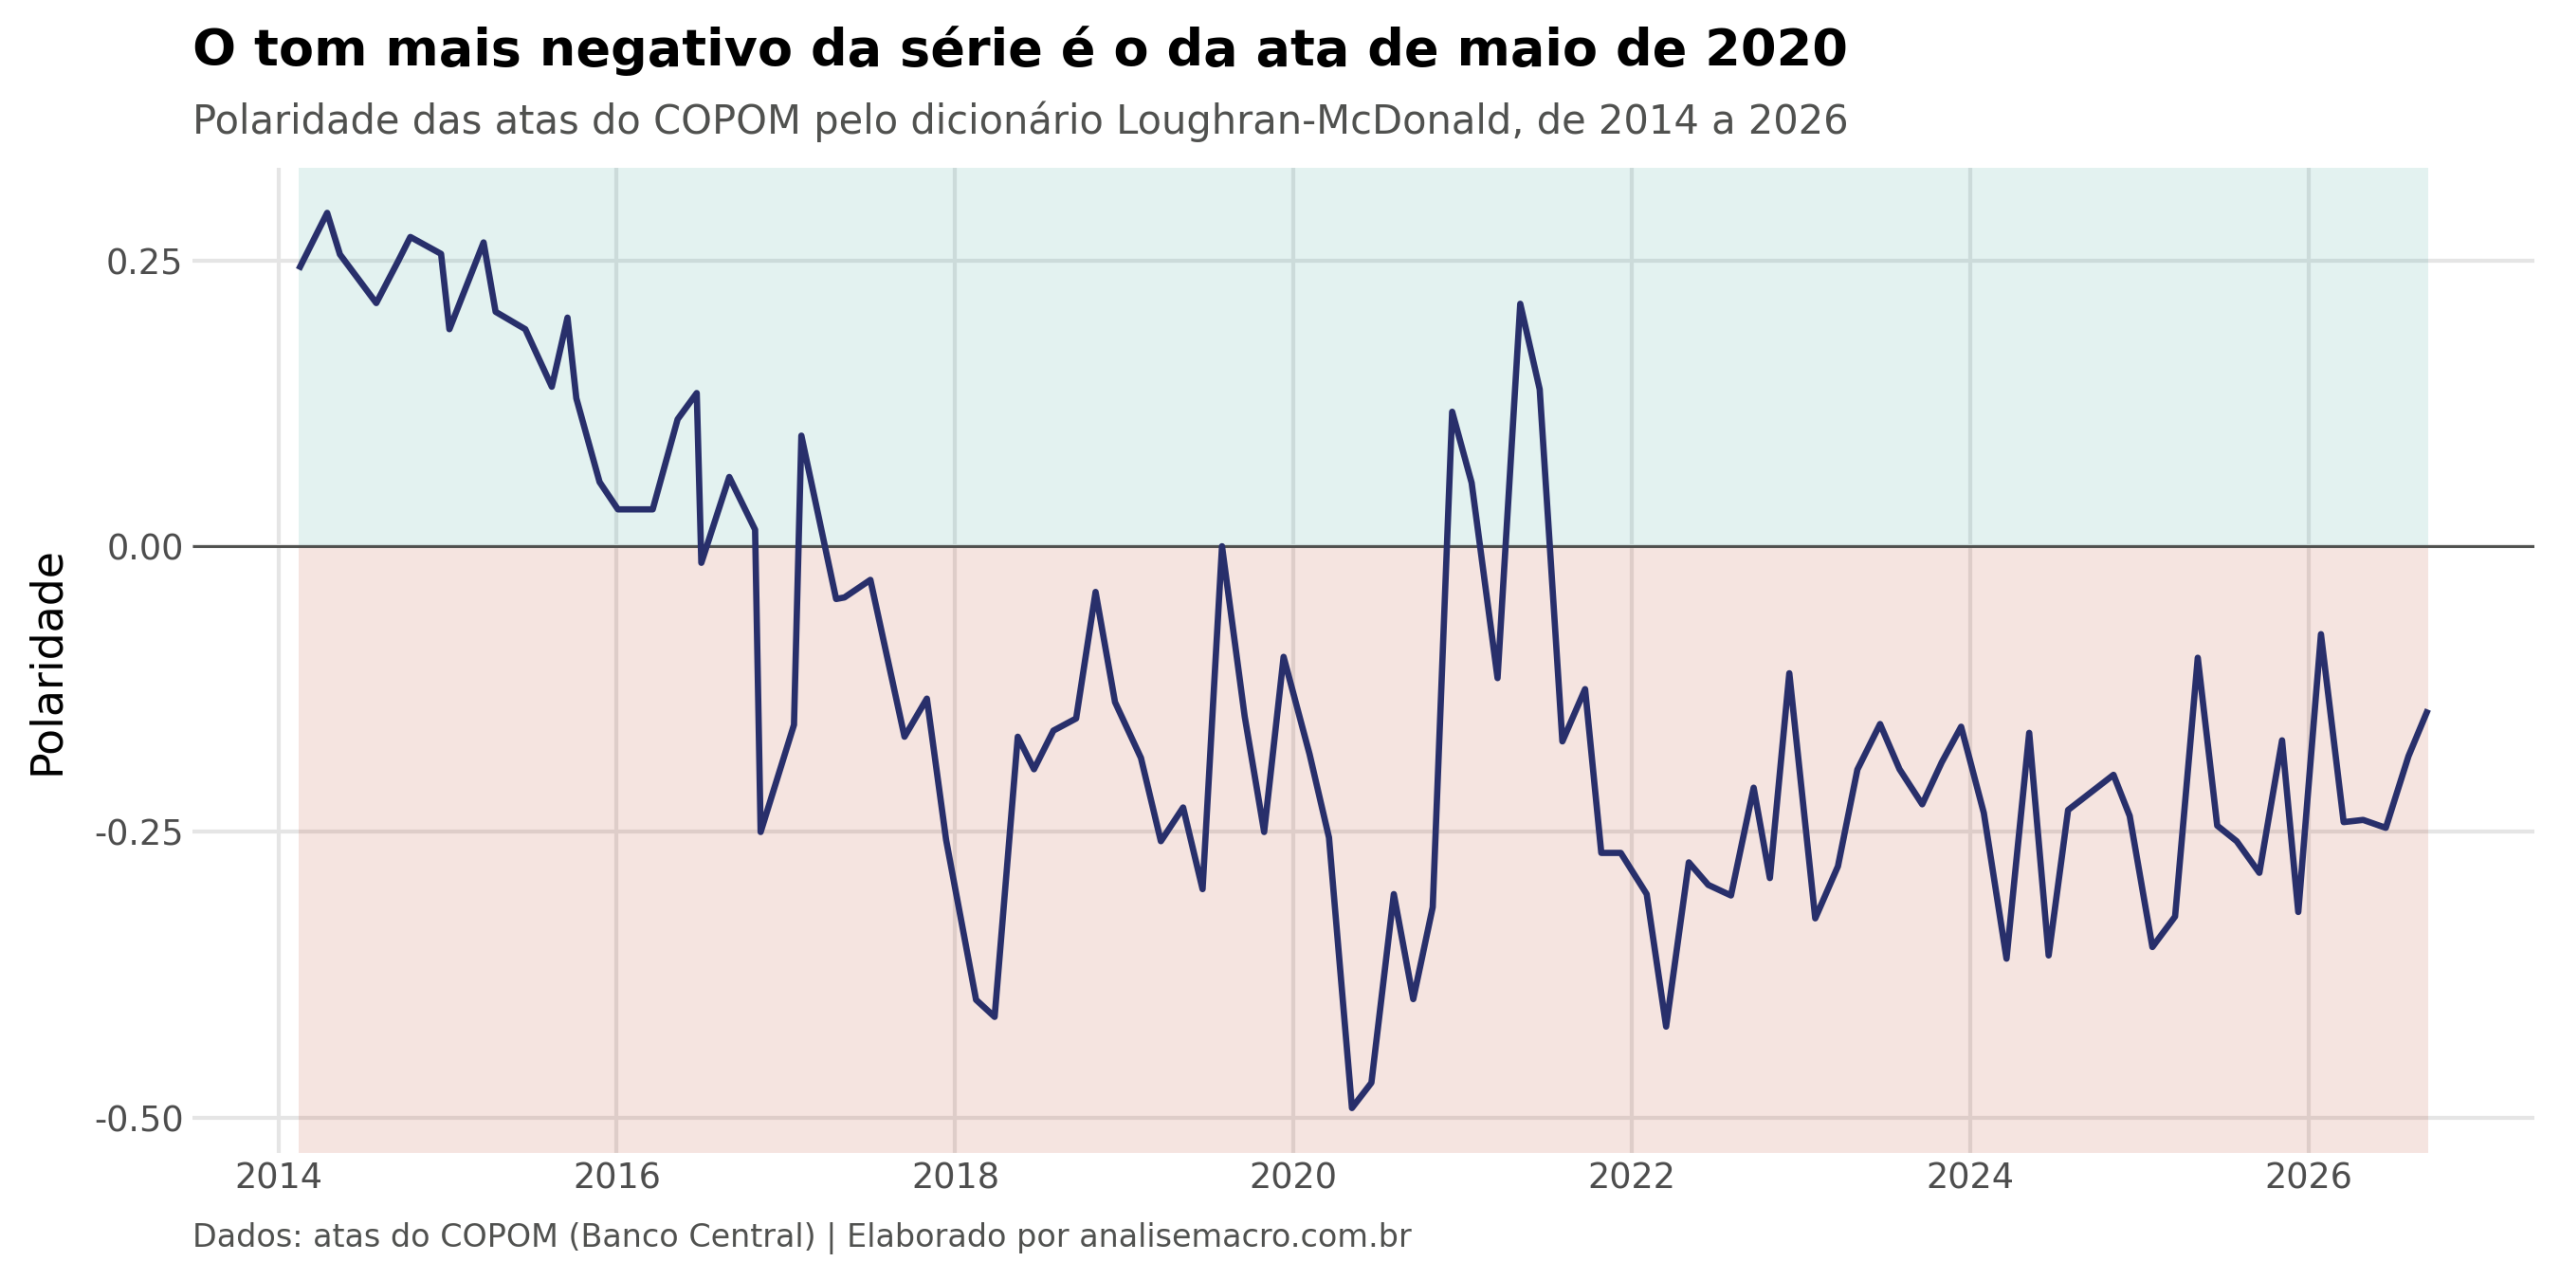
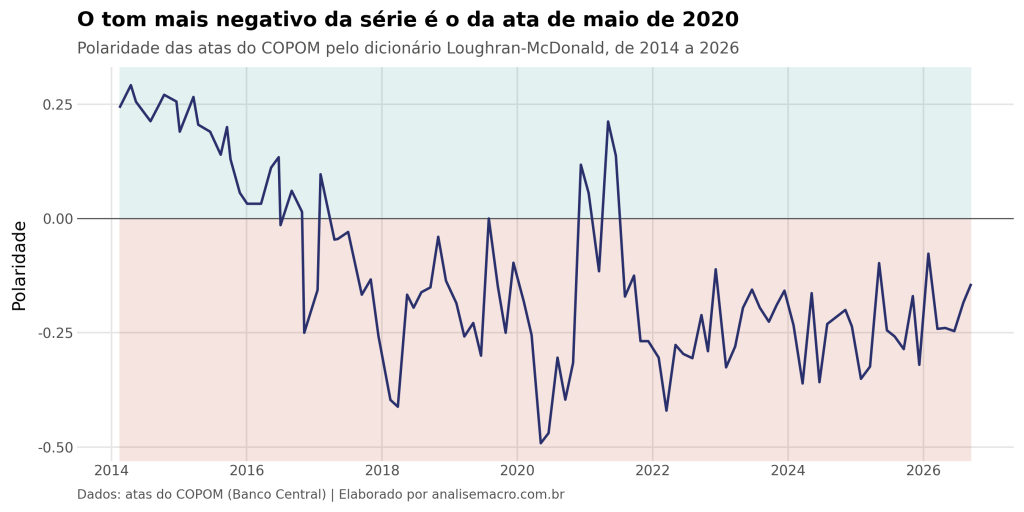
A série acima acompanha a história recente. O tom cai durante a recessão de 2015 e 2016, atinge o mínimo na ata de maio de 2020, nas primeiras semanas da pandemia, e sobe para o pico de 2021, durante a retomada.
📬 Estatística, econometria e IA aplicada. Todo dia, no seu e-mail.
O Boletim AM traz modelos estatísticos, econometria e LLMs aplicados a Economia, Finanças e análise de dados, com exemplos em R e Python. Todo domingo, às 20h, uma leitura mais longa que reúne as fontes da semana.
Como se mede o sentimento de um texto
A técnica mais simples conta quantas palavras positivas e quantas negativas aparecem no documento, e resume as duas contagens em um número.
O numerador é o saldo entre os dois tipos de palavra. O denominador é o total de palavras que carregam sentimento, e dividir por ele deixa a medida entre −1 e 1.
Essa divisão é o que torna documentos de tamanhos diferentes comparáveis. Sem ela, uma ata longa teria saldo maior apenas por ser longa.
Um valor positivo indica predomínio de termos positivos, um valor negativo o contrário, e zero indica equilíbrio.
O que a contagem não enxerga
"O risco de recessão diminuiu" tem duas palavras negativas e nenhuma positiva. A polaridade dessa frase é −1, embora ela seja uma boa notícia.
Negação, ironia e construções condicionais passam despercebidas. É o preço de um método que roda em milhares de documentos por segundo, e a razão pela qual modelos de linguagem vêm sendo aplicados ao mesmo problema.
O dicionário decide o resultado
A conta acima depende de uma lista que diga quais palavras são positivas e quais são negativas. Essas listas se chamam dicionários de sentimento, ou léxicos, e são construídas por pesquisadores a partir de classificação manual.
| Dicionário | Como classifica | Para que serve |
|---|---|---|
| Loughran-McDonald | 7 categorias, entre elas positivo, negativo, incerteza e litigioso | Textos financeiros e relatórios corporativos |
| Bing | Binária, positivo ou negativo | Uso geral, avaliações e redes sociais |
| AFINN | Nota de −5 a 5 para cada palavra | Quando a intensidade importa, não só o sinal |
A escolha não é indiferente, e o exemplo clássico é a palavra "liability". Em um dicionário de uso geral ela aparece como negativa, mas num balanço contábil significa apenas "passivo", um termo neutro.
Loughran e McDonald construíram o dicionário deles em 2011 justamente ao notar que léxicos genéricos erravam de forma sistemática em textos financeiros. Para atas de banco central, é a escolha natural.
O método, etapa por etapa
| Etapa | O que se faz | O que acontece sem ela |
|---|---|---|
| Coletar | Baixar os PDFs pela API do Banco Central | Não há texto sobre o que operar |
| Extrair | Converter cada PDF em texto corrido | O PDF guarda posição de caractere, não palavras |
| Tokenizar | Separar em palavras e reduzir ao radical | "increased" não encontra a entrada "increas" do dicionário |
| Classificar | Cruzar os tokens com o dicionário | As palavras não têm sinal atribuído |
| Calcular | Aplicar a fórmula da polaridade | Restam duas contagens, sem medida comparável |
A terceira etapa merece atenção. O dicionário guarda os termos reduzidos ao radical, então "increased", "increasing" e "increases" precisam virar "increas" antes da comparação. É o stemming do pré-processamento de dados textuais, aplicado aqui com uma finalidade específica.
No exercício, a coleta usa a API pública do Banco Central, a extração usa a biblioteca pypdf e a classificação vem da pysentiment2, que traz o Loughran-McDonald pronto. Usamos a versão em inglês das atas porque é o idioma do dicionário.
O que o indicador mostra
Aplicado às cem atas mais recentes, de 2014 a 2026, o indicador tem média de −0,12. Três de cada quatro atas ficam abaixo de zero.
Isso não significa pessimismo permanente. O vocabulário de banco central é feito de "risco", "incerteza", "pressão" e "deterioração", palavras que o dicionário classifica como negativas por construção.
Por isso o nível do indicador não é comparável ao de um texto de outro gênero. O que se acompanha é a variação entre reuniões.
E há uma quebra clara em meados de 2016: a média era 0,18 antes, passou a −0,20 depois. A mudança coincide com a troca de diretoria do Banco Central e com a adoção de uma linguagem mais técnica nas atas.
O indicador antecipa a decisão de juros?
Essa é a pergunta que daria utilidade prática ao exercício. A resposta, no período analisado, é não.
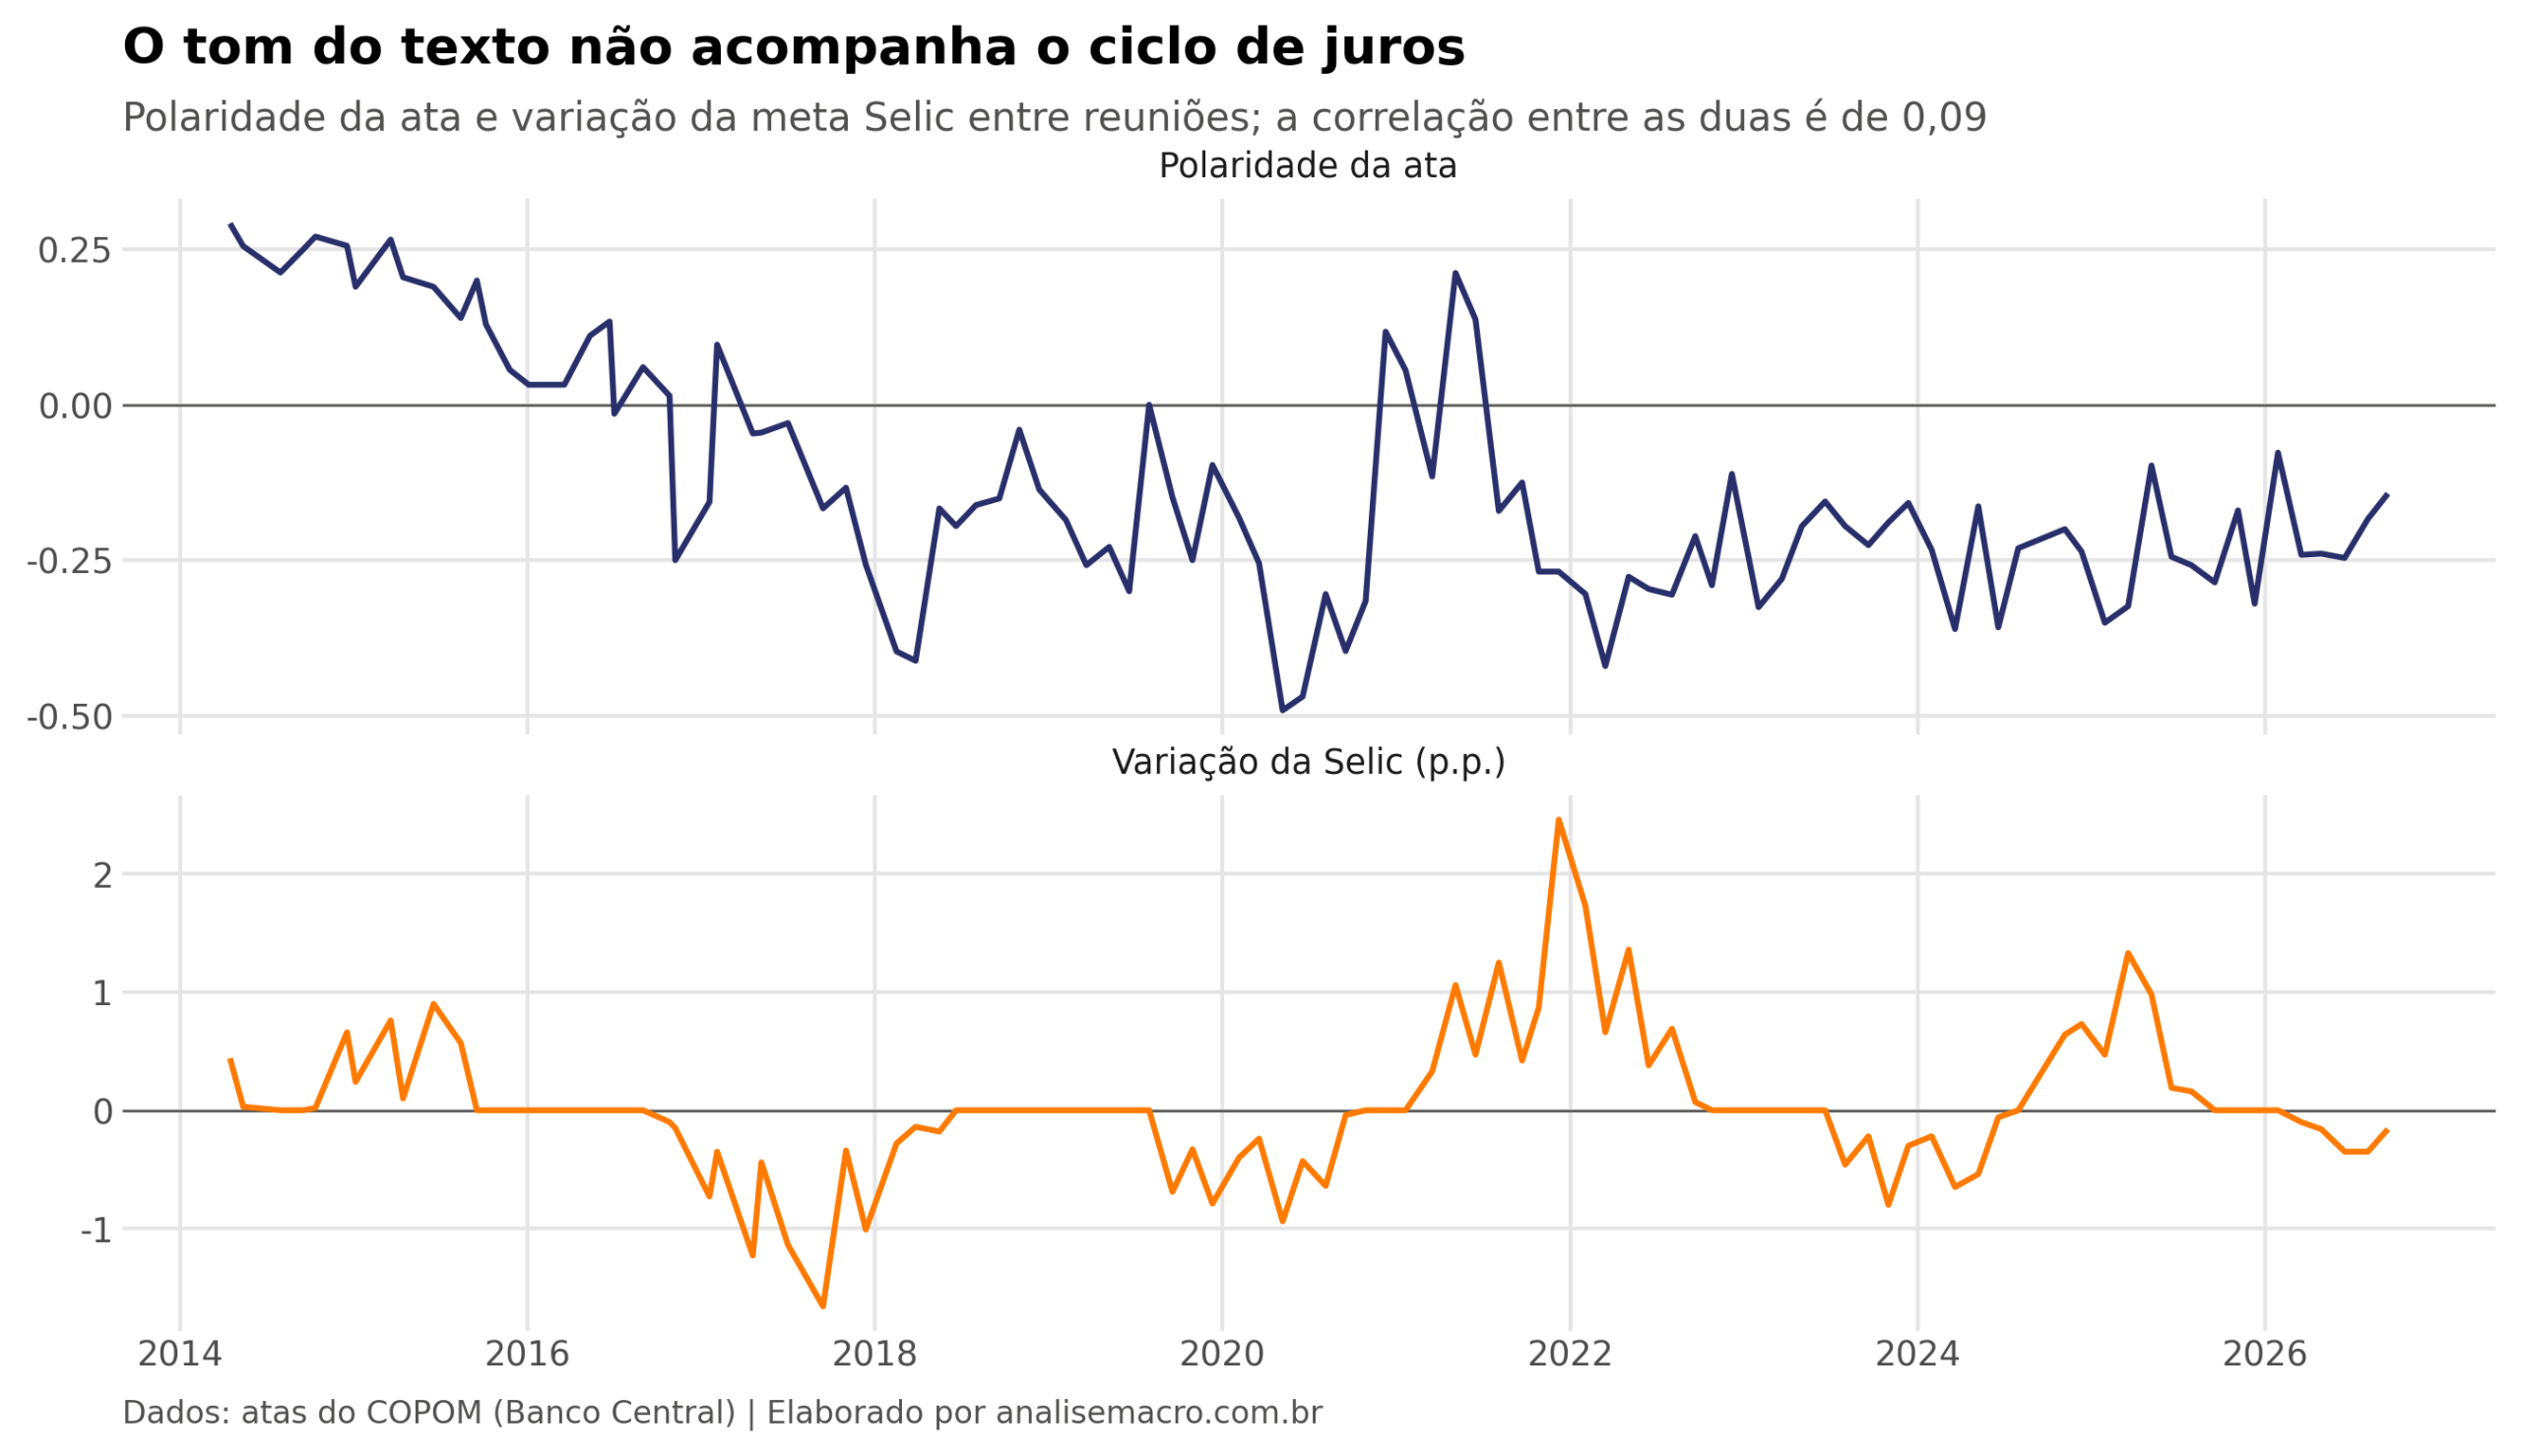
A correlação entre a polaridade da ata e a variação da meta Selic é de 0,09, praticamente nula.
O resultado tem explicação econômica. A decisão de juros responde a projeções de inflação e ao hiato do produto, não ao vocabulário do documento que a acompanha.
Uma ata pode descrever um cenário adverso e anunciar corte de juros, porque é o cenário adverso que pede estímulo. Tom e direção da política não precisam andar juntos.
Um indicador que não prevê ainda pode ser útil
A polaridade não antecipa a Selic, mas registra como o Comitê descreveu cada momento. A série funciona como termômetro da percepção de risco, que é informação distinta da decisão tomada.
Medidas construídas especificamente para política monetária, que separam termos hawkish de dovish em vez de positivo e negativo, costumam ter desempenho melhor nesse tipo de comparação.
Onde a análise de sentimentos é usada
- Comunicação de bancos centrais. Medir o tom de atas e comunicados ao longo do tempo é linha de pesquisa estabelecida, e alimenta indicadores de orientação de política monetária.
- Notícias e mercado. Classificar o fluxo de notícias sobre um ativo produz uma série que pode entrar como variável explicativa em modelos de preço ou volatilidade.
- Avaliações de clientes. O uso que originou a área: resumir milhares de comentários em uma medida acompanhável, sem leitura manual.
- Relatórios corporativos. O tom das seções narrativas de um balanço carrega informação que os números sozinhos não trazem, e foi para isso que o Loughran-McDonald foi criado.
O primeiro caso é o mais próximo da análise macroeconômica brasileira, e conecta-se à relação entre os comunicados do COPOM e as variáveis macro.
Considerações finais
A análise de sentimentos transforma texto em número ao contar palavras positivas e negativas segundo um dicionário, e esse número pode ser acompanhado ao longo do tempo.
O resultado depende inteiramente do dicionário escolhido. Para textos financeiros, o Loughran-McDonald evita os erros que um léxico genérico cometeria com termos como "liability" ou "exposure".
Aplicado às atas do COPOM, o indicador reproduziu a cronologia econômica do período. Já a relação com a direção dos juros é praticamente inexistente, com correlação de 0,09.
A contagem de palavras é o ponto de partida da área, não o estado da arte. Ela ignora negação, contexto e ironia, limitações que motivaram o uso de modelos de linguagem no mesmo problema.
Dominar esse ferramental muda o trabalho de quem acompanha comunicação institucional:
- Economista — constrói uma série de tom da comunicação oficial e a usa como variável de acompanhamento.
- Analista de research — resume o fluxo de notícias sobre um setor em uma medida comparável entre períodos.
- Cientista de dados — monta a etapa de classificação textual que alimenta modelos quantitativos.
- Gestor — identifica mudança de linguagem em relatórios e comunicados antes que ela apareça nos números.
Linguagem Econômica: mineração de textos de Bancos Centrais
Os dez capítulos do livro digital percorrem o caminho completo: dos primeiros tratamentos de texto ao indicador de sentimentos do COPOM e à classificação do tom da política monetária com IA generativa. Exercícios aplicados, em Python.
Quer acesso a todos os cursos da Análise Macro? Conheça o AM Black, a assinatura anual.
Leia também
- Técnicas de extração de informação com text mining — TF-IDF e Lei de Zipf, as medidas que pesam termos dentro de um documento.
- Técnicas de machine learning para mineração de textos — classificação de texto quando não há dicionário pronto para o problema.
Referências
LOUGHRAN, Tim; McDONALD, Bill. When is a liability not a liability? Textual analysis, dictionaries, and 10-Ks. The Journal of Finance, v. 66, n. 1, p. 35-65, 2011.
HU, Minqing; LIU, Bing. Mining and summarizing customer reviews. In: Proceedings of the tenth ACM SIGKDD international conference on Knowledge discovery and data mining, p. 168-177, 2004.
SILGE, Julia; ROBINSON, David. Text Mining with R: a tidy approach. Sebastopol: O'Reilly Media, 2017.
📩 Análise de dados aplicada, todo dia
Este exercício é um recorte. No Boletim AM eu mostro o trabalho com dado do jeito que ele acontece — coletar, limpar, rodar o modelo e ler o resultado, em R, Python e agora com IA no meio do caminho.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.