O que é e como aplicar análise de sentimentos no Python?
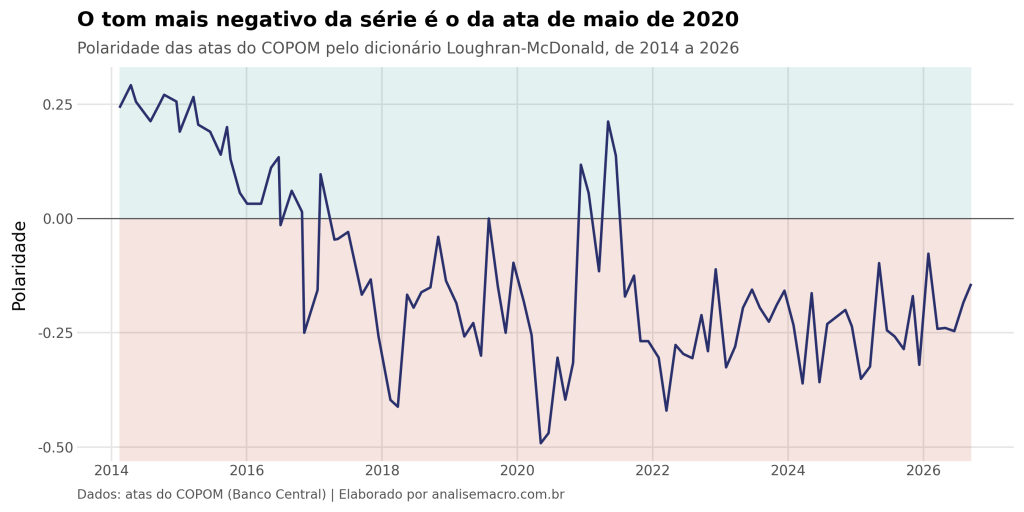
A análise de sentimentos conta palavras positivas e negativas segundo um dicionário e resume o tom de um documento em um número. Este artigo explica como a medida é construída, por que o dicionário escolhido decide o resultado, e aplica o método a cem atas do COPOM. O indicador reproduz a cronologia econômica do período, mas sua correlação com a direção dos juros é de apenas 0,09.
Técnicas de machine learning para mineração de textos
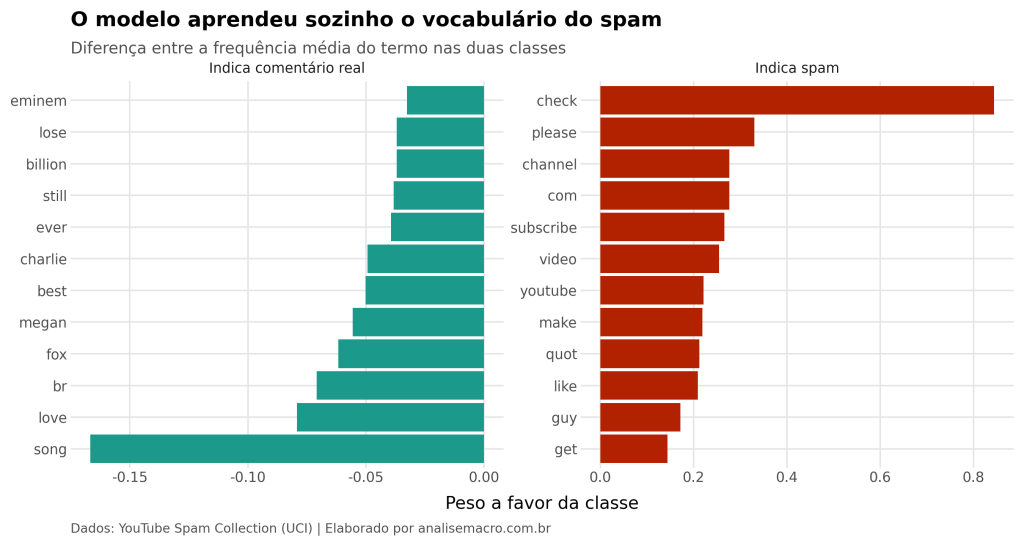
O Naive Bayes conta quantas vezes cada palavra aparece em mensagens de cada tipo e usa essas contagens para classificar um texto novo. Este artigo apresenta a probabilidade que sustenta o método, a suposição de independência que lhe dá o nome e o estimador de Laplace, e aplica tudo à separação entre spam e comentário legítimo em 448 comentários do YouTube.
Técnicas de extração de informação com text mining
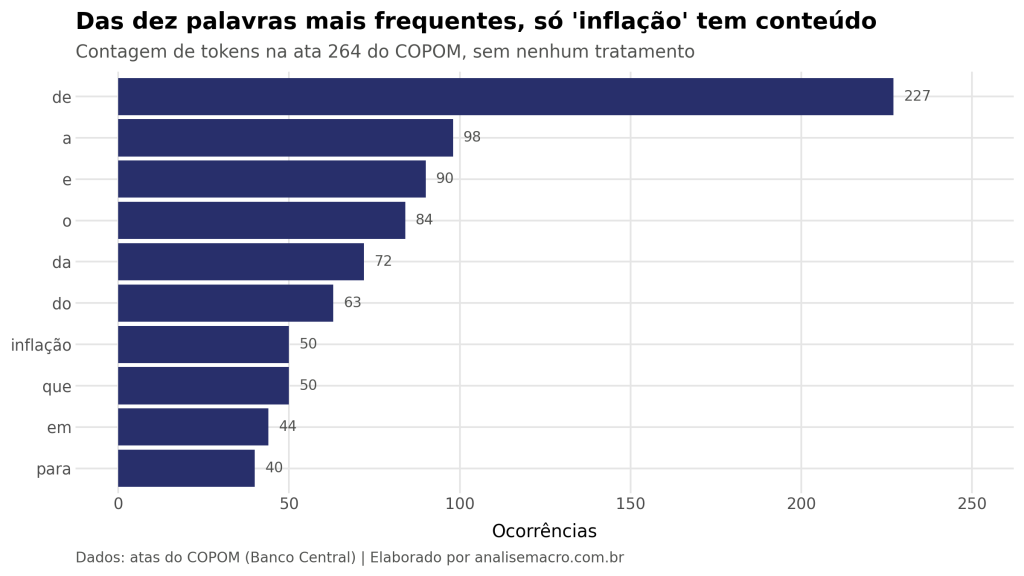
Contar palavras é o modo mais direto de descobrir sobre o que um documento trata, e também o mais decepcionante: as mais frequentes são sempre "de", "a" e "que". Este artigo apresenta as três medidas que resolvem esse problema — a frequência dos termos, a Lei de Zipf e o TF-IDF — e mostra o que elas revelam quando aplicadas a duas reuniões seguidas do COPOM.
Introdução a pré-processamento de dados textuais para mineração de textos
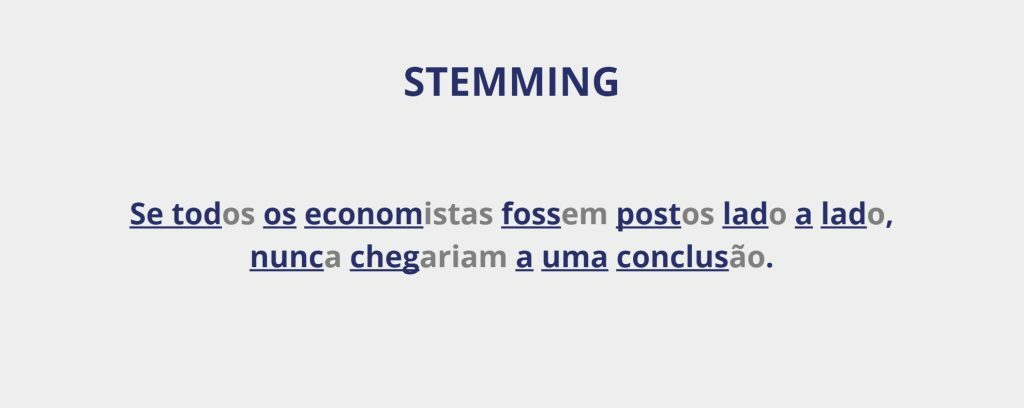
Antes de qualquer análise, o texto precisa virar dado. Este artigo apresenta as etapas que fazem essa transformação — tokenização, remoção de stop words, stemming e lemmatizing —, explica o que cada uma resolve e em que ordem se encadeiam. No exercício aplicado a uma ata do COPOM, 42% das palavras são descartadas antes que a análise comece.
Introdução a dados textuais no Python
Manejar dados textuais é diferente de manejar uma tabela com números. Este artigo apresenta as ferramentas do Python que resolvem essa etapa: as operações básicas sobre strings — contar, combinar, recortar e padronizar — e as expressões regulares, que descrevem padrões sem depender da posição exata da informação no documento.