Já exploramos as capacidades da mineração de textos e vimos que existem muitos dados para serem analisados por aí. Agora surge a pergunta seguinte: como começar? De tokens até stop words, passando por procedimentos de stemming e lemmatizing, neste artigo introduzimos as principais técnicas de preparação de dados textuais para a análise.
Como na maioria das aplicações de ciência de dados, o caminho entre o problema e a solução não costuma ser direto, rápido ou fácil. Na mineração de textos não é diferente: precisamos tornar os nossos dados "analisáveis", e isso nos leva aos procedimentos de pré-processamento, que são vários.
No exercício que acompanha este artigo, aplicamos todas essas etapas ao texto de uma ata do COPOM. O documento começa com 2.756 palavras e termina com 1.607 depois da limpeza, ou seja, 42% do texto é descartado antes que a análise comece.
📬 Estatística, econometria e IA aplicada. Todo dia, no seu e-mail.
O Boletim AM traz modelos estatísticos, econometria e LLMs aplicados a Economia, Finanças e análise de dados, com exemplos em R e Python. Todo domingo, às 20h, uma leitura mais longa que reúne as fontes da semana.
O que é pré-processamento de dados textuais?
O pré-processamento de dados na mineração de textos são rotinas de tratamento cujo objetivo é transformar os dados brutos, sejam textos ou arquivos, em uma representação analítica, ou seja, em um formato vetorial ou tabular.
A razão é que nenhum método estatístico opera sobre um parágrafo. Contar, comparar ou classificar exige que o texto esteja quebrado em unidades comparáveis entre si, e é esse o trabalho das etapas a seguir.
Esses pré-processamentos costumam envolver a tokenização do texto, a remoção de stop words, de números e de pontuações, além da stemização e da lematização. Todos são feitos via linguagem de programação, o que possibilita a automatização e a escalabilidade do processo.
O que é tokenização?
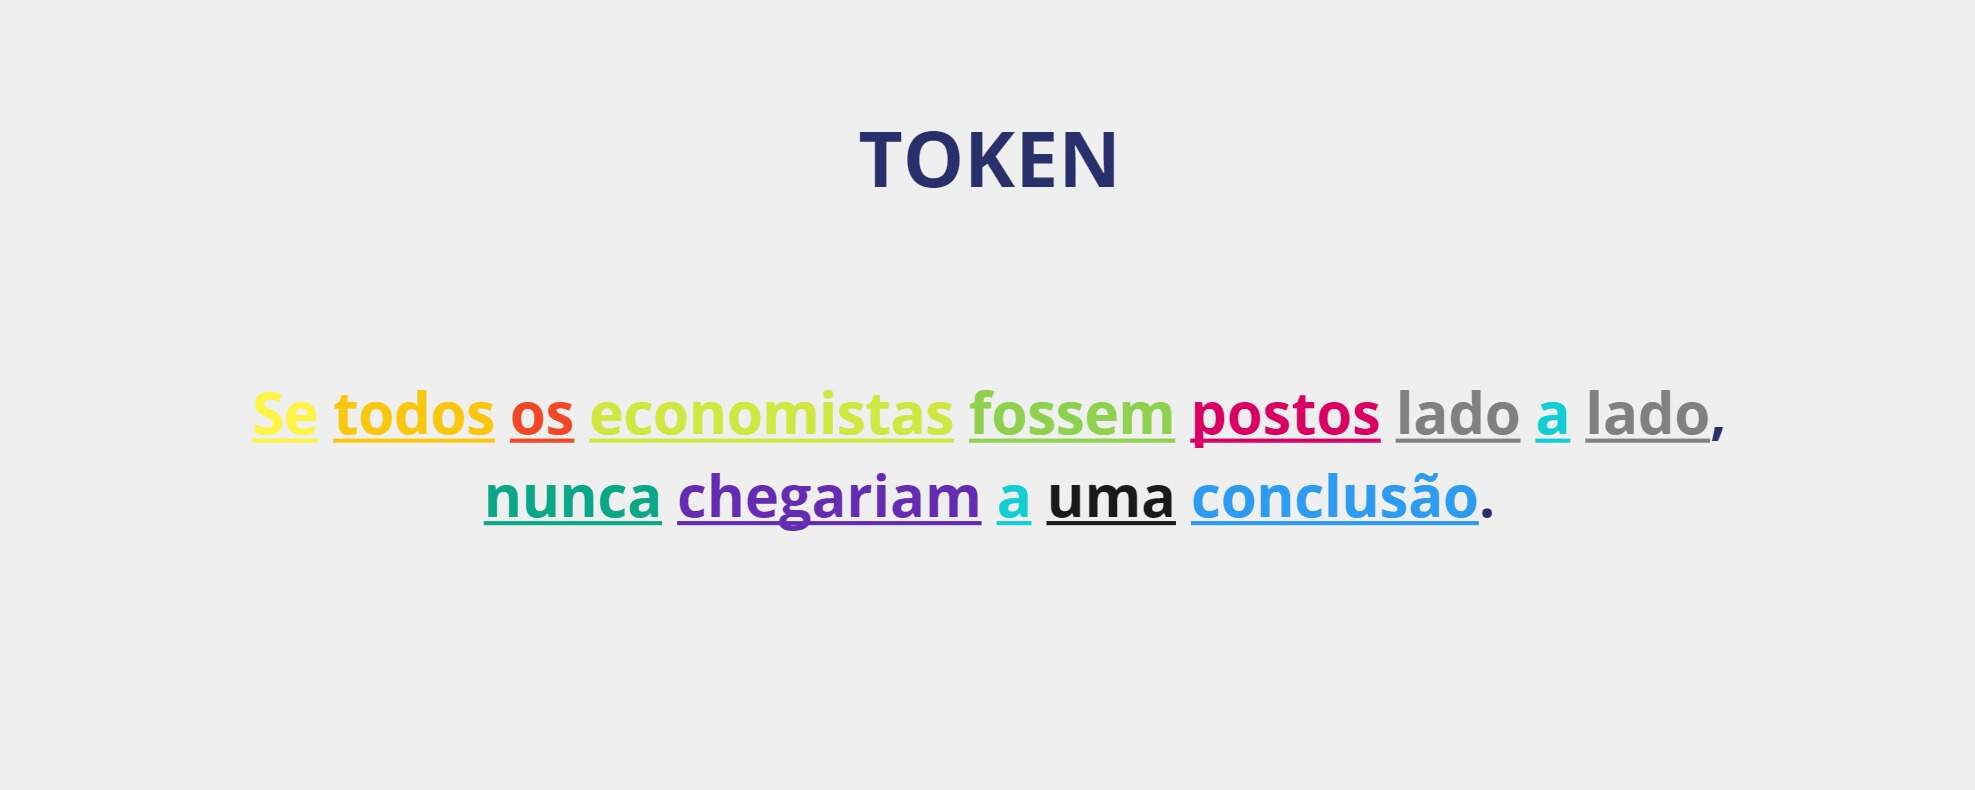
"Tokenizar" significa separar um texto de modo a obter unidades para análise posterior, ou seja, os tokens. Um token geralmente é uma palavra, mas pode ser um conjunto de palavras, uma sentença ou um parágrafo.
Esse processo facilita a análise dos dados quando o objetivo é contar, filtrar, categorizar ou agrupar os tokens. É a primeira etapa porque todas as demais operam sobre a lista resultante, e não mais sobre o texto corrido.
O que são stop words?
As chamadas stop words são palavras consideradas irrelevantes para a análise dos dados textuais, por não carregarem emoção nem valor semântico, ou por não alterarem o sentido do texto ao serem removidas.
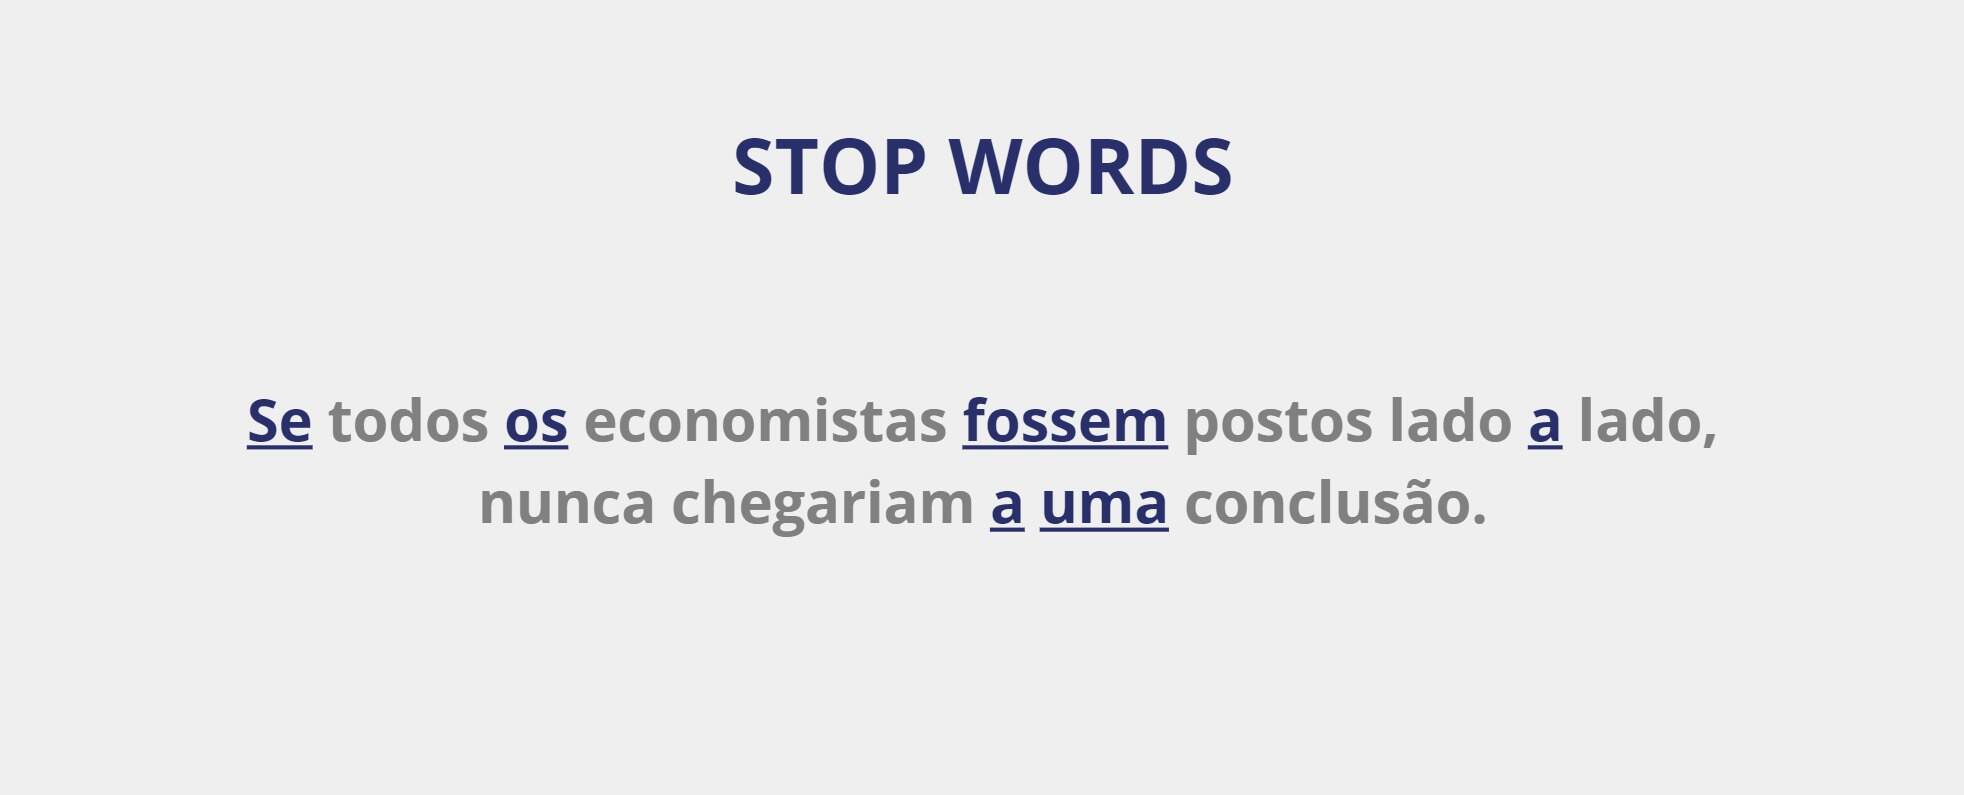
Geralmente são definidas em uma lista de stop words as classes de palavras auxiliares: conjunções, preposições, pronomes, artigos e advérbios. Outros caracteres também costumam ser removidos, como números, pontuações e caracteres especiais.
A remoção descarta uma parcela grande do documento, e é isso que se espera. Na ata do COPOM usada como exemplo, 42% dos tokens saem nessa etapa, justamente por serem as palavras que aparecem em qualquer texto e não distinguem uma ata de outra.
O que é stemming?
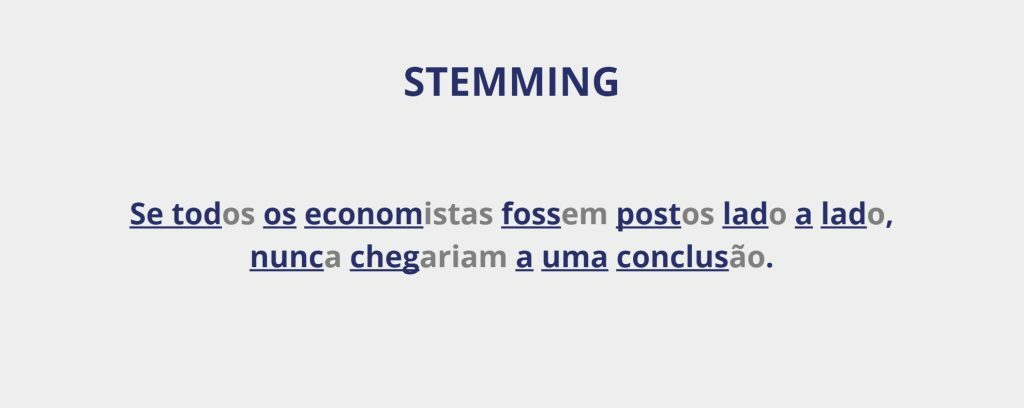
Stemming, ou normalização morfológica, é o processo de eliminar variações morfológicas de uma palavra, visando reduzi-la ao seu radical. Assim, eliminam-se os prefixos e sufixos, além de outras variações que podem estar presentes, como de gênero, número e grau.
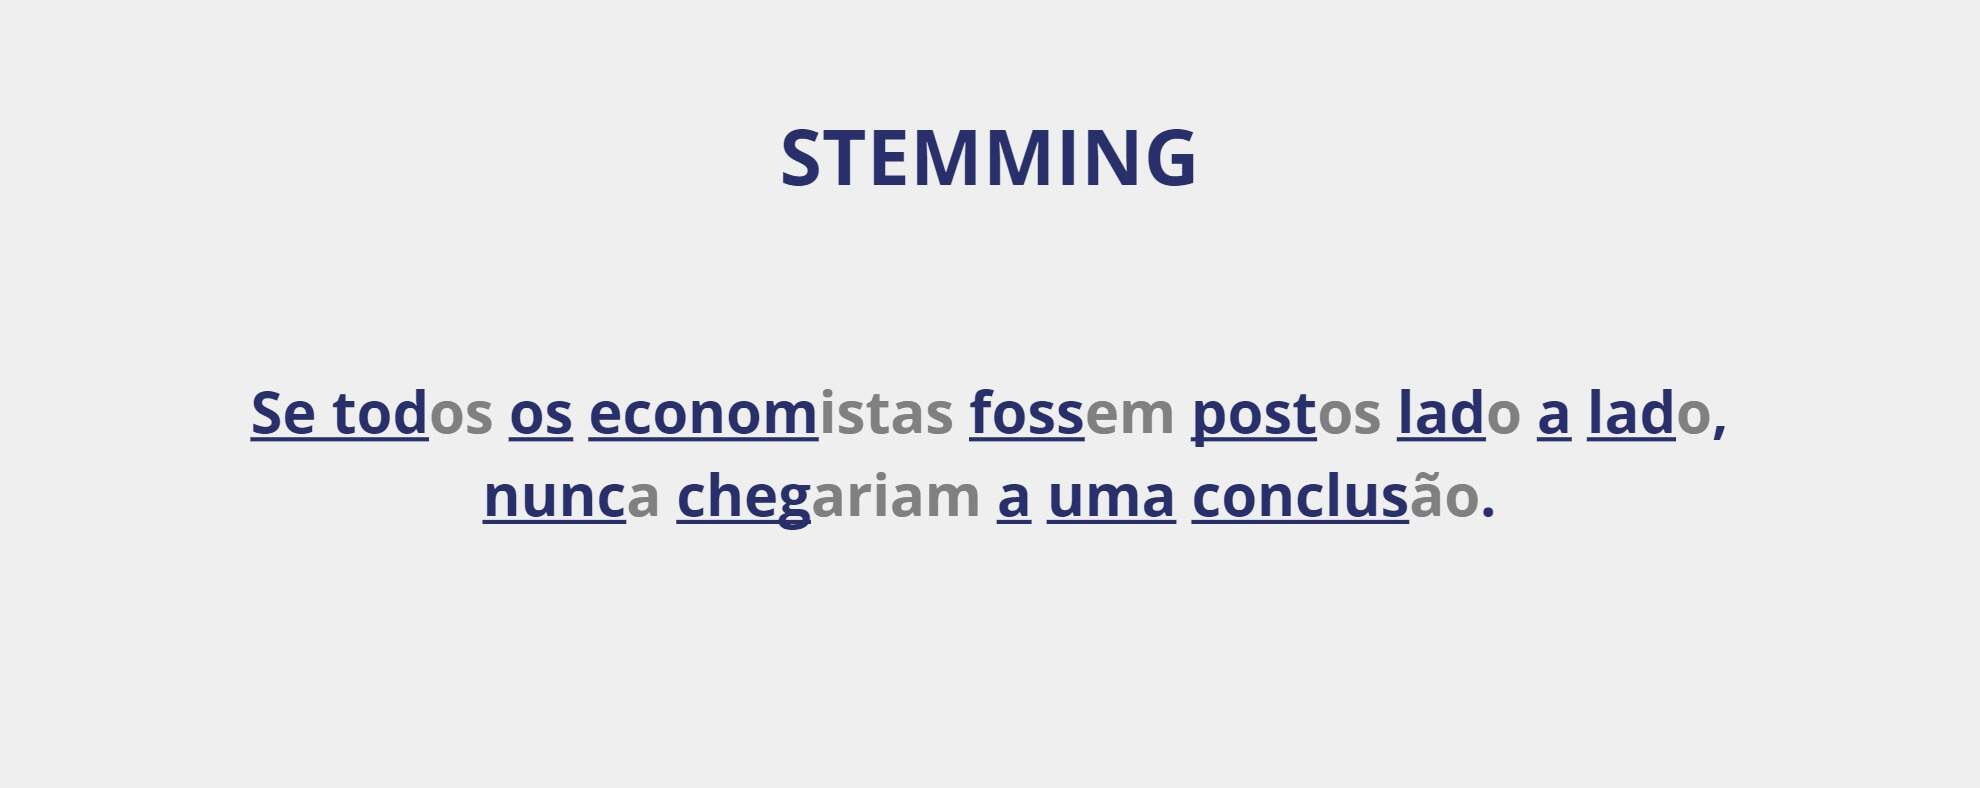
O problema que ele resolve é a contagem dividida. Sem essa etapa, "analisamos", "analisaram" e "análise" entram como três termos distintos em qualquer medida de frequência, ainda que tratem do mesmo conceito.
O que é lemmatizing?
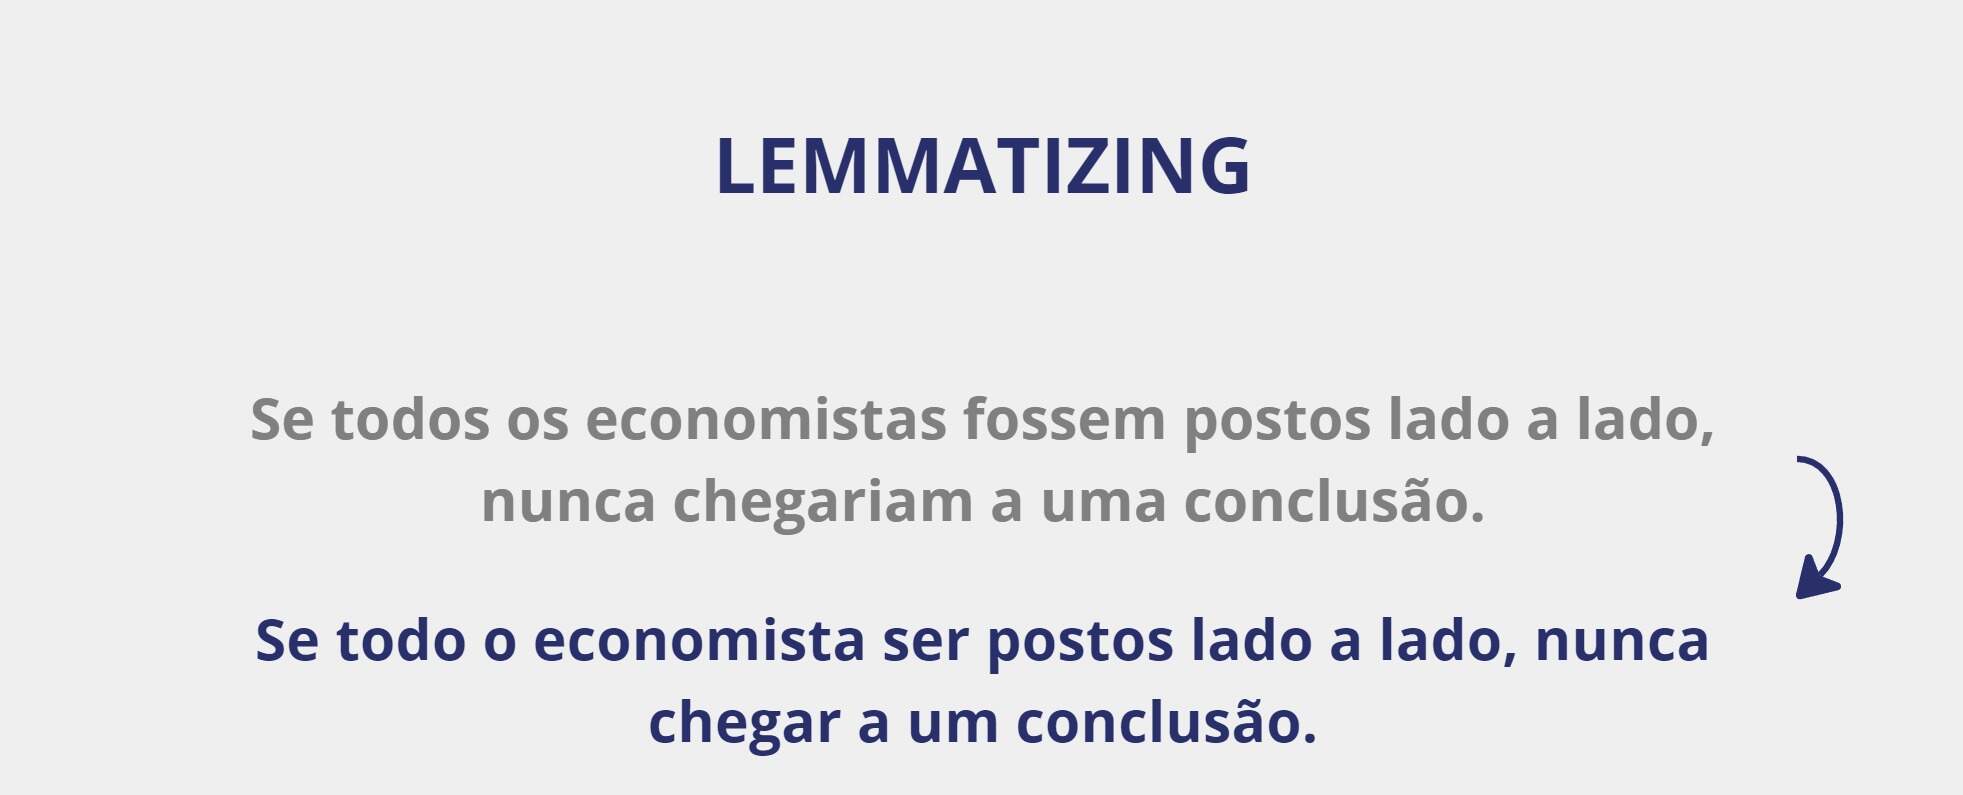
Lemmatizing é o processo de transformar um token no lema correspondente da palavra, ou seja, na forma em que as variações dessa palavra são escritas no dicionário. O resultado do procedimento é um token que existe na gramática.
Stemming ou lemmatizing?
Os dois resolvem o mesmo problema por caminhos diferentes, e a escolha depende do que será feito com o resultado.
| Critério | Stemming | Lemmatizing |
|---|---|---|
| Como funciona | Corta prefixos e sufixos por regras fixas | Consulta a gramática e o vocabulário da língua |
| Resultado | Um radical, que pode não existir no dicionário | Uma palavra real da língua |
| Exemplo | "econômica" vira "econôm" | "econômica" vira "econômico" |
| Velocidade | Rápido, não carrega modelo | Mais lento, exige um modelo de língua |
| Quando usar | Agrupar variações para contagem | Quando o resultado será lido ou interpretado |
O stemming é mais agressivo e mais rápido, o que serve quando o objetivo é apenas agrupar variações para uma contagem de frequência. O lemmatizing preserva palavras legíveis, o que importa quando o resultado será lido por uma pessoa ou usado em uma análise de significado.
A ordem das etapas
As etapas se encadeiam, e cada uma trabalha sobre o resultado da anterior.
🧹
✂️
🚫
🌱
A limpeza vem primeiro porque a pontuação atrapalha a separação em palavras. A filtragem vem depois da tokenização porque as stop words são comparadas token a token contra uma lista. E a normalização vem por último porque opera sobre menos palavras, já sem as que seriam descartadas de qualquer forma.
As ferramentas vêm prontas. As bibliotecas de processamento de linguagem natural do Python trazem as listas de stop words por idioma e os algoritmos de radicalização, inclusive um desenvolvido especificamente para o português. Para o lemmatizing, é preciso carregar um modelo da língua, que traz o vocabulário e as regras gramaticais.
Considerações finais
De tokens até stop words, passando por procedimentos de stemming e lemmatizing, entre outros, neste artigo introduzimos as principais técnicas e conceitos de mineração de textos, preparando os dados para a análise.
Cada escolha dessas altera o que a análise vai encontrar. Uma lista de stop words que inclua "não" apaga as negações do documento, e um stemming agressivo demais junta palavras de sentidos distintos sob o mesmo radical. O texto tratado é que vai alimentar as técnicas de extração de informação e, adiante, a análise de sentimentos.
O percurso muda pouco de uma área para outra, e o que varia é a aplicação:
- Economista: prepara atas e comunicados para medir a frequência de termos e comparar documentos ao longo do tempo.
- Analista de investimentos: trata cartas de gestores e relatórios antes de extrair os temas recorrentes de cada período.
- Cientista de dados: monta a etapa de limpeza que antecede qualquer modelo de classificação ou agrupamento de textos.
- Pesquisador: normaliza acervos grandes para que variações de grafia não fragmentem a contagem de um mesmo conceito.
Aprender a linguagem é o que abre a porta para todas essas frentes.
Linguagem Econômica: mineração de textos de Bancos Centrais
Os dez capítulos do livro digital percorrem o caminho completo: dos primeiros tratamentos de texto ao indicador de sentimentos do COPOM e à classificação do tom da política monetária com IA generativa. Exercícios aplicados, em Python.
Leia também: