Quando um meteorologista diz que "há 70% de chance de chover hoje", ele está afirmando que, em 7 de cada 10 dias anteriores com condições parecidas, choveu. A previsão não vem de uma certeza sobre o futuro, mas da contagem de casos passados.
O algoritmo Naive Bayes aplica esse mesmo raciocínio à classificação de textos. Ele conta quantas vezes cada palavra apareceu em mensagens de cada tipo e usa essas contagens para decidir a que tipo pertence uma mensagem nova.
Neste tutorial explicamos a probabilidade que sustenta o método, a suposição que lhe dá o nome e o estimador de Laplace que corrige uma falha prática dele. No fim, aplicamos tudo a um problema real: separar spam de comentário legítimo no YouTube.
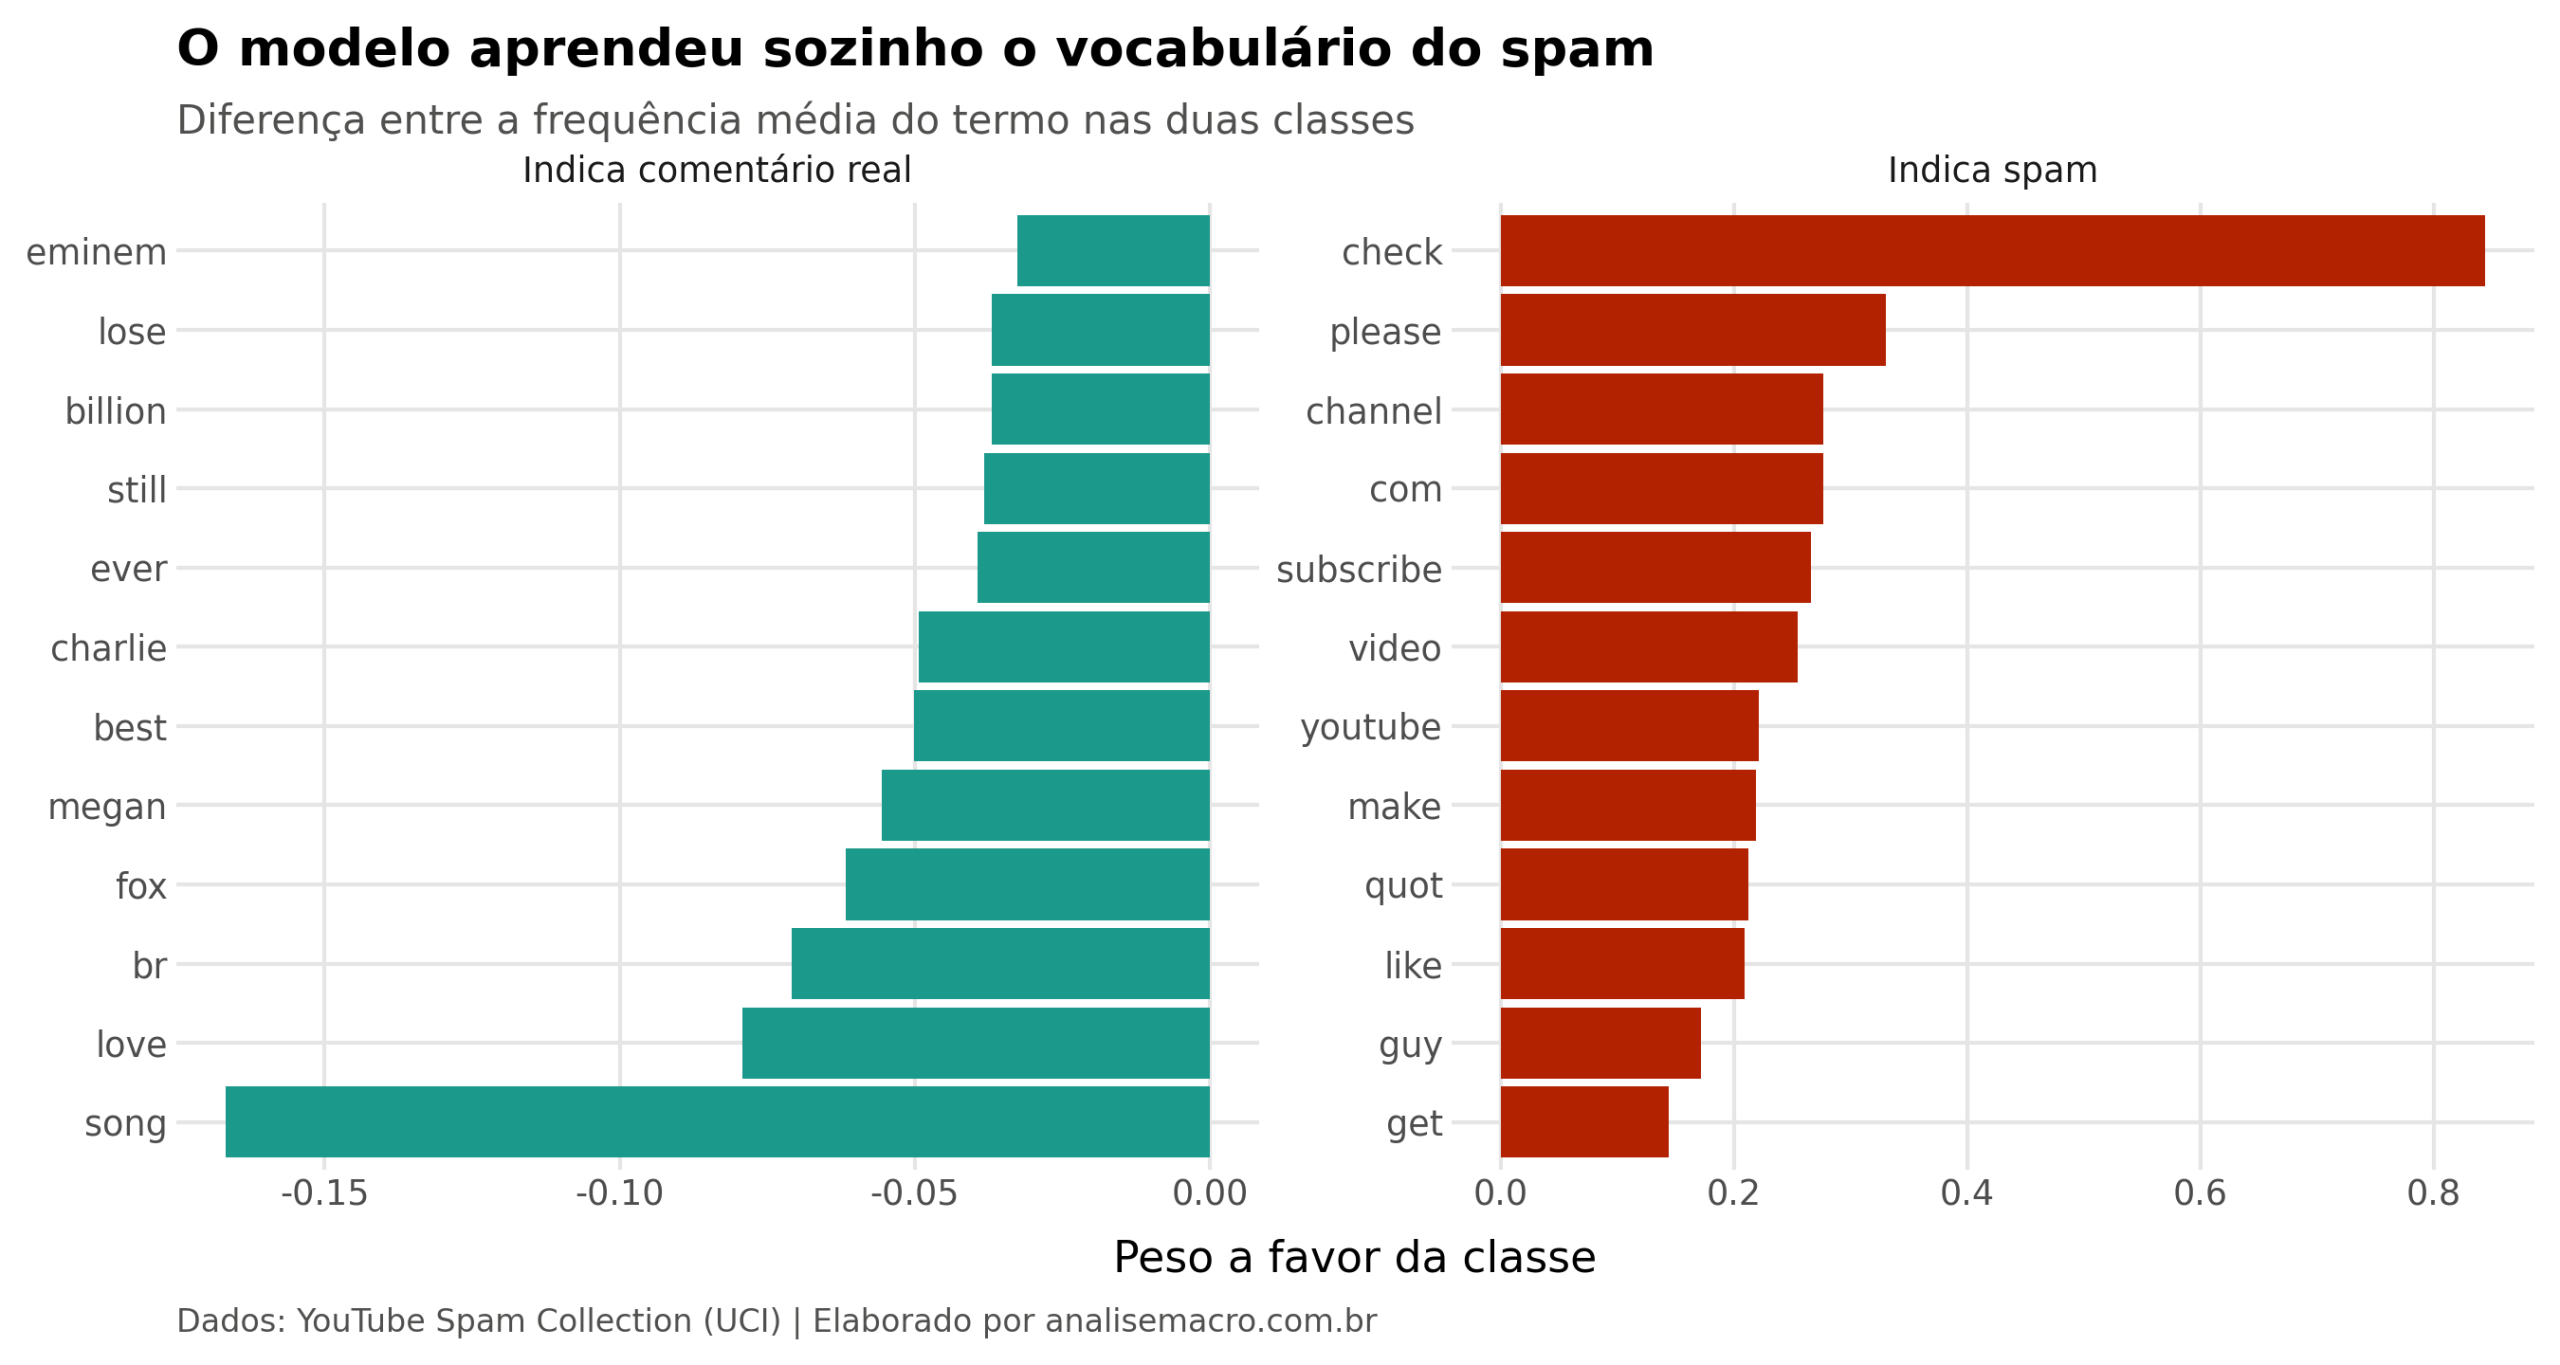
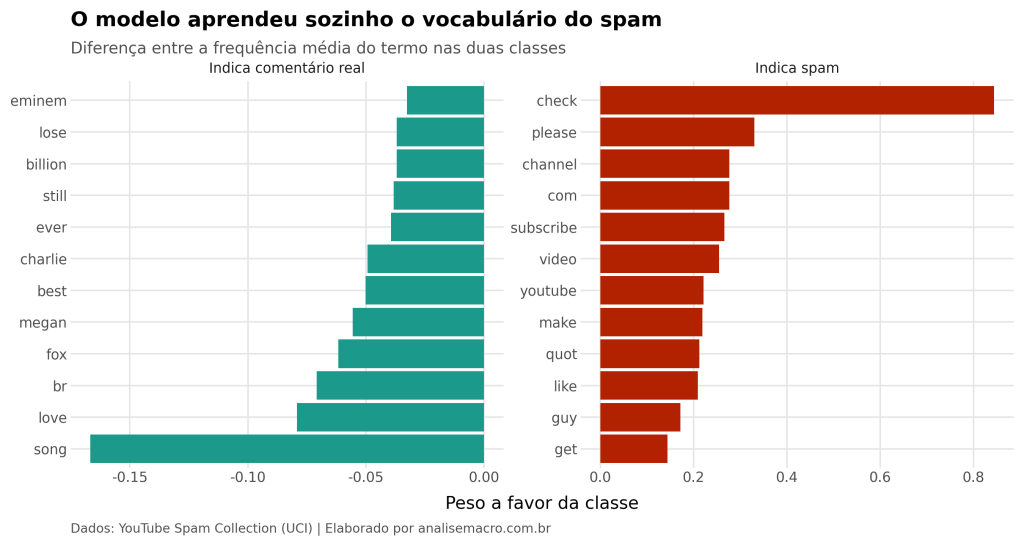
De um lado, "check", "subscribe" e "channel", o vocabulário de quem divulga o próprio canal. Do outro, "song", "love" e os nomes dos atores do clipe.
A separação entre as duas classes estava nas palavras, e o algoritmo só precisou contá-las.
📬 Estatística, econometria e IA aplicada. Todo dia, no seu e-mail.
O Boletim AM traz modelos estatísticos, econometria e LLMs aplicados a Economia, Finanças e análise de dados, com exemplos em R e Python. Todo domingo, às 20h, uma leitura mais longa que reúne as fontes da semana.
A probabilidade por trás do método
Probabilidade é um número entre 0 e 1 que mede a chance de um evento ocorrer. Estimamos essa chance dividindo o número de vezes em que o evento ocorreu pelo total de tentativas.
Se 10 de 50 e-mails recebidos eram spam, a probabilidade de uma mensagem ser spam é de 20%. Como os dois casos são mutuamente exclusivos, a probabilidade de não ser spam sai por subtração: 80%.
O caso que interessa a um classificador é outro: quando um evento carrega informação sobre o outro.
Suponha que 20% das mensagens sejam spam e que a palavra "Viagra" apareça em 5% delas. Se os dois eventos fossem independentes, a probabilidade de uma mensagem ser spam e conter a palavra seria o produto simples, 0,20 × 0,05 = 0,01.
Mas eles não são independentes. A presença de "Viagra" é indício de spam, assim como a presença de nuvens é indício de chuva. São os eventos dependentes que sustentam qualquer modelo preditivo: se tudo fosse independente, observar uma variável não ajudaria a prever outra.
O Teorema de Bayes
A relação entre eventos dependentes é descrita pelo Teorema de Bayes.
A notação P(A|B) lê-se "a probabilidade de A ocorrer, dado que B ocorreu", e se chama probabilidade condicional.
Aplicado ao filtro de spam, cada parte da fórmula ganha um nome:
A probabilidade a priori, P(spam), é o que sabemos antes de ler a mensagem: 20% delas são spam. A verossimilhança, P(Viagra|spam), é a frequência do termo entre os spams já conhecidos. E a probabilidade a posteriori, P(spam|Viagra), é a estimativa revista depois de ver que a mensagem contém a palavra.
O cálculo com uma tabela de frequências
Para calcular cada parte, montamos uma tabela com a contagem de mensagens em cada situação. Suponha 100 mensagens, das quais 20 são spam, e que "Viagra" apareça em 5 delas.
| Contém "Viagra" | Não contém | Total | |
|---|---|---|---|
| Spam | 4 | 16 | 20 |
| Não spam | 1 | 79 | 80 |
| Total | 5 | 95 | 100 |
Das 20 mensagens de spam, 4 contêm "Viagra", o que dá uma verossimilhança de 4/20 = 0,20. Aplicando o teorema:
Uma mensagem que contém "Viagra" tem 80% de chance de ser spam, contra os 20% que atribuiríamos antes de ler qualquer palavra. A evidência quadruplicou a estimativa.
Por que o algoritmo se chama "naive"
Um filtro real não olha uma palavra só. Ele monitora dezenas ou centenas de termos ao mesmo tempo, e aí o cálculo exato fica impraticável: seria preciso guardar a probabilidade de cada combinação possível de presença e ausência de cada termo.
O Naive Bayes resolve isso com a suposição que lhe dá o nome, a de independência condicional entre as variáveis, dada a classe. Ou seja: dentro do grupo dos spams, a presença de "Viagra" não diria nada sobre a presença de "Money".
Com essa suposição, a probabilidade conjunta vira um produto simples das probabilidades individuais.
Aqui C é a classe (spam ou não spam), cada Fi é uma variável observada, e Z é a constante que converte os valores em probabilidades que somam 1.
A suposição é quase sempre falsa. Palavras se correlacionam, e em um e-mail o remetente importa mais que o texto. Ainda assim o método classifica bem, porque a distorção afeta as probabilidades estimadas, mas raramente inverte a ordem entre as classes — e é a ordem que decide a classificação.
Quando o Naive Bayes é uma boa escolha
A favor: é simples e rápido de treinar, lida bem com ruído e dados faltantes, funciona com poucos exemplos e entrega a probabilidade estimada junto da classe.
Contra: a suposição de independência raramente se sustenta, o método não vai bem com muitas variáveis numéricas contínuas, e as probabilidades que ele estima são menos confiáveis que as classes que ele prevê.
O estimador de Laplace
A multiplicação de probabilidades tem uma fragilidade. Se qualquer uma delas for zero, o produto inteiro zera, independentemente do que as outras variáveis indiquem.
Imagine um filtro que monitora quatro termos e recebe uma mensagem com todos eles. Se um desses termos nunca apareceu em nenhum spam do conjunto de treino, sua verossimilhança é 0/20. O produto zera, e a mensagem é classificada como legítima — mesmo contendo os outros três termos suspeitos.
O estimador de Laplace corrige isso somando um valor pequeno, em geral 1, a cada contagem da tabela de frequências.
Nenhuma frequência fica em zero, e nenhuma palavra isolada pode vetar as demais. No exemplo dos quatro termos, a mesma mensagem passa de 0% para 80% de chance de ser spam.
A diferença não está nos dados, e sim em não deixar que uma única contagem vazia decida sozinha. É por isso que a correção vem ligada por padrão na maioria das implementações.
O exercício: separando spam de comentário real
Aplicamos o método a comentários do vídeo "Eminem - Love The Way You Lie ft. Rihanna", publicado em 2010. Os dados vêm do YouTube Spam Collection, da UCI, com 448 comentários já rotulados: 245 spam e 203 legítimos.
A base estar quase equilibrada entre as duas classes evita um problema comum em classificação: quando 95% dos casos são de uma classe só, um modelo que chuta sempre essa classe acerta 95% das vezes sem ter aprendido nada.
Do texto à matriz de números
O modelo não lê texto, lê números. O caminho entre um e outro tem quatro etapas.
| Etapa | O que se faz | O que acontece sem ela |
|---|---|---|
| Limpar | Minúsculas, sem pontuação, números e stop words | "Check" e "check" contam como termos distintos |
| Lematizar | Reduzir cada palavra à forma do dicionário | "subscribe" e "subscribed" viram variáveis separadas |
| Vetorizar | Montar a matriz documento-termo | Não há número sobre o que o modelo opere |
| Filtrar | Manter só os termos com 5 ou mais ocorrências | Milhares de colunas quase vazias, uma por palavra rara |
A matriz documento-termo é o formato que torna texto analisável: cada linha é um comentário, cada coluna é uma palavra do vocabulário, e cada célula guarda quantas vezes aquela palavra aparece naquele comentário.
É a mesma estrutura que vimos no pré-processamento de dados textuais, agora servindo de entrada para um modelo.
A divisão entre treino e teste
Antes de estimar qualquer coisa, separamos 80% dos comentários para o modelo aprender e 20% para avaliá-lo. O modelo nunca vê essa segunda parte durante o treino.
Sem essa separação, a avaliação não mede nada: um modelo testado nos mesmos dados com que aprendeu tende a acertar muito, porque está reconhecendo exemplos que decorou, não generalizando para casos novos. Tratamos desse ponto em detalhe no artigo sobre como construir amostras de treino e teste.
Dois cuidados valem a pena aqui. O primeiro é manter a mesma proporção de spam nas duas partes, o que se faz com estratificação.
O segundo é decidir o corte de termos frequentes usando só o conjunto de treino. Calcular essa lista com a base inteira deixaria informação do teste vazar para dentro do modelo, e a avaliação sairia otimista.
O resultado
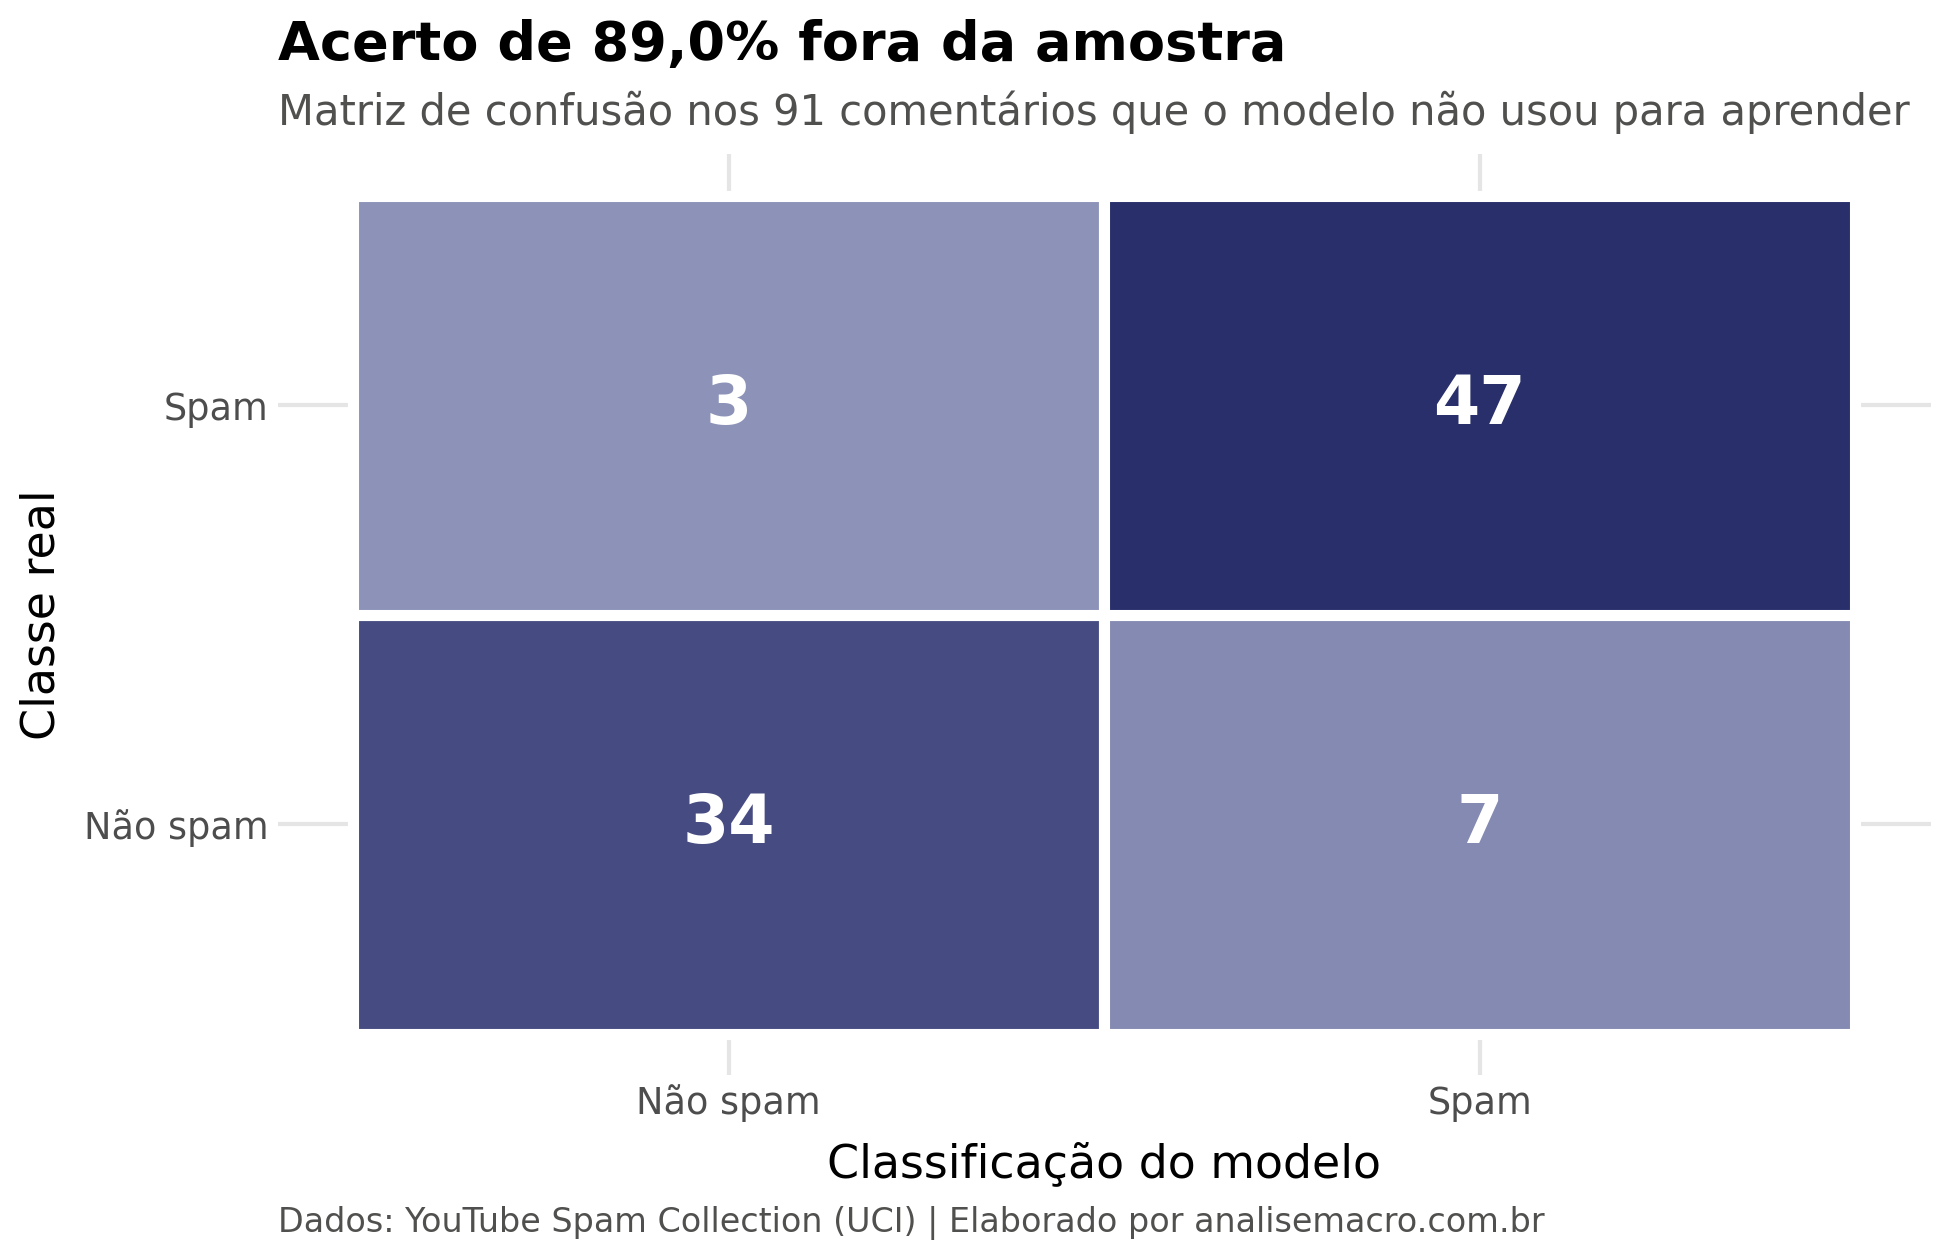
O modelo acertou 89,0% dos 91 comentários que nunca tinha visto. A matriz de confusão mostra onde ele errou: 7 comentários legítimos foram marcados como spam, e 3 spams passaram como legítimos.
Os dois erros não custam a mesma coisa. Marcar um comentário legítimo como spam o esconde do autor, que escreveu de boa-fé; deixar passar um spam é um incômodo menor. Um filtro em produção ajustaria o limiar de decisão conforme esse custo, em vez de usar os 50% padrão.
Há ainda o que a acurácia não diz. Com 55% de spam na amostra, um classificador que respondesse "spam" para tudo acertaria 55%. Os 89,0% precisam ser lidos contra esse piso, não contra zero.
O vocabulário que o modelo encontrou
O resultado mais ilustrativo não é a acurácia, mas o gráfico da abertura: os termos que o modelo associou a cada classe sem que ninguém o instruísse.
Do lado do spam estão "check", "subscribe", "channel" e "please". Do lado dos comentários legítimos, "song", "love", "eminem" e os nomes dos atores do clipe, "megan" e "fox".
É o mesmo padrão do exemplo teórico com "Viagra" e "Unsubscribe", só que aqui os termos não foram escolhidos por ninguém. Saíram da contagem.
Dois termos que não são palavras
Entre os indicativos de spam aparecem "quot" e "br", resíduos de " e <br> que sobreviveram à limpeza.
Eles de fato se concentram em uma das classes, então o modelo não está errado em usá-los. Mas o que ele capturou aí é um padrão de formatação, não de linguagem.
Remover entidades HTML antes da tokenização resolveria, e é o tipo de detalhe que só aparece quando se olha o que o modelo aprendeu.
Onde o Naive Bayes é usado
- Filtros de spam. O caso clássico, e ainda em uso como primeira camada de triagem por ser rápido o bastante para rodar sobre todo o fluxo de mensagens.
- Classificação de documentos por tema. Separar notícias, chamados de suporte ou processos por assunto, a partir do vocabulário de cada categoria.
- Análise de sentimento. Classificar textos como positivos ou negativos usando as palavras como evidência, que é o tema do próximo passo desta série.
- Linha de base em projetos de NLP. Antes de partir para um modelo pesado, o Naive Bayes dá em minutos um número contra o qual comparar. Se o modelo complexo não supera a contagem de palavras, algo está errado.
Esse último uso é o mais subestimado. Em economia e finanças, aplicar o método à comunicação dos bancos centrais dá uma referência barata antes de recorrer a modelos de linguagem.
Considerações finais
O Naive Bayes transforma contagem de palavras em classificação. Ele estima com que frequência cada termo aparece em cada classe e combina essas frequências pelo Teorema de Bayes para decidir a que classe pertence um texto novo.
A suposição de independência entre as palavras é falsa, e mesmo assim o método funciona, porque a distorção que ela causa raramente inverte a ordem entre as classes.
O estimador de Laplace resolve o problema de uma contagem zerada anular toda a evidência restante. É uma correção de uma linha que evita um erro grosseiro.
Um número de acurácia só significa alguma coisa quando medido em dados que o modelo não viu, e lido contra o piso que o acaso já garantiria.
Dominar esse ferramental muda o trabalho de quem lida com texto em volume:
- Cientista de dados — tem uma linha de base rápida para qualquer problema de classificação de texto, antes de investir em modelo complexo.
- Economista — classifica documentos de política econômica por tema ou tom sem depender de leitura manual.
- Analista de research — tria automaticamente o fluxo de notícias e relatórios que chega todo dia.
- Analista de risco — sinaliza documentos que mencionam temas sensíveis em um acervo grande demais para revisão humana.
Linguagem Econômica: mineração de textos de Bancos Centrais
Os dez capítulos do livro digital percorrem o caminho completo: dos primeiros tratamentos de texto ao indicador de sentimentos do COPOM e à classificação do tom da política monetária com IA generativa. Exercícios aplicados, em Python.
Quer acesso a todos os cursos da Análise Macro? Conheça o AM Black, a assinatura anual.
Leia também
- Técnicas de extração de informação com text mining — TF, Lei de Zipf e TF-IDF, as medidas que precedem a classificação.
- O que é e como aplicar análise de sentimentos no Python — a próxima aplicação de classificação de textos da série.
Referências
LANTZ, Brett. Machine Learning with R. Birmingham: Packt Publishing, 2013. Capítulo 4.
ALBERTO, Túlio C.; LOCHTER, Johannes V.; ALMEIDA, Tiago A. TubeSpam: comment spam filtering on YouTube. In: IEEE International Conference on Machine Learning and Applications (ICMLA), 2015.
📩 Modelo, dado e ressalva — todo dia
Este exercício é um recorte. No Boletim AM eu mostro econometria aplicada o ano inteiro, e como a IA entra nesse trabalho sem substituir o julgamento de quem entende o modelo.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.