Contar quantas vezes cada palavra aparece em um documento é o modo mais direto de descobrir sobre o que ele trata. E também o mais decepcionante: as palavras mais frequentes de qualquer texto em português são "de", "a", "e" e "que".
A extração de informação em mineração de textos resolve esse problema com três medidas encadeadas: a frequência dos termos, a Lei de Zipf, que descreve como essa frequência se distribui, e o TF-IDF, que ajusta a contagem pela raridade de cada termo.
Neste tutorial explicamos as três e mostramos o que elas revelam quando aplicadas a duas atas seguidas do COPOM.
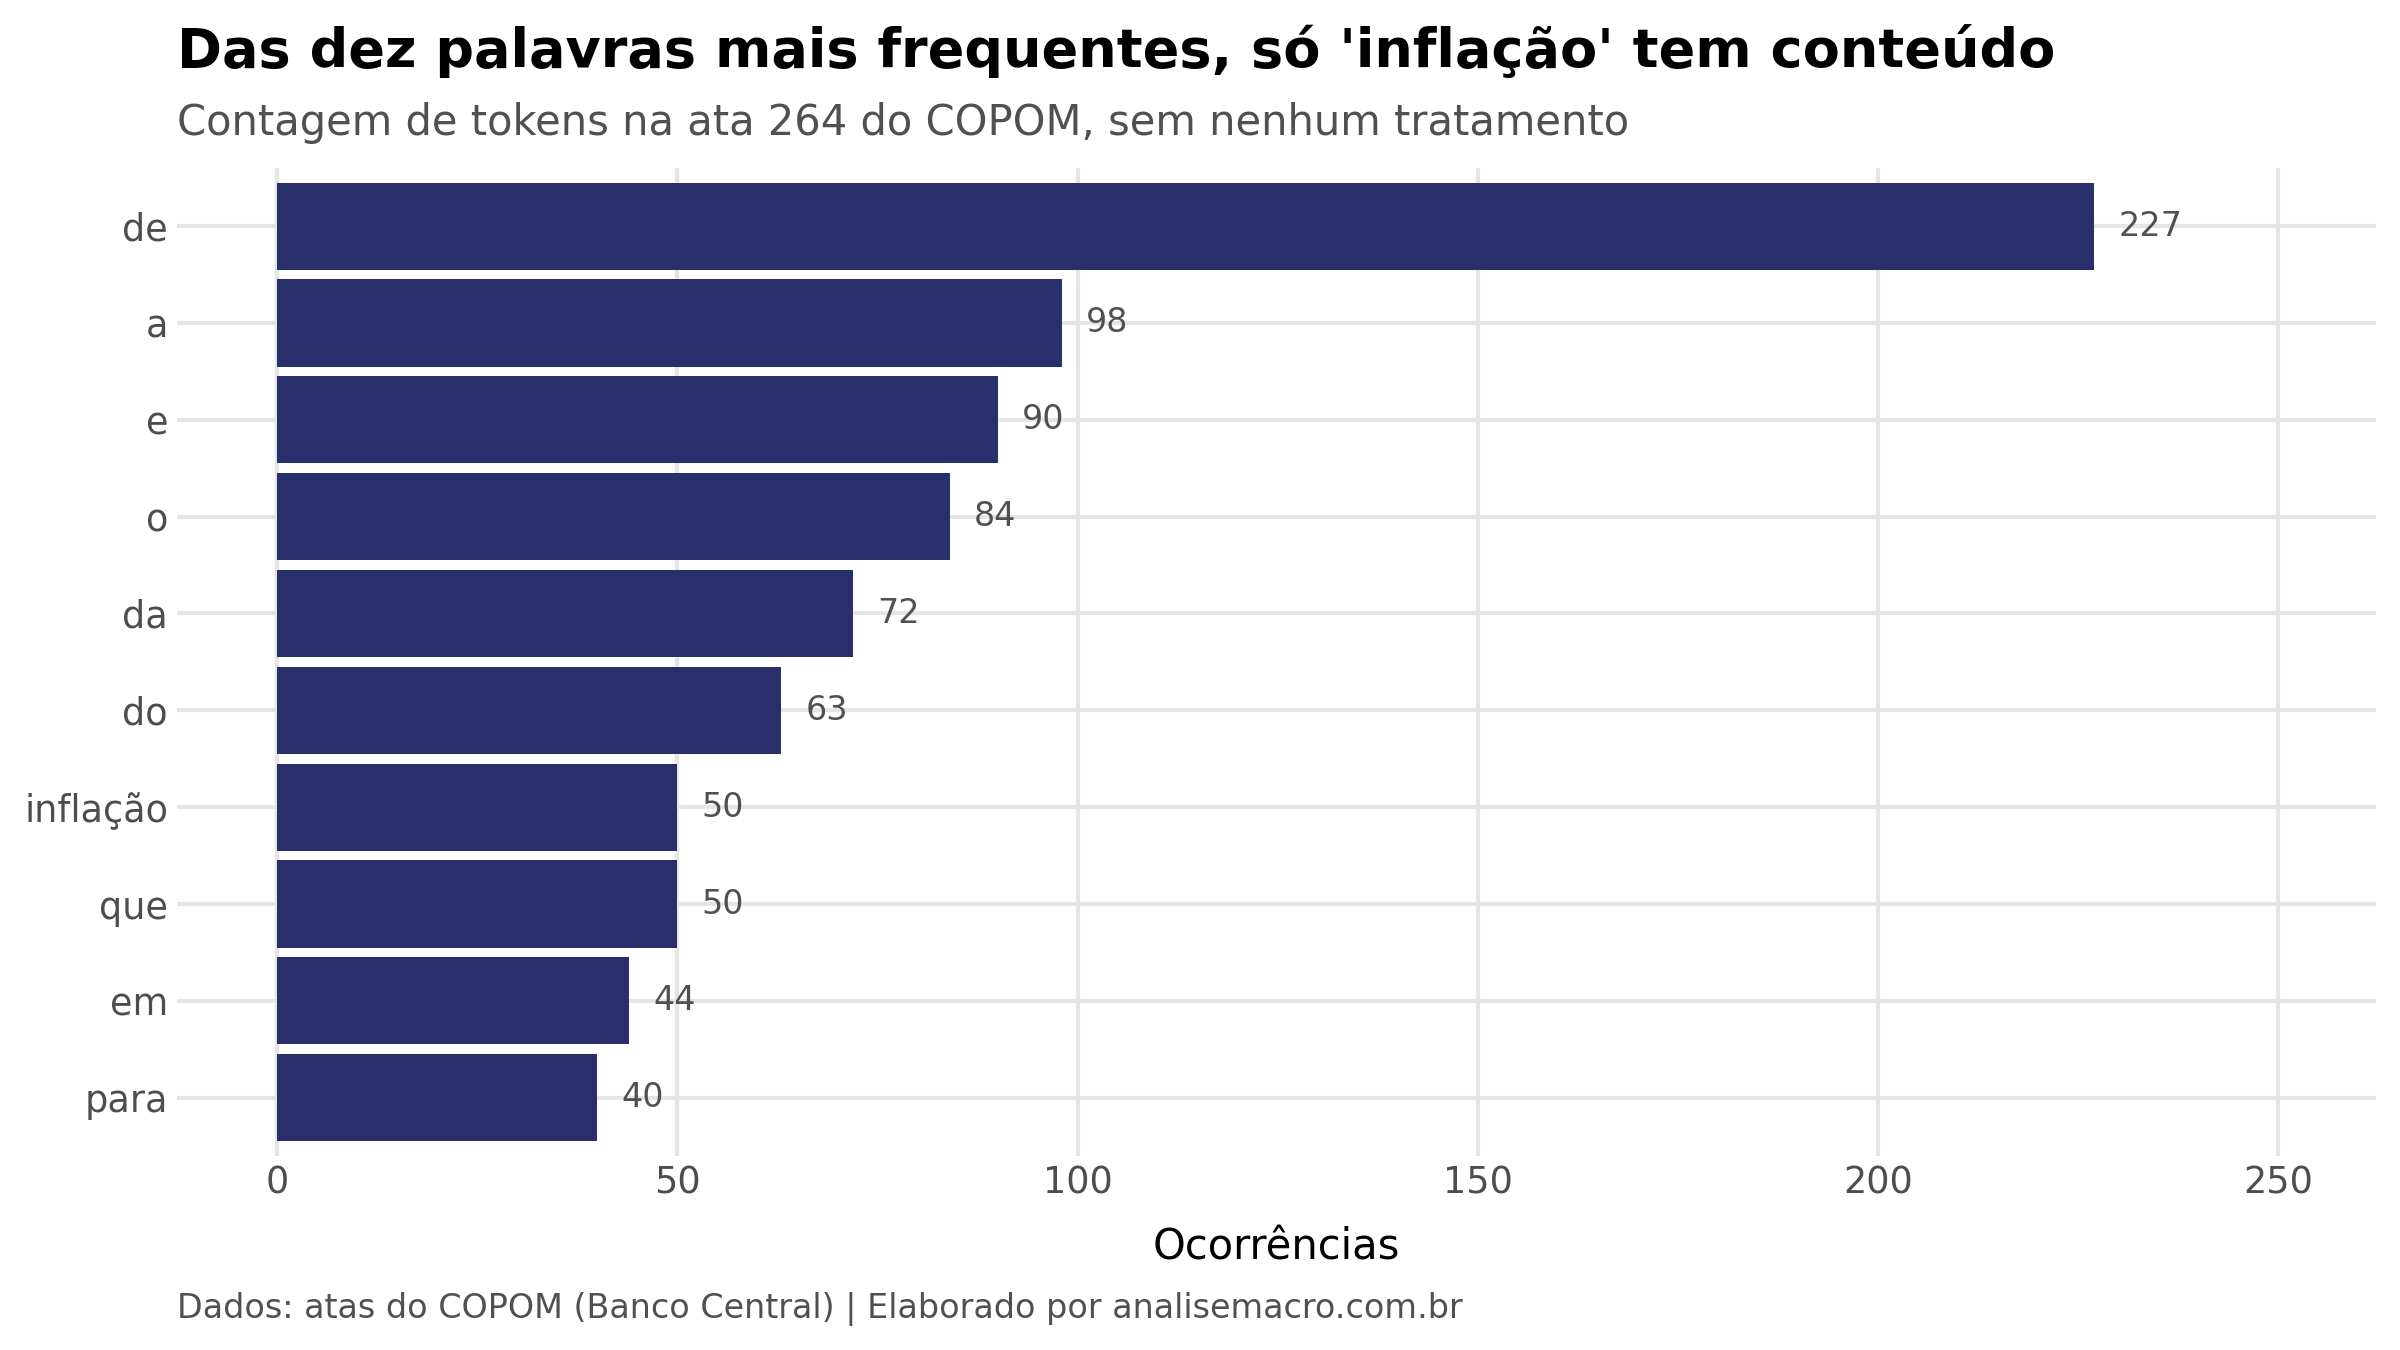
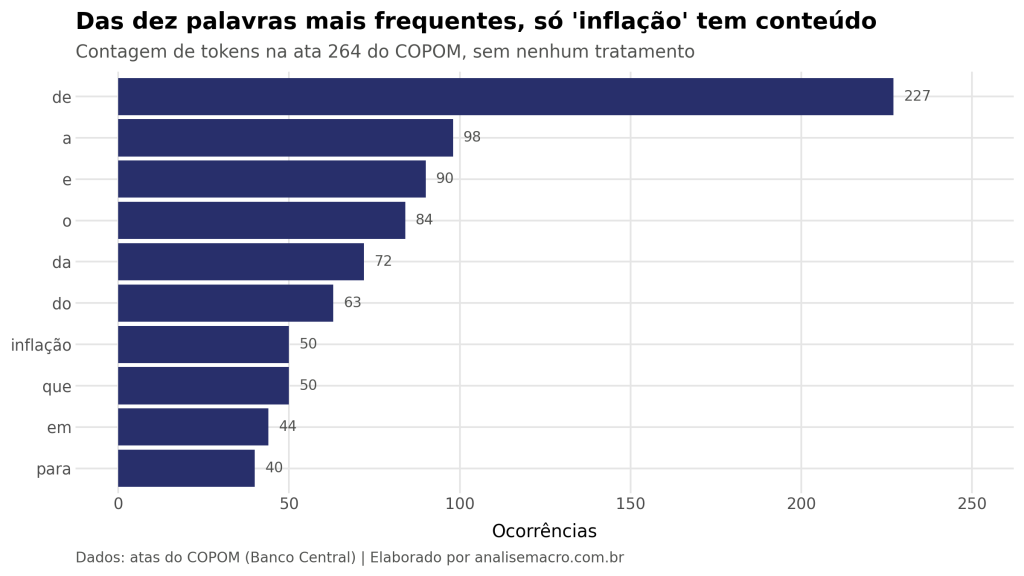
Das dez palavras mais usadas pelos diretores do COPOM na ata de julho de 2024, apenas "inflação" diz algo sobre o conteúdo do documento.
Ela aparece em sétimo lugar, com 50 ocorrências. As outras nove são preposições, artigos e conjunções.
📬 Estatística, econometria e IA aplicada. Todo dia, no seu e-mail.
O Boletim AM traz modelos estatísticos, econometria e LLMs aplicados a Economia, Finanças e análise de dados, com exemplos em R e Python. Todo domingo, às 20h, uma leitura mais longa que reúne as fontes da semana.
O que é a frequência dos termos (TF)?
A frequência de um termo mede quantas vezes ele aparece em um documento, dividido pelo total de palavras desse documento. Em mineração de textos essa medida se chama term frequency, ou TF.
Aqui t é o token, em geral uma palavra, e d é o documento. Um token é a unidade em que o texto foi dividido antes da análise.
Dividir pelo total de tokens é o que torna a medida comparável. A ata de julho tem 2.756 palavras e a de junho, 2.635. Sem a divisão, a ata maior teria frequências maiores só por ser maior.
O resultado dessa contagem é o gráfico da abertura, e ele mostra o limite da medida. O TF encontra as palavras mais comuns da língua portuguesa, que aparecem em qualquer documento e por isso não distinguem nenhum.
A Lei de Zipf: por que isso acontece
A concentração que aparece na contagem não é particularidade do COPOM. É uma regularidade de toda língua natural, descrita pelo linguista americano George Zipf.
A Lei de Zipf diz que a frequência de uma palavra é inversamente proporcional à sua posição no ranking.
A segunda palavra mais comum de um texto aparece cerca de metade das vezes que a primeira, a terceira cerca de um terço, e assim por diante.
O ranking é a posição do termo depois de ordená-los do mais para o menos frequente. O expoente s mede a rapidez da queda: quando vale 1, a lei se cumpre na forma exata que Zipf descreveu.
A verificação é feita em escala logarítmica nos dois eixos. Nessa escala, a proporção inversa vira uma reta, e o expoente vira a inclinação dela.
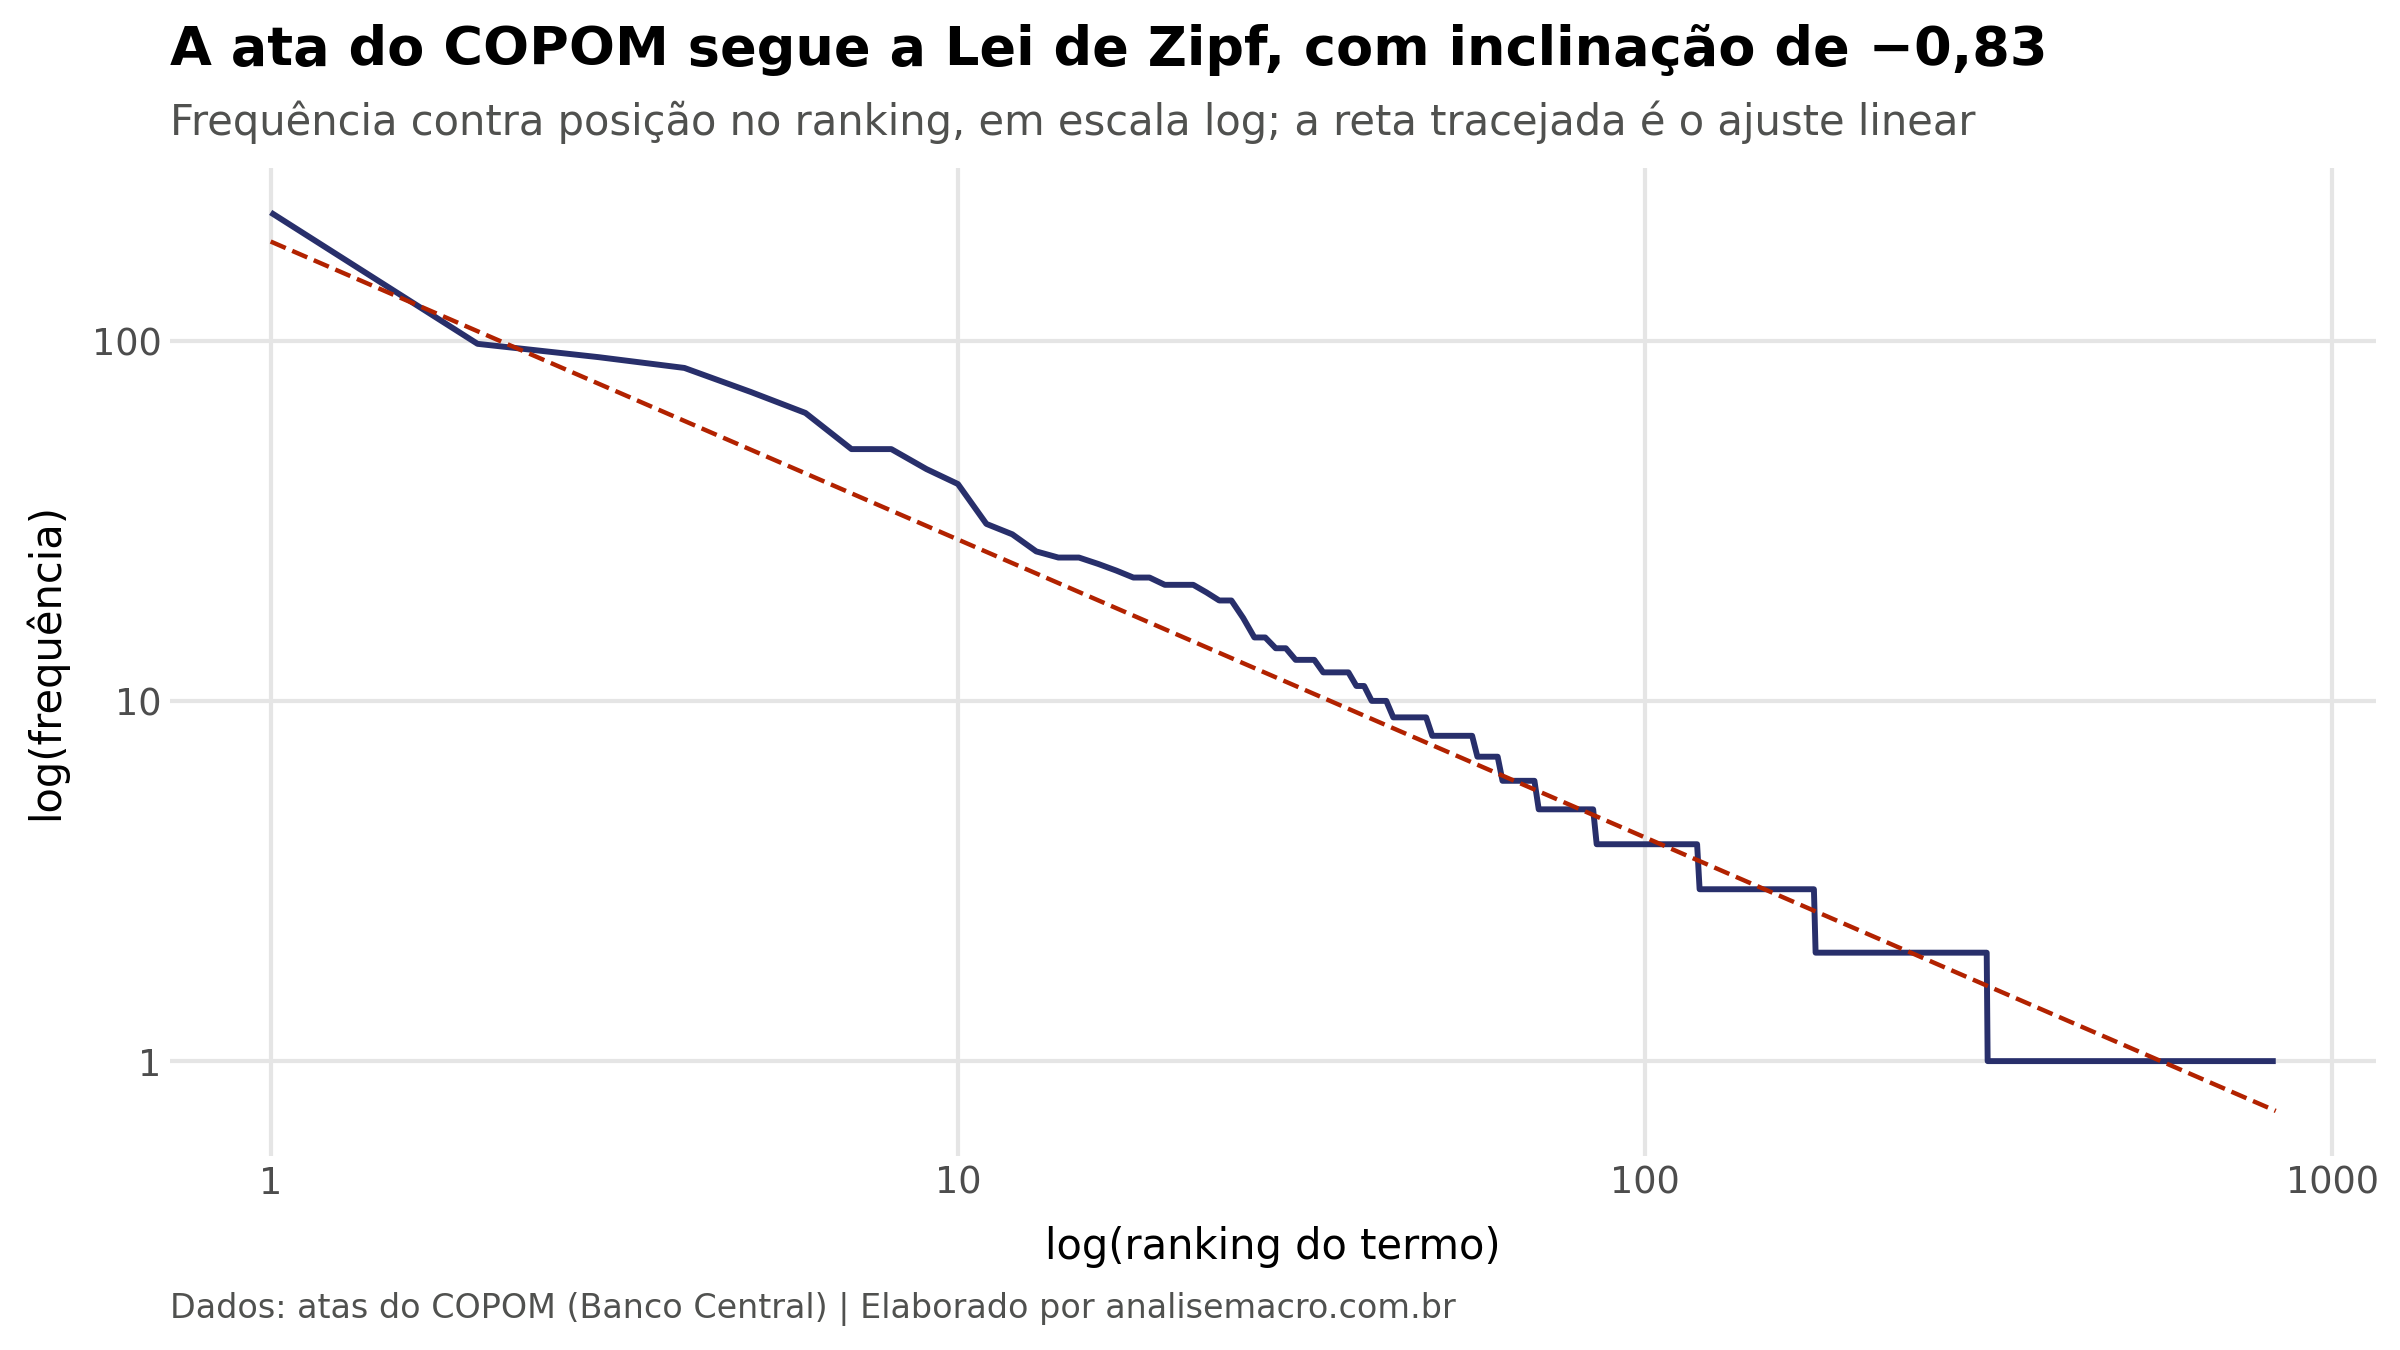
Os dados acompanham a reta por três ordens de grandeza, o que confirma a forma da lei. Mas a inclinação estimada é de −0,83, não −1.
A diferença diz que a frequência cai de forma mais lenta do que a proporção inversa exata prevê. Ou seja, a ata distribui um pouco melhor o uso das palavras.
Desvios assim são comuns e variam com o gênero do texto. Documentos técnicos, de vocabulário restrito e repetitivo, costumam ficar abaixo de 1 em módulo.
A Lei de Zipf explica por que a contagem bruta falha. Um punhado de palavras funcionais concentra a maior parte das ocorrências em qualquer texto.
É por isso que a remoção de stop words vem antes de quase toda análise.
O que é o TF-IDF?
Remover stop words resolve parte do problema, mas depende de uma lista fixa que não conhece o domínio do texto. Em um acervo de atas do COPOM, "inflação" aparece em todas — é frequente e, justamente por isso, não distingue uma reunião da outra.
A solução é medir a raridade do termo no conjunto de documentos. É o que faz a frequência inversa de documentos, ou IDF.
Aqui c é o conjunto de documentos. Quando um termo aparece em todos eles, a razão dentro do logaritmo vale 1 e o IDF é zero. Quanto mais raro o termo no acervo, maior o valor.
Multiplicando as duas medidas chegamos ao TF-IDF, que combina o quanto um termo aparece neste documento com o quanto ele é raro no conjunto.
A palavra "de" aparece nas duas atas, seu IDF é zero, e o TF-IDF zera junto, por mais frequente que ela seja.
Já um termo que aparece várias vezes em uma ata e nenhuma na outra sobe ao topo.
O TF responde "quais palavras este documento usa mais". O TF-IDF responde "quais palavras este documento usa e os outros não".
O que as duas atas revelam
Aplicamos o cálculo às atas 263 e 264 do COPOM, das reuniões de junho e julho de 2024, depois de remover as stop words das duas.
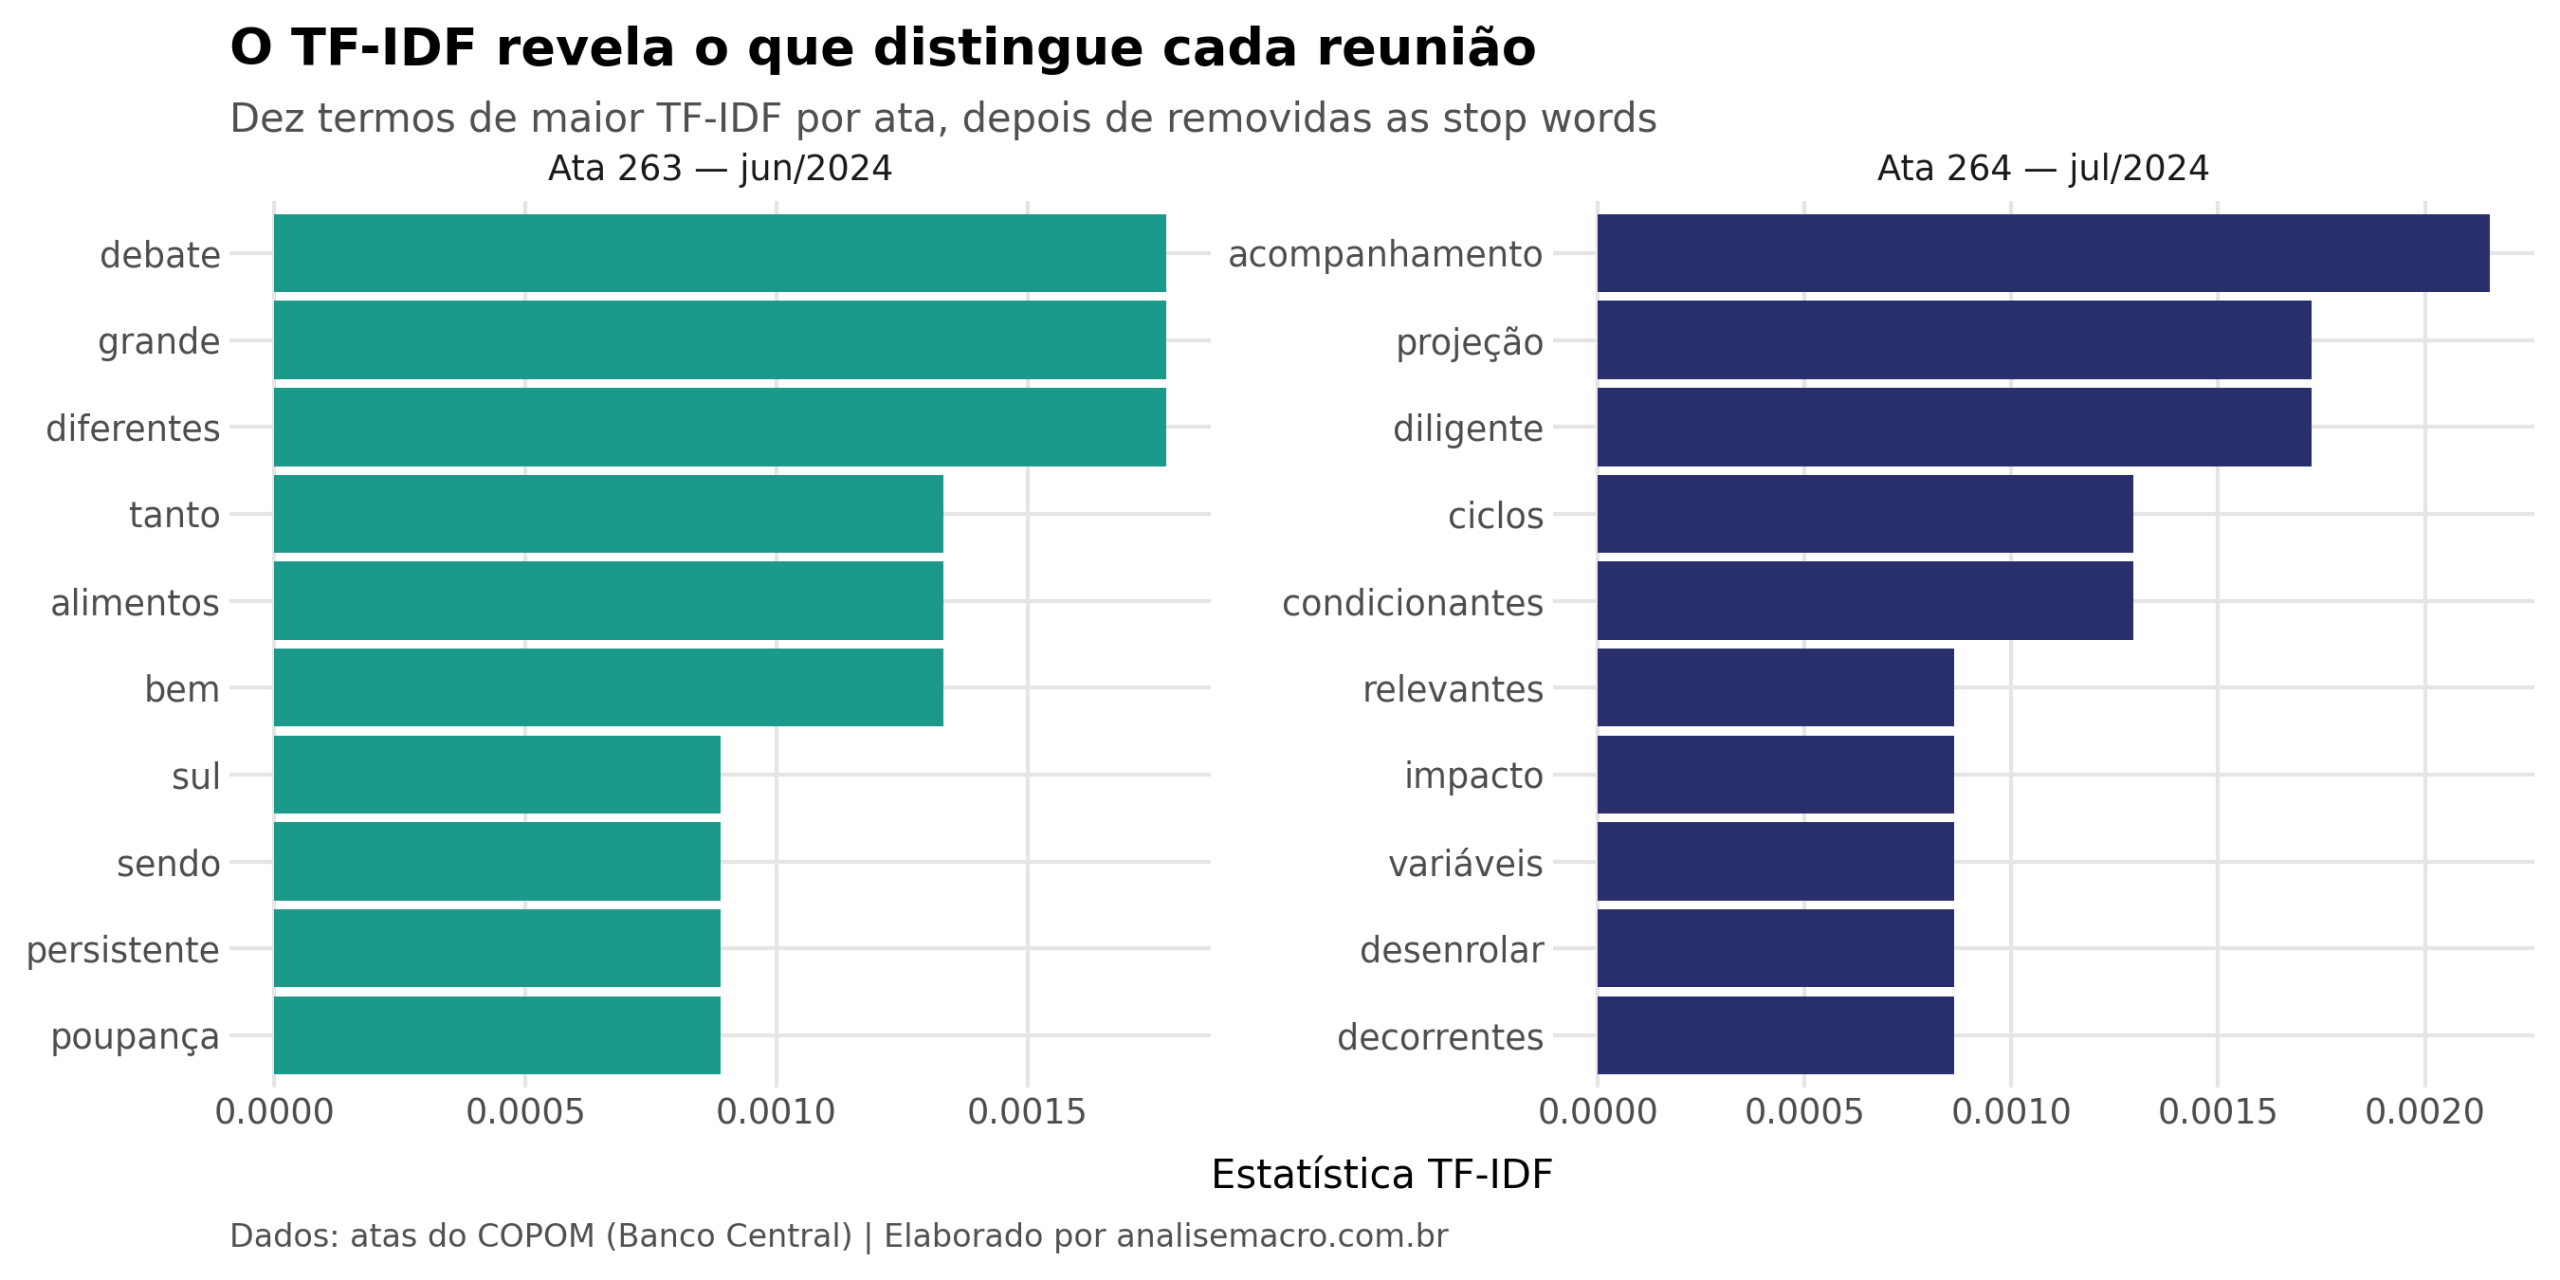
Na ata de junho estão "alimentos", "poupança" e "sul", que remetem às enchentes do Rio Grande do Sul e ao seu efeito sobre os preços.
Na de julho aparece o vocabulário do acompanhamento da política monetária: "acompanhamento", "projeção", "diligente", "condicionantes".
Nenhum desses termos estaria no topo de uma contagem simples. O TF-IDF os trouxe à superfície ao descartar tudo que as duas reuniões têm em comum.
Dois documentos são poucos para o TF-IDF
Com apenas duas atas, o IDF assume só dois valores: zero, para o que aparece nas duas, e ln(2), para o que aparece em uma. Isso reduz a medida a "termos exclusivos desta ata, ordenados por frequência".
É por isso que ainda sobram palavras de pouco conteúdo como "tanto" e "bem", que a lista padrão de stop words não cobre.
Com dezenas ou centenas de documentos, o IDF ganha escala contínua e separa bem melhor o vocabulário específico do genérico.
O método, etapa por etapa
O caminho da ata publicada até o gráfico de TF-IDF tem cinco etapas, e nenhuma delas é opcional.
| Etapa | O que se faz | O que acontece sem ela |
|---|---|---|
| Coletar | Baixar a ata pela API do Banco Central | Sem o número da reunião, a consulta não encontra o documento |
| Limpar | Remover marcação HTML, números e pontuação | As tags viram tokens e a pontuação gruda nas palavras |
| Tokenizar | Separar o texto em palavras | A contagem não tem sobre que unidade operar |
| Filtrar | Descartar as stop words | Artigos e preposições ocupam o topo de qualquer ranking |
| Ponderar | Calcular TF, IDF e o produto dos dois | O vocabulário comum a todos os documentos não é descontado |
As três primeiras etapas são as do pré-processamento de dados textuais. As duas últimas são o que este tutorial acrescenta.
No exercício, a coleta usa a API pública do Banco Central, a limpeza usa a BeautifulSoup para remover a marcação herdada da web, e a tokenização e a lista de stop words vêm da nltk. Os gráficos são feitos com a plotnine.
Onde o TF-IDF é usado
A medida foi proposta nos anos 1970 para recuperação de informação e continua no centro de várias aplicações.
- Busca em acervos. Quando um sistema ordena documentos por relevância a partir de uma consulta, o TF-IDF é o ponto de partida clássico do ranqueamento.
- Classificação de textos. Filtros de spam e classificadores de tema usam o vetor de TF-IDF de cada documento como entrada do modelo, em vez do texto cru.
- Comparação de documentos. Dois textos com vetores de TF-IDF parecidos tratam de assuntos parecidos, o que permite medir a similaridade entre comunicados de datas diferentes.
- Acompanhamento de comunicação oficial. Aplicado a uma série de atas, o TF-IDF mostra quando um tema entra e sai do radar do banco central, antes que isso apareça na decisão de juros.
Esse último uso é o que liga a técnica ao trabalho de análise macroeconômica. A relação entre os comunicados do COPOM e as variáveis macro é um campo de pesquisa próprio, e medidas de frequência são a base dele.
Considerações finais
O TF conta a frequência de cada termo e esbarra na gramática do idioma. A Lei de Zipf explica por que isso acontece, descrevendo a distribuição desigual que toda língua natural apresenta. E o TF-IDF resolve o problema ao penalizar os termos presentes em todos os documentos.
As três medidas são o alicerce da mineração de textos, e continuam valendo mesmo em aplicações que usam modelos de linguagem: o TF-IDF é rápido, interpretável e não depende de nenhuma infraestrutura além de uma tabela de contagens.
A limitação a ter em mente é a do acervo. Com poucos documentos, o IDF não tem o que separar, e a medida degenera em contagem de termos exclusivos. O ganho aparece quando o conjunto cresce.
Dominar essas técnicas muda o trabalho de quem lida com documentos:
- Economista — acompanha a mudança de vocabulário na comunicação oficial e a usa como indicador antecedente.
- Analista de research — compara relatórios e comunicados de datas diferentes sem ler tudo linha a linha.
- Cientista de dados — monta o vetor de entrada de um classificador de texto sem depender de modelo pré-treinado.
- Analista de risco — monitora menções a temas específicos em um acervo grande de documentos regulatórios.
O passo seguinte é medir não só quais palavras aparecem, mas o que elas indicam: se o tom de um documento é mais duro ou mais brando que o do anterior. É o terreno da análise de sentimentos.
Linguagem Econômica: mineração de textos de Bancos Centrais
Os dez capítulos do livro digital percorrem o caminho completo: dos primeiros tratamentos de texto ao indicador de sentimentos do COPOM e à classificação do tom da política monetária com IA generativa. Exercícios aplicados, em Python.
Quer acesso a todos os cursos da Análise Macro? Conheça o AM Black, a assinatura anual.
Leia também
- O que é mineração de textos e sua relação com IA? — o panorama da área e onde a extração de informação se encaixa.
- Onde encontrar dados e ferramentas para text mining? — as fontes de texto disponíveis e as bibliotecas que as acessam.
📩 A ferramenta é meio caminho. O outro é o método
Coletar e tratar o dado é a parte que a IA já encurtou. O que continua sendo seu é saber qual pergunta fazer e como checar a resposta. No Boletim AM eu mostro, todo dia, estatística, econometria e IA aplicadas à economia, mercado financeiro e análise de dados.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.