A análise de cenários mais comum entrega três números: otimista, base e pessimista. Falta neles a probabilidade de cada cenário, sem a qual não dá para pesar um contra o outro. Ninguém sabe dizer se o caso pessimista tem 1% ou 30% de chance de acontecer. Neste artigo trocamos os três números por uma distribuição completa.
A pergunta do exercício: onde a dívida bruta do governo geral termina no ano que vem, e com que probabilidade?
A dívida bruta do governo geral soma o endividamento do governo federal, do INSS e dos governos estaduais e municipais, expresso como proporção do PIB. É o indicador que agências de risco e investidores acompanham para julgar a saúde fiscal do país. Ela é projetada a partir de outras variáveis, cada uma delas incerta.
Receba as próximas análises no seu e-mail
Cenários probabilísticos, dívida pública e propagação de incerteza aparecem toda semana nas análises do Boletim AM. A assinatura é gratuita e chega direto no seu e-mail.
O problema dos três cenários
A ausência de probabilidade é o primeiro problema. O segundo está na forma como o cenário pessimista é construído.
O cenário pessimista costuma ser montado colocando todas as variáveis no pior valor ao mesmo tempo: inflação alta, juro alto, crescimento baixo e resultado fiscal ruim, tudo simultaneamente.
Essa combinação é bem menos provável do que cada uma das partes isoladamente. Se cada valor ruim tem, digamos, uma chance em cinco de ocorrer, a chance de os quatro ocorrerem juntos é muito menor do que uma em cinco, e nem sabemos quanto menor, porque isso depende de como as variáveis se relacionam entre si.
O resultado é um número sem interpretação clara: pode ser um caso extremo quase impossível, ou pode nem ser tão pessimista assim, dependendo de como as variáveis interagem dentro da equação.
O mecanismo de sorteio repetido que usamos aqui é o da simulação de Monte Carlo, e o que muda neste exercício é o número de fontes de incerteza que entram no mesmo laço.
A alternativa é atribuir uma distribuição de probabilidade a cada variável de entrada, sortear milhares de combinações e olhar a distribuição do resultado.
De onde vem a incerteza de cada entrada
A dívida serve bem a este exercício por duas razões. Ela é calculada por uma equação que combina quatro variáveis incertas, e existe uma fonte pública que publica, para cada uma delas, tanto a expectativa do mercado quanto o quanto os analistas discordam entre si.
Mediana, média e desvio-padrão são as três estatísticas de um sumário descritivo, aqui calculadas sobre as respostas dos analistas.
Essa fonte é o Focus, pesquisa que o Banco Central realiza semanalmente com instituições do mercado. Para cada variável, ele divulga três informações:
- a mediana das projeções, que é a expectativa central;
- a média das projeções, que se desloca quando alguns respondentes se afastam do consenso;
- o desvio-padrão entre os respondentes, que mede a discordância.
A maioria das análises usa apenas a mediana e descarta a média e o desvio-padrão. Mas é o desvio-padrão que permite sair de um número único para uma distribuição, porque ele diz o quanto abri-la, e é a distância entre média e mediana que diz para que lado ela pende. Sem essas duas informações, largura e formato teriam de ser arbitrados.
Resta definir o ponto de partida. A dívida é publicada mensalmente, mas as expectativas do Focus e a equação que usaremos são anuais. Por isso a base é o último dezembro observado, e o ano projetado é o seguinte, o mesmo recorte que o Focus usa ao projetar a dívida.
Como um número vira uma distribuição
Um número vira uma distribuição quando ganha três informações:
- onde ela está centrada;
- quão espalhada ela é;
- se ela é simétrica ou pende para um lado.
Centro, dispersão e inclinação saem todos do próprio Focus.
Supor simetria significaria dizer que uma surpresa de meio ponto para cima é tão provável quanto meio ponto para baixo. Em variáveis econômicas isso costuma ser falso: a inflação tem mais espaço para surpreender para cima, e o crescimento tende a decepcionar mais do que a surpreender.
Escolher a família que reproduz o formato de cada variável é o mesmo diagnóstico feito em distribuições de probabilidade em dados, agora aplicado às entradas de uma projeção.
Para acomodar esse comportamento usamos a normal assimétrica. Ela mantém o formato de sino da normal, mas acrescenta um terceiro parâmetro que inclina a curva: valores positivos alongam a cauda direita, negativos alongam a esquerda, e zero devolve a normal comum.
Onde a fonte informa a inclinação
A inclinação sai da comparação entre duas colunas que o Focus publica lado a lado: a média e a mediana das projeções.
Numa distribuição simétrica, as duas coincidem. Quando alguns respondentes projetam valores muito acima dos demais, esses valores puxam a média para cima sem deslocar a mediana, que depende apenas da posição central da fila ordenada. A média se afasta na direção da cauda mais longa; a mediana fica onde está.
A distância entre as duas mede, então, o quanto a distribuição pende, e o sinal dessa distância diz para que lado. Dividida pelo desvio-padrão, para ficar comparável entre variáveis medidas em grandezas diferentes, ela é o segundo coeficiente de assimetria de Pearson:
Assim a inclinação vem da mesma pesquisa que fornece o centro e a dispersão.
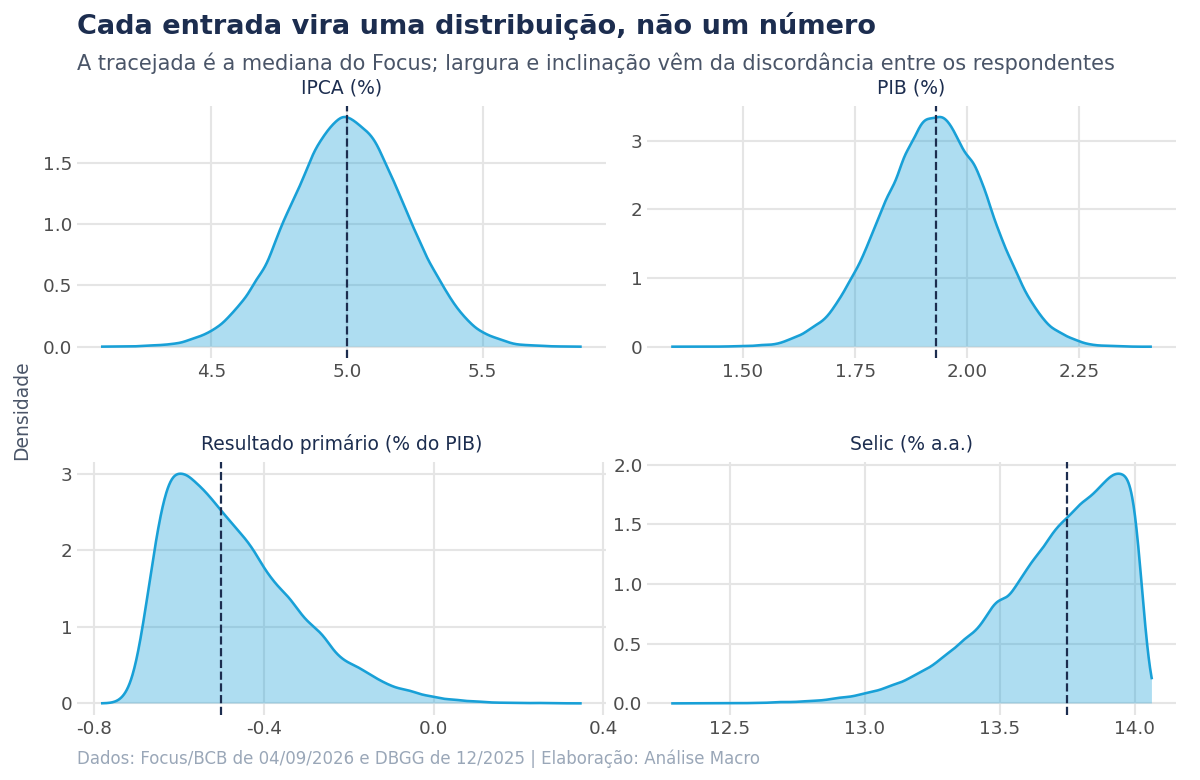
Cada painel mostra a distribuição de uma das entradas, com a linha tracejada marcando a mediana publicada pelo Focus. A largura e a inclinação de cada curva vêm da discordância entre os respondentes: quanto mais eles divergem, mais larga a distribuição; conforme divirjam mais para um lado, mais ela pende para esse lado.
Um detalhe de calibração
Como média e mediana não coincidem numa distribuição assimétrica, é preciso decidir qual delas a simulação vai reproduzir.
A preferência pela mediana diante de respondentes extremos é a mesma lógica das estatísticas robustas: mediana, IQR e MAD.
A escolha é pela mediana, pelo mesmo motivo que a tornou útil acima: ela depende só da posição central da fila ordenada e não se move quando alguns respondentes projetam valores distantes dos demais. Centrar a simulação na média faria o centro da projeção depender de quantos participantes extremos responderam naquela semana.
Cada informação da montagem sai de uma estatística diferente da mesma pesquisa:
- a posição vem da mediana;
- a largura vem do desvio-padrão;
- a inclinação vem da distância entre média e mediana.
A equação que combina tudo
Com as entradas prontas, falta o que transforma cada cenário sorteado em um resultado. No caso da dívida, esse papel cabe à equação de sustentabilidade.
Ela diz que a variação da dívida depende de duas coisas:
- do resultado primário, que é o que o governo arrecada menos o que gasta, antes de contar os juros;
- da diferença entre o juro real (a taxa básica descontada a inflação) e o crescimento do PIB.
Nessa notação d é a dívida em proporção do PIB, r o juro real, g o crescimento do PIB e s o resultado primário. A leitura é mais simples do que a fórmula sugere. A dívida sobe quando há déficit primário, porque o governo precisa se endividar para cobrir a diferença.
E sobe também quando o juro real supera o crescimento do PIB: como a dívida é medida em proporção do PIB, o juro faz o numerador crescer e o crescimento faz o denominador crescer. Se o primeiro corre mais rápido que o segundo, a razão entre eles aumenta mesmo sem novo endividamento.
O juro real r entra descontando a inflação da taxa básica:
É por aí que a inflação alcança a dívida no exercício: ela aparece no denominador, e uma inflação maior reduz o juro real.
Uma observação sobre a convenção da fonte: no Focus, valor negativo do resultado primário significa déficit. Como o déficit aumenta a dívida, o termo entra subtraindo na equação.
Inverter esse sinal é um erro fácil de cometer e difícil de enxergar na saída, porque a projeção continua produzindo números plausíveis. A comparação com a projeção de dívida publicada pelo próprio Focus, feita adiante, é o que revela a troca.
O resultado: uma distribuição de projeções
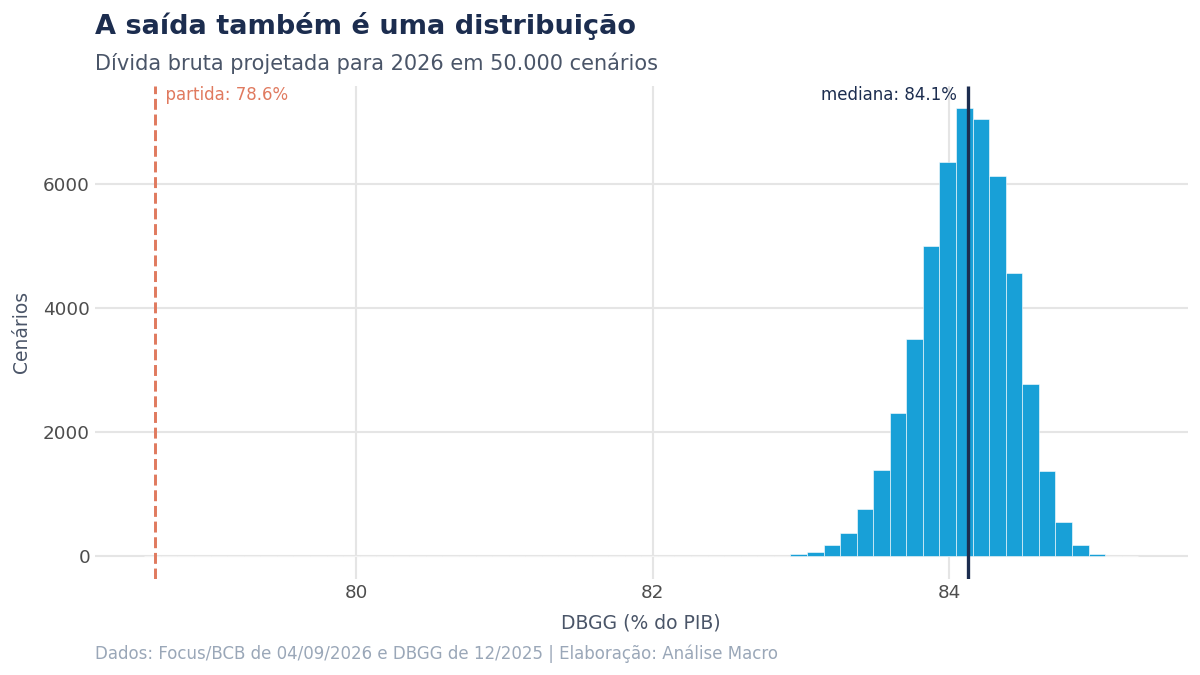
Cada cenário sorteado passou pela equação e virou um valor de dívida. A saída é uma distribuição inteira, e não um número.
À esquerda da figura, a dívida do ano-base fica fora da distribuição inteira. Nenhum dos cenários simulados termina no patamar de onde a projeção partiu.
O deslocamento vem da própria equação, e não de alguma escolha pessimista na montagem dos cenários. Ela produz esse resultado sempre que o juro real mediano fica bem acima do crescimento esperado, porque a diferença entre os dois empurra a dívida para cima em todos os cenários.
Comparando com uma referência externa
O Focus também publica a expectativa do próprio mercado para a dívida. Nossa simulação chegou a um valor por um caminho completamente diferente: partindo de quatro variáveis e de uma equação, sem olhar essa projeção.
Os dois valores caem na mesma vizinhança, e a folga que sobra vem do alcance da equação: ela tem quatro variáveis, enquanto a dívida se move também por câmbio, composição por indexador e operações que não passam pelo resultado primário.
Sempre que a saída de uma simulação puder ser comparada a algo observável, seja uma projeção publicada, um valor histórico ou o resultado de outro método, a comparação deve ser feita antes de reportar. Custa uma linha de código e pega erros que passariam despercebidos.
O que os três cenários perdiam
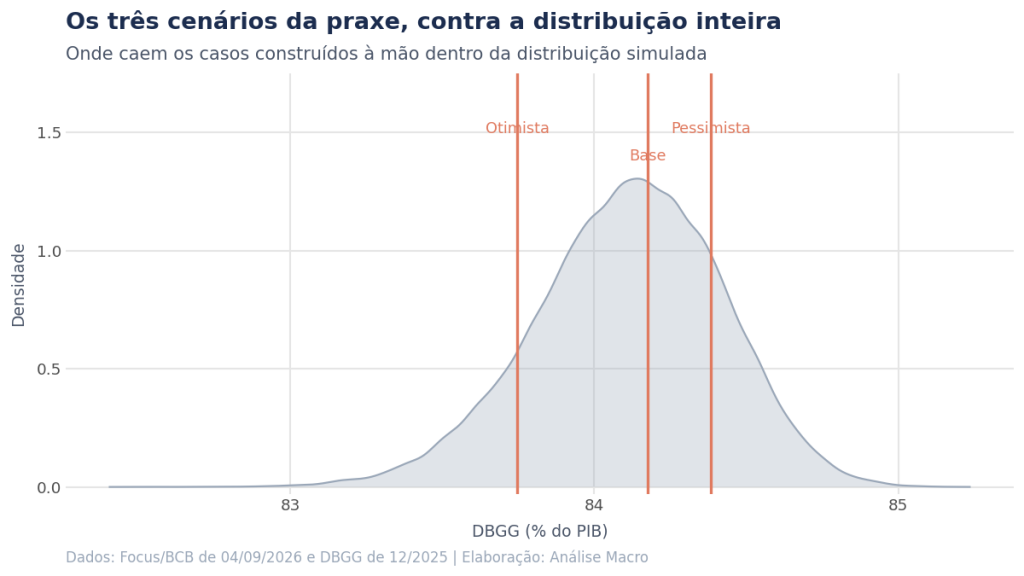
Agora dá para responder à crítica do começo com números. Montamos os três cenários da praxe:
- o pessimista, com todas as variáveis no lado ruim ao mesmo tempo;
- o otimista, com todas no lado bom;
- o base, com todas na mediana.
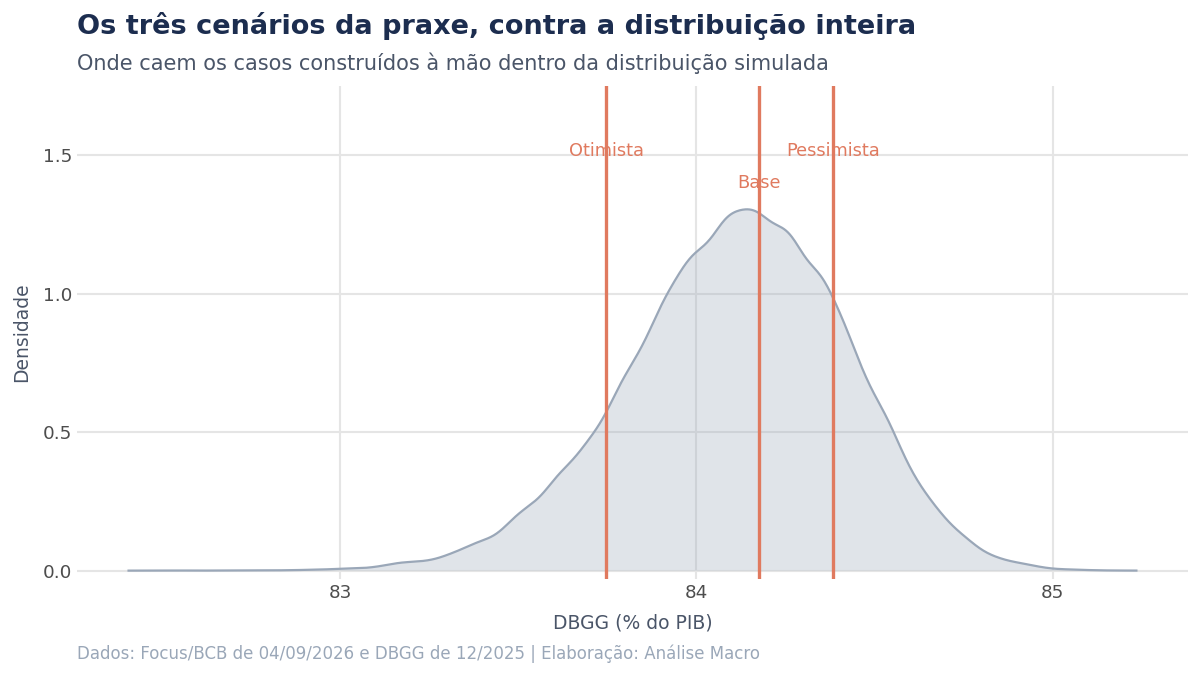
Os três cenários feitos à mão caem todos na região central da distribuição simulada. O pessimista construído empilhando valores ruins é superado por uma parcela considerável dos cenários sorteados; o otimista deixa uma parcela semelhante abaixo dele.
Ou seja: aquilo que a análise tradicional apresenta como o pior caso é superado com frequência bem maior do que o rótulo sugere. Um cenário chamado de "pessimista" que os fatos batem com alguma regularidade comunica menos do que aparenta.
O outro lado do problema aparece aqui. Empilhar quatro valores ruins costuma produzir um caso absurdamente improvável, mas aqui não produziu, porque as quatro variáveis não empurram a dívida na mesma direção com a mesma força. Sem a distribuição, não havia como saber em qual dos dois erros se estava incorrendo.
De onde vem a incerteza do resultado
Com a simulação montada, uma pergunta fica barata de responder: qual das quatro entradas mais contribui para a incerteza da projeção?
O teste parte de um raciocínio direto: se uma variável é a principal responsável pela incerteza do resultado, eliminar a incerteza dela deveria estreitar bastante a distribuição de saída. Se ela pesa pouco, a distribuição quase não muda.
Fazemos isso uma variável por vez: em vez de sortear, fixamos ela na mediana do Focus, como se o futuro dela fosse conhecido, e medimos o quanto a dispersão da dívida projetada encolhe.
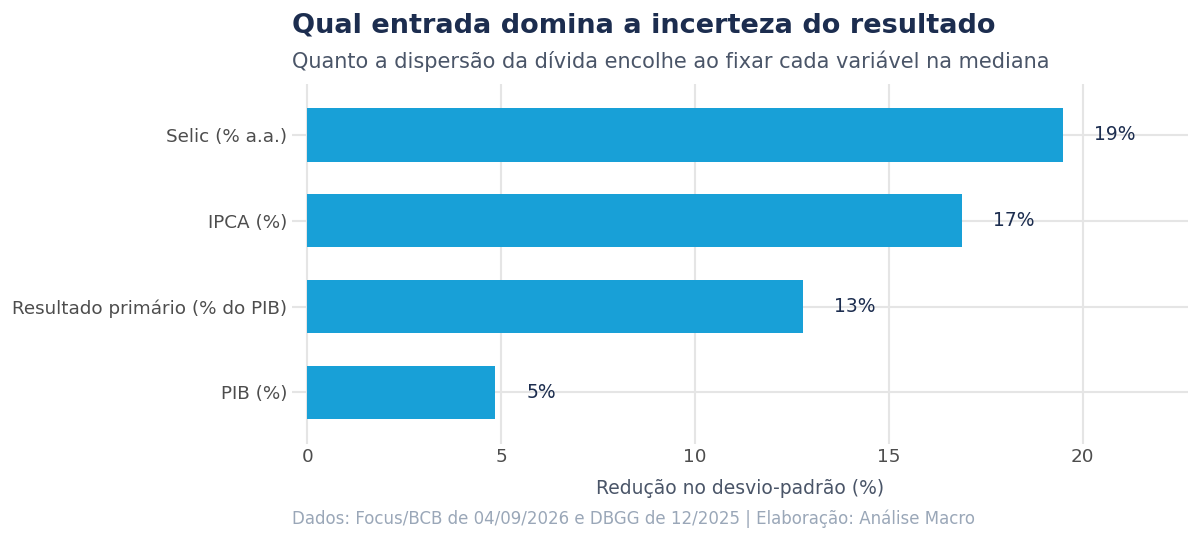
A ordem costuma surpreender quem acompanha o debate fiscal: o resultado primário concentra a maior parte da discussão sobre a dívida, mas não lidera a contribuição para a incerteza.
O motivo é que essa contribuição depende de duas coisas ao mesmo tempo: o peso da variável na equação e o quanto os analistas discordam sobre ela. Uma variável decisiva sobre a qual todos concordam não gera incerteza nenhuma; uma de peso moderado sobre a qual as projeções se espalham gera bastante.
São duas perguntas diferentes: qual variável mais afeta o resultado e qual mais gera incerteza sobre ele. Quem quer uma projeção mais precisa precisa investir na segunda. E como a discordância muda a cada divulgação, a ordem entre as variáveis não é fixa.
O que acontece com a assimetria
Resta verificar o que a assimetria de cada entrada produz na saída. Se as quatro distribuições têm uma cauda mais longa de um lado, a distribuição da dívida herda essas caudas de que forma?
Testamos entrada por entrada: deixamos apenas uma delas assimétrica de cada vez, com a assimetria medida no Focus, e zeramos a das demais.
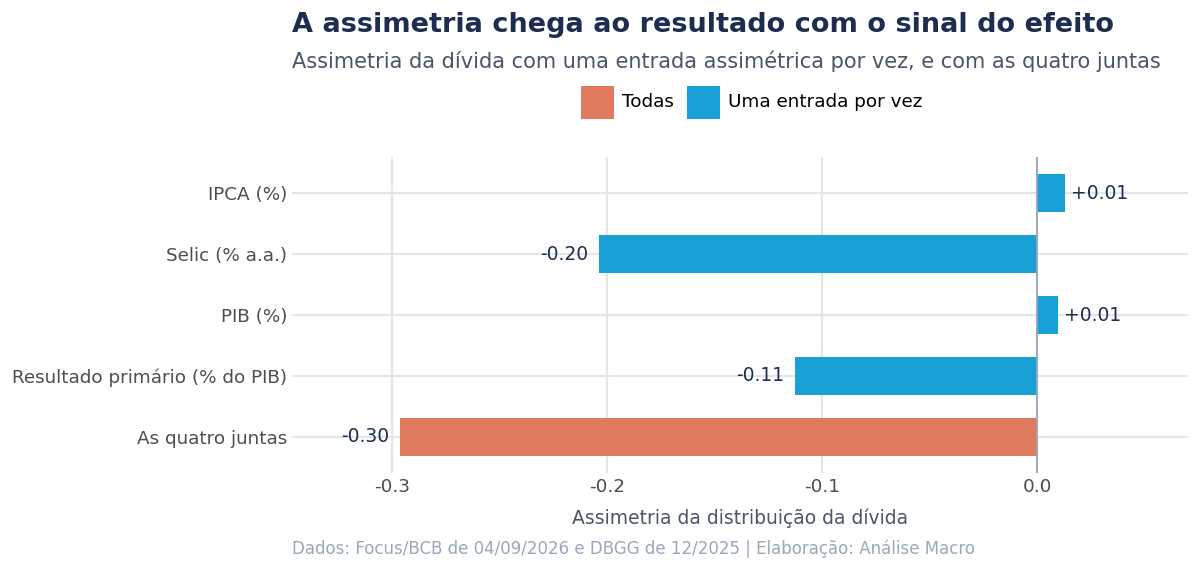
Três das quatro entradas chegam ao resultado com o sinal invertido, e a equação explica cada uma. A inflação aparece no denominador do juro real, então inflação mais alta reduz o juro real e reduz a dívida. O crescimento entra subtraindo. O resultado primário também, porque um superávit abate dívida. Só a taxa de juros preserva o sinal, por ser a única que entra somando.
A regra geral: a assimetria de uma entrada chega ao resultado com o sinal do efeito daquela variável sobre ele, e não com o sinal que ela tinha na entrada. O que decide é a posição da variável na equação.
Daí vem o comportamento da barra que reúne as quatro. Ela não é a soma das outras: contribuições de mesmo sinal se reforçam, de sinais opostos se cancelam, e o saldo depende de quais entradas pendem para que lado naquela divulgação. Por isso a assimetria da saída precisa ser medida, e não deduzida das entradas.
Os limites do método
📊
🔗
✍️
O primeiro limite é sobre o que o desvio-padrão do Focus mede. Ele capta a discordância entre analistas, e não o erro de previsão. Se todos erram na mesma direção, o que acontece com frequência diante de um choque não antecipado, o intervalo simulado será estreito demais.
Dá para dimensionar isso aplicando a equação a anos já encerrados, com os valores que de fato se realizaram, e comparando com a dívida observada. O erro dessa conta fica na casa de alguns pontos percentuais, bem acima da largura que a discordância do Focus produz. O intervalo simulado descreve a dispersão das opiniões sobre quatro variáveis, e não a incerteza sobre a dívida.
A distinção importa porque o intervalo de uma pesquisa amostral mede a precisão de uma estimativa, assunto do Teorema Central do Limite, enquanto a dispersão do Focus mede o desacordo entre quem projeta.
O segundo é sobre a independência do sorteio. Inflação e juros andam juntos no mundo real: o Banco Central sobe a taxa quando a inflação sobe. Sortear as duas sem correlação gera cenários internamente incoerentes.
O terceiro é sobre a assimetria, que é inferida e não observada. O coeficiente de Pearson resume o formato da distribuição em um número a partir de três estatísticas, sem enxergar a distribuição inteira das respostas. Ele capta bem o lado para o qual ela pende, mas não distingue uma cauda longa e rala de um grupo de respondentes concentrado longe do consenso.
Quem precisar dessa distinção encontra os histogramas completos no Relatório de Distribuições de Frequência das Expectativas de Mercado, publicado pelo próprio Banco Central.
O quarto é sobre a Selic do Focus, que é de fim de período, enquanto o juro que incide sobre a dívida ao longo do ano é a taxa média. Nos anos em que o Banco Central move a taxa com intensidade, as duas se distanciam.
Há ainda um quinto limite, sobre a equação. Ela ignora o câmbio, a composição da dívida por indexador e os passivos que aparecem fora do resultado primário, o que explica boa parte da distância entre a projeção simulada e a do mercado.
Cada limite acima é uma hipótese sobre o processo gerador dos dados que a simulação toma como dada.
Nenhum desses limites invalida o método. O que eles mostram é que a distribuição de saída herda tudo o que foi assumido na entrada, e que o trabalho analítico está em escolher e justificar as entradas.
O roteiro completo
| Passo | O que fazer |
|---|---|
| 1 | Escreva a equação que liga as variáveis incertas ao resultado. |
| 2 | Colete a incerteza de cada entrada de uma fonte que a meça, em vez de arbitrar. |
| 3 | Escolha a família de distribuição e calibre-a para reproduzir as estatísticas publicadas. |
| 4 | Sorteie e propague milhares de combinações pela equação. |
| 5 | Confira a saída contra algo observável, quando existir. |
| 6 | Decomponha a incerteza para descobrir qual entrada domina o resultado. |
| 7 | Reporte probabilidades, não cenários nomeados. |
O último passo muda a forma de comunicar o resultado. Dizer que existe determinada probabilidade de a dívida superar certo patamar carrega mais informação do que apresentar um "cenário pessimista" sem probabilidade associada.
Você simulou cenários; aprenda a construir modelos
Da geração de cenários à modelagem e previsão de séries econômicas, com Python aplicado a dados reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
AZZALINI, A.; CAPITANIO, A. The skew-normal and related families. Cambridge: Cambridge University Press, 2014. (Institute of Mathematical Statistics Monographs, v. 3).
CELASUN, O.; DEBRUN, X.; OSTRY, J. D. Primary surplus behavior and risks to fiscal sustainability in emerging market countries: a "fan-chart" approach. IMF Staff Papers, Washington, DC, v. 53, n. 3, p. 401-425, 2006.
ESCOLANO, J. A practical guide to public debt dynamics, fiscal sustainability, and cyclical adjustment of budgetary aggregates. Washington, DC: International Monetary Fund, 2010. (Technical Notes and Manuals, TNM/10/02).
SALTELLI, A. et al. Global sensitivity analysis: the primer. Chichester: John Wiley & Sons, 2008.
VOSE, D. Risk analysis: a quantitative guide. 3. ed. Chichester: John Wiley & Sons, 2008.
Leia também: Tabelas de contingência e teste qui-quadrado · Variáveis quantitativas e qualitativas: o que são e como analisar