Entender as características gerais dos dados é uma das primeiras etapas de um projeto de ciência ou análise de dados. É como se sentar no banco do motorista de um carro que você nunca dirigiu na vida: primeiro você vai querer se ambientar e entender os principais comandos de direção do veículo e, então, ter mais confiança para pilotar o veículo.
De forma análoga, um cientista ou analista de dados precisa primeiro entender os dados para, então, desenvolver uma análise preditiva, diagnóstica ou prescritiva. Em certa medida, podemos dizer que a base de tudo isso é uma boa análise descritiva. Sendo assim, neste artigo vamos navegar pelas definições, fórmulas, cálculos e computação das estatísticas descritivas, como forma de entendimento de dados do tipo série temporal e/ou corte transversal. Além disso, mostraremos na prática, em R e Python, como gerar um sumário para reportar e analisar os dados rapidamente.O que são estatísticas descritivas de dados?
As estatísticas descritivas desempenham um papel fundamental na análise de dados, fornecendo insights valiosos sobre as características e padrões de um conjunto de dados. Antes de mergulhar em técnicas analíticas avançadas, é essencial ter um bom domínio das estatísticas descritivas. A seguir, vamos explorar o que são estatísticas descritivas e discutir sua relevância na análise tanto de dados de séries temporais quanto de dados de corte transversal. Estatísticas descritivas envolvem resumir e apresentar dados de forma significativa para descobrir características-chave, tendências e distribuições. Elas nos permitem obter uma compreensão inicial do conjunto de dados, identificar valores atípicos, medir tendências centrais e avaliar a variabilidade ou dispersão das variáveis. Ao utilizar várias medidas estatísticas, podemos obter insights significativos e tomar decisões informadas com base nos dados observados.
Dados de séries temporais
Ao lidar com dados de séries temporais, que são coletados ao longo de uma sequência de períodos de tempo, certas estatísticas descritivas se tornam particularmente relevantes. Essas estatísticas nos ajudam a entender o comportamento temporal e os padrões exibidos pelos dados. Algumas estatísticas descritivas importantes para a análise de séries temporais incluem:- Medidas de tendência central: isso inclui a média, mediana e moda, que fornecem insights sobre o valor médio ou típico da série temporal.
- Medidas de dispersão: desvio padrão, variância e amplitude são úteis para avaliar a variabilidade ou dispersão dos pontos de dados ao longo da série temporal.
- Análise de tendência: estatísticas obtidas pela regressão linear e médias móveis ajudam a identificar tendências, sejam elas crescentes, decrescentes ou estacionárias, ao longo do tempo.
- Sazonalidade e periodicidade: ao examinar estatísticas descritivas como autocorrelação e análise espectral, podemos detectar padrões sazonais ou flutuações periódicas dentro da série temporal.
Dados de corte transversal
Por outro lado, ao trabalhar com dados de corte transversal, que representam observações realizadas em um ponto específico no tempo, diferentes estatísticas descritivas são relevantes. Essas estatísticas oferecem insights sobre a distribuição e as relações entre as variáveis em um determinado momento. Aqui estão algumas estatísticas descritivas importantes para a análise de dados de corte transversal:- Distribuição de frequência: fornece um resumo da frequência com que diferentes valores ocorrem para uma variável específica, usualmente representada por meio de histogramas ou gráficos de barras.
- Medidas de associação: estatísticas descritivas como coeficientes de correlação (por exemplo, correlação de Pearson) e tabelas de contingência ajudam a entender as relações e dependências entre as variáveis.
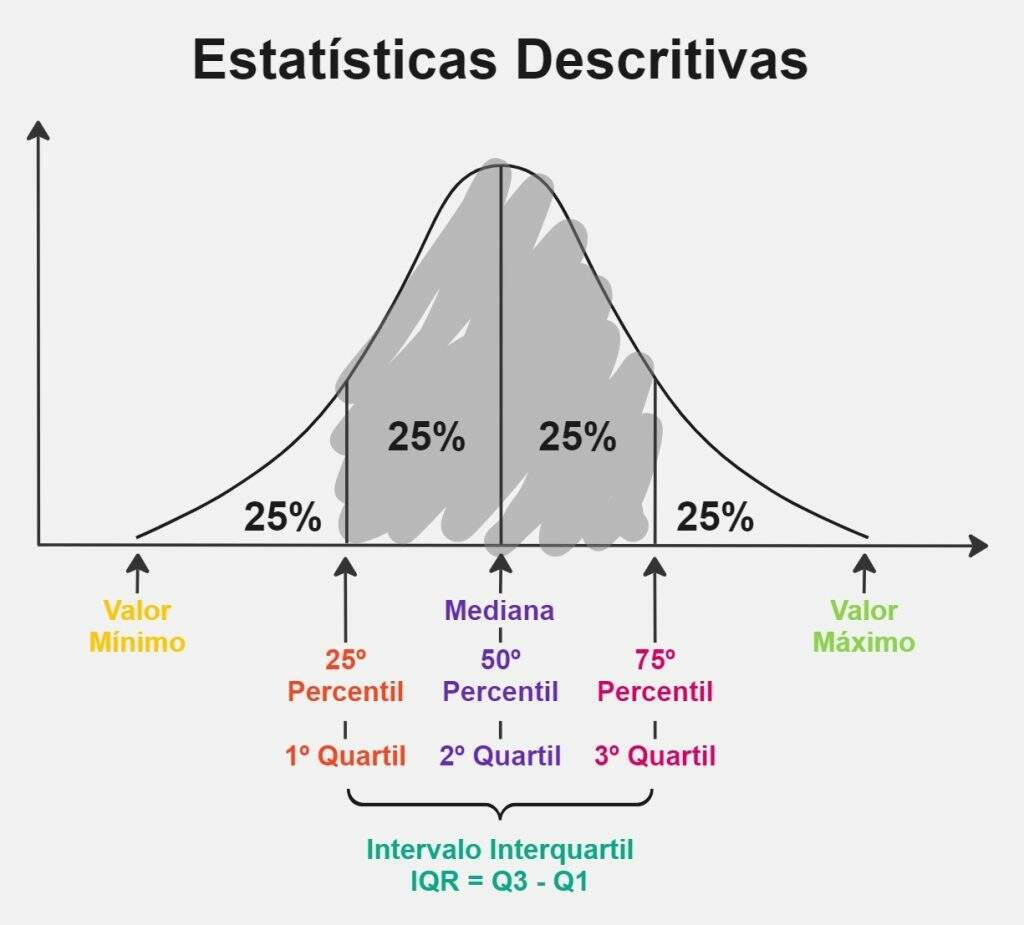
- Sumário de estatísticas: inclui valores mínimos e máximos, quartis e percentis, que fornecem uma visão abrangente do intervalo e distribuição do conjunto de dados.
- Análise de dados categóricos: estatísticas descritivas como moda e proporções são úteis para analisar variáveis categóricas e entender a prevalência ou distribuição de diferentes categorias.
Fórmulas e cálculos de estatísticas descritivas
As estatísticas descritivas fornecem ferramentas essenciais para analisar e resumir dados. Sendo assim, vamos entender de maneira um pouco mais formal as diversas estatísticas descritivas importantes, incluindo a média, mediana, mínimo, máximo, percentis, frequência, desvio padrão e variância. Compreender como calcular essas estatísticas é crucial para obter insights dos seus dados. Vamos detalhar cada uma delas:Média
A média representa o valor médio de um conjunto de dados e é calculada somando todos os valores e dividindo pelo número total de observações. Fórmula: X̄ = 1nnΣi=1Xi, onde Xi representa cada observação no conjunto de dados e n é o número total de observações.Mediana
A mediana representa o valor central de um conjunto de dados quando ordenado em ordem crescente ou decrescente. É útil para identificar a tendência central e é menos sensível a valores atípicos. Fórmula: ordene o conjunto de dados em ordem crescente ou decrescente e, em seguida, selecione o valor do meio.Mínimo
O mínimo é o menor valor em um conjunto de dados e fornece insights sobre o limite inferior dos dados. Fórmula: Xmin = min(X1, X2, …, Xn), onde Xi representa cada observação no conjunto de dados.Máximo
O máximo é o maior valor em um conjunto de dados e indica o limite superior dos dados. Fórmula: Xmax = max(X1, X2, …, Xn), onde Xi representa cada observação no conjunto de dados.Percentis
Os percentis dividem um conjunto de dados em partes iguais, indicando os valores abaixo dos quais uma certa porcentagem dos dados se encontra. Os percentis comuns incluem o 25º percentil (primeiro quartil), 50º percentil (mediana ou segundo quartil) e 75º percentil (terceiro quartil). Fórmula: há pelo menos 9 algoritmos diferentes para computar percentis, veja detalhes nesse link.Frequência
Frequência refere-se ao número de vezes que um determinado valor ocorre em um conjunto de dados. Ajuda a entender a distribuição e prevalência de valores específicos. Fórmula: contar as ocorrências de cada valor único no conjunto de dados.Desvio Padrão
O desvio padrão mede a dispersão ou variabilidade de um conjunto de dados. Quantifica o quanto os valores se desviam da média. Fórmula: σ = √1nnΣi=1(Xi − X̄)2, onde Xi representa cada observação no conjunto de dados, X̄ é a média e n é o número total de observações.Variância
A variância é o valor ao quadrado do desvio padrão e fornece uma medida do desvio médio ao quadrado em relação à média. Fórmula: σ2 = 1nnΣi=1(Xi − X̄)2, onde Xi representa cada observação no conjunto de dados e X̄ é a média. Saber como calcular essas estatísticas descritivas permite obter uma compreensão mais profunda dos seus dados. Ao aplicar essas fórmulas, você pode resumir o conjunto de dados, identificar tendências centrais, detectar valores atípicos, avaliar a variabilidade e explorar a distribuição dos seus dados. Esses cálculos fornecem insights valiosos que possibilitam a tomada de decisões informadas e uma análise de dados eficaz em várias áreas. Lembre-se de que estar familiarizado com esses cálculos capacita você a extrair informações significativas dos seus dados e chegar a conclusões precisas.📩 Onde a estatística vira decisão
O método que você acabou de ver não envelheceu: o que mudou foi o tempo que ele leva. No Boletim AM eu mostro, todo dia, estatística, econometria e IA aplicadas à economia, ao mercado financeiro e à análise de dados. Com dado real e sem enrolação.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.Como gerar um sumário de estatísticas descritivas?
Ter uma visão geral sobre os cálculos de estatísticas descritivas pode ajudar a não cometer análises errôneas. Na prática, porém, não é necessário decorar as fórmulas e algoritmos, pois as principais ferramentas e linguagens de programação existentes atualmente já trazem estes procedimentos prontos para aplicação. De toda forma, ferramentas são apenas ferramentas e só ganham utilidade se o usuário tiver um conhecimento de base estatística sólido para aplicação e uso adequado. A seguir mostramos a aplicação, usando linguagem de programação, de cálculos de estatísticas descritivas que são facilmente reportadas em um sumário, facilitando a análise e apresentação das características principais dos dados: Os códigos abaixo foram atualizados e leem um arquivo CSV público com os dados do Brasileirão Série A 2020. A versão original consultava a BaseDosDados via BigQuery, o que exigia uma conta do Google Cloud autenticada e deixava o exercício sem reprodução direta por quem lê.R
# Carregar pacotes
library(readr)        # leitura de arquivos CSV
library(dplyr)        # manipulação de dados
library(datawizard)   # sumário de estatísticas descritivas

# Coleta: partidas do Brasileirão Série A, direto de um CSV público
url <- paste0(
  "https://raw.githubusercontent.com/adaoduque/",
  "Brasileirao_Dataset/master/campeonato-brasileiro-full.csv"
)

tabela <- readr::read_csv(url, show_col_types = FALSE) |>   # baixa e lê o arquivo
  dplyr::filter(format(data, "%Y") == "2020")               # mantém a temporada 2020

# Estatísticas descritivas de todas as colunas numéricas
datawizard::describe_distribution(tabela)
Python
# Importar bibliotecas
import pandas as pd   # manipulação de dados

# Coleta: partidas do Brasileirão Série A, direto de um CSV público
url = (
    "https://raw.githubusercontent.com/adaoduque/"
    "Brasileirao_Dataset/master/campeonato-brasileiro-full.csv"
)

tabela = pd.read_csv(url, parse_dates=["data"], dayfirst=True)   # baixa e lê o arquivo
tabela = tabela[tabela["data"].dt.year == 2020]                  # mantém a temporada 2020

# Estatísticas descritivas de todas as colunas
tabela.describe(include="all").Tdescribe_distribution() do R traz assimetria e curtose junto das medidas usuais, enquanto o describe() do Python entrega contagem, valores únicos e os quartis. São recortes distintos do mesmo conjunto de medidas, e a escolha depende do que a análise pede.
O que o sumário revela
Rodando o código sobre a temporada 2020, algumas linhas do sumário chamam atenção e ilustram por que essa etapa vem antes de qualquer modelo:| Variável | Média | Desvio padrão | Mínimo | Máximo |
|---|---|---|---|---|
| Gols do mandante | 1,41 | 1,10 | 0 | 5 |
| Gols do visitante | 1,07 | 1,06 | 0 | 5 |
| Público presente | 0 | 0 | 0 | 0 |
| Chutes do mandante | 13,60 | 5,27 | 1 | 31 |
| Chutes do visitante | 11,48 | 4,41 | 1 | 31 |
Conclusão
Neste artigo entendemos sobre as principais estatísticas descritivas que analistas e cientistas de dados podem utilizar pra compreensão dos dados, permitindo análises e decisões mais informadas. Mostramos um pouco da base teórica de maneira didática e expomos a aplicação com um exemplo de conjunto de dados real.Da estatística descritiva ao modelo
Resumir os dados é o primeiro passo; o seguinte é modelar. O AM Black é a assinatura anual que dá acesso a todos os cursos da Análise Macro, em R e em Python, da estatística descritiva à econometria aplicada.