O processo gerador dos dados, ou PGD, é o mecanismo que produziu os números que temos em mãos. Toda análise estatística supõe alguma coisa sobre esse mecanismo, mesmo quando a suposição nunca é escrita.
A pergunta que o conceito responde é direta: de onde vieram estes dados, e o que podemos afirmar a partir deles? Um intervalo de confiança, um p-valor e uma previsão só têm significado dentro de uma hipótese sobre o processo que gerou a amostra.
Quando essa hipótese está errada, nada no software indica o problema. O código roda, a tabela sai formatada, e o erro aparece só adiante, quando as previsões falham ou o risco estimado se mostra menor que o real.
Neste artigo explicamos o que é o PGD, por que ele sustenta as conclusões de qualquer modelo e como investigar, no Python, qual distribuição de probabilidade descreve uma variável. O exercício simulado serve de ilustração: ele testa as ferramentas num caso em que a resposta certa é conhecida.
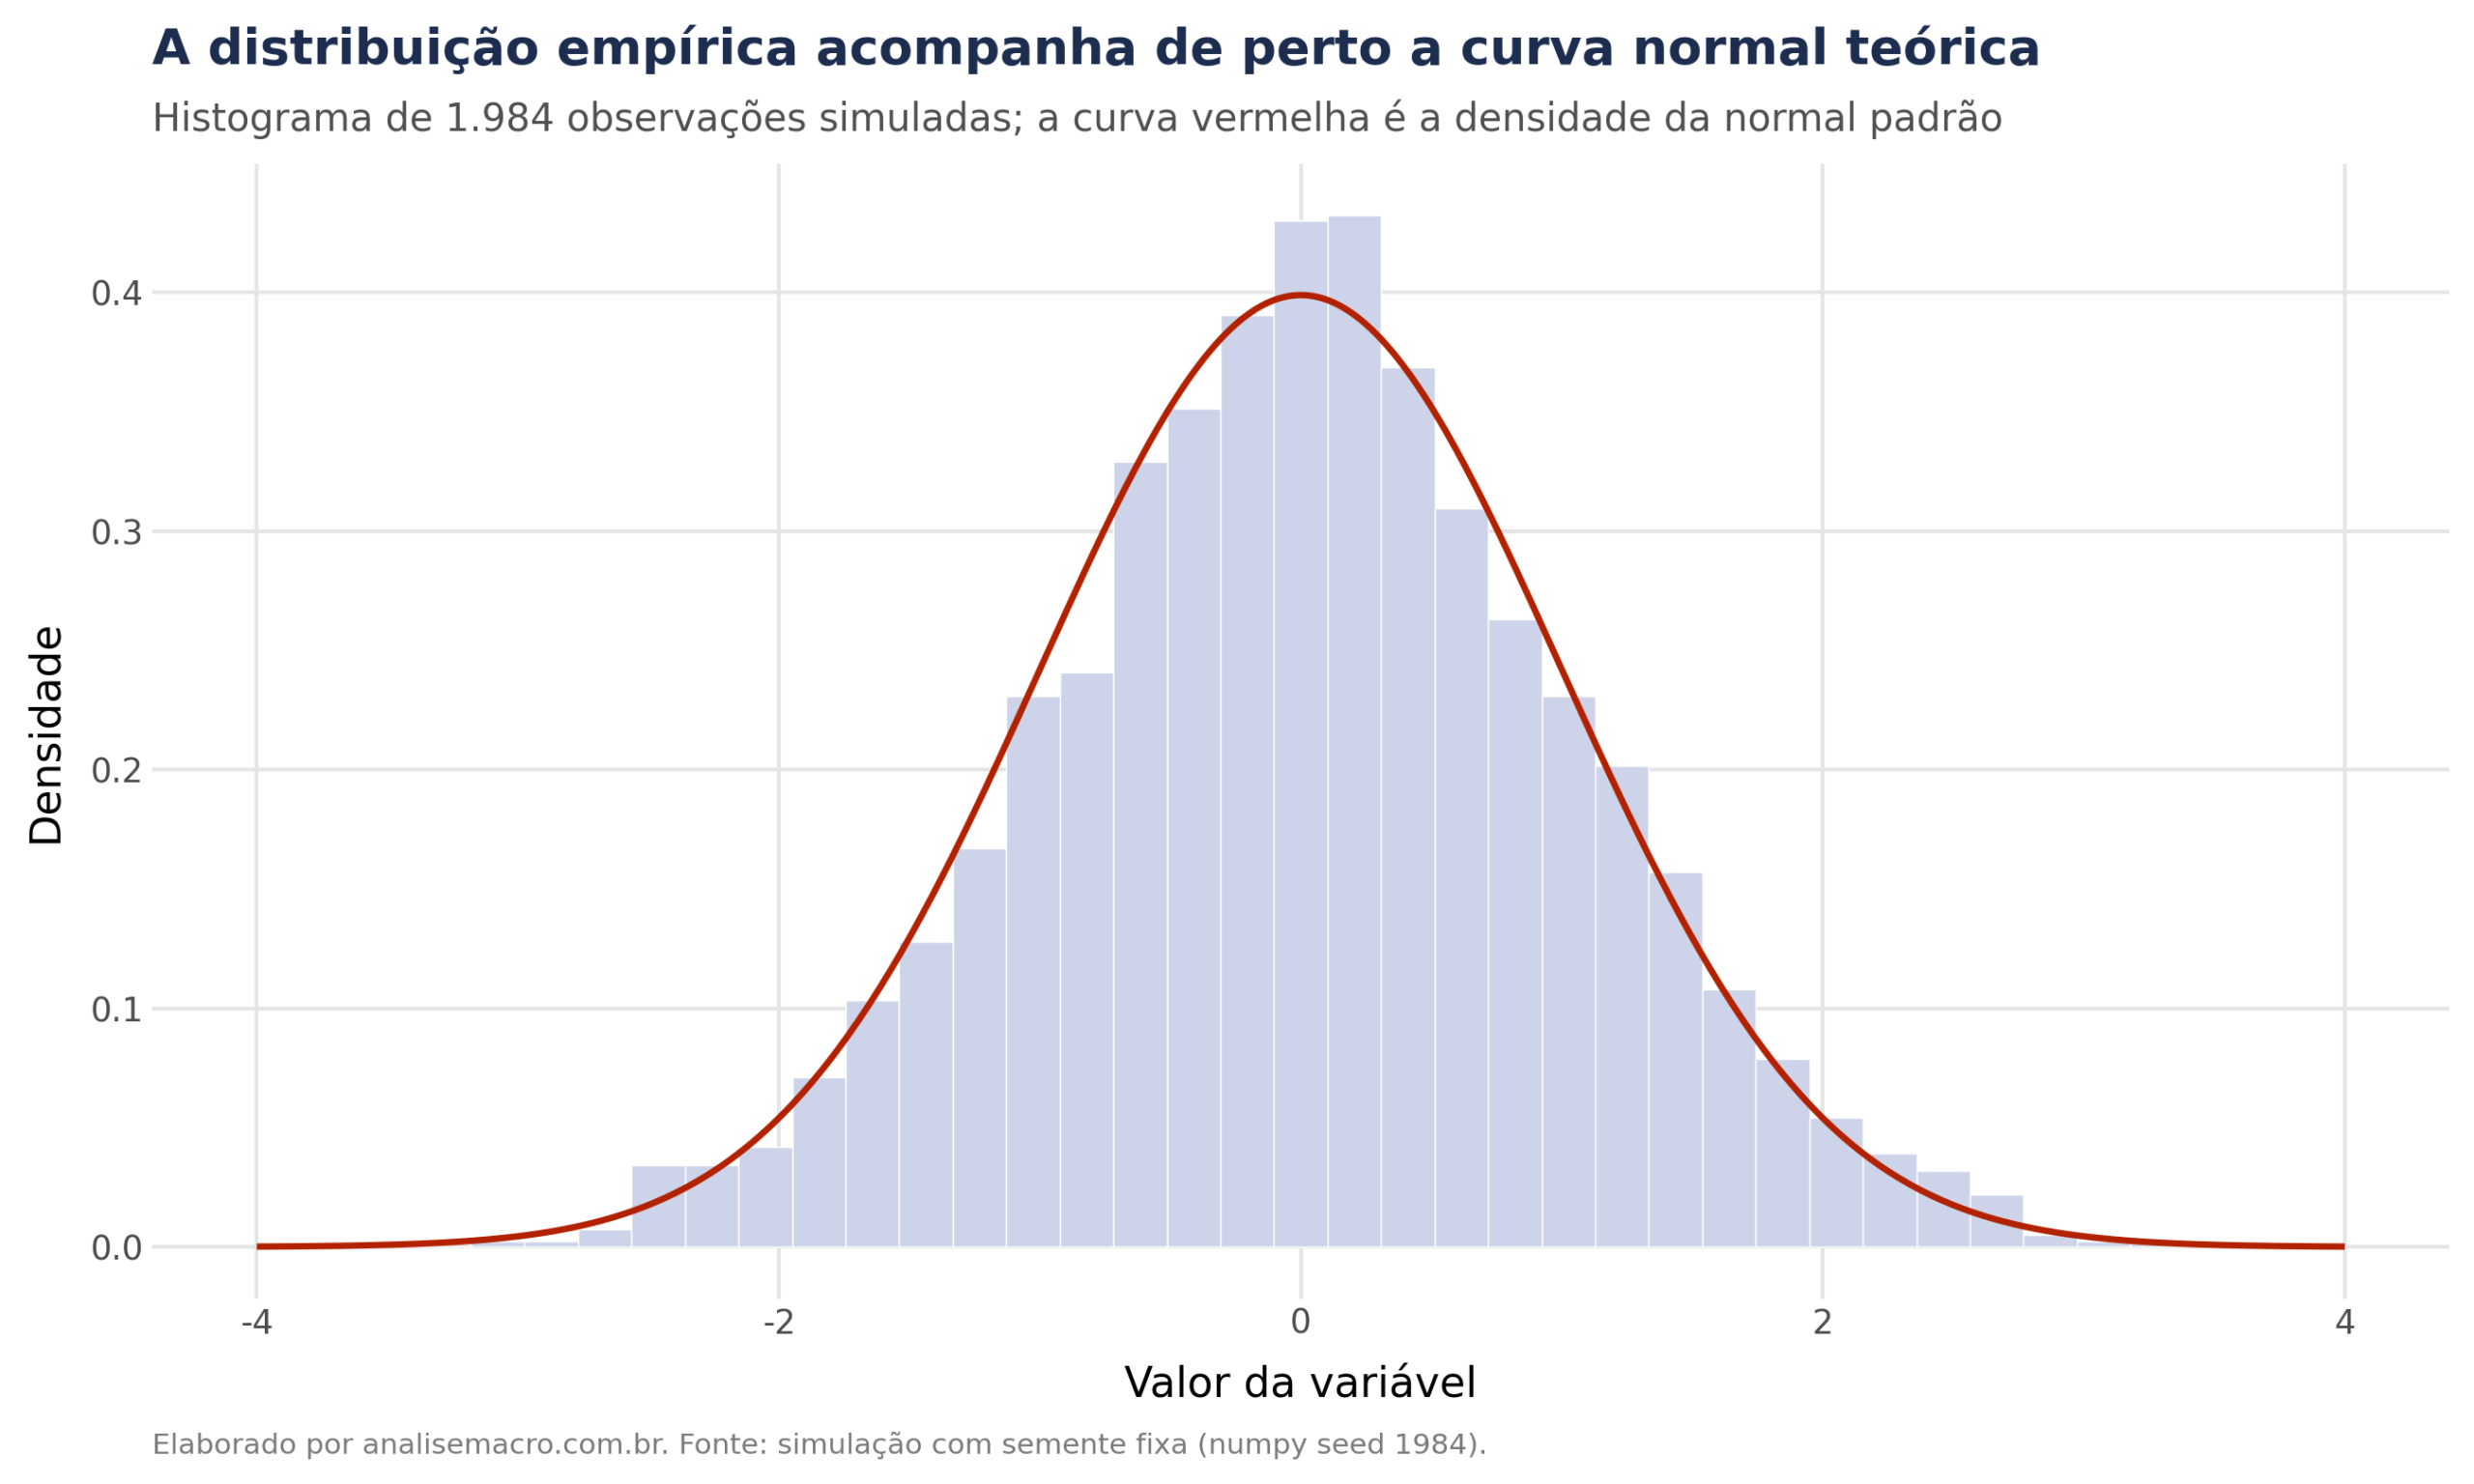
Para testar se essas ferramentas funcionam, precisamos de um caso em que a resposta seja conhecida de antemão. Por isso o exercício sorteia uma variável de uma distribuição normal com semente fixa: sabemos qual é o PGD porque fomos nós que o definimos.
Gerar dados a partir de um mecanismo que nós mesmos definimos é o procedimento da simulação de Monte Carlo, aqui usado para avaliar as ferramentas de identificação.
Com dados reais esse teste seria impossível, já que não há gabarito contra o qual comparar o resultado. O cenário simulado mede a qualidade do método, e não a da variável.
Código do exercício
O código com a identificação da distribuição que descreve seus dados, com a comparação entre candidatas está disponível em:
O que é o processo gerador dos dados
O processo gerador dos dados é o mecanismo do mundo real que produziu as observações que temos em mãos. Ele existe antes e independentemente da nossa análise: a tabela que abrimos é o resultado dele, não o processo em si.
Uma comparação torna a distinção concreta. Ao medir a altura de mil pessoas, obtemos mil números; o PGD é o conjunto de fatores que produziu essas alturas, da genética à nutrição na infância. Os números são o efeito observável, e o mecanismo que os gerou permanece fora da planilha.
Esse mecanismo tem duas partes. A parte sistemática reúne o que empurra a variável de forma regular, como a renda que sobe com a escolaridade. A parte aleatória reúne tudo que varia caso a caso e que não conseguimos antecipar, e é ela que faz duas pessoas com a mesma escolaridade ganharem valores diferentes.
A distribuição de probabilidade entra como a descrição dessa segunda parte. Ela responde quais valores a variável pode assumir e com que frequência esperamos cada um, e é a peça do PGD que conseguimos estimar a partir de uma amostra.
O PGD pode ser de naturezas bem diferentes. Um processo físico gera a temperatura registrada por um sensor, com erro de medição em torno do valor real. Um processo comportamental gera as decisões de compra de milhares de consumidores, cada uma com sua motivação. Um processo institucional gera um índice de preços, em que a regra de cálculo e a cesta de bens definem o número publicado.
A natureza do processo antecipa o formato esperado. Erros de medição em torno de um valor central costumam produzir uma distribuição simétrica; decisões de compra que dependem de renda produzem distribuições assimétricas, com poucos valores muito altos.
Por que o conceito decide o resto da análise
Todo modelo estatístico é uma hipótese sobre o PGD. Quando estimamos uma regressão e reportamos o p-valor de um coeficiente, esse número foi calculado supondo uma distribuição para os erros. A suposição não aparece na saída do software, mas sustenta tudo que ela informa.
A suposição fica invisível justamente por estar embutida no cálculo. Os asteriscos de significância continuam aparecendo quando ela está errada, porque o que muda é o limiar usado para decidi-los, e esse valor não é impresso na tabela.
Os modelos de risco de mercado dão o caso mais conhecido. Ao supor retornos normais, eles atribuem probabilidade desprezível a quedas diárias acima de cinco por cento, que nas bolsas ocorrem com frequência bem maior. O sistema roda todos os dias e reporta um risco menor do que o real, sem sinal algum de falha.
O conceito também delimita o alcance das conclusões. Uma previsão para valores fora da faixa observada só se sustenta se soubermos que o mecanismo continua o mesmo ali, e é o PGD que responde por essa continuidade.
Por que nunca conhecemos o PGD por completo
Observamos uma amostra, e não a população inteira. Mil alturas medidas descrevem aquelas mil pessoas, e qualquer afirmação sobre a população depende de supor que a amostra representa o todo.
O mecanismo real também envolve fatores que não medimos. A renda de uma pessoa depende de escolaridade e experiência, que costumam estar na base, mas também de rede de contatos e de sorte, que não estão.
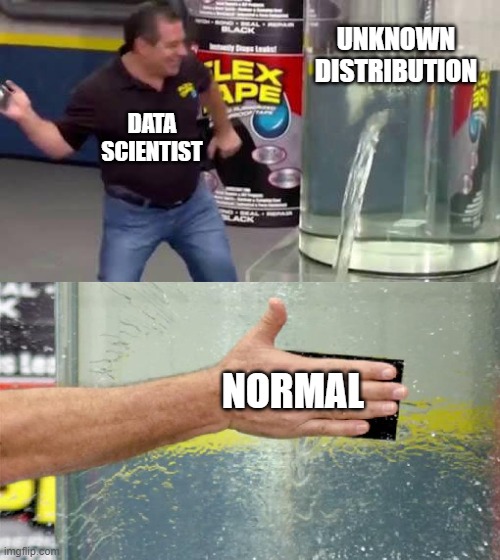
O trabalho prático, portanto, é aproximar: escolher uma distribuição candidata e verificar se o comportamento observado nos dados é compatível com ela. A pergunta deixa de ser qual é o PGD verdadeiro e passa a ser qual candidata descreve os dados bem o suficiente para o uso pretendido.
Em parte dos casos, a teoria já sugere a candidata. Somas de muitos efeitos pequenos e independentes tendem à normal, pelo Teorema Central do Limite. Contagens de eventos raros num intervalo tendem à Poisson. Tempos de espera entre eventos tendem à exponencial.
Quando a teoria não indica nada, a investigação começa nos próprios dados, e é esse caminho que o restante do texto percorre.
As quatro ferramentas de identificação
📊
📦
📐
🧪
Cada instrumento responde a uma pergunta diferente. O histograma e o boxplot descrevem o formato da distribuição observada, mostrando onde os valores se concentram e para que lado ela pende. O gráfico Q-Q confronta esse formato com uma candidata específica, ponto a ponto ao longo de toda a distribuição.
As famílias mais comuns em dados econômicos, e o que o formato de cada uma revela sobre o fenômeno, estão reunidas em distribuições de probabilidade em dados: como identificar a sua.
Os testes formais fecham com um número: a probabilidade de observar uma amostra como a nossa se a candidata fosse verdadeira. Eles quantificam o que os gráficos mostram, e por isso a prática combina os dois em vez de escolher um.
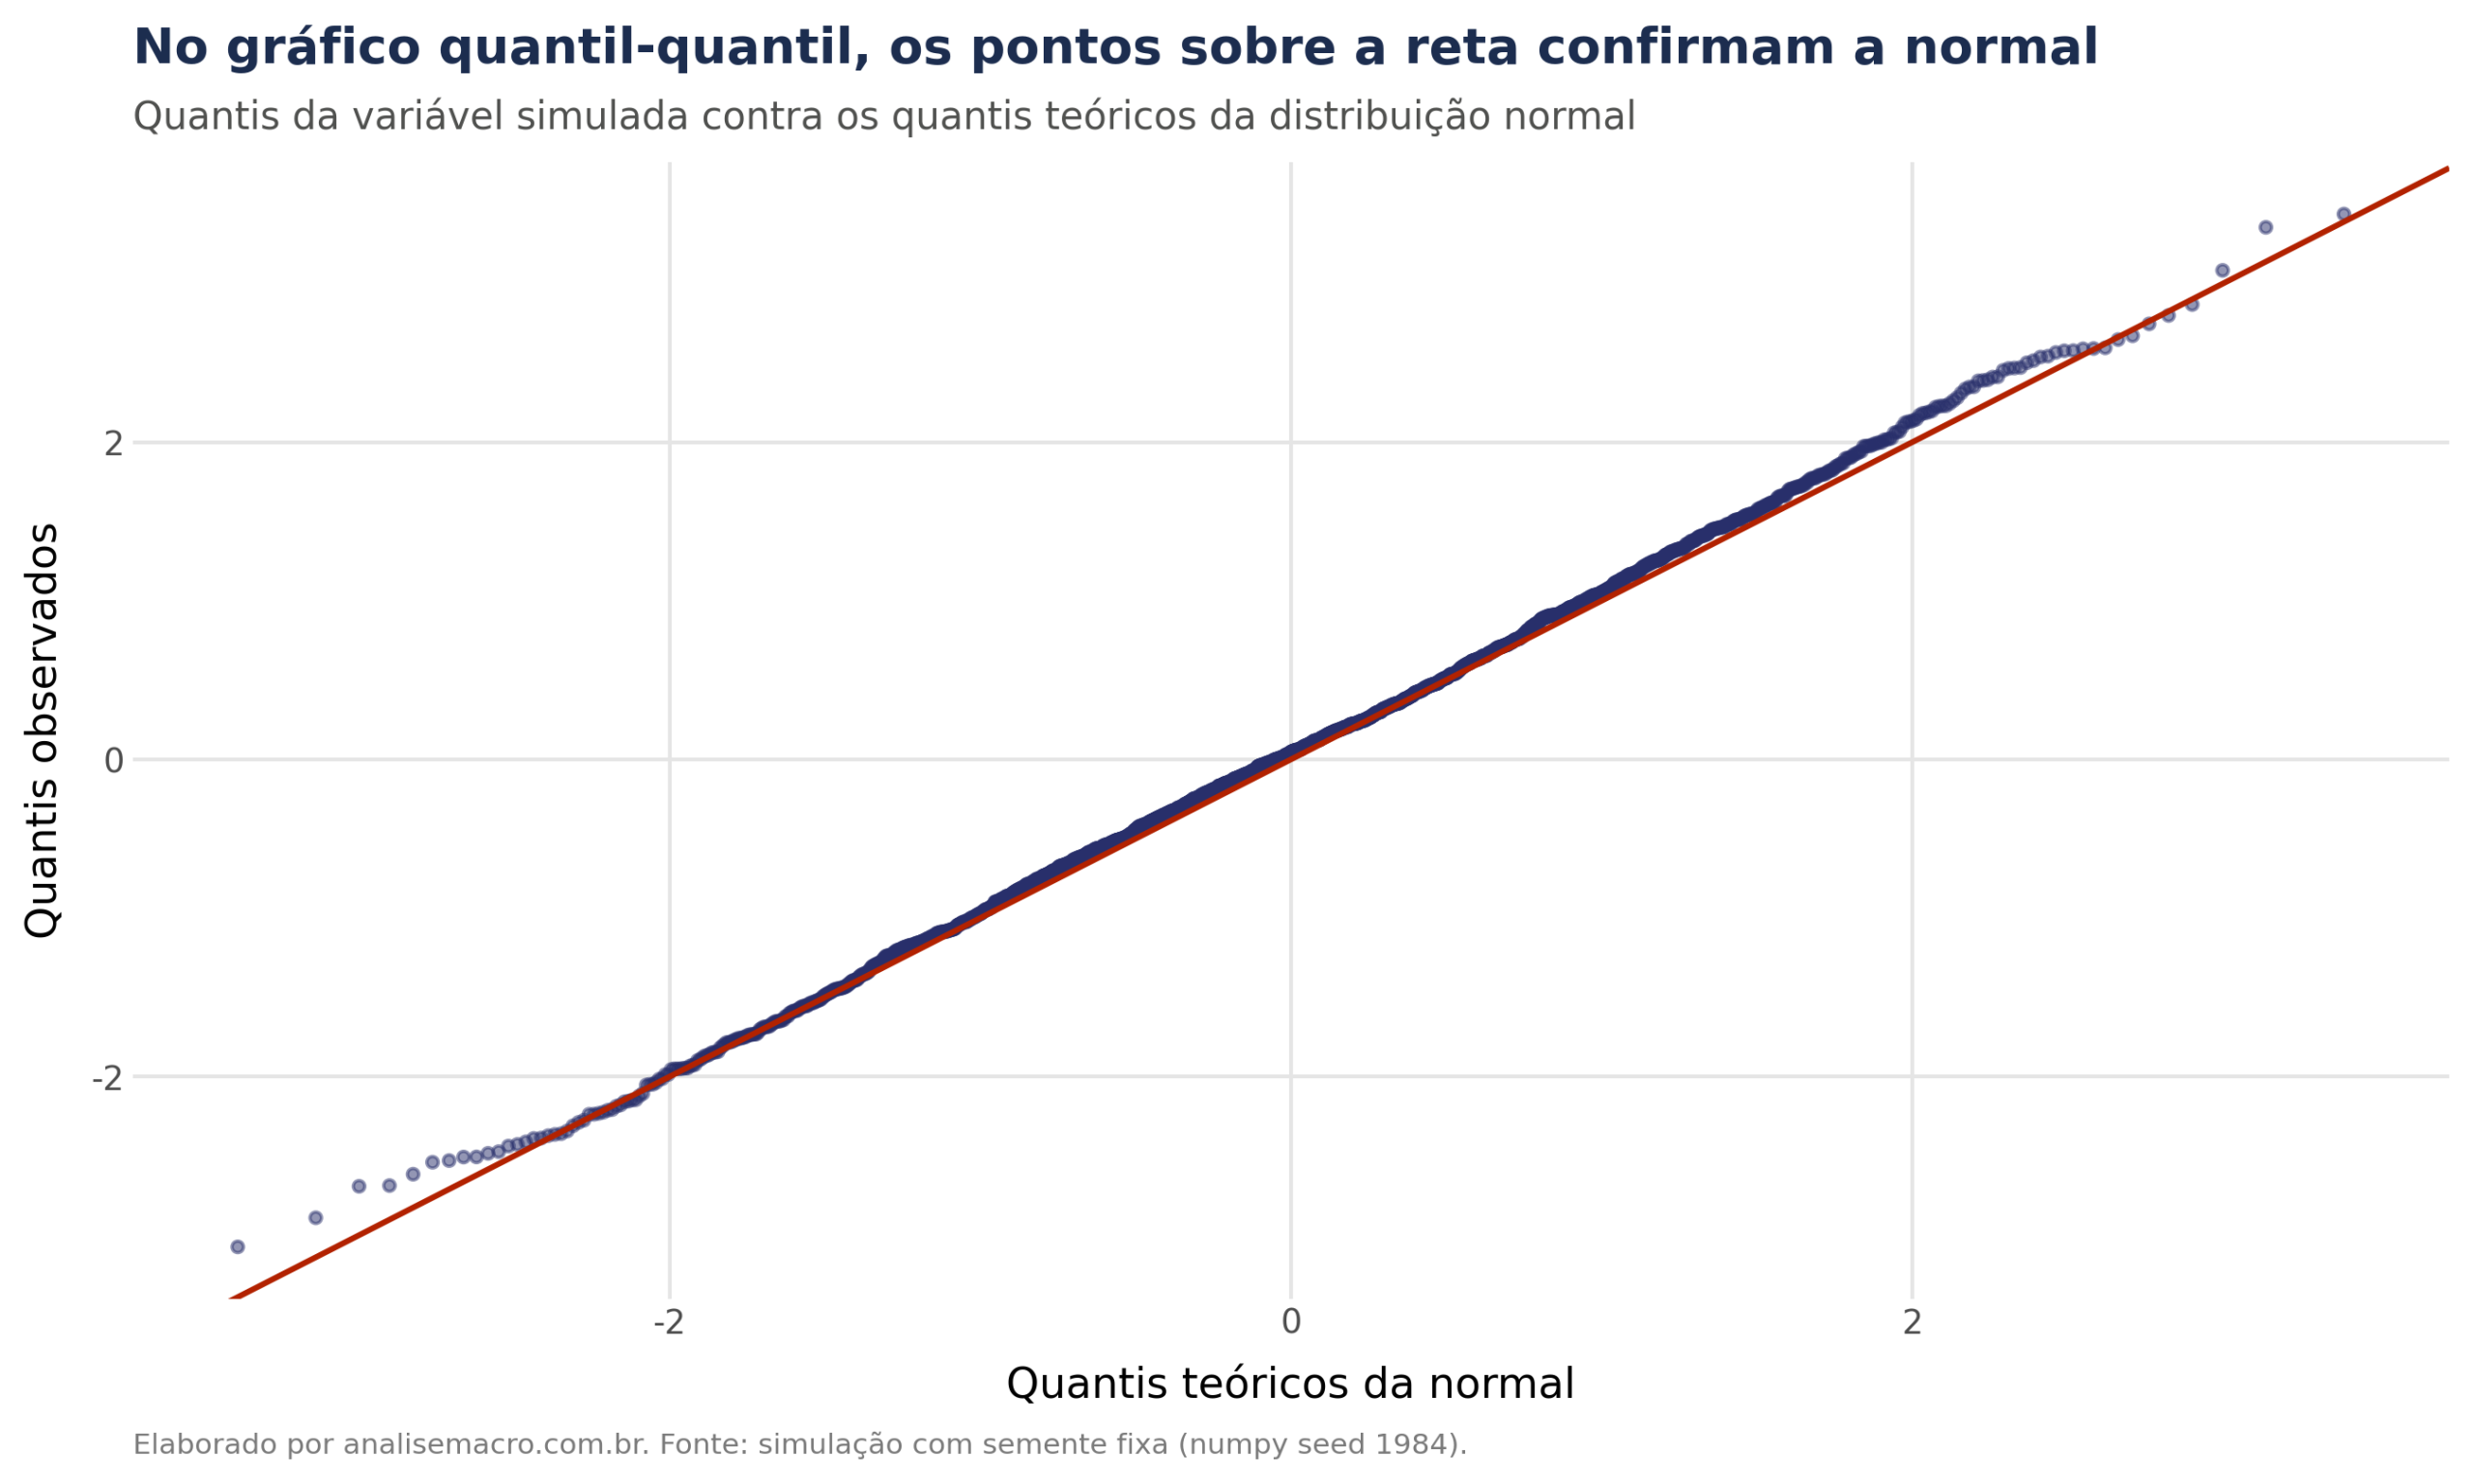
No gráfico quantil-quantil da variável simulada, os pontos acompanham a reta do começo ao fim, com desvios pequenos apenas nas caudas, onde há poucas observações e alguma oscilação é esperada.
A busca automática com o distfit
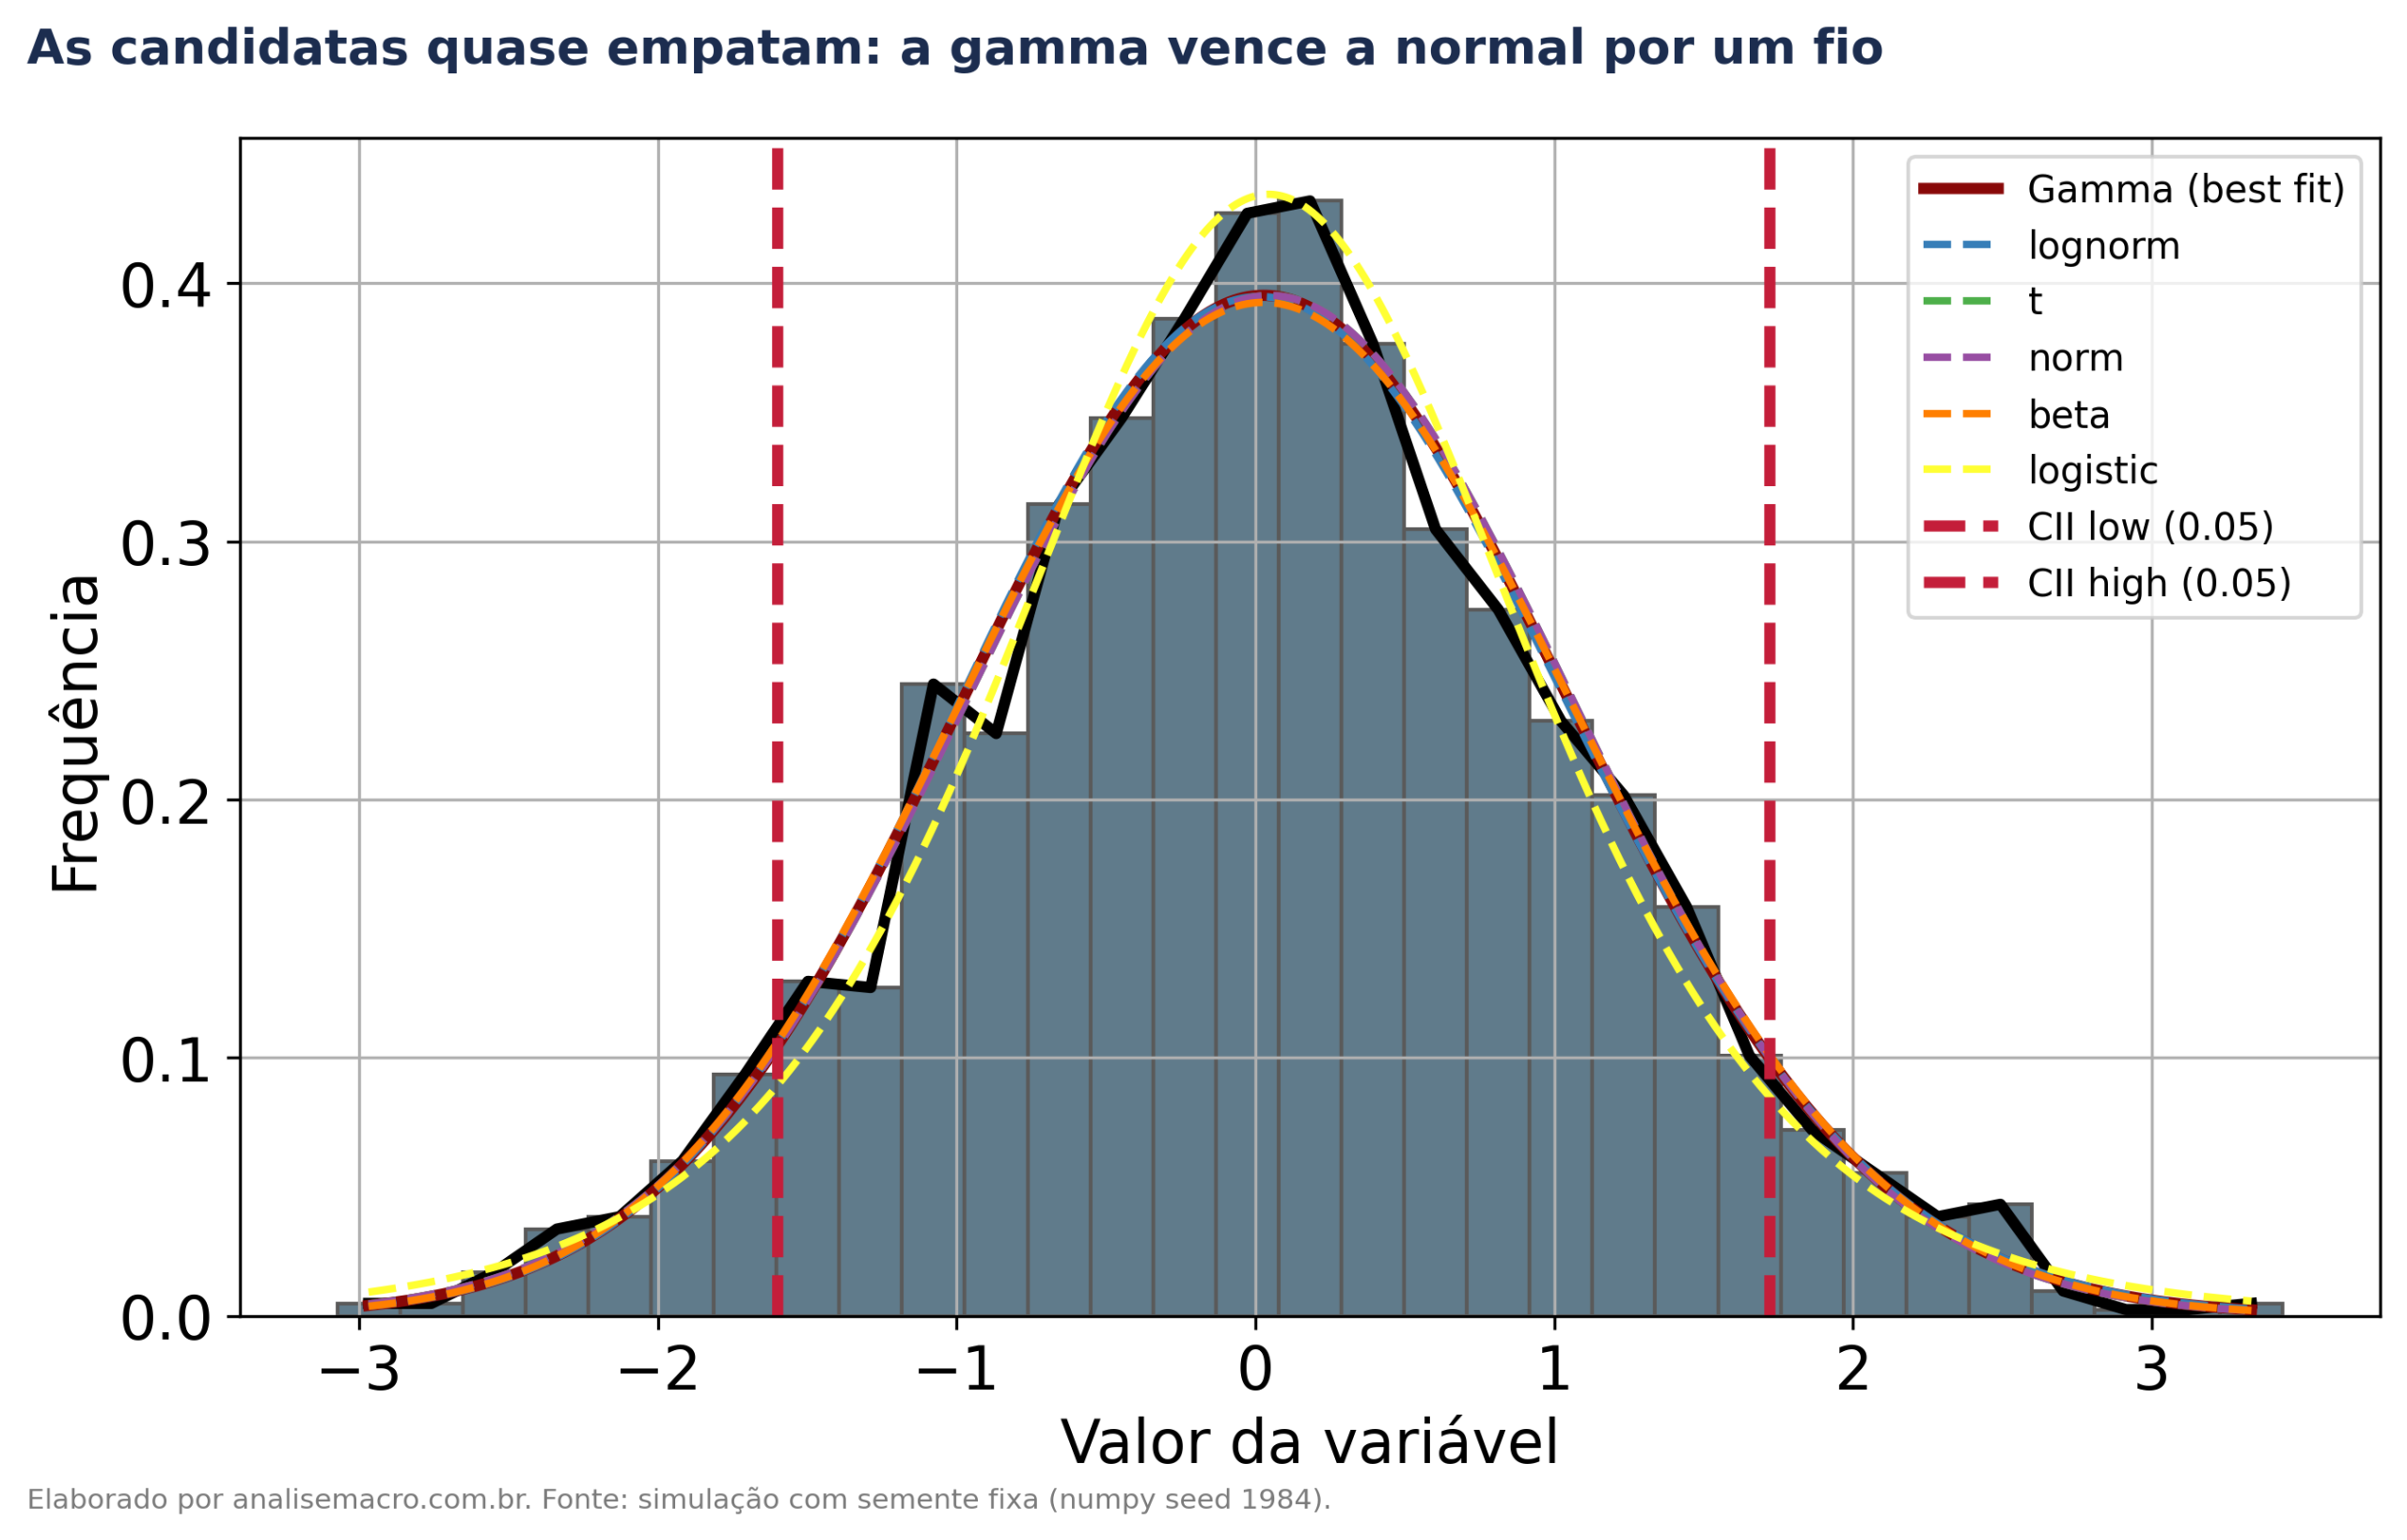
A biblioteca distfit ajusta dezenas de candidatas por máxima verossimilhança e as ordena pela qualidade do ajuste. No exercício, a gamma aparece em primeiro lugar e a normal, que é o PGD verdadeiro, em quarto, com escores praticamente idênticos.
O empate tem explicação: com parâmetro de forma muito alto, a gamma imita uma normal quase perfeitamente, e o acaso da amostra decide o ranking por diferenças em casas decimais distantes. Quando os escores empatam assim, a decisão passa a ser da parcimônia e do conhecimento do fenômeno, e não da métrica.
A comparação formal entre candidatas
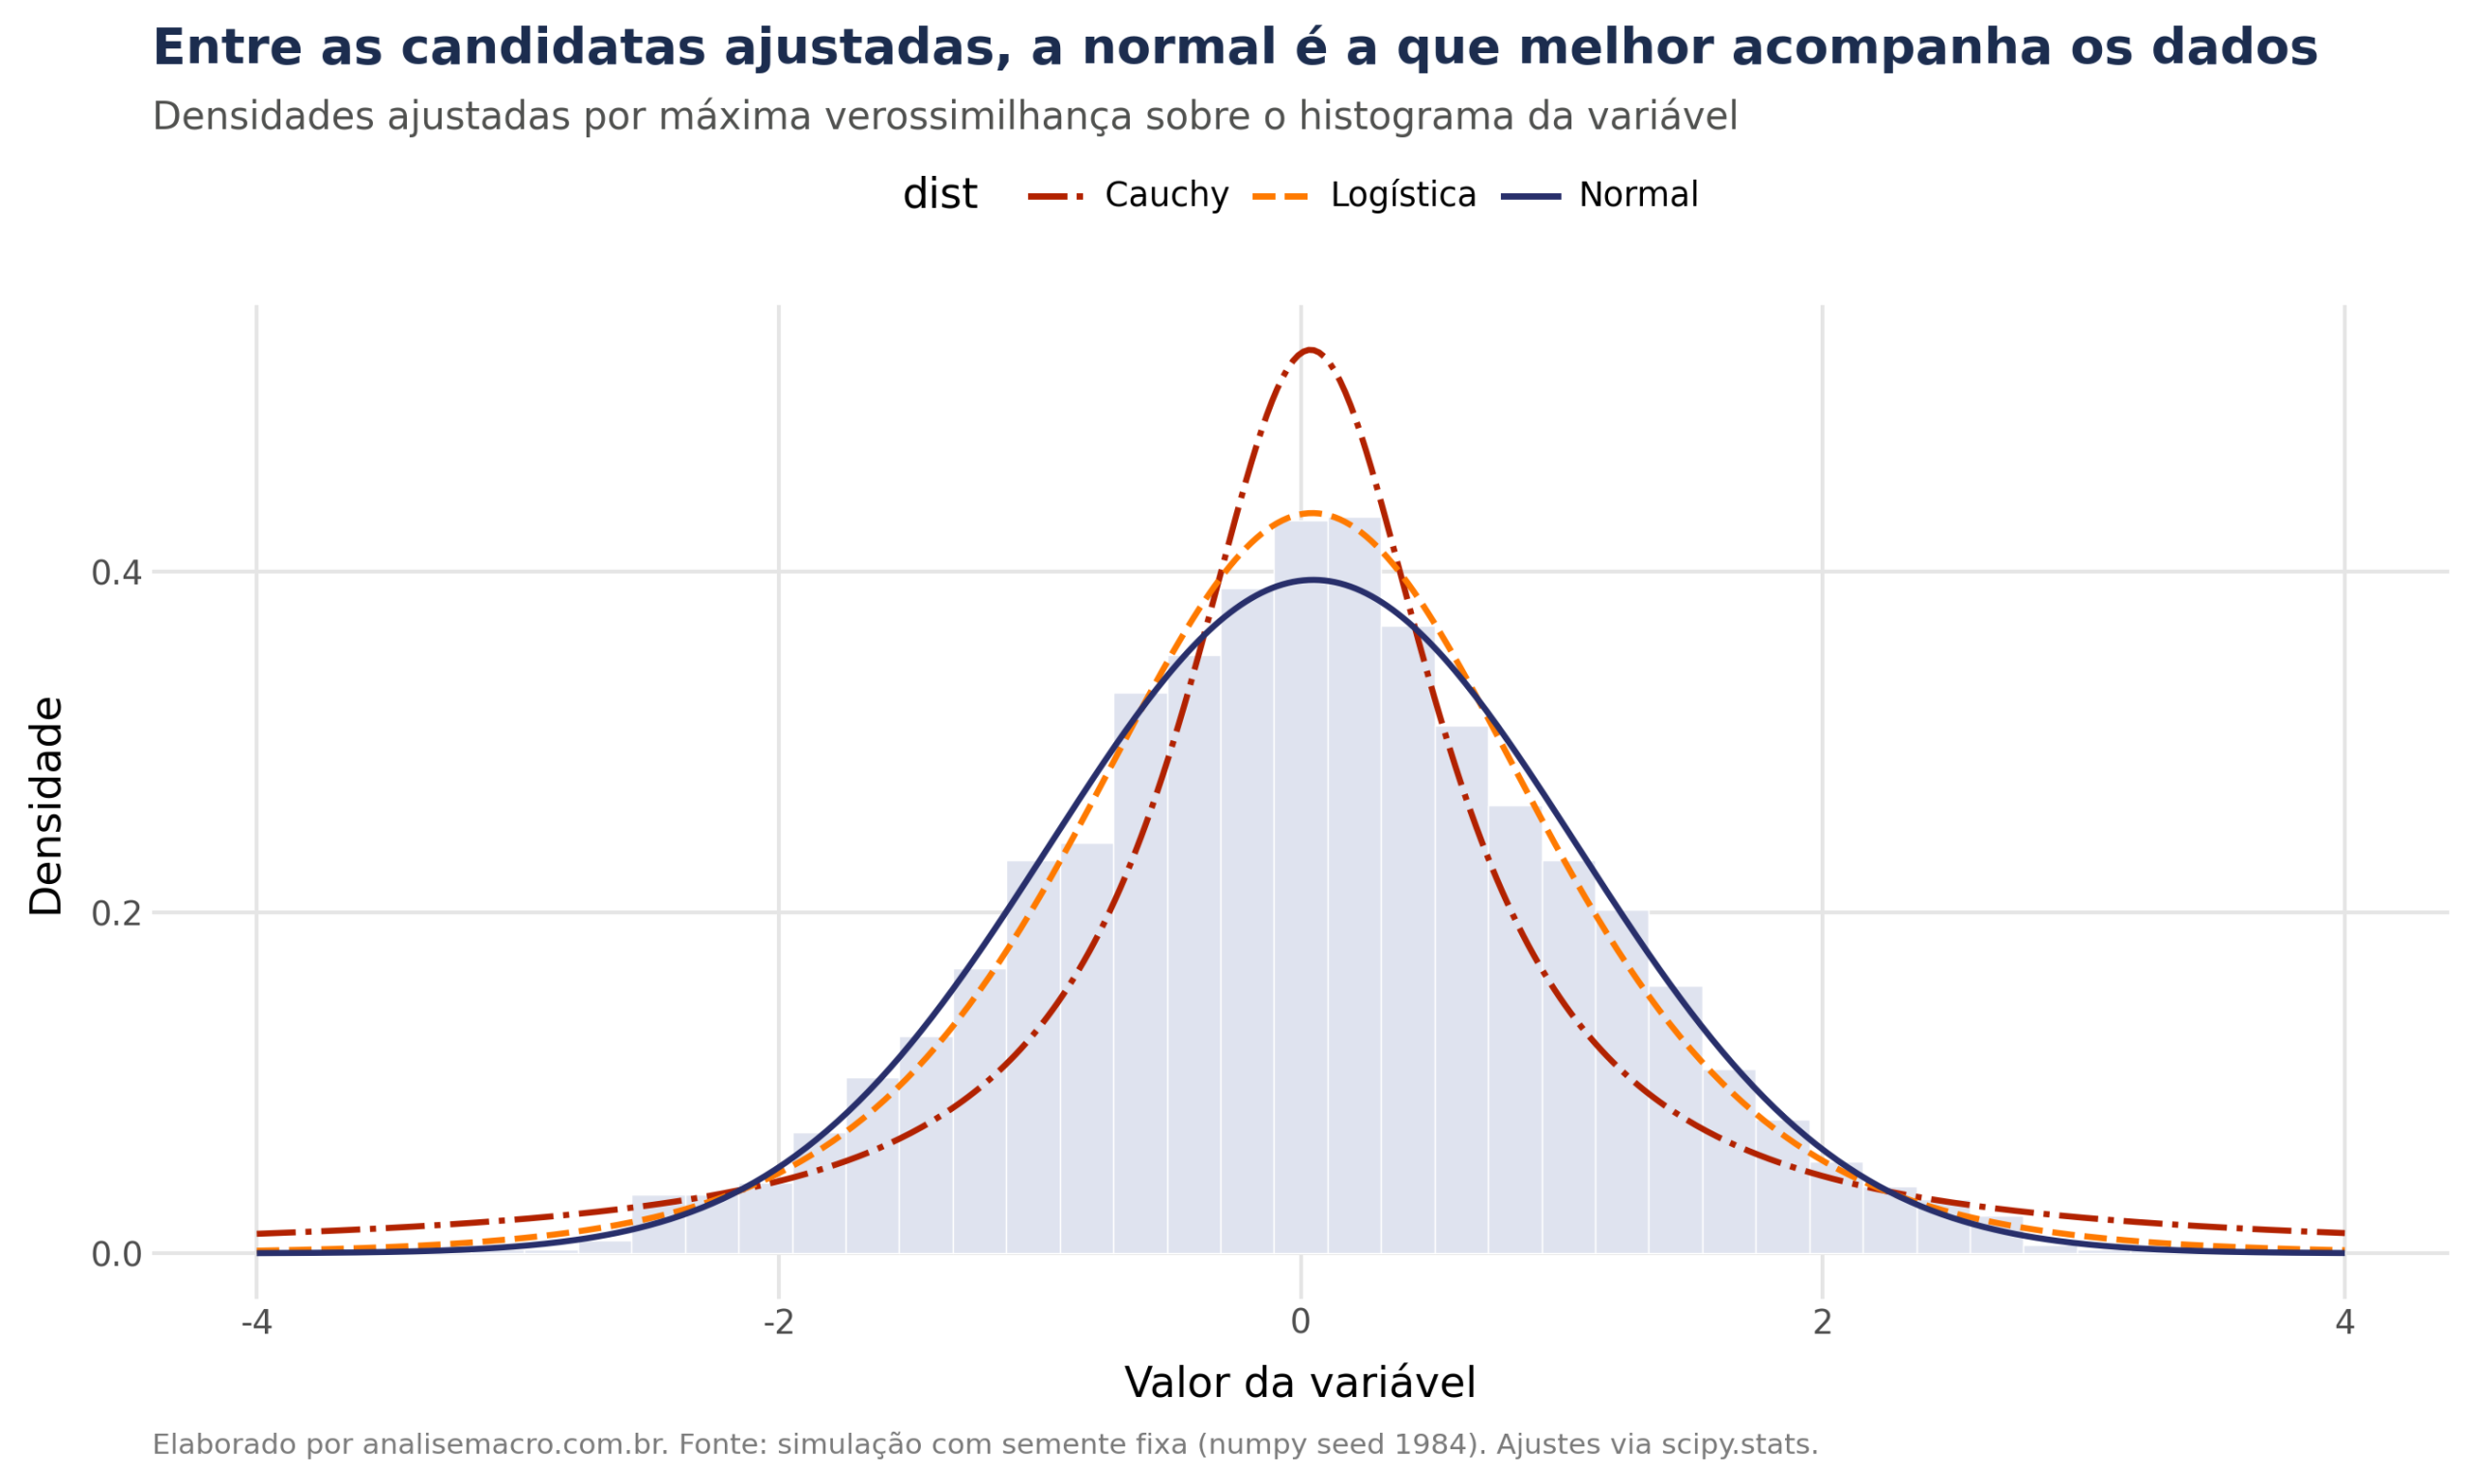
O passo final ajusta cada candidata por máxima verossimilhança e compara pelo AIC, critério que penaliza o ajuste obtido pelo número de parâmetros usados, e em que o menor valor indica o melhor ajuste:
| Distribuição | AIC |
|---|---|
| Normal | 5.636 |
| Logística | 5.669 |
| Cauchy | 6.346 |
A normal vence com folga sobre a Cauchy, de caudas muito pesadas, e com margem clara sobre a logística, de formato parecido. O método reencontrou a distribuição que gerou os dados, que era o resultado esperado do teste.
O que o resultado revela
- A investigação reencontrou o PGD conhecido. Histograma, Q-Q e comparação formal convergiram para a normal que gerou os dados, e é essa validação que autoriza usar as mesmas ferramentas em dados reais.
- Métricas de ajuste podem empatar. Distribuições flexíveis imitam a normal com parâmetros extremos, e nessa faixa o ranking por escore depende do acaso da amostra. Parcimônia e teoria desempatam.
- Nem todo método exige acertar a distribuição. Árvores de decisão e redes neurais aprendem sem suposições distribucionais explícitas, mas conhecer o PGD segue orientando transformações e leitura de erros.
- Reprodutibilidade começa na semente. Sem semente fixa, cada execução produz números diferentes dos publicados.
Veja o exercício rodando em vídeo
A aula abaixo percorre as mesmas etapas descritas acima, com o código rodando na tela.
O conceito fora do exercício
O caso simulado tinha resposta conhecida, o que permitiu avaliar os métodos. Em dados reais não existe esse gabarito, e o que orienta a escolha da candidata passa a ser o conhecimento do fenômeno.
Nos retornos de um ativo financeiro, o mecanismo reúne decisões de milhares de investidores reagindo a notícias. O resultado tem caudas mais pesadas que a normal, porque dias de pânico concentram variações que uma distribuição simétrica trata como quase impossíveis.
Na renda das famílias, o mecanismo combina escolaridade, ocupação e herança, fatores que se multiplicam em vez de se somar. A distribuição resultante é assimétrica à direita, e supor simetria desloca a média para uma região onde há poucos domicílios. Nesses casos, a mediana descreve melhor o caso típico do que a média, argumento que desenvolvemos em estatísticas robustas: mediana, IQR e MAD.
Em dados de contagem, como o número de sinistros de uma seguradora em um mês, o mecanismo produz apenas valores inteiros e não negativos. Uma distribuição contínua atribuiria probabilidade a meio sinistro e a valores negativos, ambos impossíveis no fenômeno.
O padrão que se repete nos três casos é o mesmo: a natureza do mecanismo restringe os formatos plausíveis antes de qualquer teste. Conhecer o fenômeno reduz a lista de candidatas, e os dados decidem entre as que sobraram.
Como a suposição entra nos modelos que já usamos
Numa regressão linear, a suposição recai sobre os erros, e não sobre a variável dependente. É dela que saem os erros padrão, os p-valores e os intervalos de confiança reportados na saída.
Num teste de hipótese, a distribuição de referência sob a hipótese nula define o valor a partir do qual rejeitamos, como no teste qui-quadrado em tabelas de contingência. Trocar a distribuição de referência muda o limiar e pode inverter a conclusão sobre o mesmo dado.
Numa simulação de cenários, a distribuição de entrada determina a largura do resultado. Supor normalidade onde há cauda pesada produz um intervalo estreito demais, e o cenário adverso sai mais brando do que deveria. Atribuir uma distribuição a cada variável de entrada, em vez de três cenários fixos, é o que fazemos em simulação de cenários com distribuição de probabilidades.
Considerações finais
O PGD é a regra por trás dos números, e aproximá-lo bem é condição para inferências e previsões válidas. O exercício mostra o caminho completo no Python: os gráficos para o formato, a varredura automática do distfit e a comparação por AIC para a decisão formal.
- Analistas de dados: verificar a distribuição antes de modelar evita intervalos de confiança inválidos e previsões com viés.
- Economistas: retornos, rendas e durações raramente são normais, e a escolha da distribuição muda a política estimada.
- Profissionais de mercado financeiro: subestimar caudas pesadas é subestimar risco, porque a diferença entre a normal e uma t de Student aparece exatamente nos eventos extremos.
- Pesquisadores e estudantes: a suposição distribucional é premissa de quase todo teste estatístico, e explicitá-la fortalece o trabalho.
Em todas elas o passo é o mesmo: identificar a distribuição que descreve os dados antes de escolher o modelo que os usa.
Você viu o alicerce; aprenda o método completo
Do processo gerador dos dados à modelagem de dados econômicos e financeiros, com Python aplicado a dados reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Leia também: