
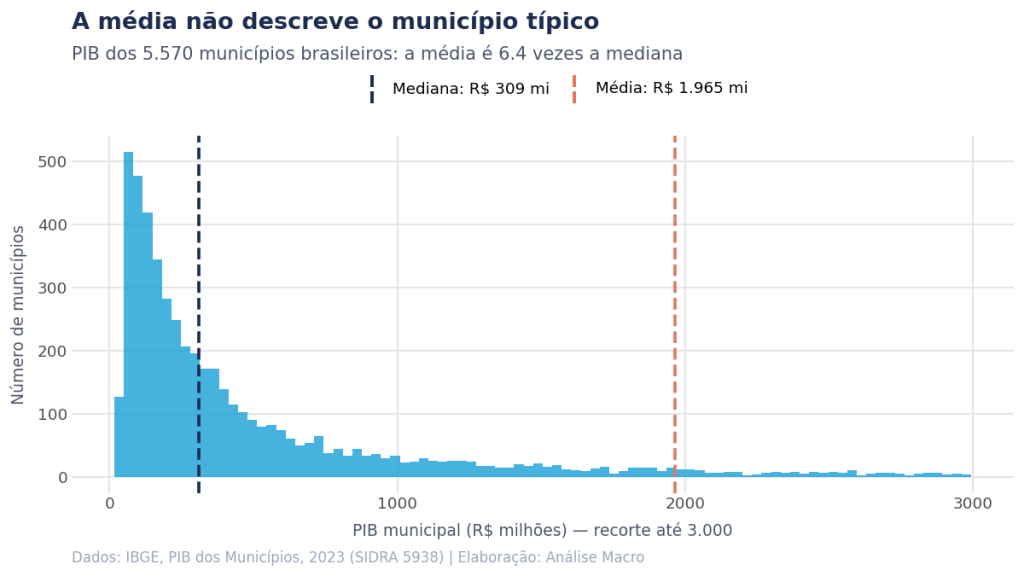
Quando calculamos a média do PIB dos municípios brasileiros, a grande maioria dos municípios fica abaixo dela, mesmo com o cálculo correto. Uma média que fica acima de quase todos os casos que deveria resumir deixa de representar o município típico. Neste exercício, vamos mostrar por que isso acontece e quais medidas usar nessas situações.
Média, mediana e desvio-padrão são as medidas que abrem qualquer sumário de estatísticas descritivas.
A média é a medida de centro mais usada, e na maior parte das situações ela funciona bem. Seu cálculo soma todos os valores e divide pelo número de observações, o que significa que cada observação entra na soma com o seu valor integral, por maior que ele seja.
Num conjunto de municípios, São Paulo entra na soma uma única vez, como uma cidade de mil habitantes, mas com um PIB milhares de vezes maior. Por isso, o valor paulistano sozinho desloca o resultado.
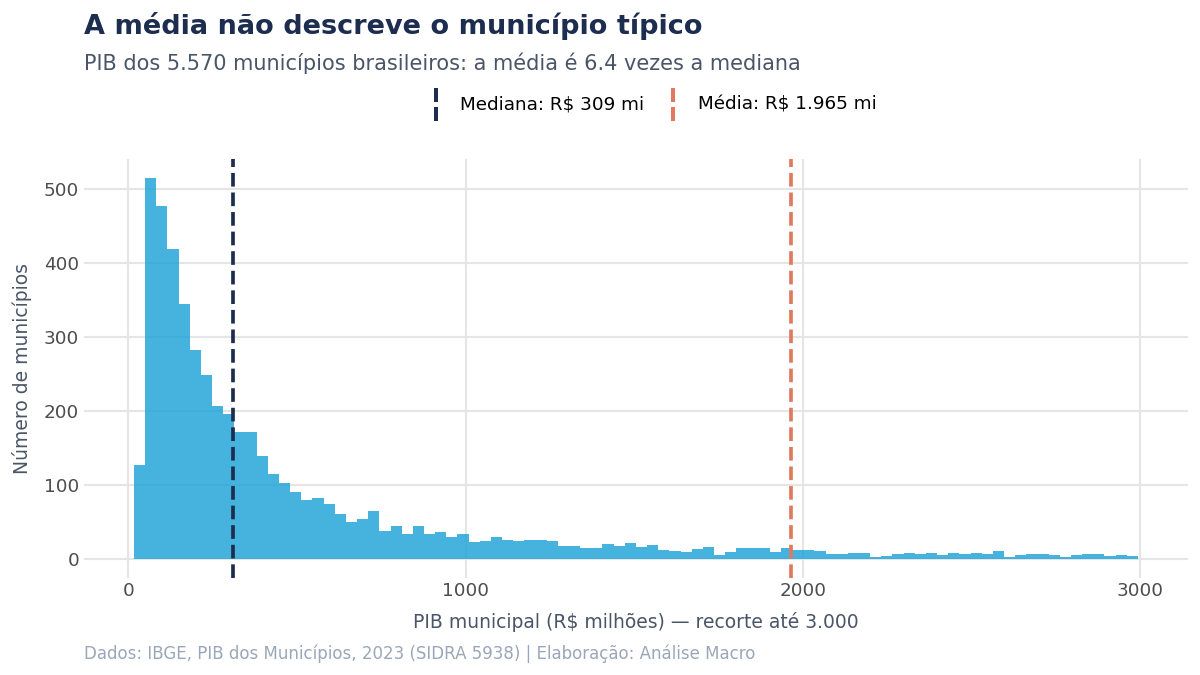
No gráfico acima, cada barra mostra quantos municípios têm PIB dentro de uma faixa, e duas linhas verticais marcam as medidas de centro. Uma marca a média; a outra marca a mediana, que é o valor que ocupa a posição central quando ordenamos todos os municípios do menor para o maior PIB: metade fica abaixo dela, metade acima.
A mediana descreve melhor o município típico, porque cai dentro da faixa onde as barras se concentram, ou seja, onde está a maioria dos municípios. A média cai mais à direita, numa região em que quase não há barras.
Receba as próximas análises no seu e-mail
Estatísticas robustas, valores extremos e leitura crítica de dados aparecem toda semana nas análises do Boletim AM. A assinatura é gratuita e chega direto no seu e-mail.
Por que a maioria fica abaixo da média
A explicação está no formato da distribuição. Quando os dados são assimétricos, com muitos casos pequenos e poucos casos muito grandes, a média é puxada na direção da cauda longa.
O PIB municipal segue de perto uma distribuição de cauda longa, formato que o catálogo de distribuições de probabilidade em dados descreve em detalhe.
A mediana resiste a esse efeito porque seu cálculo usa apenas a ordem dos valores, sem considerar a magnitude de cada um. Se o PIB de São Paulo dobrasse amanhã, ele continuaria sendo o último da fila ordenada, e a posição central permaneceria a mesma. Já a média mudaria, porque o valor novo entraria inteiro na soma.
Por isso, a diferença entre média e mediana funciona como um diagnóstico de assimetria: quanto mais distantes uma da outra, mais assimétrica é a distribuição.
O teste de sensibilidade
Para medir o quanto cada medida se deixa influenciar, retiramos uma única observação da amostra e recalculamos as duas.
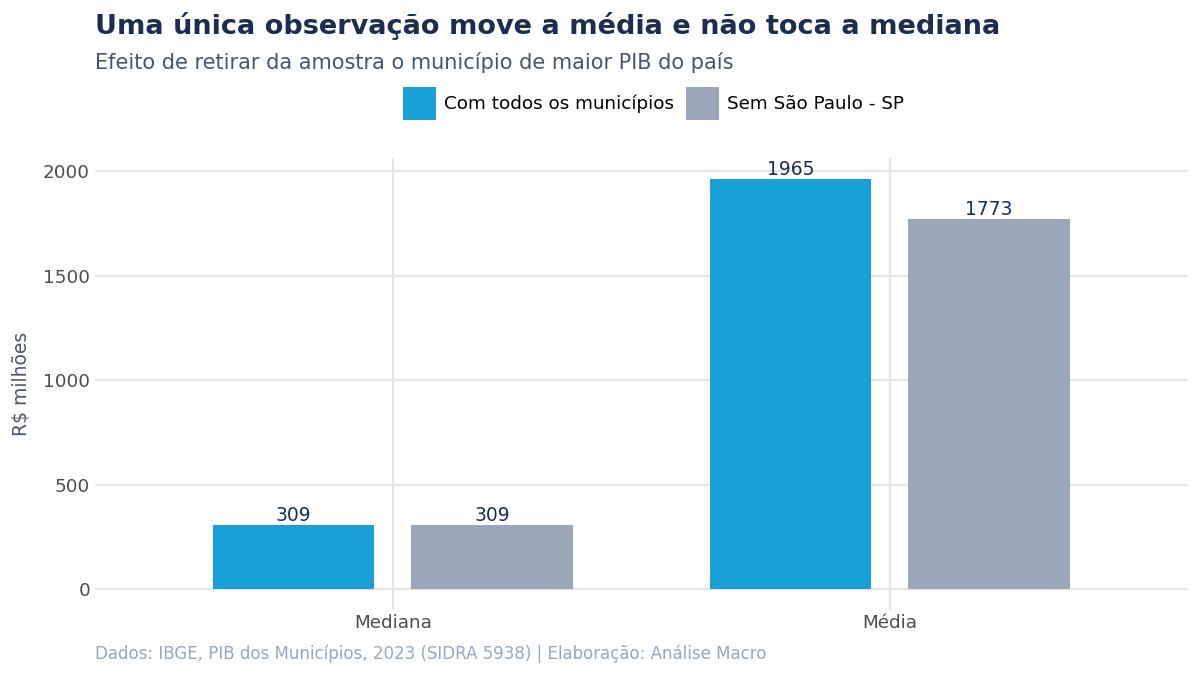
No gráfico acima, as barras mostram a média e a mediana antes e depois da retirada do município de maior PIB. A retirada derruba a média de forma perceptível, enquanto a mediana praticamente não se move.
Ou seja, uma observação entre mais de cinco mil desloca visivelmente a média e quase não altera a mediana. Uma medida que muda pouco quando valores extremos entram ou saem da amostra chama-se robusta.
Ponto de ruptura: quanto cada medida aguenta
Até aqui, comparamos a robustez das medidas pelo gráfico. A estatística mede essa resistência com um número, o ponto de ruptura.
O ponto de ruptura responde à pergunta: qual a menor fração da amostra que, se corrompida, é capaz de levar o resultado a qualquer valor? Quanto maior essa fração, mais resistente é a medida.
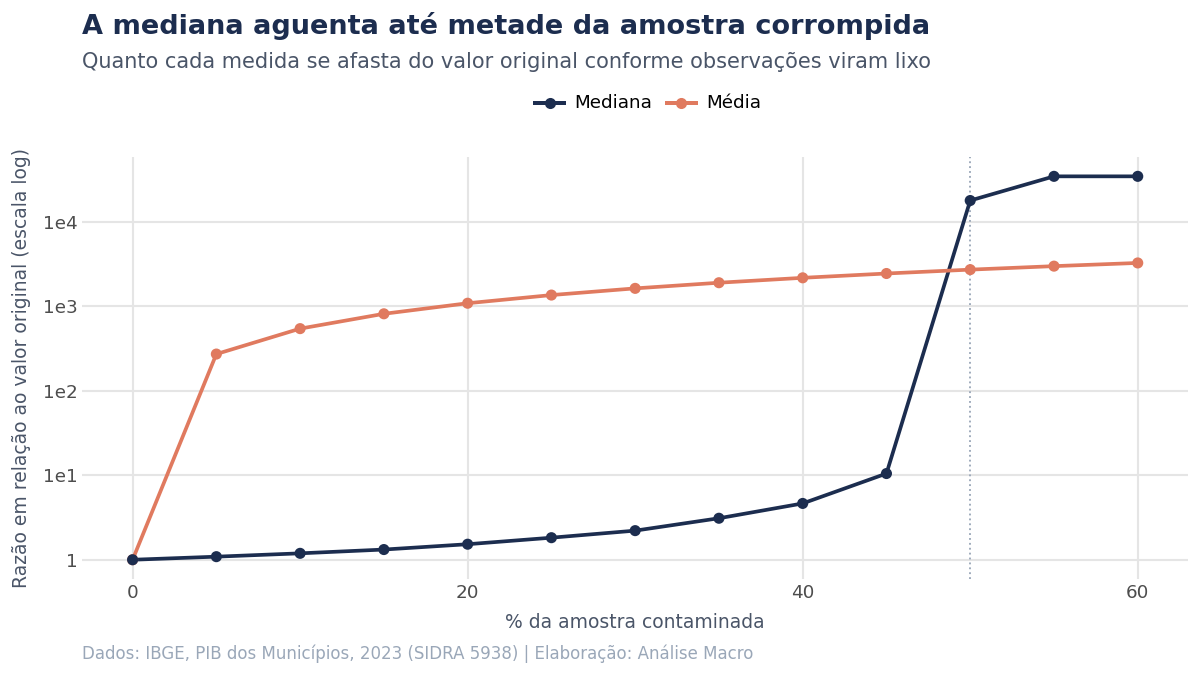
O ponto de ruptura pode ser medido experimentalmente. Substituímos uma parcela crescente dos municípios por valores muito acima de qualquer PIB observado, simulando erro de digitação ou contaminação da base, e acompanhamos o quanto cada medida se afasta do valor que tinha antes.
Contaminar a amostra de propósito e observar o resultado é um experimento controlado, da mesma família dos exercícios de simulação de Monte Carlo.
No gráfico acima, cada linha mostra o quanto uma medida se afasta do seu valor original, e as linhas da média e da mediana se comportam de maneira oposta. A linha da média sobe desde o primeiro ponto: basta uma fração pequena de dados corrompidos para ela se afastar muito do valor original. A linha da mediana permanece praticamente na horizontal enquanto a contaminação for minoritária, e só dispara quando os valores corrompidos passam da metade da amostra.
A média tem ponto de ruptura zero: uma única observação suficientemente extrema já a desloca para qualquer valor. A mediana tem ponto de ruptura de 50%.
E 50% é o teto para qualquer medida de centro: se mais da metade das observações estiver corrompida, os valores corrompidos passam a ser a maioria, e nenhum critério estatístico consegue indicar qual grupo é o dado legítimo e qual é a contaminação.
Dispersão: as alternativas ao desvio-padrão
O mesmo problema afeta a medida de espalhamento. O desvio-padrão calcula a distância de cada observação até a média e eleva essa distância ao quadrado antes de somá-la. Elevar ao quadrado amplia as distâncias grandes muito mais do que as pequenas: uma observação dez vezes mais distante do centro contribui cem vezes mais para o resultado.
As duas alternativas robustas, o IQR e o MAD, substituem a soma de quadrados por posições na fila ordenada, do mesmo modo que a mediana faz com o centro.
IQR: a faixa central dos dados
O IQR, ou intervalo interquartil, parte dos quartis. Assim como a mediana divide o conjunto ordenado em duas metades, os quartis o dividem em quatro partes com o mesmo número de observações cada:
- o primeiro quartil deixa 25% dos municípios abaixo dele;
- o terceiro quartil deixa 75% abaixo.
A distância entre o primeiro e o terceiro quartil é o IQR: a largura da faixa que contém os 50% de municípios do meio da distribuição. Como o cálculo usa apenas esses dois pontos de corte, o que acontece nas pontas fica fora do cálculo: o PIB de São Paulo poderia ser dez vezes maior sem alterar o resultado.
MAD: a distância típica até o centro
O MAD, ou desvio absoluto mediano, aplica a mesma ideia duas vezes:
- primeiro, calcula a distância de cada município até a mediana;
- depois, tira a mediana dessas distâncias.
Como as duas etapas usam a mediana, que depende só da ordem dos valores, um valor extremo entra no cálculo apenas como “mais uma distância grande”, sem que o tamanho dele influencie o resultado.
O MAD calculado dessa forma sai numa escala menor que a do desvio-padrão, e comparar os dois números diretamente levaria a conclusões erradas. A solução é multiplicá-lo por um fator de ajuste fixo, escolhido de modo que, quando o dado segue uma distribuição normal, MAD e desvio-padrão devolvam o mesmo valor. Com o ajuste, uma diferença entre MAD e desvio-padrão passa a indicar afastamento da normalidade.
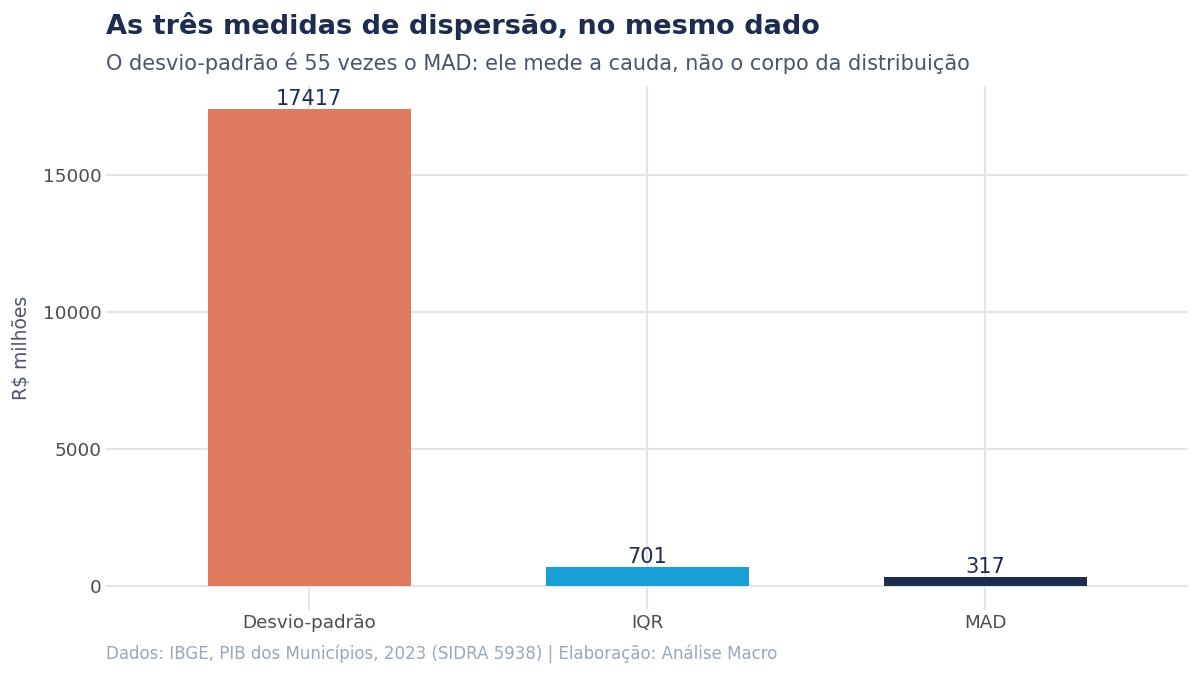
No gráfico acima, cada barra mostra uma das três medidas de dispersão calculadas sobre o PIB municipal. O desvio-padrão fica dezenas de vezes acima do MAD, porque cada medida descreve uma parte distinta da mesma distribuição:
- o desvio-padrão descreve a cauda da distribuição, dominada pelas capitais;
- o MAD descreve o corpo dela, onde está a maioria dos municípios.
O MAD fica próximo da própria mediana. A distância típica entre um município e o município central é, portanto, da mesma ordem de grandeza do próprio valor central. Ou seja, a desigualdade entre municípios comuns já é grande, mesmo deixando as capitais de fora. O desvio-padrão, dominado pelas capitais, esconde essa desigualdade entre os municípios comuns.
Quando usar cada medida
A escolha entre as medidas clássicas e as robustas depende do formato da distribuição.
Usamos as medidas clássicas, média e desvio-padrão, quando:
- a distribuição for aproximadamente simétrica e sem valores extremos;
- a inferência se apoiar na média amostral, caso em que o Teorema Central do Limite garante a distribuição dela mesmo com a população assimétrica;
- a soma total for o que interessa. Para calcular o PIB do país, a média dos municípios é exatamente o que se quer, porque cada real tem o mesmo peso.
Usamos as robustas, mediana, IQR e MAD, quando:
- a distribuição for assimétrica;
- houver valores extremos legítimos que não queremos remover;
- a pergunta for sobre o caso típico. Renda, PIB municipal, tempo de resposta e preço de imóvel se encaixam aqui.
A decisão pressupõe saber com que tipo de variável estamos lidando, distinção tratada em variáveis quantitativas e qualitativas.
Reportamos as duas quando o formato da distribuição for parte da informação a transmitir. A distância entre média e mediana é, ela própria, uma medida de assimetria: publicar média e mediana permite ao leitor perceber o quanto a distribuição é assimétrica.
Todas essas medidas pressupõem uma variável numérica. Quando o dado vem em categorias, o diagnóstico muda de ferramenta e passa pelas tabelas de contingência e o teste qui-quadrado.
O roteiro de diagnóstico
Duas razões resumem o diagnóstico e podem ser calculadas em qualquer conjunto de dados:
- média dividida por mediana;
- desvio-padrão dividido por MAD.
A referência é o valor 1, porque numa distribuição simétrica a média coincide com a mediana e o desvio-padrão ajustado coincide com o MAD. Razões próximas de 1 indicam, portanto, que as medidas clássicas bastam. Quanto mais as razões se afastam de 1, mais a assimetria e os valores extremos influenciam o resultado, e mais as medidas robustas se tornam a leitura adequada.
| Situação | O que usar |
|---|---|
| Distribuição simétrica, sem valores extremos | Média e desvio-padrão |
| A soma total é o que interessa (agregar o PIB do país) | Média, porque cada real tem o mesmo peso |
| Distribuição assimétrica, com outliers legítimos | Mediana, IQR e MAD |
| A pergunta é sobre o caso típico | Mediana |
| A forma do dado é parte da informação | Média e mediana: a distância entre elas mede a assimetria |
São Paulo continua na amostra, porque é um dado legítimo e economicamente relevante. O que muda é a medida escolhida para resumir o conjunto.
Você viu o problema; aprenda a análise completa
Da estatística descritiva ao tratamento de dados reais e à modelagem, com Python aplicado a dados econômicos desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
HUBER, P. J. Robust estimation of a location parameter. The Annals of Mathematical Statistics, v. 35, n. 1, p. 73-101, 1964.
HUBER, P. J.; RONCHETTI, E. M. Robust statistics. 2. ed. Hoboken: John Wiley & Sons, 2009.
MARONNA, R. A. et al. Robust statistics: theory and methods (with R). 2. ed. Hoboken: John Wiley & Sons, 2019.
ROUSSEEUW, P. J.; CROUX, C. Alternatives to the median absolute deviation. Journal of the American Statistical Association, v. 88, n. 424, p. 1273-1283, 1993.
TUKEY, J. W. Exploratory data analysis. Reading: Addison-Wesley, 1977.
Leia também: Simulação de cenários com distribuição de probabilidades · O alicerce da ciência de dados: entendendo o processo gerador dos dados




