
Para calcular a taxa de desemprego, o IBGE entrevista algumas dezenas de milhares de brasileiros, em vez dos mais de 200 milhões, e a partir desse grupo estima o resultado do país inteiro. Junto com o número, o instituto informa o quanto ele pode variar: é a margem de erro que acompanha o resultado. Neste exercício, vamos mostrar de onde vem essa margem e por que ela continua válida mesmo quando a população estudada está longe de ser normal.
Digamos que a taxa de desemprego calculada nessa amostra tenha sido de 8%. Se o IBGE tivesse sorteado outro conjunto de domicílios, no mesmo dia e pelo mesmo critério, o resultado poderia ser 7,8% ou 8,3%, porque as pessoas entrevistadas seriam outras.
Todos esses valores seriam estimativas legítimas, obtidas de amostras diferentes da mesma população. Mas qual é a amplitude dessa variação? Se amostras diferentes produzem resultados entre 7,8% e 8,3%, a estimativa é confiável dentro de alguns décimos. Se produzissem valores entre 5% e 11%, a taxa do país poderia estar três pontos acima ou abaixo do número divulgado.
Responder a essa pergunta exige conhecer o comportamento da média amostral, a soma das n observações sorteadas dividida por n: se repetíssemos a pesquisa várias vezes, sorteando pessoas diferentes a cada rodada, cada amostra produziria uma média um pouco diferente. Essas médias formam uma distribuição própria, e a dispersão dessa distribuição mede o quanto o resultado pode variar.
Em princípio, para conhecer essa distribuição precisaríamos conhecer a distribuição da população inteira. A pesquisa, porém, entrevistou apenas uma parte dela.
O Teorema Central do Limite resolve esse impasse. Ele afirma que, conforme o tamanho da amostra cresce, a distribuição da média amostral se aproxima de uma distribuição normal, aquela com formato de sino, simétrica em torno da média. E o resultado se aplica qualquer que seja a distribuição da população de origem: ela pode ser assimétrica, ter caudas pesadas ou nem sequer se parecer com um sino.
Em símbolos, com μ e σ representando a média e o desvio-padrão da população de origem, o teorema afirma que a média amostral tende a se distribuir assim:
O segundo argumento da normal é a variância da média: σ² dividido por n. Por isso, a média varia menos de uma amostra para outra do que o dado original varia de uma observação para outra, e a diferença aumenta com o tamanho da amostra.
Como o resultado se aplica a qualquer população de origem, podemos calcular a precisão de uma média estimada sem precisar descobrir antes como a população se distribui.
Receba as próximas análises no seu e-mail
Amostragem, erro-padrão e inferência aplicada a dados econômicos aparecem toda semana nas análises do Boletim AM. A assinatura é gratuita e chega direto no seu e-mail.
Começando por uma população distante da normal
Para testar o teorema, convém partir de uma população que esteja claramente distante da normal. Se a convergência aparecer no caso difícil, aparece também nos casos comuns. Usamos a oscilação diária do Ibovespa em módulo: o quanto o índice se moveu a cada pregão, tomando o valor absoluto da variação, sem distinguir alta de queda.
Essa variável tem três características que a afastam do sino:
- nunca é negativa, porque tomamos o valor absoluto: uma queda de 2% e uma alta de 2% entram no cálculo como o mesmo número;
- concentra a maior parte dos pregões em valores baixos;
- apresenta uma cauda longa à direita, formada pelos pregões de oscilação muito acima da usual.

No histograma acima, cada barra mostra quantos pregões tiveram oscilação dentro de uma faixa. A maior parte dos pregões fica nos valores baixos, e a cauda se estende para a direita.
O quanto uma distribuição se afasta da simetria se mede pela assimetria, que indica se a distribuição se estende mais para um lado do que para o outro. Uma distribuição normal tem assimetria igual a zero, por ser perfeitamente simétrica em torno da média; valores positivos indicam cauda mais longa à direita. A oscilação do Ibovespa fica bem acima dessa referência.
Formatos como esse, e como identificar qual distribuição descreve cada variável, são o assunto de Distribuições de probabilidade em dados: como identificar a sua.
Assimetria, curtose e as demais medidas de forma entram no mesmo bloco de sumários de estatísticas descritivas que costuma abrir uma análise.
Um método que pressuponha normalidade, aplicado diretamente sobre esse dado, produziria resultados incorretos, porque a suposição não descreve o comportamento da variável. Por isso, a oscilação do Ibovespa serve como um caso exigente para testar o teorema.
O experimento: o que acontece com a média de amostras
Para cada tamanho de amostra, do menor ao maior, repetimos os passos abaixo:
- sorteamos uma amostra de tamanho n dessa população;
- calculamos a média dessa amostra e guardamos o valor;
- repetimos o sorteio milhares de vezes, de modo que as médias obtidas formem elas próprias uma distribuição, que é o objeto que queremos observar.
Gerar milhares de cenários por sorteio e ler a distribuição que eles formam é o método da simulação de Monte Carlo, usado aqui para observar o teorema em funcionamento.
Cada sorteio produz um número: a média daquela amostra. Ao repetir o procedimento milhares de vezes, obtemos milhares desses números, e esses números passam a ser o dado analisado. A oscilação diária do Ibovespa continua com a mesma distribuição assimétrica de sempre; o que vamos observar daqui em diante é a distribuição das médias calculadas a partir dela.

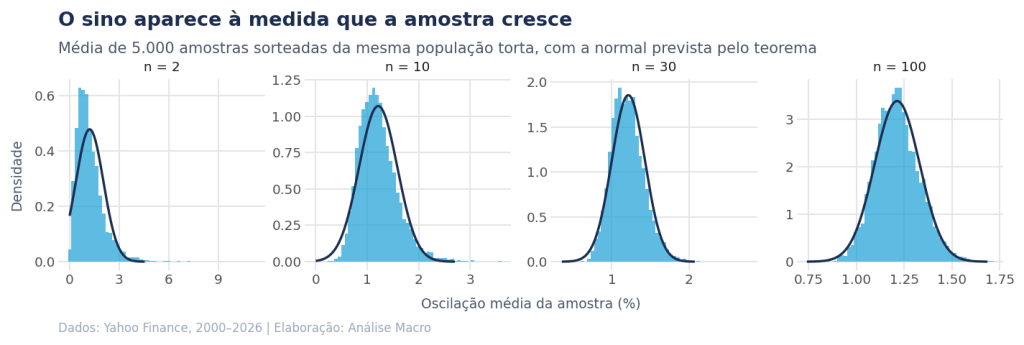
Cada painel da figura acima mostra o histograma das médias para um tamanho de amostra, e o formato muda aos poucos:
- com amostras muito pequenas, o histograma ainda mantém a assimetria da população de origem;
- com algumas dezenas de observações, já aparece um sino reconhecível, ainda que levemente inclinado para a direita;
- com amostras grandes, o histograma e a linha da normal prevista se sobrepõem.
A linha azul-escura sobreposta a cada painel é a distribuição normal que o teorema prevê. Ela não foi ajustada aos histogramas simulados: seus dois parâmetros saem apenas da média e do desvio-padrão da população de origem, calculados antes de qualquer sorteio. Ou seja, a coincidência entre as barras e a linha da normal é a previsão do teorema, feita antes do experimento.
O sorteio repetido reproduz, no computador, o processo gerador dos dados que na vida real observamos uma vez só.
A população é a mesma em todos os painéis: os sorteios saem sempre da mesma série, com a mesma assimetria. O único parâmetro alterado foi o tamanho da amostra usada para calcular cada média. Por isso, o sino que aparece nos últimos painéis resulta de calcular a média sobre amostras maiores.
Acompanhando a assimetria das médias
Em vez de comparar formatos visualmente, podemos acompanhar um único número: a assimetria das médias a cada tamanho de amostra, medindo o quanto ela se aproxima de zero.

Na figura acima, a linha da assimetria desce de forma contínua. Com amostras pequenas, a assimetria das médias fica próxima da assimetria da população de origem, porque cada média reúne poucas observações e ainda reflete a cauda do dado. Conforme o tamanho da amostra cresce, esse valor encolhe em direção a zero, que é a assimetria de uma distribuição normal.
A convergência acontece de forma gradual, sem um ponto de corte a partir do qual a distribuição passe a ser normal.
Existe uma regra prática bastante difundida de que trinta observações bastariam, e ela vem de uma situação típica: populações moderadamente assimétricas costumam convergir por volta desse tamanho. Como a velocidade depende do formato da população de origem, a regra funciona como referência inicial, e o tamanho necessário cresce com a assimetria: quanto mais assimétrica a população, maior a amostra.
Qual normal o teorema especifica
Até aqui o teorema afirmou que a distribuição das médias se aproxima de uma normal. Mas existem infinitas distribuições normais, cada uma com seu centro e sua dispersão. O teorema também especifica qual delas se trata, e dessa especificação sai a fórmula da margem de erro.
A distribuição das médias amostrais tem duas características:
- fica centrada na média da população;
- tem dispersão igual ao desvio-padrão da população dividido pela raiz do tamanho da amostra.
Essa dispersão chama-se erro-padrão da média. Ele mede o quanto a média estimada tende a variar de uma amostra para outra e, por isso, funciona como uma medida da precisão da estimativa. Quanto menor o erro-padrão, mais próximas entre si estariam as médias de pesquisas repetidas.
A fórmula depende de duas informações apenas, a dispersão da população e o tamanho da amostra, e se aplica qualquer que seja o formato da distribuição de origem.

No gráfico acima, cada par de barras corresponde a um tamanho de amostra: uma barra mostra o desvio-padrão que as médias simuladas apresentaram, e a outra, o que a fórmula do erro-padrão previa. As barras de cada par têm praticamente a mesma altura, ou seja, a fórmula descreve o resultado do experimento.
A fórmula usa apenas duas informações da população e antecipa o espalhamento de um experimento aleatório. Por isso, um instituto de pesquisa consegue anunciar a margem de erro de um levantamento antes de a coleta começar: basta definir o tamanho da amostra e ter uma estimativa da dispersão da população.
A consequência prática: a raiz de n
A raiz quadrada no denominador tem uma consequência direta sobre o custo de uma pesquisa. Como a dispersão é dividida pela raiz de n, o ganho de precisão cresce mais devagar do que o tamanho da amostra:
- para dobrar a precisão, é preciso quadruplicar a amostra;
- para triplicar a precisão, é preciso multiplicá-la por nove.
Essa relação explica dois fatos que à primeira vista parecem contraditórios. De um lado, uma pesquisa domiciliar de grande porte mantém margem de erro perceptível mesmo com orçamento elevado, porque cada entrevista adicional contribui cada vez menos para a precisão. De outro, uma amostra de poucos milhares de pessoas já produz uma margem razoável para estimar o país inteiro, porque os primeiros milhares de entrevistas são justamente os que mais reduzem o erro-padrão.
O que o teorema sustenta na prática
Quando lemos que a taxa de desemprego é de determinado percentual com margem de erro de alguns décimos, essa margem foi construída sobre o teorema.
A distribuição exata da situação ocupacional dos brasileiros é desconhecida, e o cálculo da margem dispensa essa informação. Basta que a amostra seja grande o bastante para que a distribuição da média já tenha convergido para a normal, e as dezenas de milhares de domicílios da PNAD Contínua estão muito acima desse limiar.
O mesmo raciocínio sustenta:
- intervalos de confiança em geral;
- testes de hipótese;
- boa parte dos testes de significância em regressão;
- a leitura do p-valor em testes de associação, como o teste qui-quadrado em tabelas de contingência.
Em todos eles o procedimento parte do mesmo ponto. Conhecendo a distribuição da média, ou do coeficiente estimado numa regressão, podemos calcular a probabilidade de observar um resultado como o obtido caso o efeito não existisse na população. Se essa probabilidade for muito baixa, atribuir o resultado ao acaso do sorteio fica difícil de sustentar.
Os limites do teorema
O primeiro limite é o objeto do teorema, que descreve a média. Por maior que seja a amostra, a variável analisada continua com a distribuição que sempre teve. Se coletarmos mais retornos diários do Ibovespa, os retornos mantêm a mesma distribuição; quem se aproxima da normal é a distribuição das médias calculadas a partir deles.
O teorema garante a distribuição da média, mas a média pode resumir mal aquela população. Em distribuições muito assimétricas, ela continua sendo puxada pela cauda, e as estatísticas robustas descrevem melhor o caso típico.
O segundo limite é a velocidade da convergência, que depende da população de origem. Quanto mais assimétrica a população ou mais pesada a cauda, maior o n necessário, e o tamanho que basta para uma população pode ser insuficiente para outra.
O terceiro limite é uma exceção matemática. Em distribuições com variância infinita, como a Cauchy, a média amostral não se aproxima da normal, porque o erro-padrão depende de σ, e σ deixa de ser um número finito. Na prática econômica esse caso é raro, mas a garantia do teorema depende de a variância ser finita.
Antes de aplicar o teorema, verificamos os pontos da tabela abaixo:
| Passo | O que verificar |
|---|---|
| 1 | O objeto da análise é uma média (ou uma soma, ou um coeficiente estimado)? O teorema não se aplica a observações individuais. |
| 2 | Qual o grau de assimetria da população de origem? Quanto maior, maior a amostra necessária para a aproximação funcionar. |
| 3 | A variância da população é finita? Distribuições como a Cauchy ficam fora da versão usual do teorema. |
| 4 | As observações são independentes entre si? Em séries temporais com forte persistência, a amostra efetiva é menor do que o número de observações sugere. |
Você viu o teorema; aprenda a fazer inferência com ele
De intervalos de confiança a testes de hipótese e regressão, com Python aplicado a dados econômicos reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
CASELLA, G.; BERGER, R. L. Statistical inference. 2. ed. Pacific Grove: Duxbury Press, 2002.
DeGROOT, M. H.; SCHERVISH, M. J. Probability and statistics. 4. ed. Boston: Pearson, 2012.
EFRON, B.; HASTIE, T. Computer age statistical inference: algorithms, evidence, and data science. Cambridge: Cambridge University Press, 2016.
WASSERMAN, L. All of statistics: a concise course in statistical inference. New York: Springer, 2004.
Leia também: Simulação de cenários com distribuição de probabilidades · Variáveis quantitativas e qualitativas: o que são e como analisar




