A gramática dos gráficos é uma teoria que descreve qualquer gráfico estatístico como a combinação de componentes independentes: os dados, o mapeamento das variáveis, a forma geométrica, a transformação estatística, as facetas, as coordenadas e o tema. No Python, a biblioteca que implementa essa teoria é o plotnine, e com ela construímos um gráfico somando camadas em vez de escolher um modelo pronto de um catálogo.
Neste tutorial mostramos o que é cada componente dessa gramática, por que ela substitui com vantagem a lógica de catálogo das planilhas, e como as camadas se combinam na prática. O exemplo usa duas séries do Banco Central do Brasil, a taxa Selic e o IPCA, com 261 observações mensais entre dezembro de 2004 e agosto de 2026.
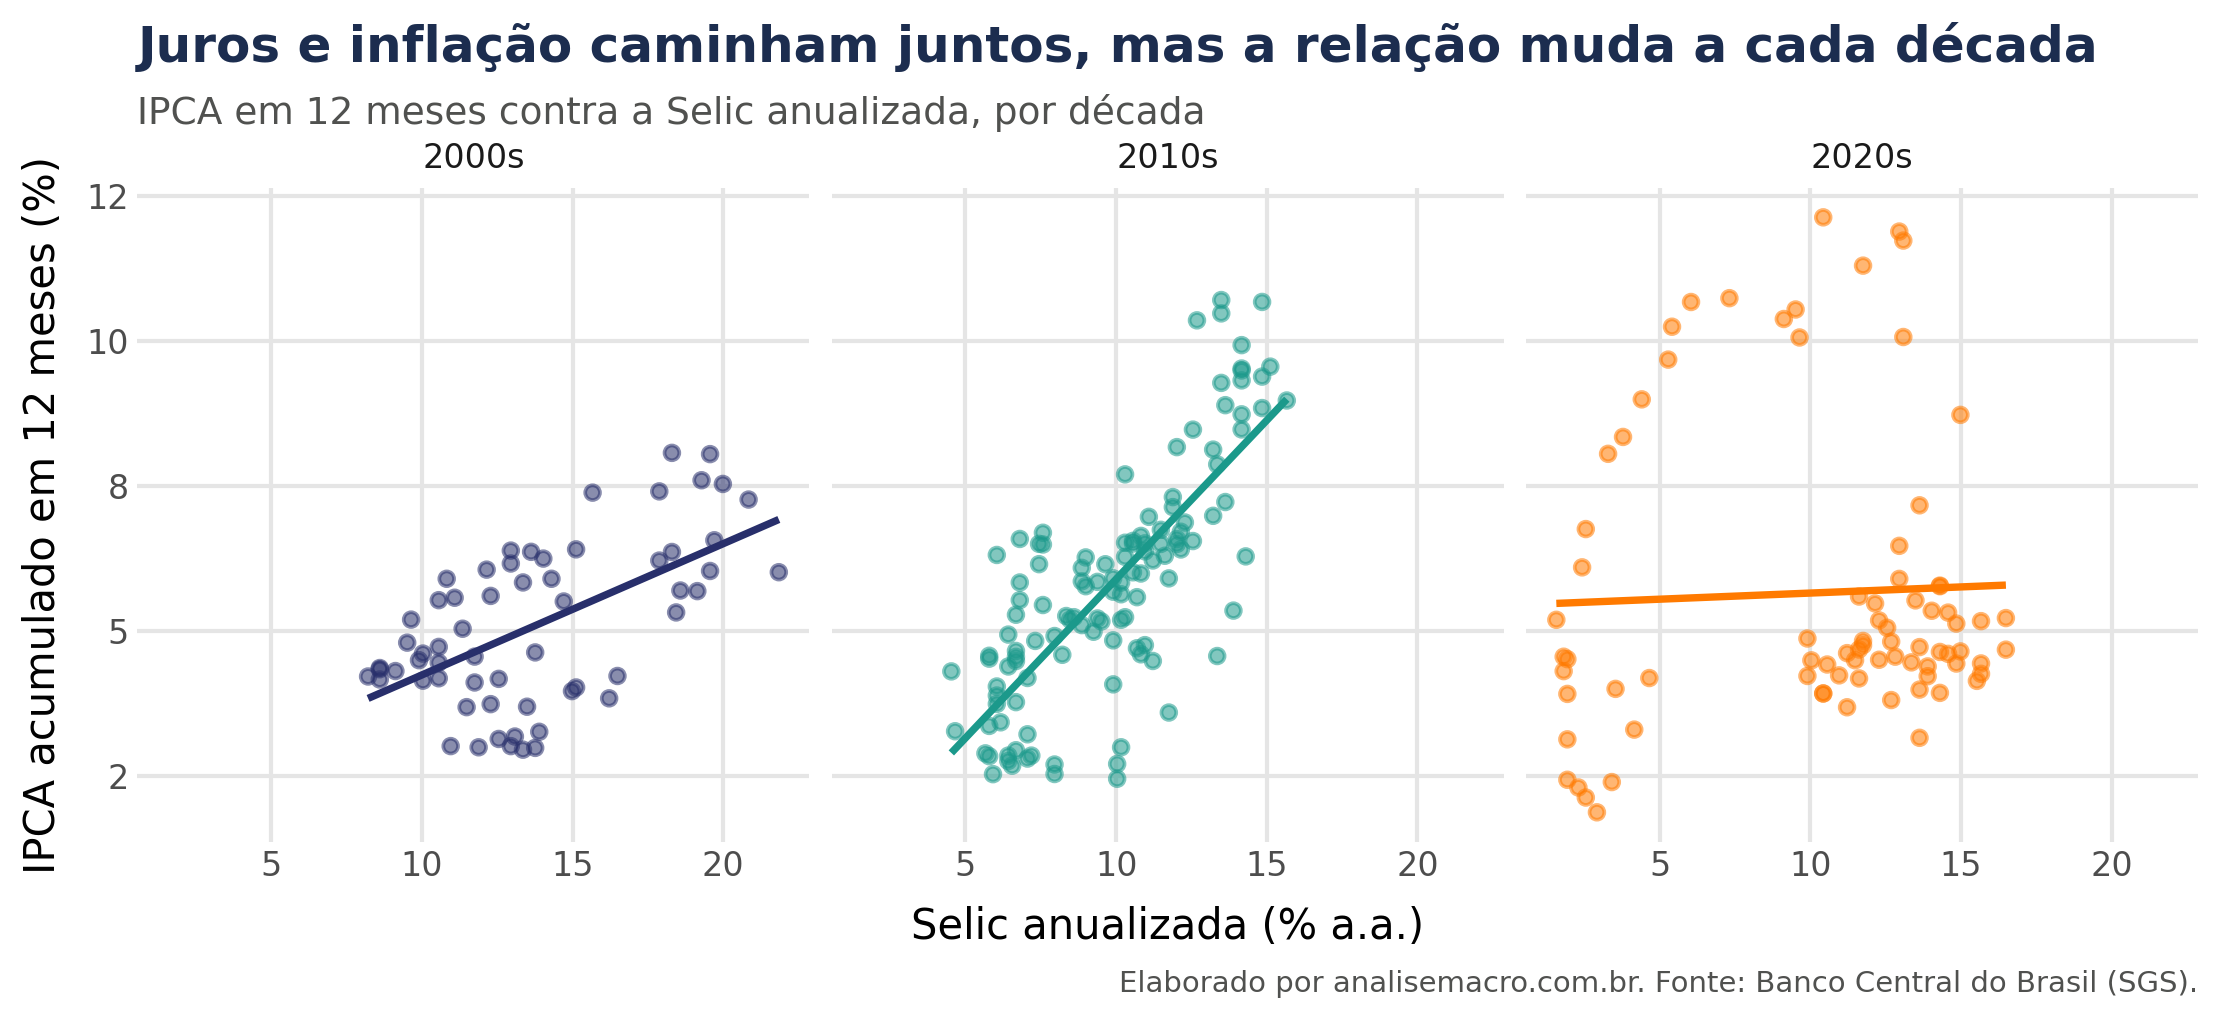
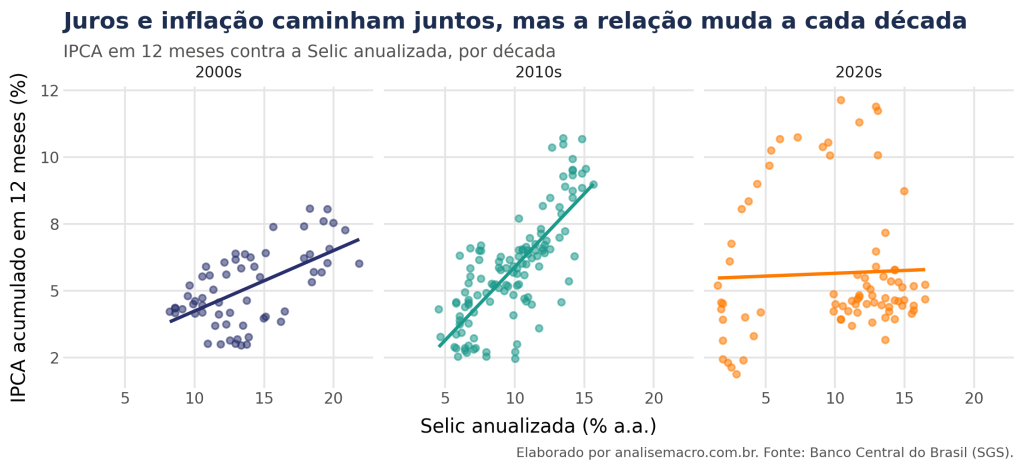
Esse gráfico reúne cinco decisões independentes: os dados, o mapeamento dos eixos, a geometria de pontos, a reta ajustada por grupo e a divisão em painéis. Nas próximas seções separamos cada uma delas.
💡 Quer obter o código completo deste exercício, com o notebook pronto para rodar no Google Colab e os dados já tratados?
O que é a gramática dos gráficos
Leland Wilkinson formalizou a gramática dos gráficos em The Grammar of Graphics, de 1999. A proposta do livro foi descrever qualquer gráfico estatístico como a combinação de um conjunto pequeno de componentes, em vez de tratá-los como tipos isolados.
A analogia com a língua explica o nome. Uma língua tem vocabulário finito e regras de combinação, e com isso produzimos um número ilimitado de frases. A gramática dos gráficos funciona do mesmo modo: em vez de uma lista fechada de gráficos prontos, ela oferece componentes que se combinam livremente.
A diferença prática aparece na comparação com a planilha. No Excel escolhemos um gráfico de um catálogo, e o que o catálogo não tem exige improviso. Na gramática dos gráficos não existe catálogo: descrevemos o gráfico pela combinação de componentes, e a figura resultante é consequência dessa descrição. O mesmo raciocínio vale para outras tarefas de análise, como mostramos ao simplificar análises de dados manuais do Excel usando o Python.
Os sete componentes
- Dados: a tabela que alimenta a figura, com uma observação por linha e uma variável por coluna.
- Mapeamento estético: a ligação entre uma coluna e uma propriedade visual, como a posição no eixo, a cor ou o tamanho.
- Geometria: a forma que representa cada observação. Ponto, linha, barra e área são geometrias diferentes sobre os mesmos dados.
- Transformação estatística: o cálculo feito antes de desenhar, como a contagem por faixa de um histograma ou uma reta de regressão.
- Facetas: a divisão dos dados em painéis, repetindo o mesmo gráfico em cada recorte.
- Coordenadas: como as posições viram lugar na tela. O cartesiano é o mais comum, e o polar transforma barras em fatias de pizza.
- Tema: tudo o que não descreve dado, como fonte, cor de fundo, grade e posição da legenda.
A independência entre os componentes é o que dá poder à teoria. Trocar apenas a geometria converte uma dispersão em linha; trocar apenas as coordenadas converte barras em pizza. Nenhuma dessas mudanças exige refazer o gráfico do zero.
ggplot2 e plotnine: a mesma gramática em duas linguagens
Hadley Wickham implementou a teoria de Wilkinson no pacote ggplot2, da linguagem R, e foi essa implementação que popularizou a gramática na análise de dados. Já tratamos dela ao mostrar como visualizar dados com ggplot2.
No Python, as bibliotecas mais conhecidas de visualização seguem outra lógica. O matplotlib e o seaborn trabalham com comandos de desenho, e não com componentes de um gráfico, como mostramos no tutorial de visualização de dados com Matplotlib e Seaborn.
O plotnine traz a gramática dos gráficos para o Python, com sintaxe deliberadamente próxima à do ggplot2. Quem já escreve gráficos em R reaproveita quase tudo, e a diferença principal é que o plotnine pede parênteses em volta da expressão inteira.
Os dados do exemplo
Usamos duas séries do Sistema Gerenciador de Séries Temporais do Banco Central: o IPCA mensal, que é o índice oficial de inflação do país, e a taxa Selic acumulada no mês, que é a taxa básica de juros da economia. A coleta usa a biblioteca python-bcb, no mesmo espírito do que fazemos ao lidar com erros de coleta de dados do Banco Central.
Nenhuma das duas séries chega na unidade em que costumamos lê-las. A Selic vem como taxa do mês e o mercado a discute em termos anuais; o IPCA vem como variação do mês e a meta de inflação é definida sobre o acumulado de doze meses. A preparação converte as duas e acrescenta a coluna de década, que alimenta as facetas.
| Mês | IPCA 12 meses (%) | Selic anualizada (% a.a.) | Década |
|---|---|---|---|
| 2026-03 | 4,14 | 15,53 | 2020s |
| 2026-04 | 4,39 | 13,89 | 2020s |
| 2026-05 | 4,72 | 13,62 | 2020s |
| 2026-06 | 4,64 | 14,30 | 2020s |
| 2026-07 | 4,44 | 15,66 | 2020s |
| 2026-08 | 4,22 | 13,89 | 2020s |
Cada linha é uma observação mensal, e é essa tabela que passamos ao plotnine. A estrutura importa: a gramática espera dados em formato longo, com uma observação por linha, e não a planilha larga em que cada coluna é um ano.
Construindo o gráfico camada a camada
Camada 1: dados e mapeamento
O gráfico começa com a função ggplot(), que recebe a tabela, e com a função aes(), que liga colunas a propriedades visuais. As camadas são somadas com o símbolo +, e a expressão inteira vai entre parênteses.
(
    ggplot(dados)                           # a tabela que alimenta o gráfico
    + aes(x="selic_anual", y="ipca_12m")    # Selic no eixo x, IPCA no eixo y
)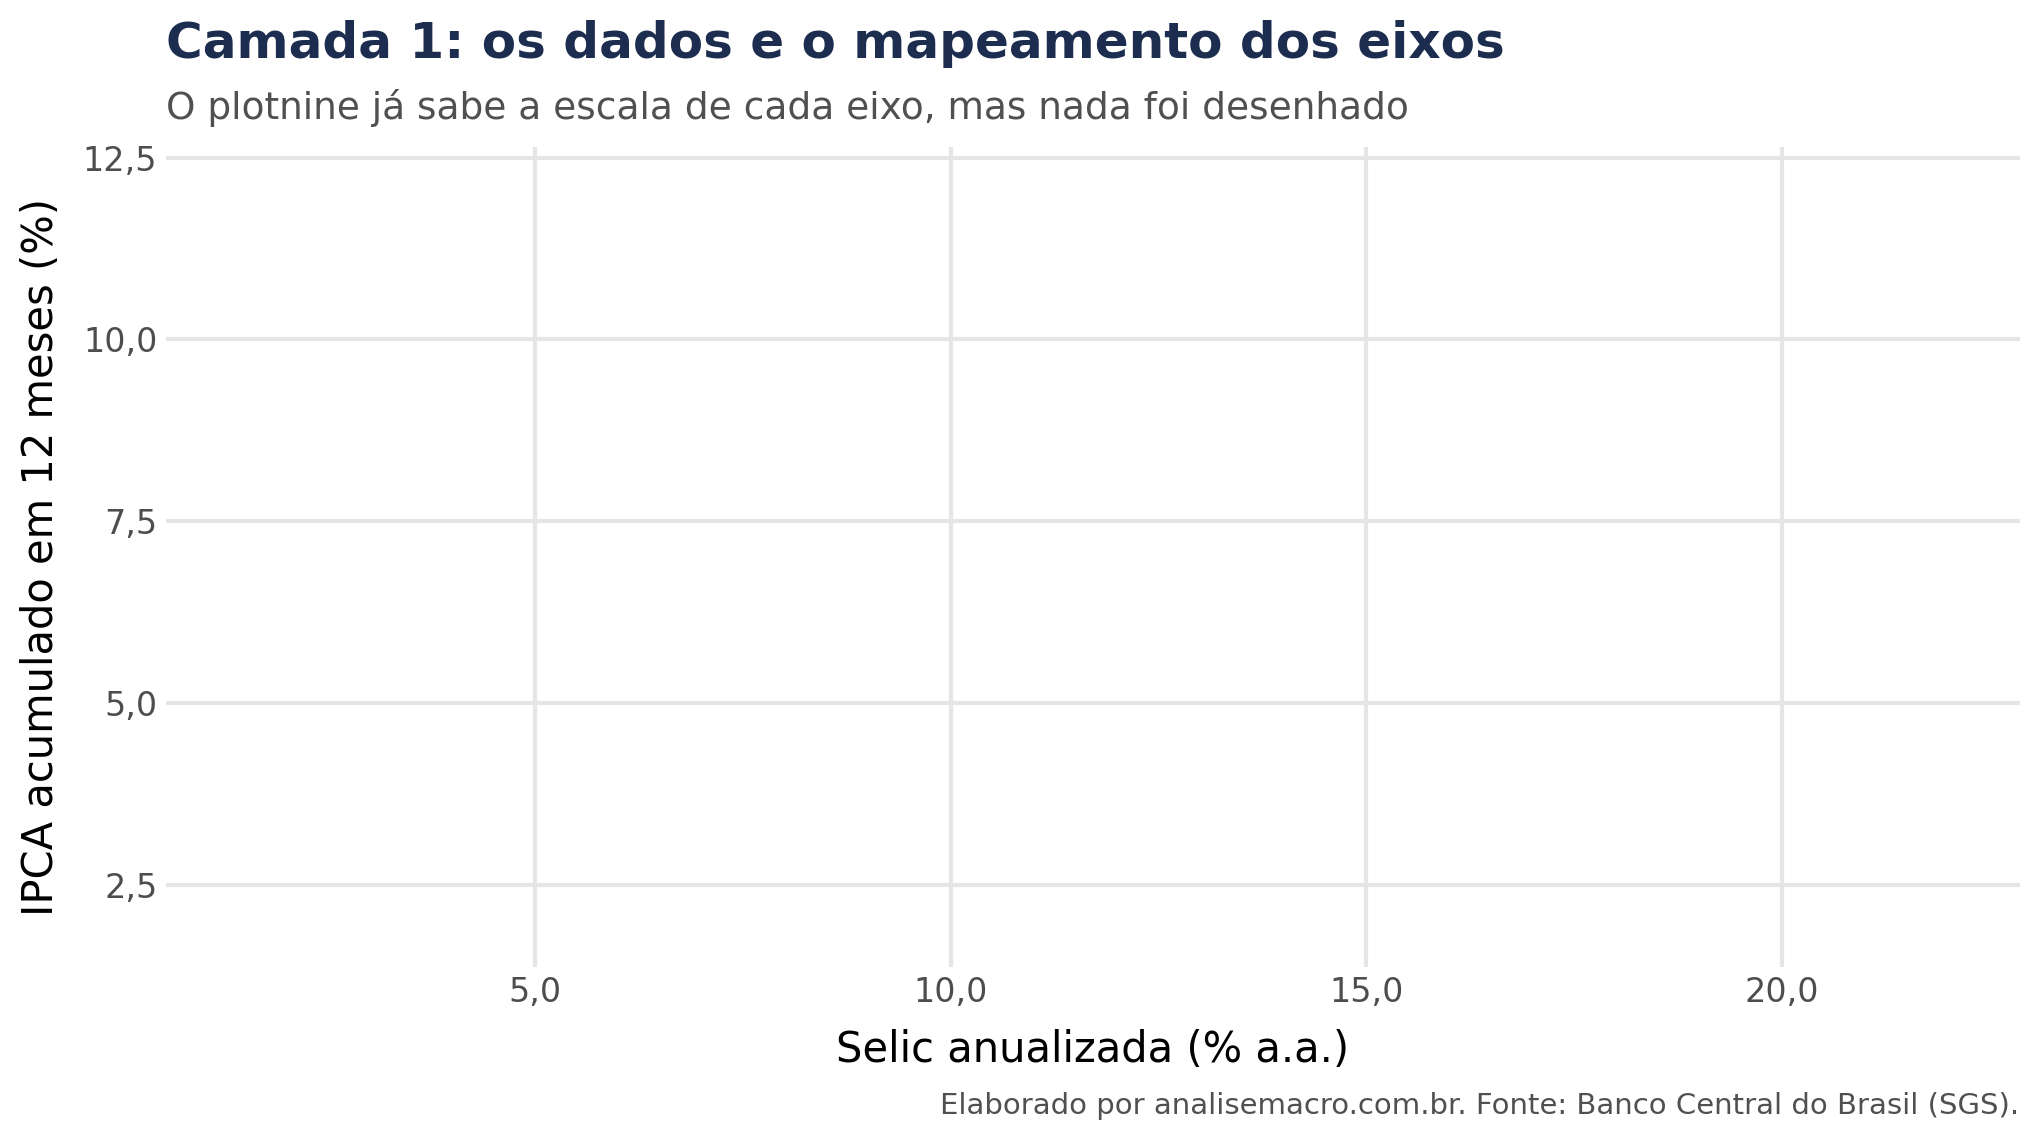
A figura sai com os eixos escalados e sem nenhum ponto. O plotnine já conhece o intervalo de cada variável e já reservou o espaço, e ainda não desenhou nada, porque não dissemos qual forma deve representar cada observação.
Esse resultado costuma parecer defeito na primeira vez, e é a demonstração de que mapeamento e geometria são decisões separadas. No Excel as duas viriam juntas na escolha do tipo de gráfico.
Camada 2: a geometria
A geometria diz qual forma representa cada linha da tabela. Como comparamos duas variáveis contínuas, cada mês vira um ponto, com geom_point().
(
    ggplot(dados)
    + aes(x="selic_anual", y="ipca_12m")
    + geom_point(color="#282f6b", alpha=.55, size=1.8)   # cada mês vira um ponto
)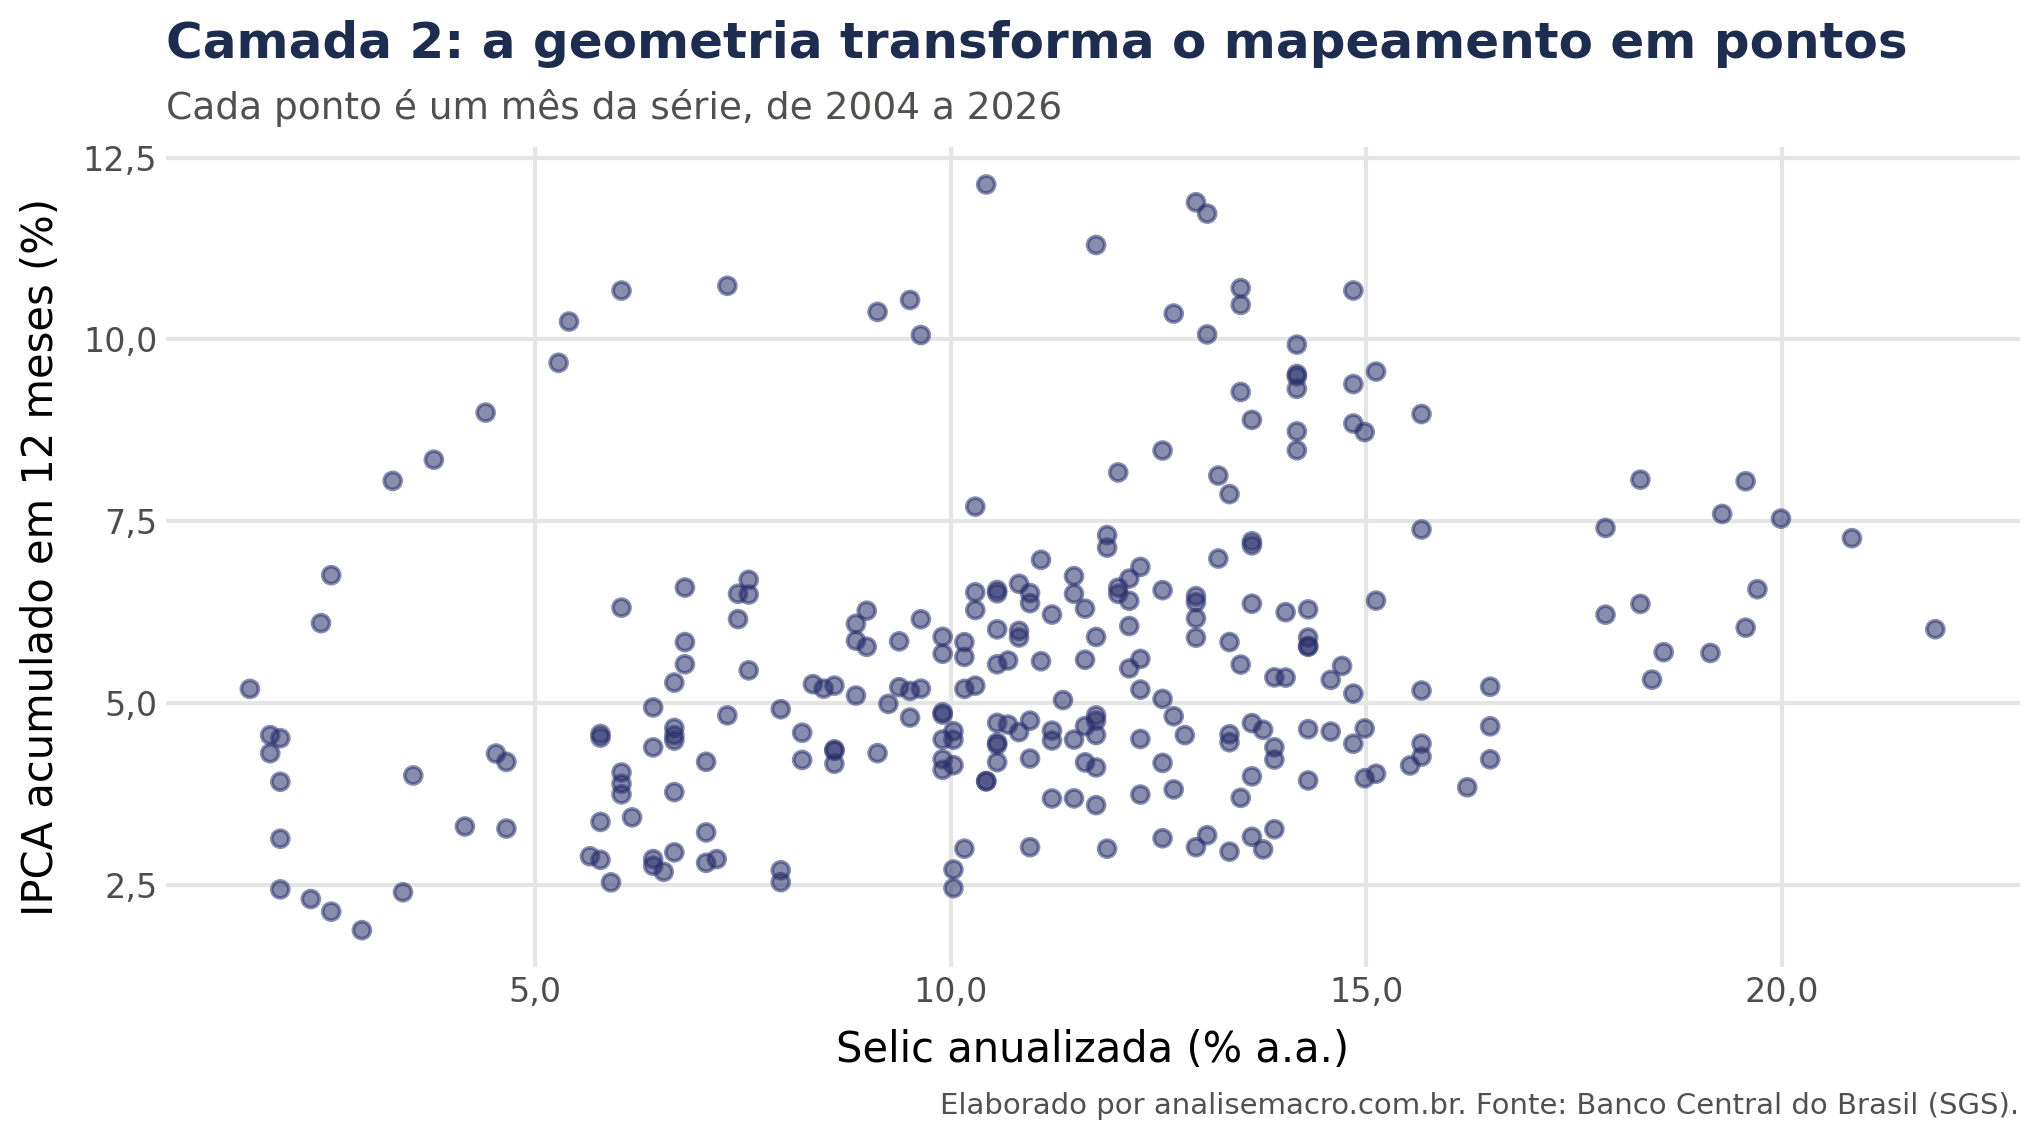
Os 261 meses da amostra aparecem. O argumento alpha controla a transparência, e isso importa porque muitos pontos se sobrepõem na região central: a transparência revela onde eles se acumulam.
A cor foi passada fora da função aes(), e essa distinção é o ponto mais confundido da gramática. Dentro do aes(), a cor vira função de uma coluna dos dados; fora dele, é uma constante aplicada a todos os pontos.
Camada 3: a cor como informação
Quando a cor entra dentro do aes(), ela deixa de ser decoração e passa a carregar informação. Mapeamos a década de cada observação.
(
    ggplot(dados)
    + aes(x="selic_anual", y="ipca_12m", color="decada")  # a cor agora é variável
    + geom_point(alpha=.6, size=1.8)
    + scale_color_manual(
        values=["#282f6b", "#1B998B", "#FF7A00"],
        name="Década"
    )
)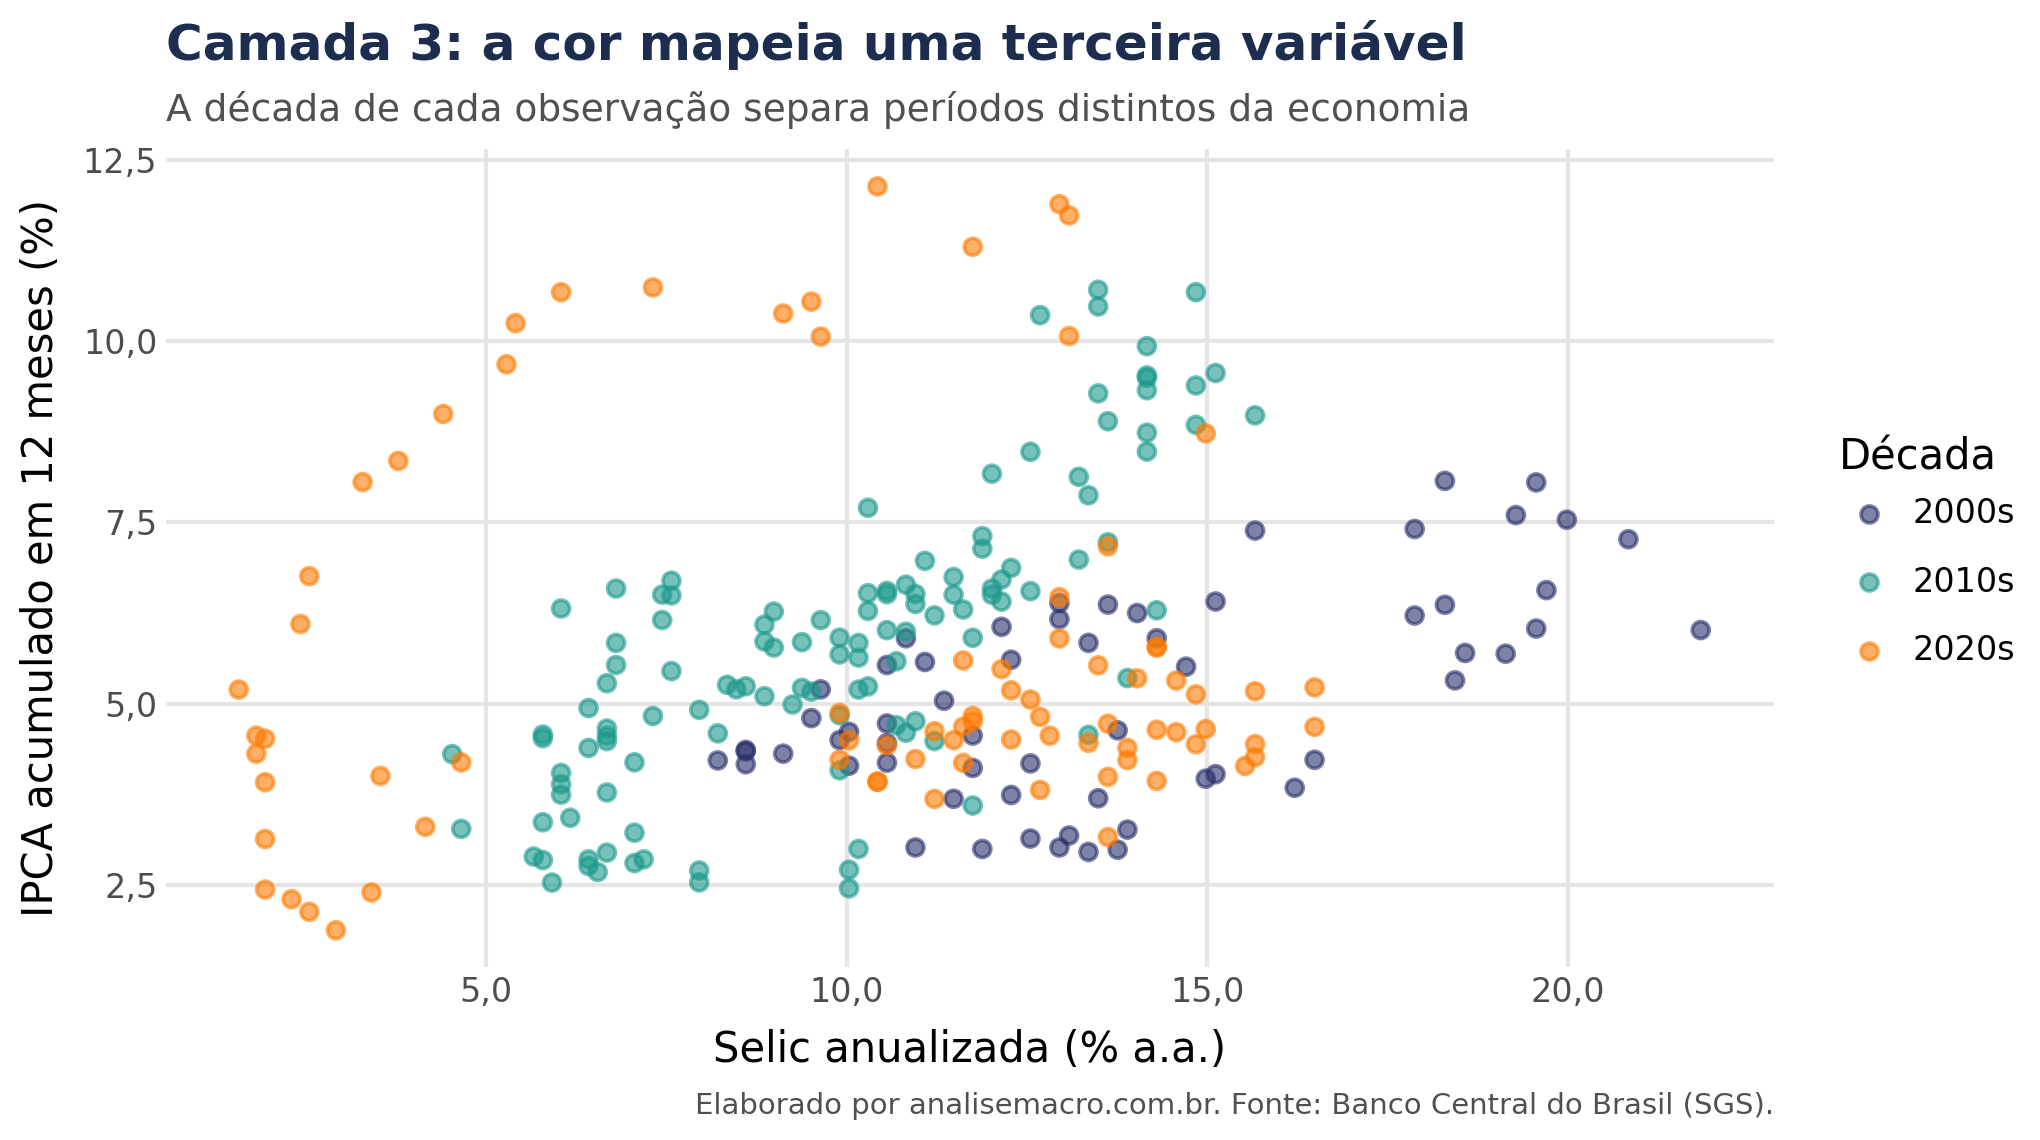
A legenda apareceu sozinha. Não a pedimos em nenhum momento: como a cor passou a representar uma variável, a gramática entende que o leitor precisa da chave de tradução entre cor e categoria.
A escala scale_color_manual() define quais cores correspondem a quais valores. Usamos a paleta da Análise Macro, com o azul-escuro na primeira posição.
Camada 4: estatística, facetas e tema
As três últimas camadas entram juntas. A transformação estatística ajusta uma reta de regressão por grupo, as facetas separam cada década em seu painel, e o tema cuida da aparência.
(
    ggplot(dados)
    + aes(x="selic_anual", y="ipca_12m", color="decada")
    + geom_point(alpha=.55, size=1.5)
    + stat_smooth(method="lm", se=False, size=1)   # a reta de regressão por grupo
    + facet_wrap("decada", nrow=1)                 # um painel por década
    + scale_color_manual(
        values=["#282f6b", "#1B998B", "#FF7A00"],
        guide=None                                 # a faceta já rotula
    )
    + labs(
        title="Juros e inflação caminham juntos, mas a relação muda a cada década",
        x="Selic anualizada (% a.a.)",
        y="IPCA acumulado em 12 meses (%)"
    )
    + theme_minimal(base_size=10)
)
A função stat_smooth() calcula uma regressão linear dentro de cada década e desenha a reta ajustada, com se=False suprimindo a faixa de erro-padrão. O cálculo acontece na hora de desenhar, e não exige criar colunas novas na tabela.
O facet_wrap() repete o mesmo gráfico para cada valor da coluna de década e mantém as escalas compartilhadas entre os painéis. A escala comum é o que torna os três painéis comparáveis entre si.
Na leitura do nosso exemplo, os anos 2000 e 2010 mostram retas inclinadas para cima, com juros mais altos convivendo com inflação mais alta. Nos anos 2020 a reta fica quase plana, e a nuvem se divide em duas regiões: juros baixos em 2020 e 2021, juros altos a partir de 2022.
Trocando uma camada por vez
O ganho da gramática aparece quando queremos uma variação do gráfico. Para ver a inflação ao longo do tempo em vez de contra os juros, mudamos o mapeamento do eixo x e a geometria, e o restante permanece.
(
    ggplot(dados)
    + aes(x="data", y="ipca_12m")                 # o tempo entra no eixo x
    + geom_line(color="#282f6b", size=.7)         # a geometria vira linha
    + geom_hline(yintercept=3, linetype="dashed", # a meta como referência
                 color="#b22200", size=.6)
)
Duas alterações produziram um gráfico de natureza diferente, e a estrutura do código permaneceu. O geom_hline() acrescentou uma linha horizontal na meta de inflação, e as geometrias se acumulam: a série e a meta convivem na mesma figura porque cada uma é uma camada somada à anterior.
Essa é a mesma lógica que usamos na análise exploratória para modelagem preditiva no Python, quando precisamos gerar muitas visões dos mesmos dados em pouco tempo.
Aplicações no dia a dia
A gramática dos gráficos rende mais em contextos onde a mesma figura precisa ser refeita muitas vezes, com pequenas variações.
- Relatórios recorrentes: o mesmo código gera o gráfico do mês seguinte quando o dado é atualizado, sem refazer a figura à mão.
- Comparação entre recortes: as facetas produzem um painel por estado, setor ou faixa de renda a partir de uma linha de código, e mantêm as escalas comparáveis.
- Padronização visual: o tema da instituição fica num objeto reutilizável, e todos os gráficos da equipe saem com a mesma identidade.
- Exploração rápida: trocar a geometria custa uma palavra, o que permite testar várias representações dos mesmos dados antes de escolher.
O caso do relatório recorrente costuma ser o que mais pesa. Uma planilha exige refazer a seleção de intervalo e a formatação a cada atualização, e o código refaz o gráfico inteiro a partir do dado novo.
Considerações finais
Aprender a gramática dos gráficos muda menos a aparência das figuras e mais a forma de pensá-las. Em vez de procurar o gráfico certo num catálogo, passamos a descrever o que queremos mostrar, e o gráfico resulta dessa descrição.
O benefício varia conforme a área de atuação:
- Analista de dados: a exploração fica mais rápida, porque testar uma representação nova custa a troca de uma camada.
- Economista: os gráficos de conjuntura passam a se atualizar sozinhos quando a série nova é publicada.
- Pesquisador: a figura do artigo fica reproduzível, e o revisor consegue refazer exatamente o mesmo gráfico.
- Gestor e profissional de risco: o relatório periódico ganha padrão visual estável, sem retrabalho manual a cada rodada.
- Quem trabalha em R e Python: a mesma gramática serve às duas linguagens, e o conhecimento transfere quase inteiro.
Quer construir análises como esta do zero?
Na formação Do Zero à Análise de Dados Econômicos e Financeiros usando Python e IA percorremos o caminho completo: coletar os dados nas fontes oficiais, tratá-los, analisá-los e apresentá-los em gráficos como os deste tutorial, sem pré-requisito de programação.
Se a intenção é acompanhar todas as trilhas da casa, o AM Black é a assinatura anual que dá acesso a todos os cursos.
Leia também
Referências
Wilkinson, L. (2005). The Grammar of Graphics. 2ª edição. Springer.
Wickham, H. (2010). A Layered Grammar of Graphics. Journal of Computational and Graphical Statistics, 19(1), 3-28.
Kibirige, H. (2024). Plotnine: A Grammar of Graphics for Python. Disponível em plotnine.org.