O PIB de um trimestre só é divulgado semanas depois que ele termina. Até lá, quem precisa decidir alguma coisa (um banco central, um gestor, uma empresa) trabalha sem o número mais importante da economia.
Só que o escuro não é total. Dezenas de indicadores mensais chegam bem antes, e todos carregam informação sobre para onde a atividade está indo. Nowcasting é a técnica que transforma esse fluxo de dados parciais numa estimativa do presente: prever não o ano que vem, mas o trimestre que está correndo agora.
O nome tem uma lógica: forecasting é prever o futuro, nowcasting é prever o presente. Parece contraditório prever algo que já aconteceu, mas não é. O trimestre terminou, a atividade econômica ocorreu, só que a medição dela ainda não existe. O que se prevê não é o que vai acontecer: é qual número o instituto de estatística vai publicar quando terminar de apurar. Pela mesma razão, a técnica serve para estimar o passado recente ainda não divulgado e o trimestre que está apenas começando.
O instrumento para isso é o modelo de fatores dinâmicos. Este guia percorre a construção dele do começo, sem pressupor conhecimento prévio de séries temporais:
- por que uma regressão comum não dá conta do problema;
- o que é um fator, e como ele transforma centenas de séries numa medida única de atividade;
- o que a formulação em espaço de estados acrescenta, e por que ela resolve o problema dos dados que faltam;
- quais decisões o analista precisa tomar ao especificar o modelo;
- como o modelo atribui cada revisão da previsão ao indicador que a causou.
O PIB americano do quarto trimestre de 2024 entra como caso de aplicação, acompanhado divulgação a divulgação.
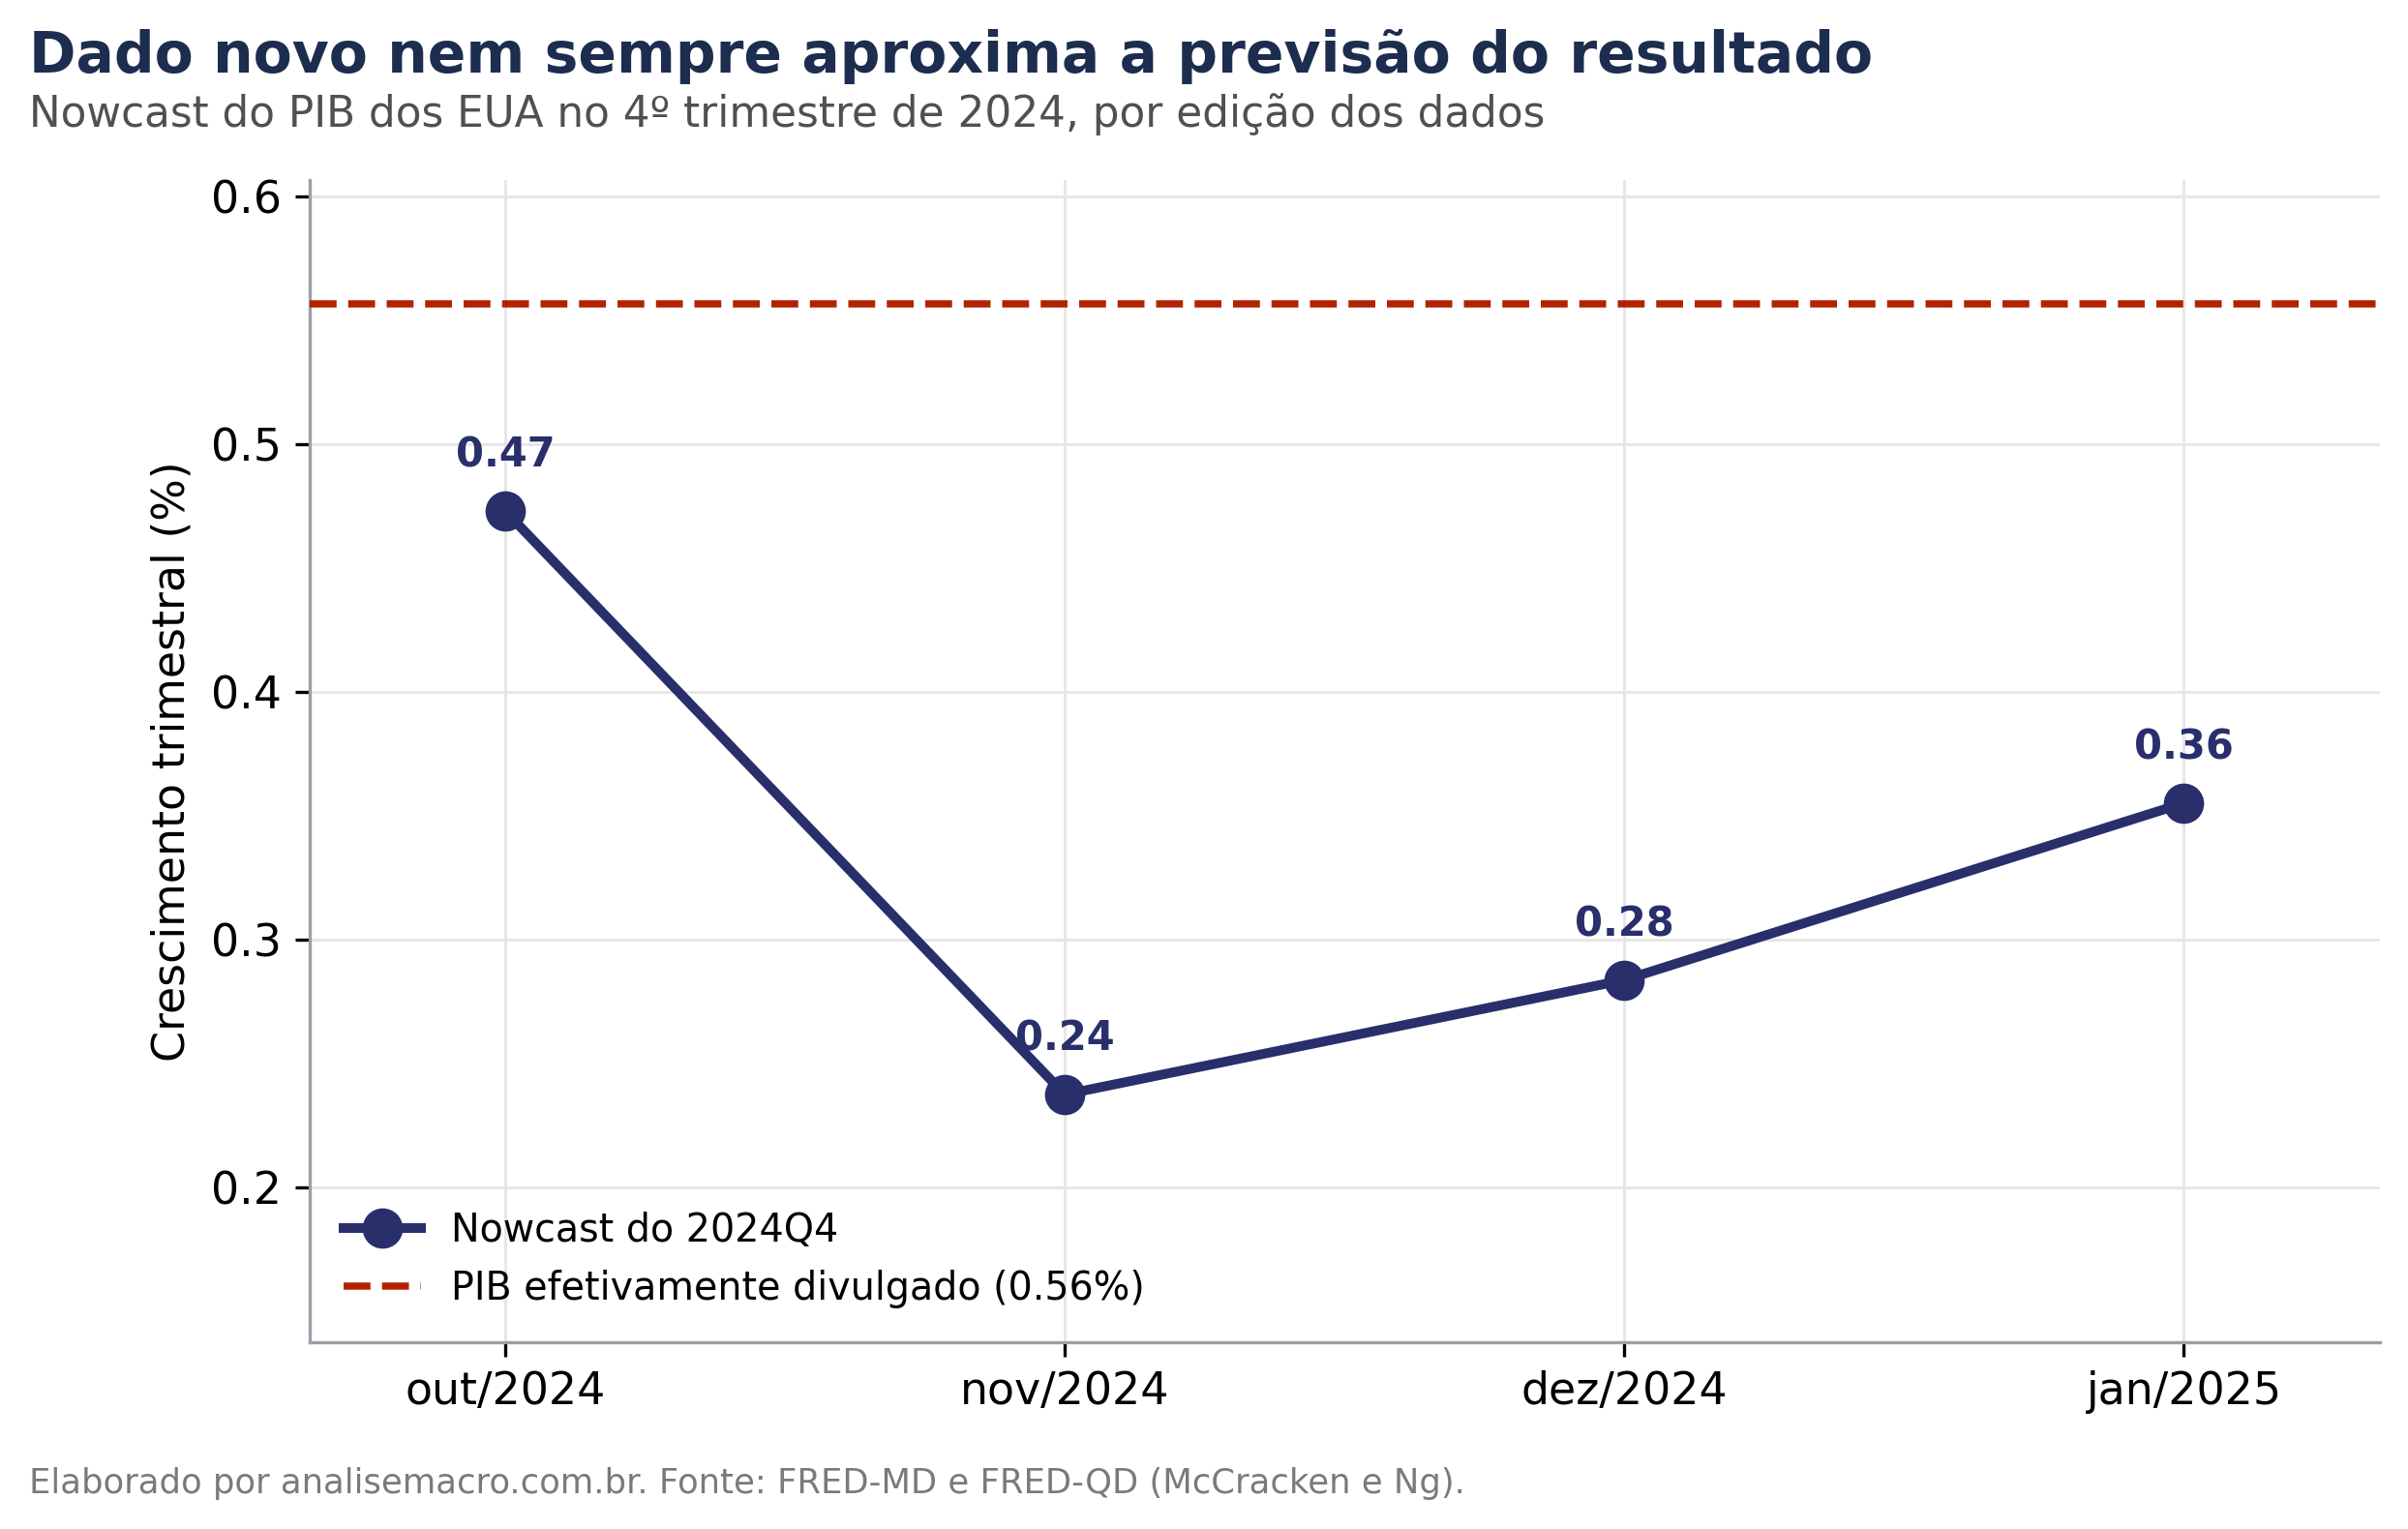
É assim que um nowcast se comporta: a estimativa do mesmo trimestre é refeita a cada divulgação, e sobe ou desce conforme o dado que chega surpreende o modelo. Entender o que produz esse movimento é o objetivo deste guia.
Código do exercício
O código com o modelo de fatores dinâmicos para o PIB e a decomposição das surpresas a cada divulgação está disponível em:
O problema: muitas variáveis, poucas observações
A ideia intuitiva do nowcasting é direta: junte todos os indicadores disponíveis e extraia deles um sinal sobre a atividade. Produção industrial, vendas no varejo, folha de pagamento, pedidos de seguro-desemprego, licenças de construção, confiança do consumidor — cada um observa um pedaço da economia, e todos chegam antes do PIB.
O obstáculo aparece na primeira tentativa de fazer isso com uma regressão linear, o método usual de explicar uma variável a partir de outras. A regressão estima um coeficiente para cada variável explicativa, e cada coeficiente é um número que precisa ser extraído dos dados. Para isso, ela precisa de mais observações do que coeficientes a estimar.
A aritmética não fecha. O painel traz mais de cem indicadores mensais, e o PIB trimestral tem um histórico de poucas dezenas de trimestres úteis — cada ano contribui com apenas quatro observações. São mais coeficientes a estimar do que observações para estimá-los, e o modelo deixa de ser identificável: existe uma infinidade de combinações de coeficientes que reproduzem os dados igualmente bem, e nada nos dados permite escolher entre elas.
Reduzir o painel a meia dúzia de séries escolhidas a dedo resolveria a contagem, mas cria dois problemas no lugar. Descarta informação que estava disponível, e faz a previsão depender de qual indicador o analista julgou relevante — dois analistas com o mesmo painel chegam a previsões diferentes.
E mesmo com um painel menor, um modelo com muitas variáveis tende ao sobreajuste: com liberdade suficiente, ele passa a descrever também o ruído da amostra, não só o padrão. O ajuste ao passado fica excelente e a previsão fora da amostra piora, porque o ruído que ele aprendeu não se repete.
Somam-se três complicações práticas:
Frequências diferentes. Os indicadores são mensais, o PIB é trimestral. Um modelo estatístico comum espera que todas as variáveis sejam observadas na mesma periodicidade, e aqui, para cada valor de PIB, existem três de cada indicador. Somar ou tirar média dos três meses resolveria a incompatibilidade, mas descartaria justamente a informação intramensal que dá ao nowcasting sua vantagem: saber que o primeiro mês do trimestre veio forte é informação sobre o trimestre.
Calendários irregulares. Cada série é divulgada num dia diferente do mês. O emprego sai no início, a produção industrial no meio, as vendas no varejo depois. O painel, portanto, nunca está completo: em qualquer data que se olhe, algumas séries já trazem o mês anterior e outras ainda não.
Dados faltantes na ponta. Consequência do item anterior, e o mais problemático dos três. No dia 10 de um mês, alguns indicadores do mês anterior já saíram, outros não. Se organizarmos o painel como uma tabela com as séries nas colunas e o tempo nas linhas, as últimas linhas ficam parcialmente vazias, e o preenchimento varia de coluna para coluna. A literatura chama esse formato de ragged edge, a borda irregular do painel.
O problema prático é que a maioria dos métodos estatísticos exige uma tabela retangular completa. Diante de células vazias, ou descartam a linha inteira — jogando fora exatamente os meses mais recentes, que são os que interessam — ou exigem que se invente um valor para o que falta. Nenhuma das duas saídas serve quando a informação da ponta é o objeto da análise.
A solução: fatores dinâmicos
A saída começa por uma observação sobre os dados: as dezenas de séries não se movem de forma independente. Quando a economia acelera, produção, emprego e vendas tendem a subir juntos; quando desacelera, caem juntos. Elas compartilham um pequeno número de forças comuns — o ciclo econômico, em essência — e cada série é uma combinação dessas forças mais um componente próprio.
Um fator é o nome dessa fonte comum de variação. Ele tem uma característica que o distingue das variáveis usuais: não é observado diretamente. Não existe uma série chamada "atividade econômica" para baixar de uma base de dados. O fator é estimado a partir daquilo que as séries observadas têm de movimento compartilhado.
Um exemplo torna a ideia concreta. O consumo de energia elétrica, a produção industrial e a confiança do consumidor reagem à atividade econômica de formas diferentes: um mede insumo, outro mede produto, o terceiro mede expectativa; um responde rápido, outro com defasagem. Nenhum dos três é a atividade econômica, e qualquer um deles isoladamente traz também ruído próprio — uma onda de calor mexe no consumo de energia sem dizer nada sobre a economia. Mas o que os três têm em comum, o movimento que aparece nos três ao mesmo tempo, é uma medida indireta da atividade. O ruído particular de cada um não se repete nos outros e, ao se extrair o componente comum, ele fica de fora.
Como o modelo escreve isso
O modelo formaliza a ideia em duas equações. A primeira liga o que se observa ao fator:
yt = Λ ft + εt
Cada símbolo tem uma leitura direta. O vetor yt reúne todas as séries observadas no período t — as mais de cem colunas do painel. O vetor ft traz os fatores comuns, que são poucos. A matriz Λ guarda as cargas fatoriais: cada carga mede o quanto uma série responde ao fator. E εt é o componente idiossincrático, a parte do movimento de cada série que o fator não explica.
A leitura econômica dessa equação é a separação entre o que é comum e o que é particular. Séries fortemente ligadas ao ciclo recebem carga alta e pesam muito na estimativa do fator. Séries que se movem principalmente por razões próprias recebem carga baixa e influenciam pouco — o modelo aprende sozinho, a partir da covariância dos dados, quanto crédito dar a cada indicador.
A segunda equação descreve como o fator se comporta ao longo do tempo:
ft = A1 ft−1 + … + Ap ft−p + ut
É um processo autorregressivo: o valor do fator hoje depende dos seus próprios valores passados. Essa é a parte "dinâmica" do modelo de fatores dinâmicos, e ela carrega um fato econômico. O ciclo tem inércia — uma economia em aceleração tende a continuar acelerando por algum tempo, e não salta de um estado a outro a cada mês. É essa persistência que permite ao modelo projetar o fator para períodos em que ainda não há dado nenhum.
Por que isso resolve o problema da dimensão. Em vez de estimar um coeficiente por série, estima-se a carga de cada série sobre um punhado de fatores, e toda a dinâmica temporal é modelada no fator, não em cada indicador. Acrescentar mais uma série ao painel acrescenta uma carga, não uma nova equação dinâmica. O problema que não cabia nos dados passa a caber.
O espaço de estados e o filtro de Kalman
Escrever o modelo em espaço de estados é o que resolve as outras duas dificuldades. Espaço de estados é uma forma de organizar um modelo em que se separa aquilo que se quer conhecer, mas não se enxerga, daquilo que se enxerga. O que se quer conhecer é o estado — aqui, o fator, a atividade econômica subjacente. O que se enxerga são as observações, as séries divulgadas, entendidas como medições imperfeitas e ruidosas desse estado.
A analogia clássica é a de rastrear a posição de um navio a partir de instrumentos imprecisos. A posição verdadeira é o estado, que ninguém observa; cada leitura de instrumento é uma medição com erro. Nenhuma leitura isolada dá a posição, mas o conjunto delas, combinado com o conhecimento de como um navio se desloca, permite estimá-la bem — e revisá-la a cada nova leitura.
O filtro de Kalman é o procedimento que faz essa combinação. Ele percorre o painel período a período repetindo dois passos. No primeiro, projeta o estado do período seguinte usando a equação dinâmica, ou seja, o que o fator tende a fazer dada sua persistência. No segundo, compara essa projeção com os dados que efetivamente chegaram e corrige a estimativa, dando mais peso às séries de carga alta e menos às ruidosas.
Desse mecanismo decorrem exatamente as três propriedades que o problema exigia:
🧩
🗓️
🔄
A borda irregular, que inviabilizava os métodos de painel completo, deixa de ser obstáculo: ela é o funcionamento normal do filtro, não uma exceção a tratar.
Como os parâmetros são estimados
Falta dizer de onde saem as cargas e os coeficientes autorregressivos. Eles são estimados por máxima verossimilhança, o critério que escolhe os valores sob os quais os dados observados seriam os mais prováveis de ocorrer.
Com um painel grande, porém, há centenas ou milhares de parâmetros, e os métodos de otimização usuais em séries temporais têm dificuldade em encontrar o máximo numa superfície dessa dimensão. A estimação recorre então ao algoritmo EM (esperança-maximização), que alterna dois passos mais simples: dado um conjunto de parâmetros, estima os fatores não observados; dados esses fatores, reestima os parâmetros. A repetição converge, e o procedimento é mais estável nessa escala do que a otimização direta.
A implementação segue Bańbura e Modugno (2014), que estende o método para painéis com frequências mistas e dados faltantes arbitrários, e a especificação de frequência mista segue Mariano e Murasawa (2010). No Python, está na classe DynamicFactorMQ do statsmodels.
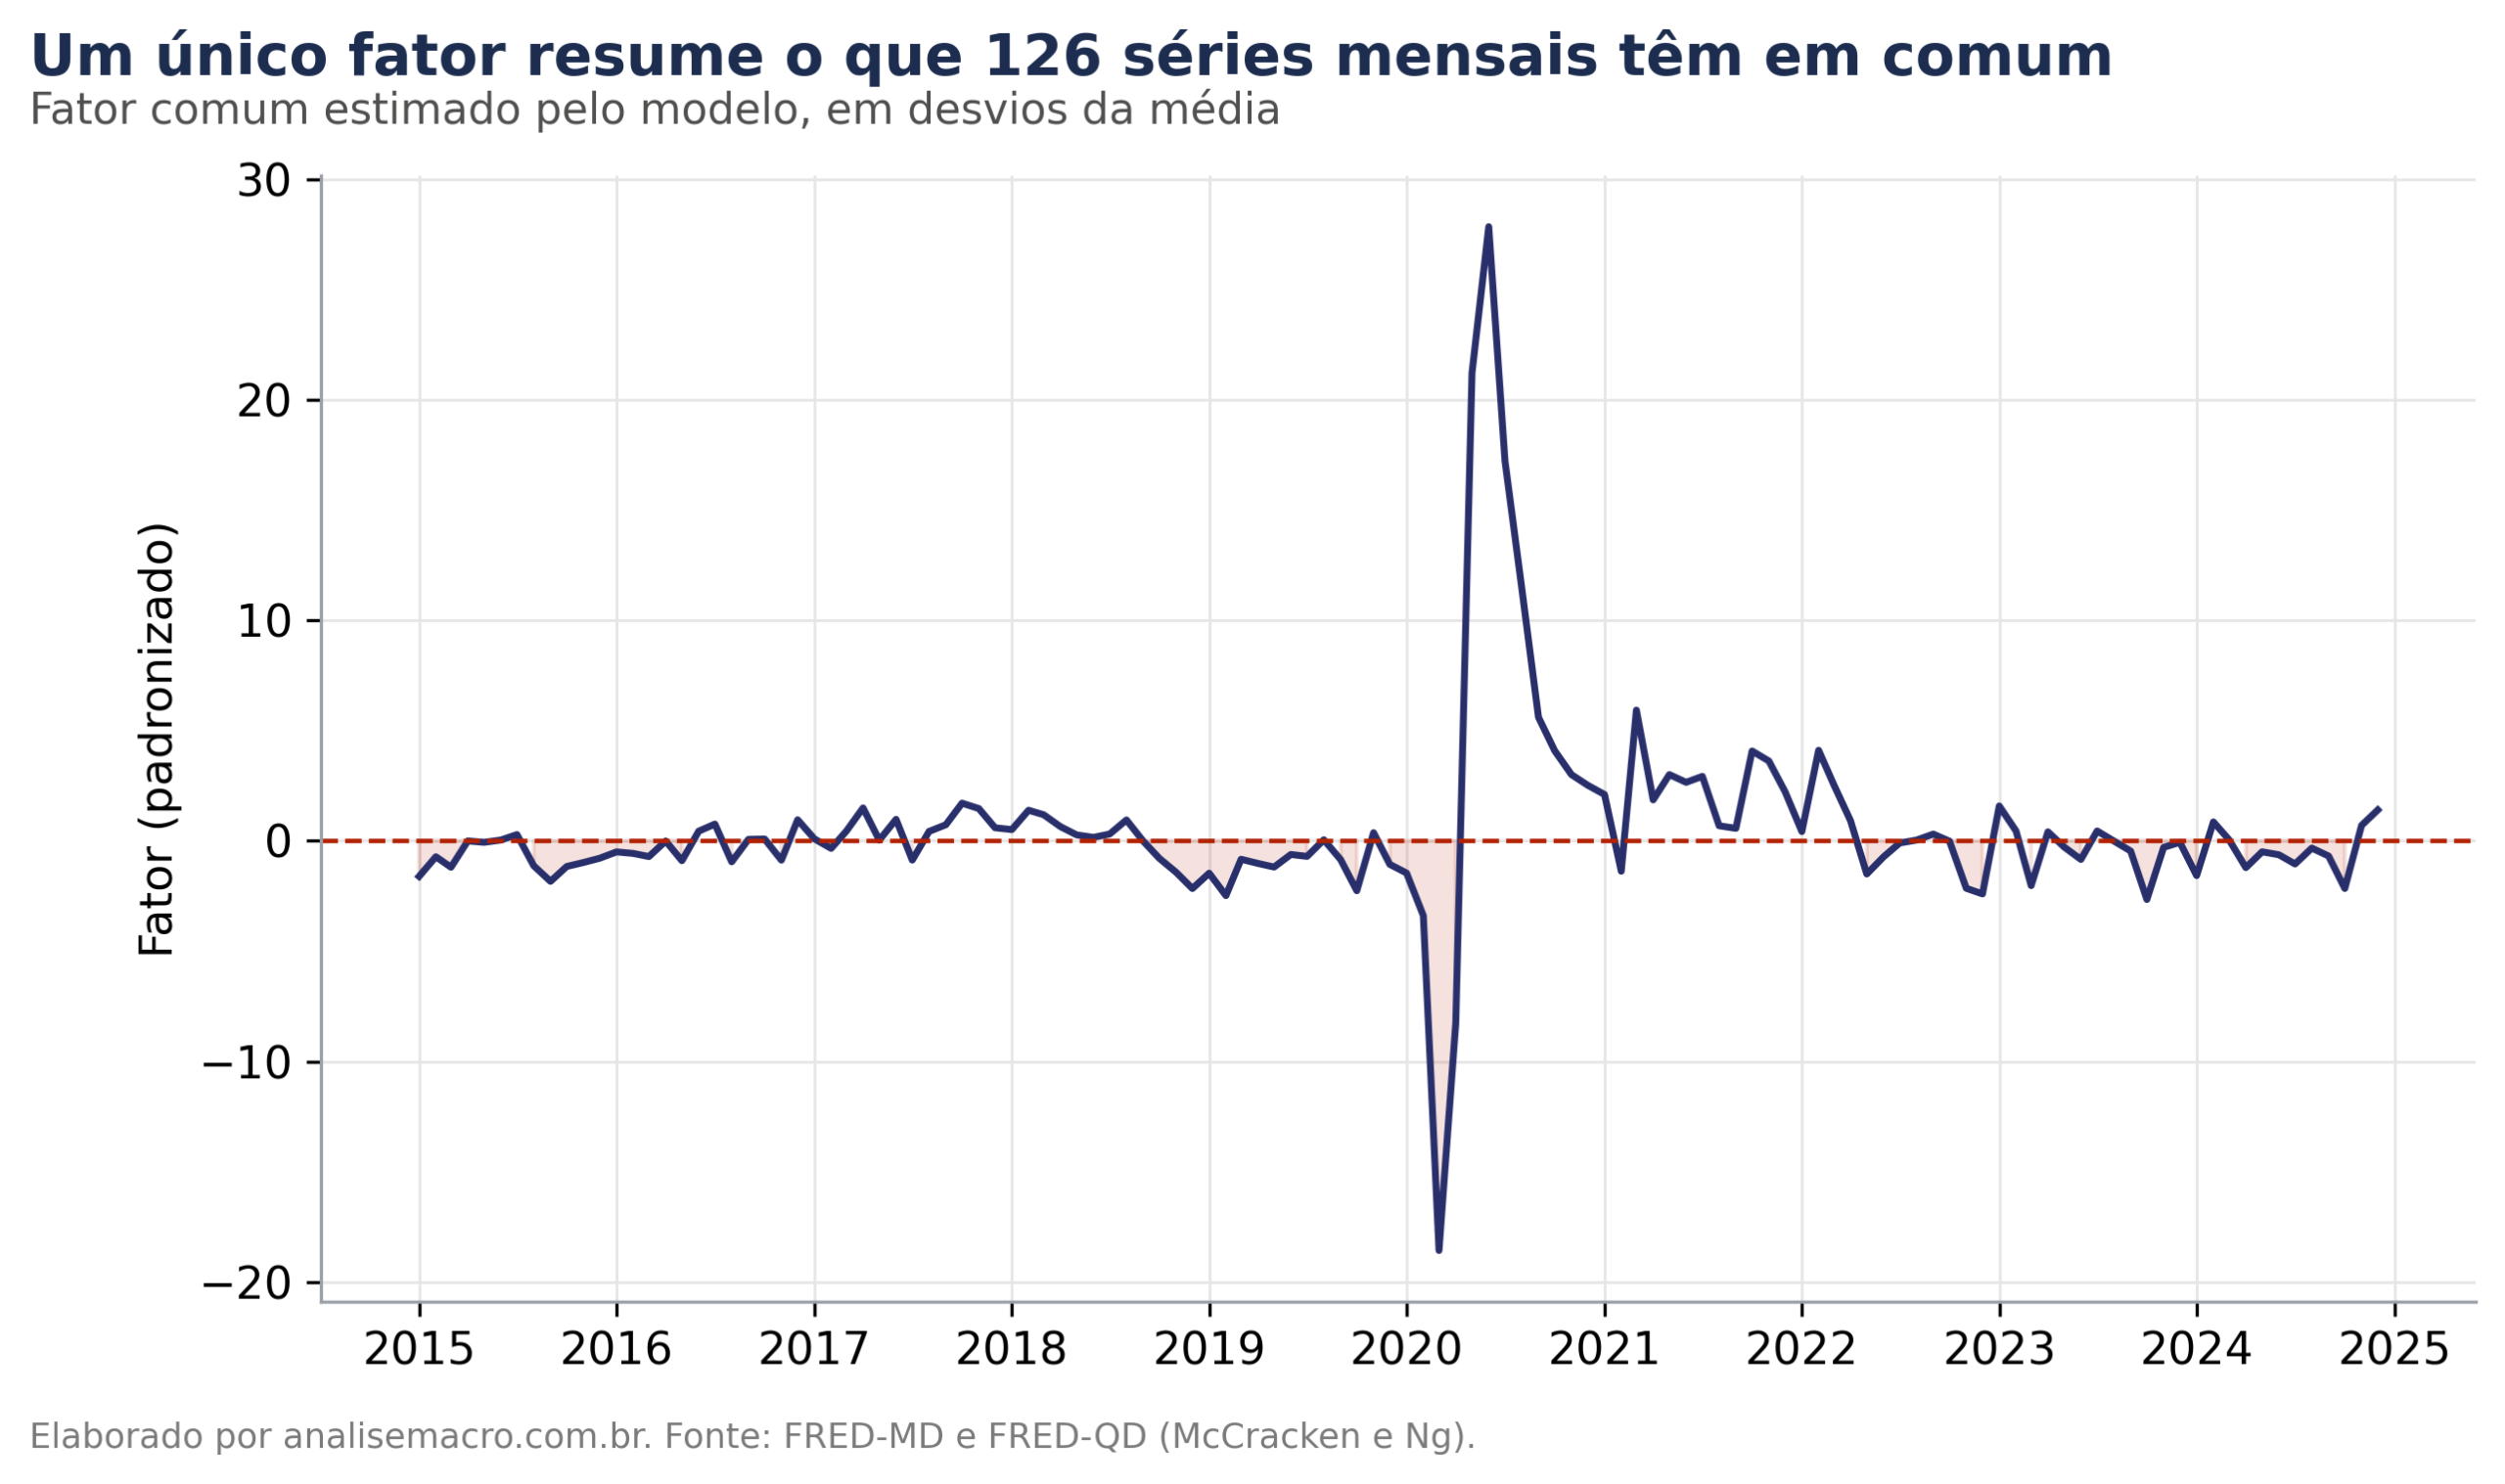
O gráfico mostra o resultado da extração: uma série única que resume o movimento compartilhado por mais de cem indicadores. É o fator comum, a medida indireta de atividade construída a partir do que as séries têm em comum.
Vale observar como se lê essa série. O fator não tem unidade — não está em reais, nem em porcentagem, nem em índice com base 100. Ele é uma quantidade padronizada, e o que informa é o movimento: períodos acima de zero indicam atividade acima da média do período estimado, abaixo de zero o contrário. Comparar dois pontos da série faz sentido; perguntar quanto "vale" um ponto isolado, não.
A queda de 2020 é inconfundível, e a magnitude dela ilustra por que o tratamento de valores extremos precisa ser feito com critério: aquele movimento é real, não erro de medida. É também um bom teste de sanidade do modelo — se o fator extraído não mostrasse a recessão da pandemia, algo estaria errado na estimação.
Por que os dados precisam ser históricos
Aqui está um ponto que costuma passar despercebido e é central no nowcasting: os dados econômicos são revisados.
Se você baixar hoje a série do PIB de 2024, verá os valores já revistos. Mas quem fazia a previsão em outubro de 2024 não tinha esses números — tinha os que estavam disponíveis naquele momento.
Por que as séries mudam depois de publicadas: os institutos divulgam uma primeira estimativa com a amostra que conseguiram apurar no prazo e, nos meses seguintes, incorporam respostas que chegaram atrasadas, corrigem classificações e atualizam fatores sazonais. A revisão não é erro; é o procedimento normal de apuração.
Isso cria uma armadilha ao avaliar previsões. Usar os dados revisados para julgar uma previsão feita no passado incorpora à avaliação informação que não existia no momento da previsão. O modelo aparenta acertar mais do que teria acertado no momento da decisão, porque foi alimentado com uma versão dos dados que só ficou disponível depois. É o problema do look-ahead bias, o viés de antevisão, e ele infla artificialmente a qualidade aparente de qualquer modelo — não só de nowcasting.
A solução são as vintages: fotografias da base tal como ela estava em cada mês. As bases FRED-MD e FRED-QD, mantidas pelo Federal Reserve de St. Louis a partir do trabalho de McCracken e Ng (2016), publicam essas edições históricas.
Usamos quatro edições consecutivas — outubro, novembro e dezembro de 2024, e janeiro de 2025. Na primeira, o PIB do quarto trimestre era uma incógnita; na última, já havia sido divulgado.
Transformações e um detalhe que quebra o código
O modelo pressupõe que as séries sejam estacionárias, uma propriedade que vale definir. Uma série é estacionária quando suas características estatísticas não mudam ao longo do tempo: ela oscila em torno de um nível estável, com dispersão parecida em qualquer trecho da amostra. A série do emprego total não é assim — cresce década após década, e o nível dos anos 1990 nada tem a ver com o de hoje.
A exigência não é capricho. Um modelo de fatores procura o que as séries têm em comum, e séries com tendência têm em comum, antes de tudo, o próprio fato de crescerem. O fator extraído capturaria a tendência compartilhada em vez do ciclo, que é o objeto de interesse. Transformar as séries — tomando a diferença entre períodos, o logaritmo, ou a variação percentual — remove a tendência e deixa a oscilação em torno dela, que é o sinal de conjuntura.
As bases já trazem a solução embutida: a primeira linha de cada arquivo é um código que indica qual transformação aplicar àquela coluna. Cada série tem seu tratamento próprio, definido por quem mantém a base — uma taxa de juros e um índice de preços não pedem a mesma transformação.
Só que a edição de janeiro de 2025 traz uma série com código 0, fora da escala de 1 a 7 prevista. Isso acontece quando uma série é acrescentada ou reclassificada entre edições, e um código que não trate o caso levanta exceção e para no meio da coleta. Sem código válido não há como tornar a série estacionária, então o correto é deixá-la fora do painel.
Valores extremos, e um cuidado com o período
Séries econômicas trazem observações muito distantes das demais, seja por erro de medida, seja por eventos genuinamente atípicos. Como o modelo estima a covariância entre as séries, uma única observação extrema desloca a estimativa das cargas e contamina o fator.
McCracken e Ng recomendam remover observações que se afastem mais de dez vezes o intervalo interquartil em relação à mediana. O intervalo interquartil é a distância entre o primeiro e o terceiro quartil, ou seja, a faixa que contém a metade central das observações — é uma medida de dispersão pouco sensível justamente aos extremos, o que a torna adequada para detectá-los.
Há um cuidado importante quanto ao período em que essa limpeza é aplicada. O exercício remove os extremos apenas até o fim de 2023 e preserva 2024 intacto. A razão é direta: o trimestre que se quer prever está em 2024, e uma observação incomum desse período pode ser exatamente o sinal que se busca — descartá-la seria jogar fora a informação, não o ruído.
Especificando o modelo: três decisões
Com os dados tratados, três escolhas definem o modelo. Nenhuma delas é dada pelos dados: todas são decisões do analista, e cada uma tem um custo do outro lado.
Quantos fatores? O exercício usa um. Para captar o ciclo econômico agregado, um fator costuma bastar, e é a escolha do trabalho original de Bańbura e Modugno. Mais fatores permitem captar nuances setoriais — um ciclo industrial distinto de um ciclo de serviços, por exemplo — ao custo de mais parâmetros a estimar e maior risco de sobreajuste.
Quantas defasagens no fator? Uma. O fator segue um processo AR(1), em que o valor de hoje depende apenas do valor do período anterior. Isso já incorpora a persistência do ciclo sem complicar a estimação. Mais defasagens permitiriam dinâmicas mais ricas, como oscilações de período mais longo.
O componente idiossincrático é autorregressivo? Sim. Essa escolha permite que a parte específica de cada série tenha persistência própria, em vez de ser ruído sem memória. Melhora o ajuste em séries que têm dinâmica própria forte, e evita que essa dinâmica seja empurrada indevidamente para dentro do fator comum.
A amostra começa em 2000, para evitar quebras estruturais mais antigas — mudanças de regime que alterariam a relação entre as séries e o fator ao longo do período estimado.
O método aplicado a um trimestre
Com o modelo montado, o exercício o aplica ao quarto trimestre de 2024 e refaz a previsão em cada uma das quatro edições dos dados. A comparação com o valor efetivamente divulgado:
Todas as edições subestimaram o crescimento, e a de novembro foi a mais distante do valor final. A trajetória merece leitura cuidadosa, porque ela contraria a expectativa natural de que acumular mais dados aproxime a previsão do resultado.
Não foi o que aconteceu. A estimativa de outubro, feita com menos informação, era a mais próxima; os dados de novembro empurraram a previsão para baixo; das edições seguintes em diante o modelo foi se recuperando, sem alcançar o valor efetivo. O que explica esse comportamento é que o movimento da previsão não depende da quantidade de dados acumulada, e sim do quanto o que chegou surpreendeu o modelo. Os indicadores divulgados em novembro descreviam uma economia mais fraca do que ela se revelou, e o modelo refletiu corretamente o que os dados diziam naquele momento.
A seção sobre as news abre essa conta indicador por indicador.
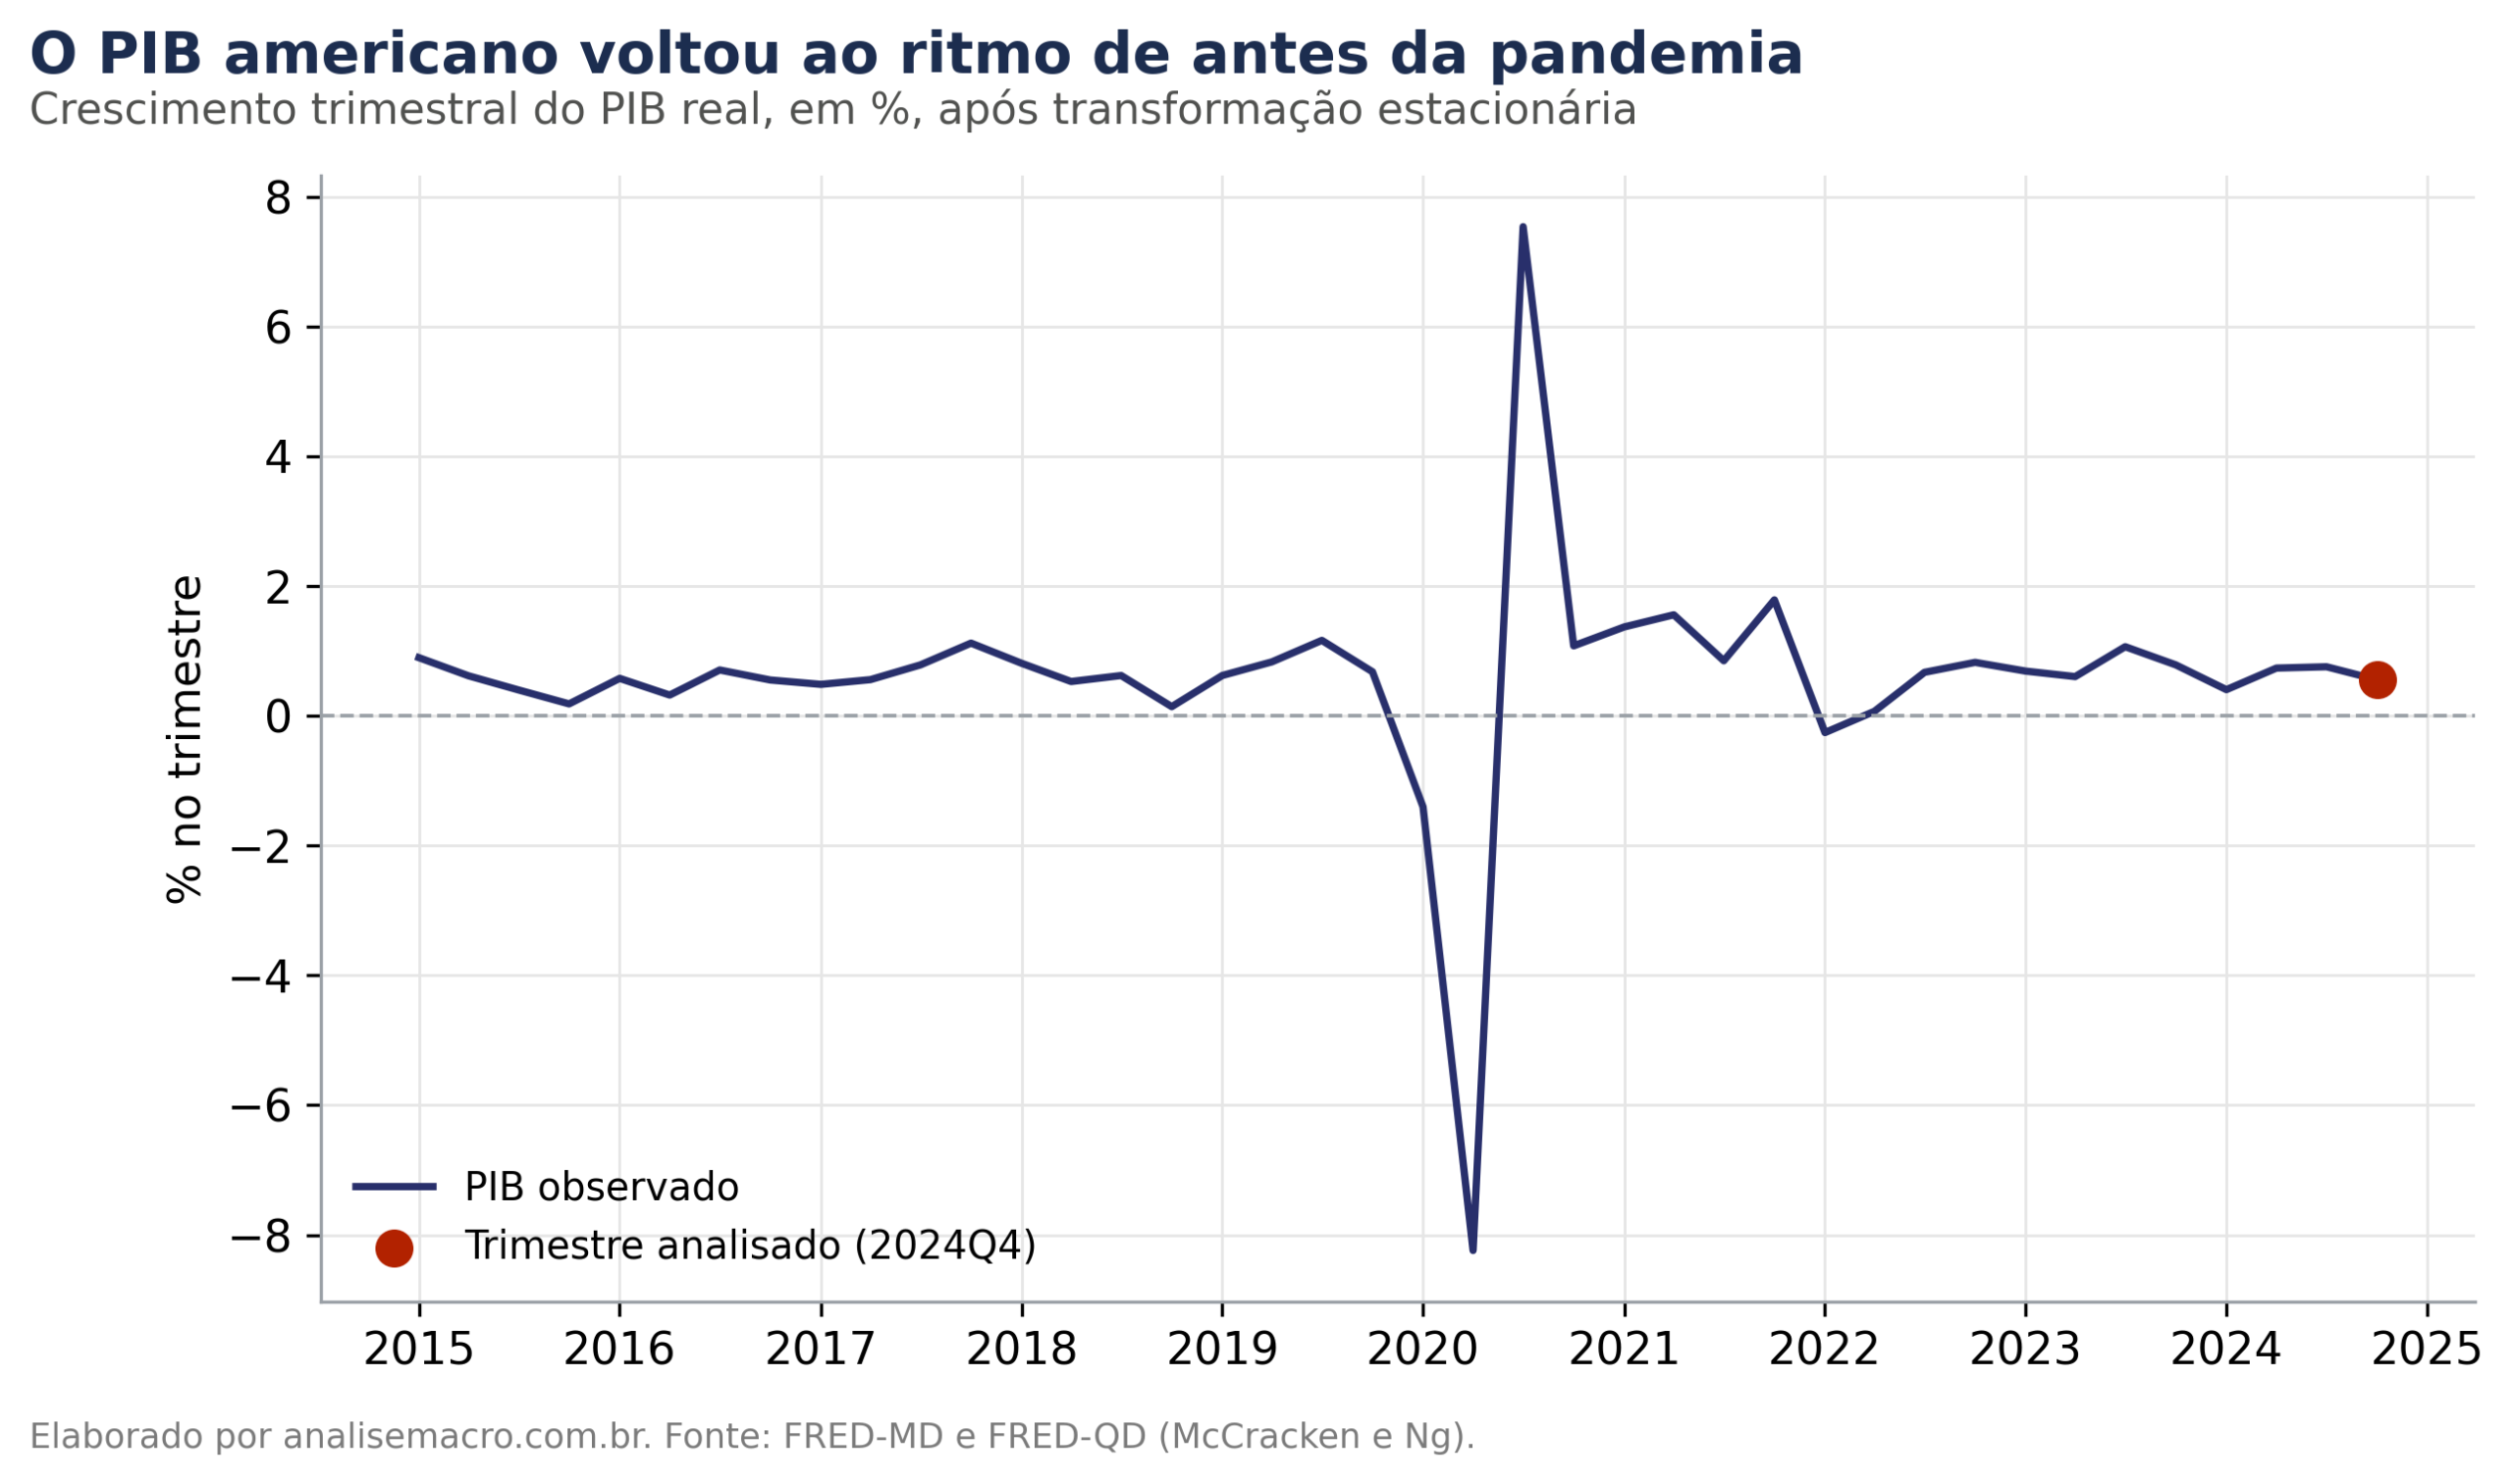
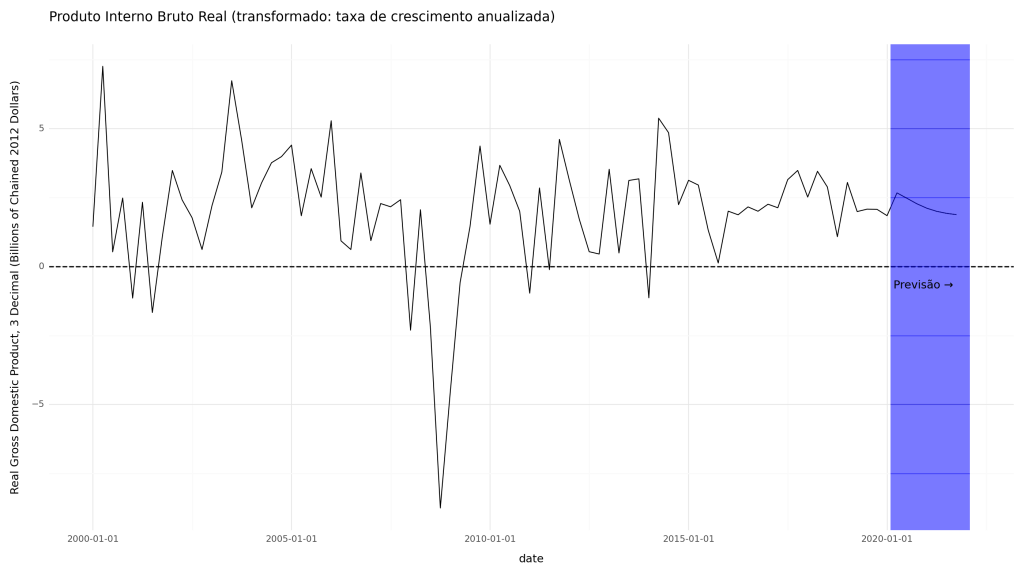
Visto na série completa, o quarto trimestre de 2024 não tem nada de excepcional — está dentro da faixa em que o PIB americano vem oscilando desde a normalização pós-pandemia. É justamente essa banalidade que torna o caso instrutivo: o modelo errou por uma fração de ponto percentual num trimestre comum, sem choques.
A previsão é a melhor leitura possível com a informação disponível em cada momento, e não um oráculo sobre o resultado final. Avaliar um modelo de nowcasting pelo acerto de um único trimestre seria confundir sorte com qualidade: a avaliação séria se faz em janelas longas, comparando o erro médio contra alternativas simples, como uma média histórica ou um modelo autorregressivo.
As news: o que cada dado acrescentou
A formulação em espaço de estados permite decompor a revisão da previsão. Quando o nowcast muda entre duas edições, o modelo responde qual dado causou a mudança e em que magnitude.
O raciocínio tem três passos. Antes de cada divulgação, o modelo já tem uma expectativa para aquele indicador, formada pelo fator estimado até ali. O que efetivamente sai difere dessa expectativa, e a diferença é a news, a surpresa. Essa surpresa entra na atualização do fator e, pela carga fatorial da série, se propaga até a previsão do PIB.
Duas consequências decorrem disso. Um dado que sai exatamente como esperado não move a previsão, por mais central que a série seja para a economia. E o tamanho do movimento depende de duas coisas ao mesmo tempo: da magnitude da surpresa e da carga daquela série sobre o fator.
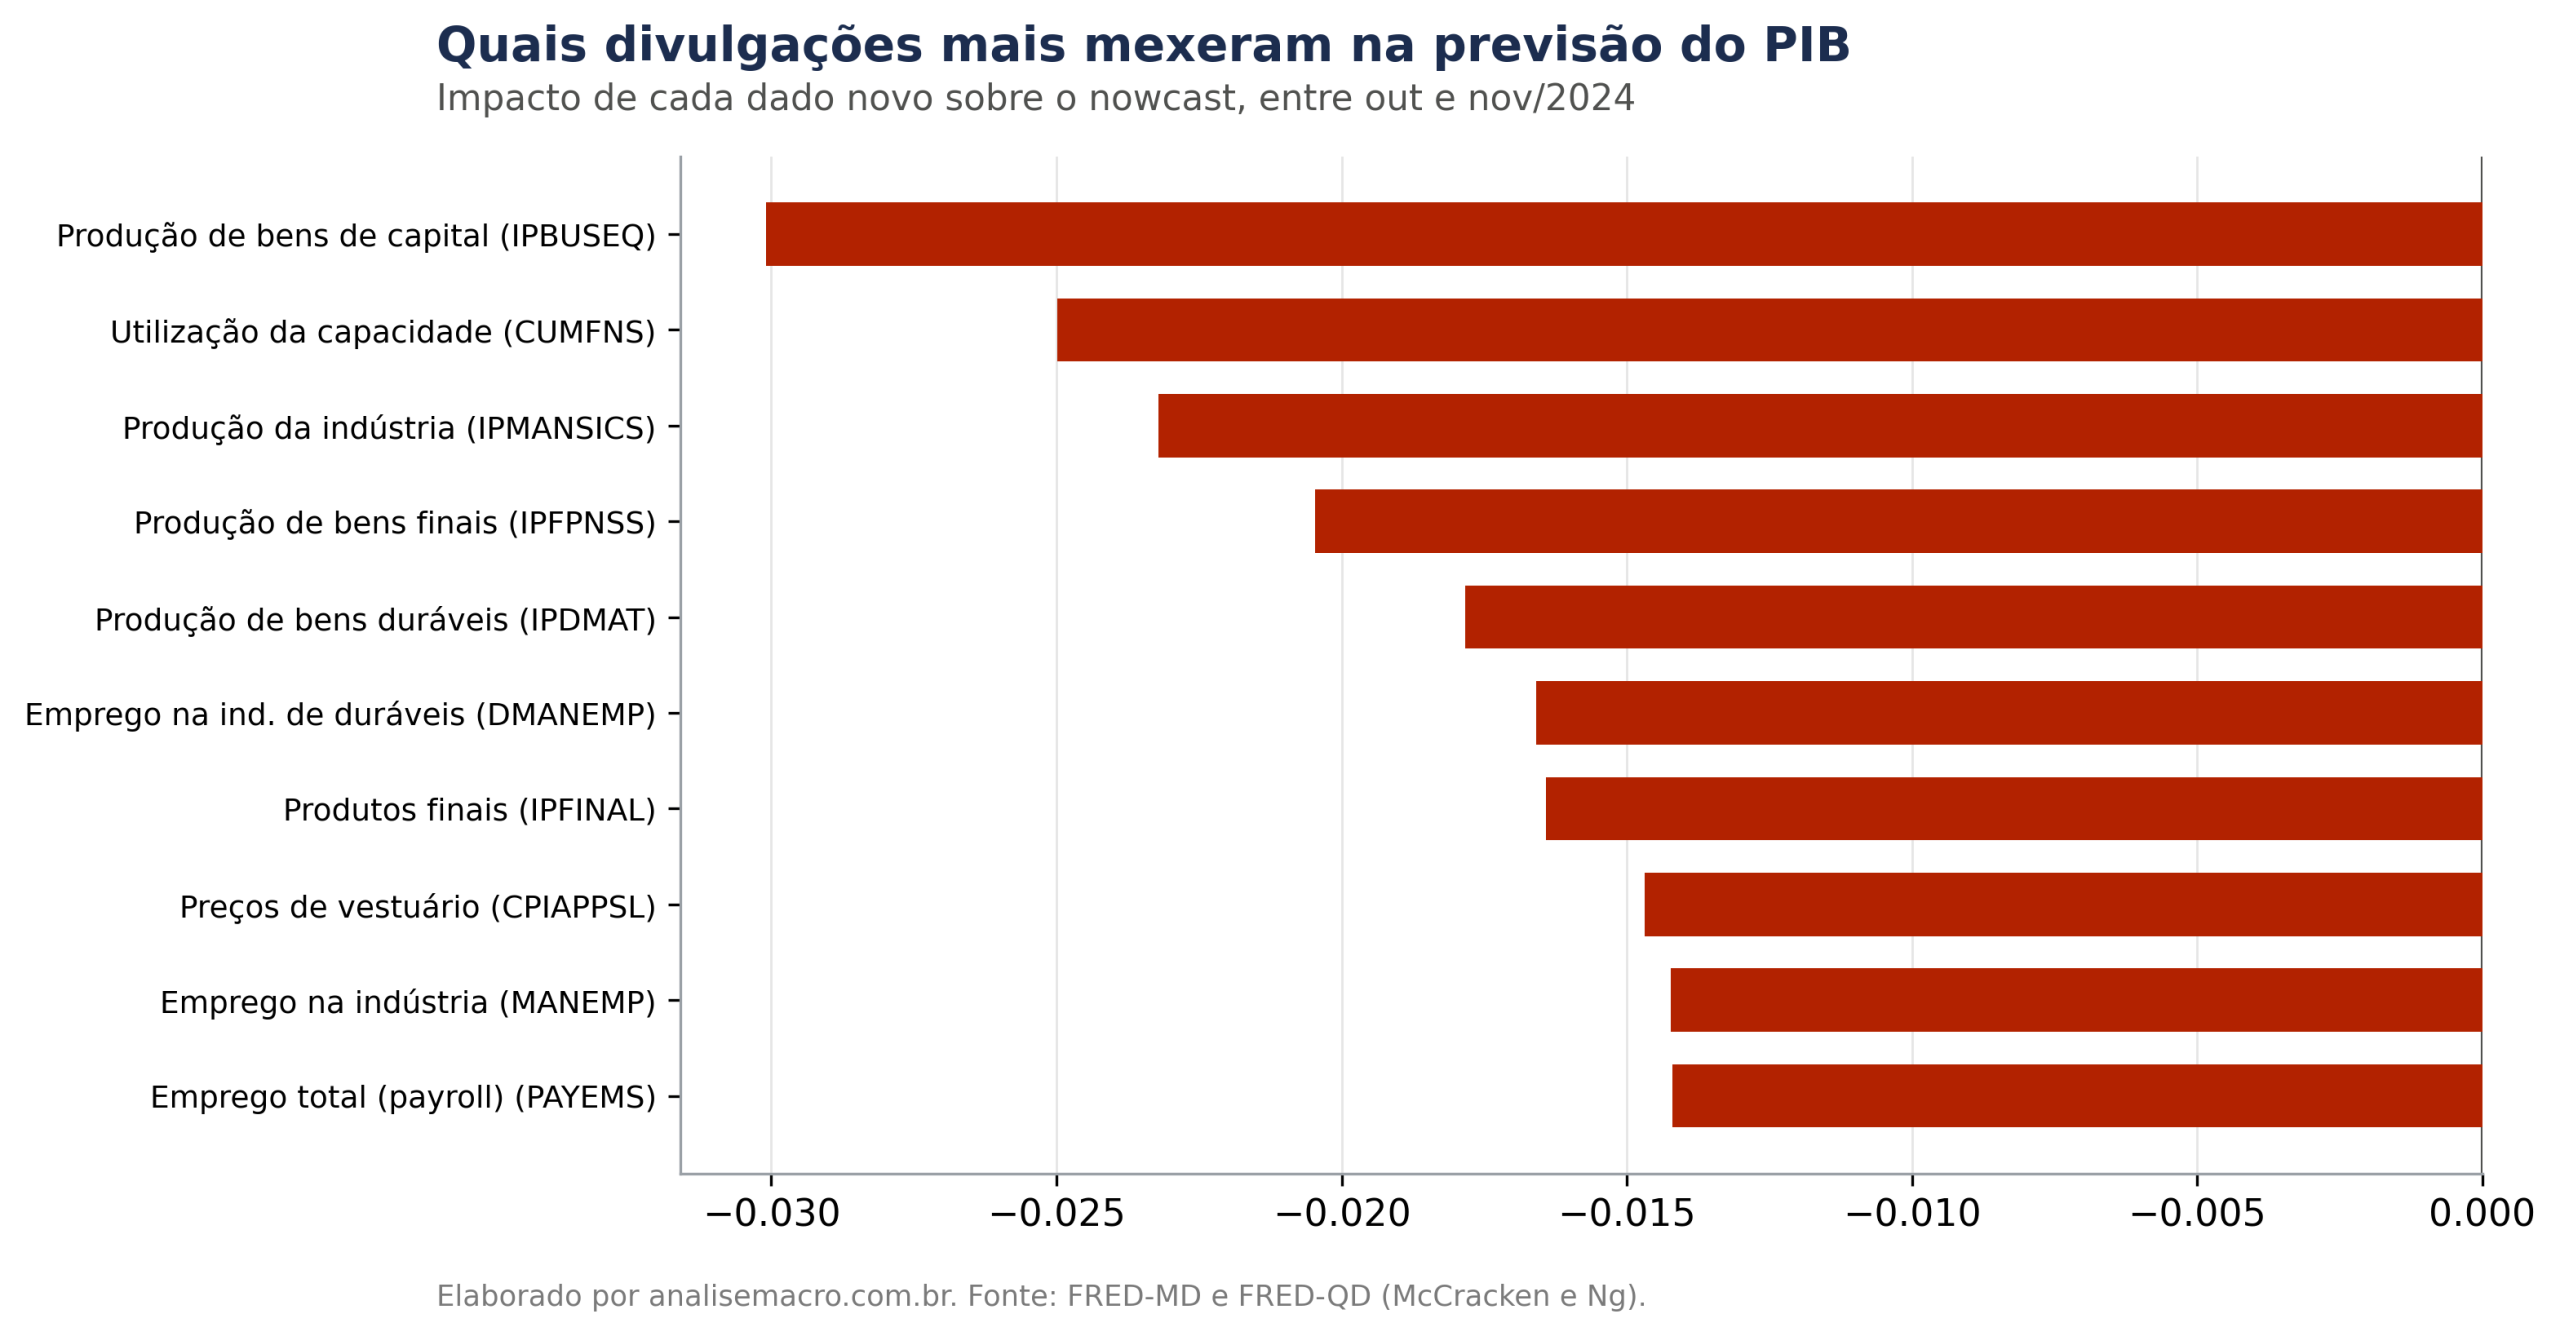
A decomposição explica a queda de novembro. Os dez maiores impactos são todos negativos, e sete deles vêm de produção ou emprego industrial: produção de bens de capital, utilização da capacidade instalada, produção da indústria de transformação, bens duráveis.
Foi a indústria que puxou a previsão para baixo. E como o PIB americano é dominado por serviços, esse pessimismo industrial acabou não se confirmando no agregado — o que explica por que a previsão de novembro errou mais.
É o que torna o método auditável: em vez de uma previsão que muda sem explicação, a decomposição transforma "a previsão caiu" em "a previsão caiu porque a produção industrial veio abaixo do esperado, e essa série tem carga alta no fator comum".
Considerações finais
O nowcasting resolve um problema concreto: decidir com a informação que existe, em vez de esperar pela estatística oficial.
O modelo de fatores dinâmicos é a ferramenta natural porque enfrenta as três dificuldades de uma vez. A extração do fator comum resolve o excesso de variáveis, ao substituir um coeficiente por série por um punhado de cargas. A formulação em espaço de estados resolve as frequências mistas e os dados faltantes, porque o filtro de Kalman atualiza a estimativa com o que chegou, sem exigir painel completo. E a mesma formulação entrega a decomposição das surpresas, que mostra de onde veio cada revisão.
Três limites que vale registrar.
O modelo não sabe o que não está nos dados. Choques que não se refletem nos indicadores incluídos passam despercebidos até aparecerem em alguma série.
O número de fatores é uma decisão, não um resultado. Usamos um, seguindo a literatura, mas especificações diferentes produzem previsões diferentes.
Um trimestre não avalia um método. A qualidade se mede em janelas longas, e o caso de 2024Q4 serve para ilustrar o mecanismo, não para julgar o modelo.
A lógica do método é essa: em vez de escolher meia dúzia de indicadores por intuição, deixar que a estrutura de covariância dos dados diga o que eles têm em comum, e acompanhar, divulgação a divulgação, como essa leitura se atualiza.
O mesmo caminho serve para qualquer variável de baixa frequência cercada de indicadores mais frequentes, e a troca é só de painel:
- Bancos centrais acompanham a atividade entre divulgações do PIB, para decidir juros com a leitura mais atual possível do ciclo;
- Gestores antecipam o número que o mercado vai precificar, e medem o quanto cada divulgação deslocou essa expectativa;
- Analistas de conjuntura ganham, com a decomposição das surpresas, uma justificativa auditável para cada revisão de cenário;
- Empresas aplicam a mesma estrutura à própria demanda, usando indicadores setoriais de divulgação mais rápida.
No caso brasileiro, o desenho é o mesmo com fontes diferentes: o PIB trimestral do IBGE no lugar do americano, e o IBC-Br, a PIM, a PMC, a PMS e o Caged compondo o painel mensal.
Quer aprender a construir modelos como este?
A Formação Do Zero à Análise de Dados Econômicos e Financeiros com Python e IA ensina o caminho completo: coleta em bases públicas, tratamento de séries temporais, modelagem econométrica e previsão.
Prefere acesso a todos os cursos? O AM Black libera o catálogo completo por uma assinatura anual.
Referências
- Bańbura, M. e Modugno, M. (2014). Maximum likelihood estimation of factor models on datasets with arbitrary pattern of missing data. Journal of Applied Econometrics, 29(1), 133-160.
- McCracken, M. W. e Ng, S. (2016). FRED-MD: A Monthly Database for Macroeconomic Research. Journal of Business & Economic Statistics, 34(4), 574-589.
- Mariano, R. S. e Murasawa, Y. (2010). A coincident index, common factors, and monthly real GDP. Oxford Bulletin of Economics and Statistics, 72(1), 27-46.
Leia também