
Introdução
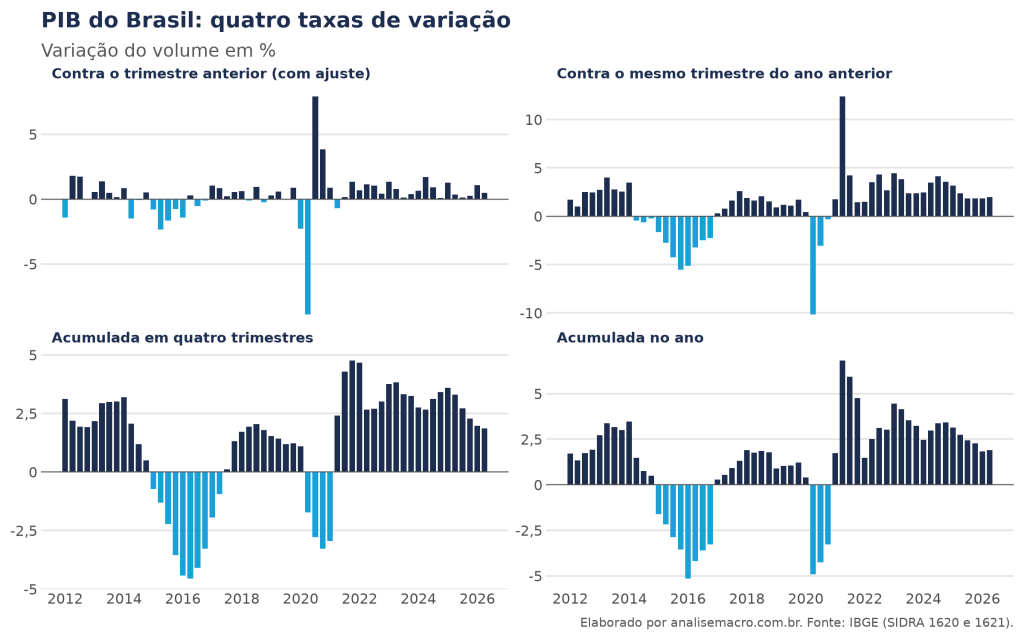
O PIB brasileiro caiu perto de 9% no segundo trimestre de 2020, na comparação com o trimestre anterior. No mesmo trimestre, a taxa acumulada em quatro trimestres recuou menos de 2%. Os dois números são do mesmo PIB e estão certos: cada taxa de variação responde a uma pergunta diferente.
Neste exercício, mostramos como analisar os dados do PIB no Python. Coletamos as tabelas do IBGE com a biblioteca sidrapy, calculamos as quatro taxas de variação que aparecem em toda divulgação, construímos os gráficos do PIB pela ótica da oferta e pela ótica da demanda e medimos quanto cada componente da demanda contribuiu para o crescimento. Todo o código está no post, bloco a bloco.
Todos os painéis do gráfico mostram o mesmo PIB. A variação contra o trimestre anterior oscila mais e reage primeiro a uma mudança de ritmo; a taxa acumulada em quatro trimestres muda devagar e mostra a tendência. A recessão de 2015 e 2016 aparece nos quatro, mas só os acumulados mostram quanto ela durou.
📩 Boletim AM
Receba análises e conteúdos sobre modelos estatísticos clássicos, econometria feita com hipóteses sérias e LLMs acessados em ambientes de trabalho reais, tudo aplicado à economia, ao mercado financeiro e à análise de dados.
O que o PIB mede
O Produto Interno Bruto (PIB) mede o valor de todos os bens e serviços finais produzidos no país em um período. "Finais" quer dizer que entram só os produtos que chegam ao usuário final: o pão entra, a farinha usada para fazê-lo não, porque o valor dela já está no preço do pão.
O IBGE publica o PIB a cada trimestre nas Contas Nacionais Trimestrais, e o mesmo total pode ser lido por dois lados. Detalhamos a pesquisa inteira, com subsetores e participações, em Analisando as Contas Nacionais Trimestrais no Python.
Pela ótica da oferta, somamos o valor adicionado de cada setor, isto é, o valor da produção menos os insumos comprados de outros setores. Os três grandes setores, somados aos impostos sobre produtos, formam o PIB:
Pela ótica da demanda, somamos quem comprou essa produção: o consumo das famílias (C), o consumo do governo (G), o investimento em máquinas, equipamentos e construções, chamado de formação bruta de capital fixo (FBCF), a variação de estoques (ΔE) e as exportações (X). As importações (M) saem da conta, porque foram produzidas fora do país:
As duas óticas chegam ao mesmo número. A oferta responde quem produziu; a demanda responde quem comprou.
As bibliotecas
O sidrapy consulta o SIDRA, o sistema de tabelas do IBGE, e devolve cada tabela já como um DataFrame. O pandas organiza os dados e calcula as taxas por componente; apresentamos a biblioteca em Introdução ao pandas.
O plotnine constrói os gráficos com a gramática de gráficos, a mesma lógica do ggplot2 do R: cada gráfico é a soma de camadas (dados, geometria, escalas, tema). Mostramos essa lógica passo a passo em A gramática dos gráficos: como deixar de criar gráficos no Excel e usar o plotnine no Python.
Antes de começar, instalamos o sidrapy e o plotnine.
# instala as bibliotecas usadas no exercício
# !pip install sidrapy plotnine
import sidrapy as sidra  # acesso às tabelas do SIDRA
import numpy as np  # operações numéricas
import pandas as pd  # manipulação de tabelas
from plotnine import *  # gramática de gráficos
Coleta dos dados no SIDRA
O PIB trimestral está em três tabelas do SIDRA, e cada uma traz uma medida diferente do mesmo componente:
- Tabela 1620: o índice de volume encadeado, sem ajuste sazonal. Ele mede a quantidade produzida, sem o efeito dos preços, e é a base das comparações com o mesmo período do ano anterior.
- Tabela 1621: o mesmo índice de volume com ajuste sazonal, isto é, sem o padrão que se repete todo ano (a safra concentrada no primeiro semestre, as vendas maiores no fim do ano). É a base da comparação com o trimestre imediatamente anterior.
- Tabela 1846: os valores a preços correntes, em milhões de reais. Eles medem o tamanho de cada componente na moeda do próprio trimestre e servem para calcular o peso de cada um no PIB.
Dentro das três tabelas, a classificação 11255 separa o PIB em setores e componentes. Guardamos os códigos dos nove que usamos num dicionário, que depois traduz cada código para um nome curto.
componentes = {  # código do IBGE e nome curto de cada série
    "90707": "PIB",  # PIB a preços de mercado
    "90687": "Agropecuária",  # oferta: agropecuária
    "90691": "Indústria",  # oferta: indústria
    "90696": "Serviços",  # oferta: serviços
    "93404": "Consumo das famílias",  # demanda: consumo das famílias
    "93405": "Consumo do governo",  # demanda: consumo da administração pública
    "93406": "FBCF",  # demanda: formação bruta de capital fixo
    "93407": "Exportações",  # demanda: exportações de bens e serviços
    "93408": "Importações",  # demanda: importações de bens e serviços
}

tabelas = {  # tabela do SIDRA: (variável, nome da medida)
    "1620": ("583", "volume"),  # índice de volume sem ajuste sazonal
    "1621": ("584", "volume_sa"),  # índice de volume com ajuste sazonal
    "1846": ("585", "corrente"),  # valores a preços correntes
}
A função coletar() faz a mesma consulta para qualquer uma das três tabelas: Brasil como nível territorial, os nove componentes e todos os trimestres disponíveis. O argumento header="n" dispensa a linha de cabeçalho, porque usamos as colunas de código. Os parâmetros do sidrapy e a forma de achar os códigos de uma tabela estão em Coleta de dados do SIDRA com o Python.
def coletar(tabela, variavel):  # baixa uma tabela inteira do SIDRA
    return sidra.get_table(  # consulta a API do SIDRA
        table_code=tabela,  # número da tabela
        territorial_level="1",  # nível territorial: Brasil
        ibge_territorial_code="all",  # todas as unidades do nível
        variable=variavel,  # variável da tabela
        classifications={"11255": ",".join(componentes)},  # os nove componentes do PIB
        period="all",  # todos os trimestres
        header="n",  # sem a linha de cabeçalho
    )

brutos = pd.concat(  # empilha as três tabelas
    [coletar(t, v).assign(medida=nome) for t, (v, nome) in tabelas.items()]  # baixa cada uma e marca a medida
)
brutos[["D2C", "D4C", "V", "medida"]].tail()  # trimestre, componente, valor e medida
Tratamento dos dados
O SIDRA devolve tudo como texto e numa tabela longa, com uma linha por componente, trimestre e medida. O tratamento transforma o código do trimestre (como 202602) em data, troca o código do componente pelo nome e deixa uma coluna para cada medida.
dados = (
    brutos
    .rename(columns={"D2C": "trimestre", "D4C": "codigo", "V": "valor"})  # colunas que interessam
    .assign(
        data=lambda x: pd.PeriodIndex(x["trimestre"].str.slice_replace(4, 5, "Q"), freq="Q").to_timestamp(),  # 202602 vira data
        rubrica=lambda x: x["codigo"].map(componentes),  # código vira nome curto
        valor=lambda x: pd.to_numeric(x["valor"], errors="coerce"),  # texto vira número
    )
    .pivot_table(index=["rubrica", "data"], columns="medida", values="valor")  # uma coluna por medida
    .reset_index()  # rubrica e data voltam a ser colunas
    .rename_axis(columns=None)  # remove o nome do eixo das colunas
)
dados.query("rubrica == 'PIB'").tail()  # últimos trimestres do PIB
Taxas de variação do PIB: trimestral, interanual e acumuladas
O índice de volume é um número sem unidade, com base fixa num ano de referência. Um valor como 180 ganha sentido quando o comparamos com o índice de outro trimestre. Por isso, a divulgação do PIB traz quatro taxas, e cada uma compara o trimestre com uma base diferente. Nas fórmulas, Yt é o índice de volume no trimestre t e Ytsa é o mesmo índice com ajuste sazonal.
Contra o trimestre anterior
A variação contra o trimestre anterior compara cada trimestre com o imediatamente anterior. É a taxa que reage primeiro a uma mudança de ritmo.
Ela usa a série com ajuste sazonal porque, sem ele, a comparação do primeiro trimestre com o quarto misturaria a atividade com o calendário. O ajuste retira o padrão que se repete todo ano, como explicamos em Como dessazonalizar uma série no Python.
Contra o mesmo trimestre do ano anterior
A variação interanual compara o trimestre com o mesmo trimestre do ano anterior. Como os dois têm a mesma sazonalidade, ela usa a série sem ajuste.
Ela depende muito da base: depois de um ano fraco, a interanual sai alta mesmo que a economia só tenha voltado ao nível de antes.
Acumulada em quatro trimestres
A taxa acumulada em quatro trimestres compara a soma dos quatro últimos trimestres com a soma dos quatro anteriores.
Ou seja, é o crescimento de um ano inteiro que termina no trimestre t. Cada trimestre novo troca só um quarto da soma, e por isso a taxa muda devagar e mostra a tendência.
Acumulada no ano
A taxa acumulada no ano soma os trimestres do ano corrente até t e compara com a soma dos mesmos trimestres do ano anterior.
No quarto trimestre, ela coincide com a acumulada em quatro trimestres e vira o crescimento do PIB no ano.
O cálculo
As quatro taxas são uma razão contra uma defasagem, então escrevemos uma função só, variacao(), e a aplicamos a cada componente separadamente com groupby(). A acumulada no ano precisa de um passo a mais: primeiro somamos o volume dentro de cada ano e depois comparamos essa soma com a de quatro trimestres antes.
def variacao(serie, defasagem):  # variação % contra t - defasagem
    return (serie / serie.shift(defasagem) - 1) * 100  # razão menos um, em %

grupo = dados.groupby("rubrica")  # cada componente é tratado separadamente

taxas = dados.assign(
    ano=lambda x: x["data"].dt.year,  # ano de cada trimestre
    margem=grupo["volume_sa"].transform(lambda s: variacao(s, 1)),  # contra o trimestre anterior, com ajuste
    interanual=grupo["volume"].transform(lambda s: variacao(s, 4)),  # contra o mesmo trimestre do ano anterior
    anual=grupo["volume"].transform(lambda s: variacao(s.rolling(4).sum(), 4)),  # acumulada em quatro trimestres
    soma_ano=lambda x: x.groupby(["rubrica", "ano"])["volume"].cumsum(),  # volume somado no ano até o trimestre
)
taxas["acum_ano"] = taxas.groupby("rubrica")["soma_ano"].transform(lambda s: variacao(s, 4))  # acumulada no ano

(taxas.query("rubrica == 'PIB'")  # só o PIB
 .set_index("data")  # data como índice
 [["margem", "interanual", "anual", "acum_ano"]]  # as quatro taxas
 .tail(8)  # oito trimestres mais recentes
 .round(2))  # duas casas decimais
Os gráficos dos dados do PIB no Python
Todos os gráficos do exercício usam barras em azul-escuro quando a taxa é positiva e em azul-claro quando é negativa, título com o assunto do gráfico e a fonte no rodapé, com o número da tabela do SIDRA. Guardamos esse padrão em um tema e em duas funções curtas, para não repetir as mesmas linhas em cada gráfico.
navy, ciano = "#1c2d4f", "#18a0d7"  # cores da casa

def fonte(tabelas):  # rodapé padrão dos gráficos
    return f"Elaborado por analisemacro.com.br. Fonte: IBGE (SIDRA {tabelas})."  # autoria e fonte

def virgula(valores):  # rótulos do eixo com vírgula decimal
    return [f"{v:g}".replace(".", ",") for v in valores]  # 2.5 vira 2,5

tema_am = (
    theme_minimal(base_size=10)  # base limpa
    + theme(
        plot_title=element_text(weight="bold", color=navy, ha="left"),  # título navy à esquerda
        plot_subtitle=element_text(color="#555555", ha="left"),  # subtítulo cinza
        plot_caption=element_text(color="#555555", size=7),  # rodapé discreto
        strip_text=element_text(weight="bold", color=navy, ha="left"),  # título dos painéis
        panel_grid_minor=element_blank(),  # sem grade secundária
        panel_grid_major_x=element_blank(),  # sem grade vertical
        legend_position="bottom",  # legenda embaixo
        legend_title=element_blank(),  # legenda sem título
    )
)
Gráfico das taxas de variação do PIB
Para colocar as quatro taxas no mesmo gráfico, passamos a tabela para o formato longo, com uma linha por trimestre e taxa. Cada taxa vira um painel do facet_wrap(), com escala própria no eixo y, porque a variação contra o trimestre anterior e a acumulada em quatro trimestres têm amplitudes muito diferentes. O resultado é o gráfico que abre este post.
nomes = {  # nome de cada taxa nos painéis
    "margem": "Contra o trimestre anterior (com ajuste)",
    "interanual": "Contra o mesmo trimestre do ano anterior",
    "anual": "Acumulada em quatro trimestres",
    "acum_ano": "Acumulada no ano",
}

pib = (
    taxas.query("rubrica == 'PIB' and ano >= 2012")  # PIB desde 2012
    .melt(id_vars="data", value_vars=list(nomes), var_name="taxa", value_name="valor")  # formato longo
    .assign(
        taxa=lambda x: pd.Categorical(x["taxa"].map(nomes), categories=nomes.values()),  # ordem dos painéis
        positivo=lambda x: x["valor"] >= 0,  # alta ou queda
    )
)

g_pib = (
    ggplot(pib, aes(x="data", y="valor", fill="positivo"))  # tempo no eixo x
    + geom_col(width=70)  # uma barra por trimestre
    + geom_hline(yintercept=0, color="#555555", size=0.3)  # linha do zero
    + facet_wrap("taxa", ncol=2, scales="free_y")  # um painel por taxa
    + scale_fill_manual(values={True: navy, False: ciano}, guide=None)  # navy para alta, ciano para queda
    + scale_x_datetime(date_breaks="2 years", date_labels="%Y")  # rótulo a cada dois anos
    + scale_y_continuous(labels=virgula)  # vírgula decimal
    + labs(title="PIB do Brasil: quatro taxas de variação",  # título
           subtitle="Variação do volume em %",  # unidade
           x="", y="", caption=fonte("1620 e 1621"))  # fonte
    + tema_am  # tema da casa
    + theme(figure_size=(8, 5))  # tamanho da figura
)
g_pib  # exibe o gráfico
O segundo trimestre de 2020 mostra a diferença entre as quatro taxas. Contra o trimestre anterior, o PIB caiu perto de 9%; contra o mesmo trimestre de 2019, cerca de 10%. Na acumulada em quatro trimestres, a queda ficou abaixo de 2%, porque três dos quatro trimestres da soma ainda eram anteriores à pandemia.
Um ano depois aparece o efeito base na interanual. O segundo trimestre de 2021 cresceu mais de 10% contra o mesmo trimestre de 2020, que tinha sido o pior da série. Na prática, a economia voltou ao nível de antes da queda, e a comparação com uma base deprimida inflou a taxa.
A recessão de 2015 e 2016 mostra o outro lado. Contra o trimestre anterior, as quedas foram moderadas, mas vieram em sequência; nos acumulados, elas se somam em quase dois anos de taxas negativas.
O PIB pela ótica da oferta
Pela oferta, comparamos a agropecuária, a indústria e os serviços pela taxa acumulada em quatro trimestres, a que mostra a tendência de cada setor. Como os gráficos da oferta e da demanda têm a mesma estrutura, escrevemos uma função, painel(), que recebe a lista de componentes e devolve o gráfico.
def painel(rubricas, titulo, altura):  # taxa em quatro trimestres, um painel por componente
    base = (
        taxas.query("rubrica in @rubricas and ano >= 2012")  # componentes escolhidos, desde 2012
        .assign(
            rubrica=lambda x: pd.Categorical(x["rubrica"], categories=rubricas),  # ordem dos painéis
            positivo=lambda x: x["anual"] >= 0,  # alta ou queda
        )
    )
    return (
        ggplot(base, aes(x="data", y="anual", fill="positivo"))  # tempo no eixo x
        + geom_col(width=70)  # uma barra por trimestre
        + geom_hline(yintercept=0, color="#555555", size=0.3)  # linha do zero
        + facet_wrap("rubrica", ncol=3, scales="free_y")  # um painel por componente
        + scale_fill_manual(values={True: navy, False: ciano}, guide=None)  # navy para alta, ciano para queda
        + scale_x_datetime(date_breaks="3 years", date_labels="%Y")  # rótulo a cada três anos
        + scale_y_continuous(labels=virgula)  # vírgula decimal
        + labs(title=titulo,  # título
               subtitle="Taxa acumulada em quatro trimestres, em %",  # unidade
               x="", y="", caption=fonte("1620"))  # fonte
        + tema_am  # tema da casa
        + theme(figure_size=(8, altura))  # tamanho da figura
    )

oferta = ["Agropecuária", "Indústria", "Serviços"]  # componentes da oferta
g_oferta = painel(oferta, "PIB pela ótica da oferta", 3.4)  # monta o gráfico
g_oferta  # exibe o gráfico
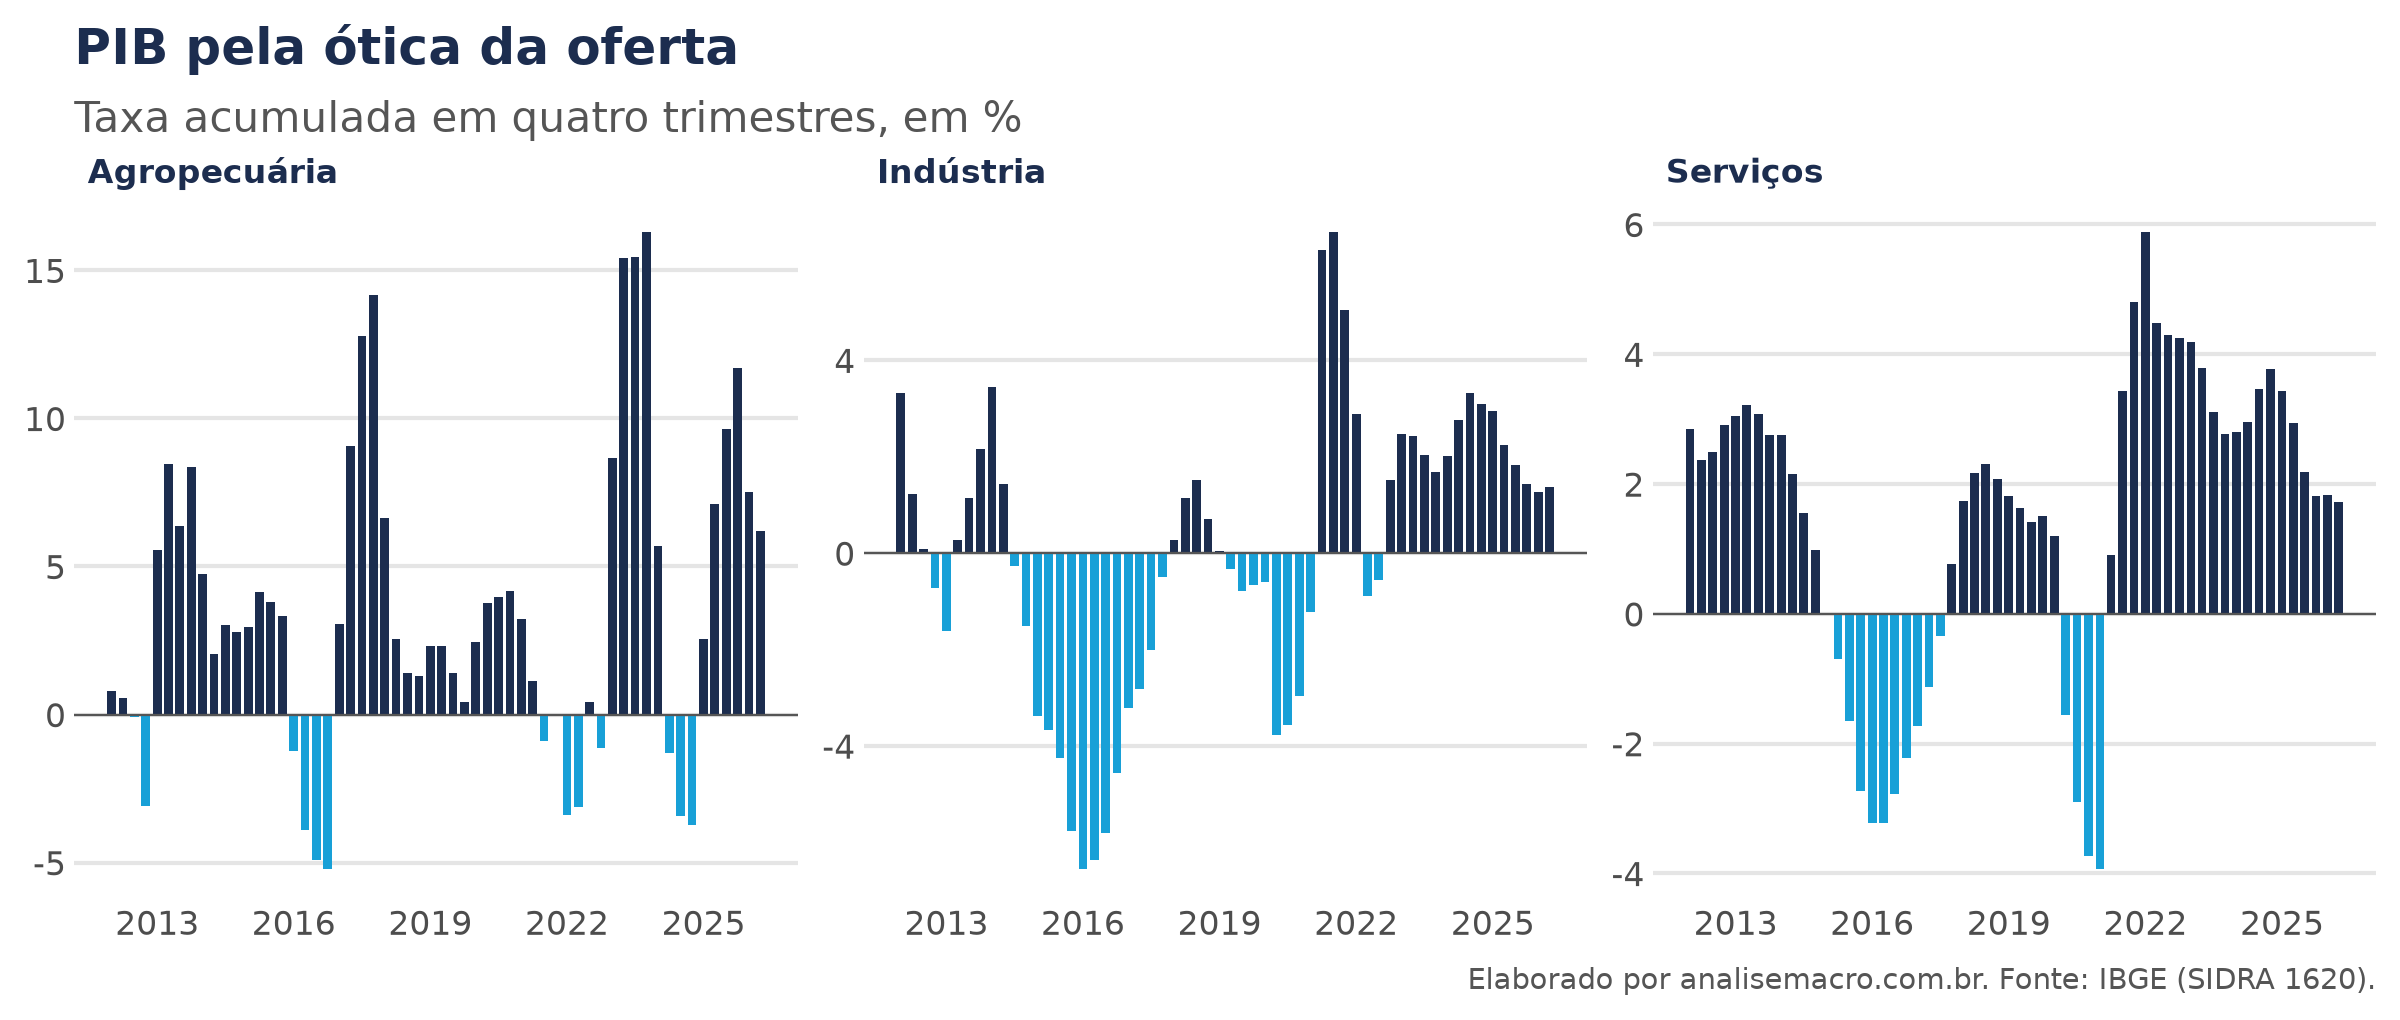
Cada setor tem um ritmo próprio. A agropecuária oscila mais que os outros dois, porque depende da safra e do clima: um ano de quebra e o seguinte de colheita cheia produzem taxas de sinais opostos.
Os serviços respondem por cerca de 70% do valor adicionado e se movem de forma mais parecida com o PIB. A indústria costuma reagir mais ao ciclo e aos juros.
O PIB pela ótica da demanda
A mesma função monta o gráfico da demanda, agora com os cinco componentes: consumo das famílias, consumo do governo, investimento (FBCF), exportações e importações.
demanda = ["Consumo das famílias", "Consumo do governo", "FBCF", "Exportações", "Importações"]  # componentes da demanda
g_demanda = painel(demanda, "PIB pela ótica da demanda", 5)  # monta o gráfico
g_demanda  # exibe o gráfico
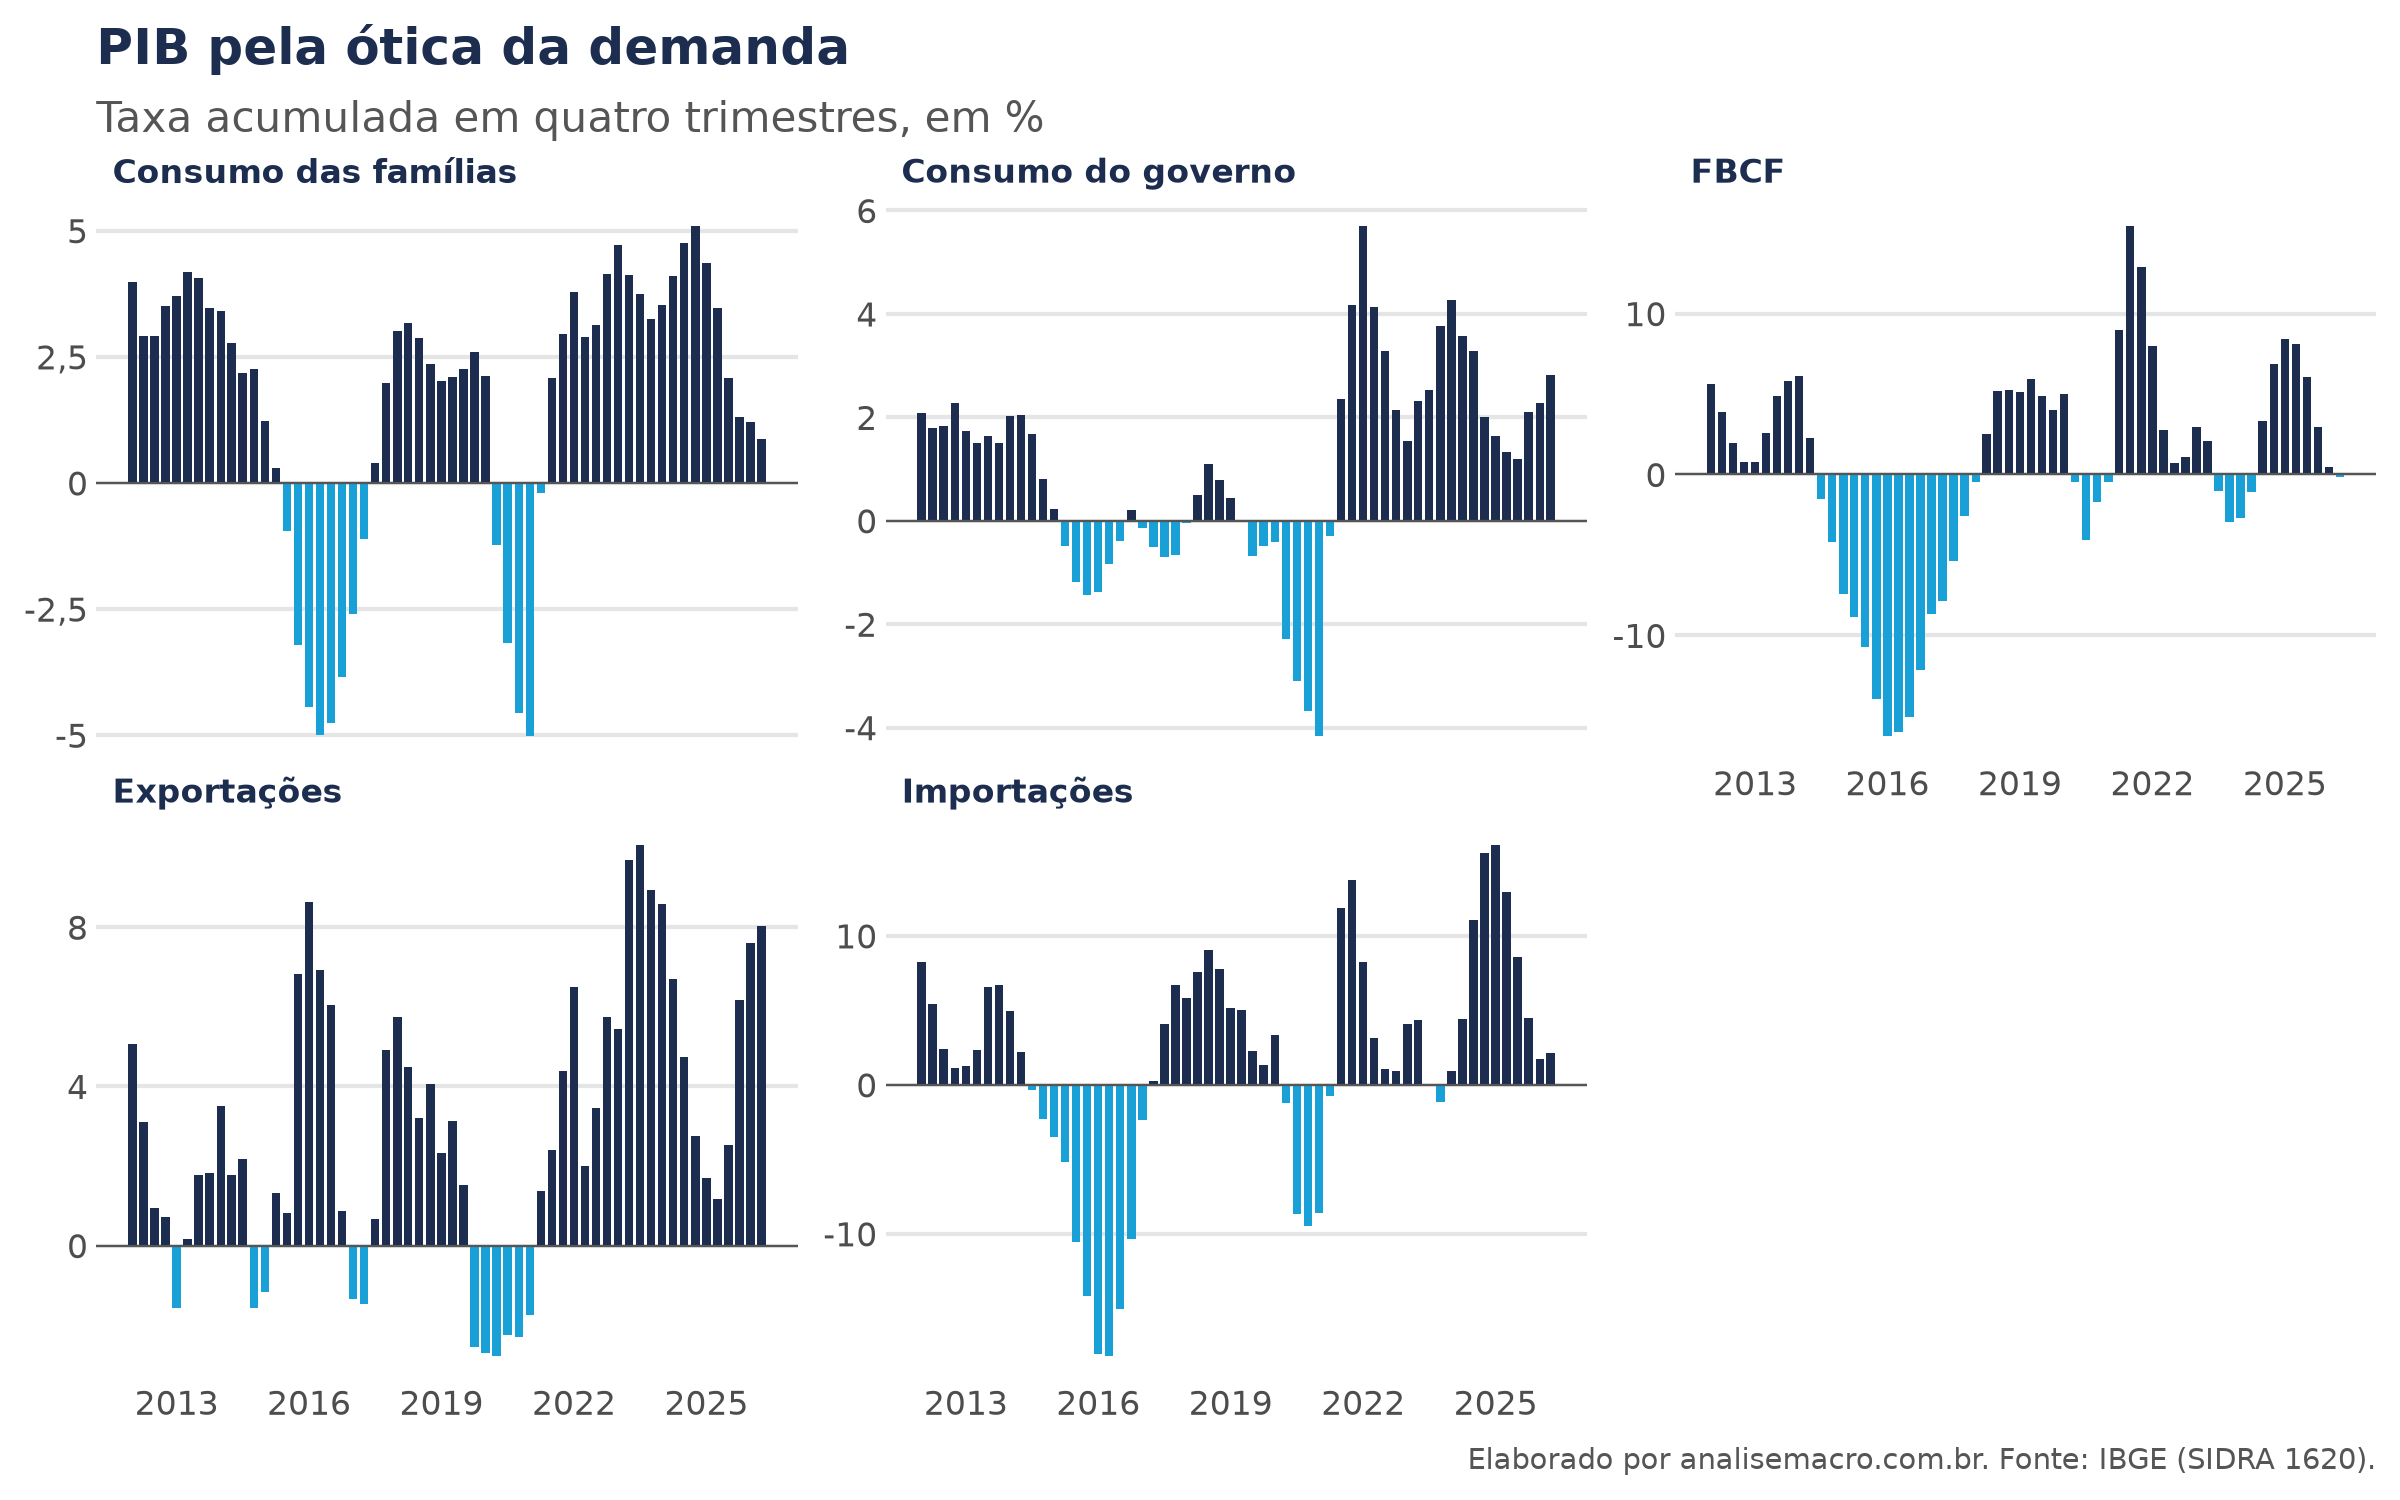
Na figura acima, a FBCF tem as maiores oscilações entre os componentes domésticos. O investimento é a decisão mais sensível a juros e a confiança: é adiado primeiro numa recessão e retomado com força na saída dela.
O consumo das famílias muda mais devagar, porque as pessoas tendem a preservar o consumo mesmo quando a renda oscila.
As importações acompanham a demanda doméstica: quando o consumo e o investimento crescem, parte dessa compra vai para produtos de fora. Na recessão de 2015 e 2016, elas caíram tanto quanto o investimento, mais de 15% no acumulado em quatro trimestres.
A contribuição de cada componente para o crescimento
Para saber quanto cada componente puxou o PIB, precisamos combinar a taxa de crescimento com o peso do componente. Um crescimento forte das exportações pesa menos que um crescimento modesto do consumo das famílias, porque o consumo das famílias responde por cerca de 60% do PIB. A contribuição para o crescimento faz essa combinação: multiplica a variação de cada componente pela participação dele na economia.
Aqui cj,t é a contribuição do componente j em pontos percentuais, Δ4T,j,t é a variação real do componente, acumulada em quatro trimestres, e wj,t−4 é a participação do componente no PIB nominal no período-base, os quatro trimestres anteriores. As importações entram com sinal negativo, porque subtraem do PIB.
O peso vem da tabela de valores correntes, porque os componentes só podem ser somados e comparados com o PIB a preços correntes. A variação vem do índice de volume, que mede o crescimento real.
A soma das contribuições se aproxima do crescimento do PIB. A diferença que sobra corresponde à variação de estoques e à discrepância estatística, que a pesquisa não publica em volume.
pib_4t = (taxas.query("rubrica == 'PIB'")  # só o PIB
          .set_index("data")["corrente"]  # valor corrente por trimestre
          .rolling(4).sum())  # PIB nominal em quatro trimestres

contrib = (
    taxas.query("rubrica in @demanda")  # componentes da demanda
    .assign(
        corrente_4t=lambda x: x.groupby("rubrica")["corrente"].transform(lambda s: s.rolling(4).sum()),  # valor em quatro trimestres
        peso=lambda x: x["corrente_4t"] / x["data"].map(pib_4t),  # participação no PIB nominal
        peso_base=lambda x: x.groupby("rubrica")["peso"].shift(4),  # participação no período-base
        sinal=lambda x: np.where(x["rubrica"] == "Importações", -1, 1),  # importações subtraem
        pp=lambda x: x["sinal"] * x["peso_base"] * x["anual"],  # contribuição em pontos percentuais
    )
    .pivot(index="data", columns="rubrica", values="pp")  # uma coluna por componente
    [demanda]  # ordem dos componentes
)
pib_anual = taxas.query("rubrica == 'PIB'").set_index("data")["anual"]  # crescimento do PIB em quatro trimestres
contrib["Estoques e discrepância"] = pib_anual - contrib.sum(axis=1)  # o que os componentes não explicam

contrib.tail(4).round(2)  # quatro trimestres mais recentes
Em cada linha da tabela que sai desse bloco, as contribuições somam o crescimento do PIB acumulado em quatro trimestres. Para o gráfico, empilhamos as contribuições em barras e colocamos a taxa do PIB como linha por cima.
ordem = demanda + ["Estoques e discrepância"]  # ordem da legenda

barras = (
    contrib.loc["2015":]  # trimestres desde 2015
    .reset_index()  # data vira coluna
    .melt(id_vars="data", var_name="componente", value_name="pp")  # formato longo
    .assign(componente=lambda x: pd.Categorical(x["componente"], categories=ordem))  # ordem fixa
)
linha = pib_anual.loc["2015":].rename("pib").reset_index()  # PIB desde 2015

g_contrib = (
    ggplot(barras, aes(x="data", y="pp"))  # tempo no eixo x
    + geom_col(aes(fill="componente"), width=70)  # barras empilhadas por componente
    + geom_hline(yintercept=0, color="#555555", size=0.3)  # linha do zero
    + geom_line(linha, aes(x="data", y="pib"), color="black", size=0.8)  # crescimento do PIB
    + geom_point(linha, aes(x="data", y="pib"), color="black", size=1.2)  # um ponto por trimestre
    + scale_fill_manual(values=[navy, ciano, "#FF7A00", "#1B998B", "#b22200", "#b3b3b3"])  # uma cor por componente
    + scale_x_datetime(date_breaks="1 year", date_labels="%Y")  # rótulo a cada ano
    + scale_y_continuous(labels=virgula)  # vírgula decimal
    + labs(title="Quem puxou o crescimento do PIB",  # título
           subtitle="Contribuição em pontos percentuais, acumulada em quatro trimestres; linha = PIB",  # unidade
           x="", y="", caption=fonte("1620 e 1846"))  # fonte
    + guides(fill=guide_legend(nrow=2))  # legenda em duas linhas
    + tema_am  # tema da casa
    + theme(figure_size=(8, 4.6))  # tamanho da figura
)
g_contrib  # exibe o gráfico
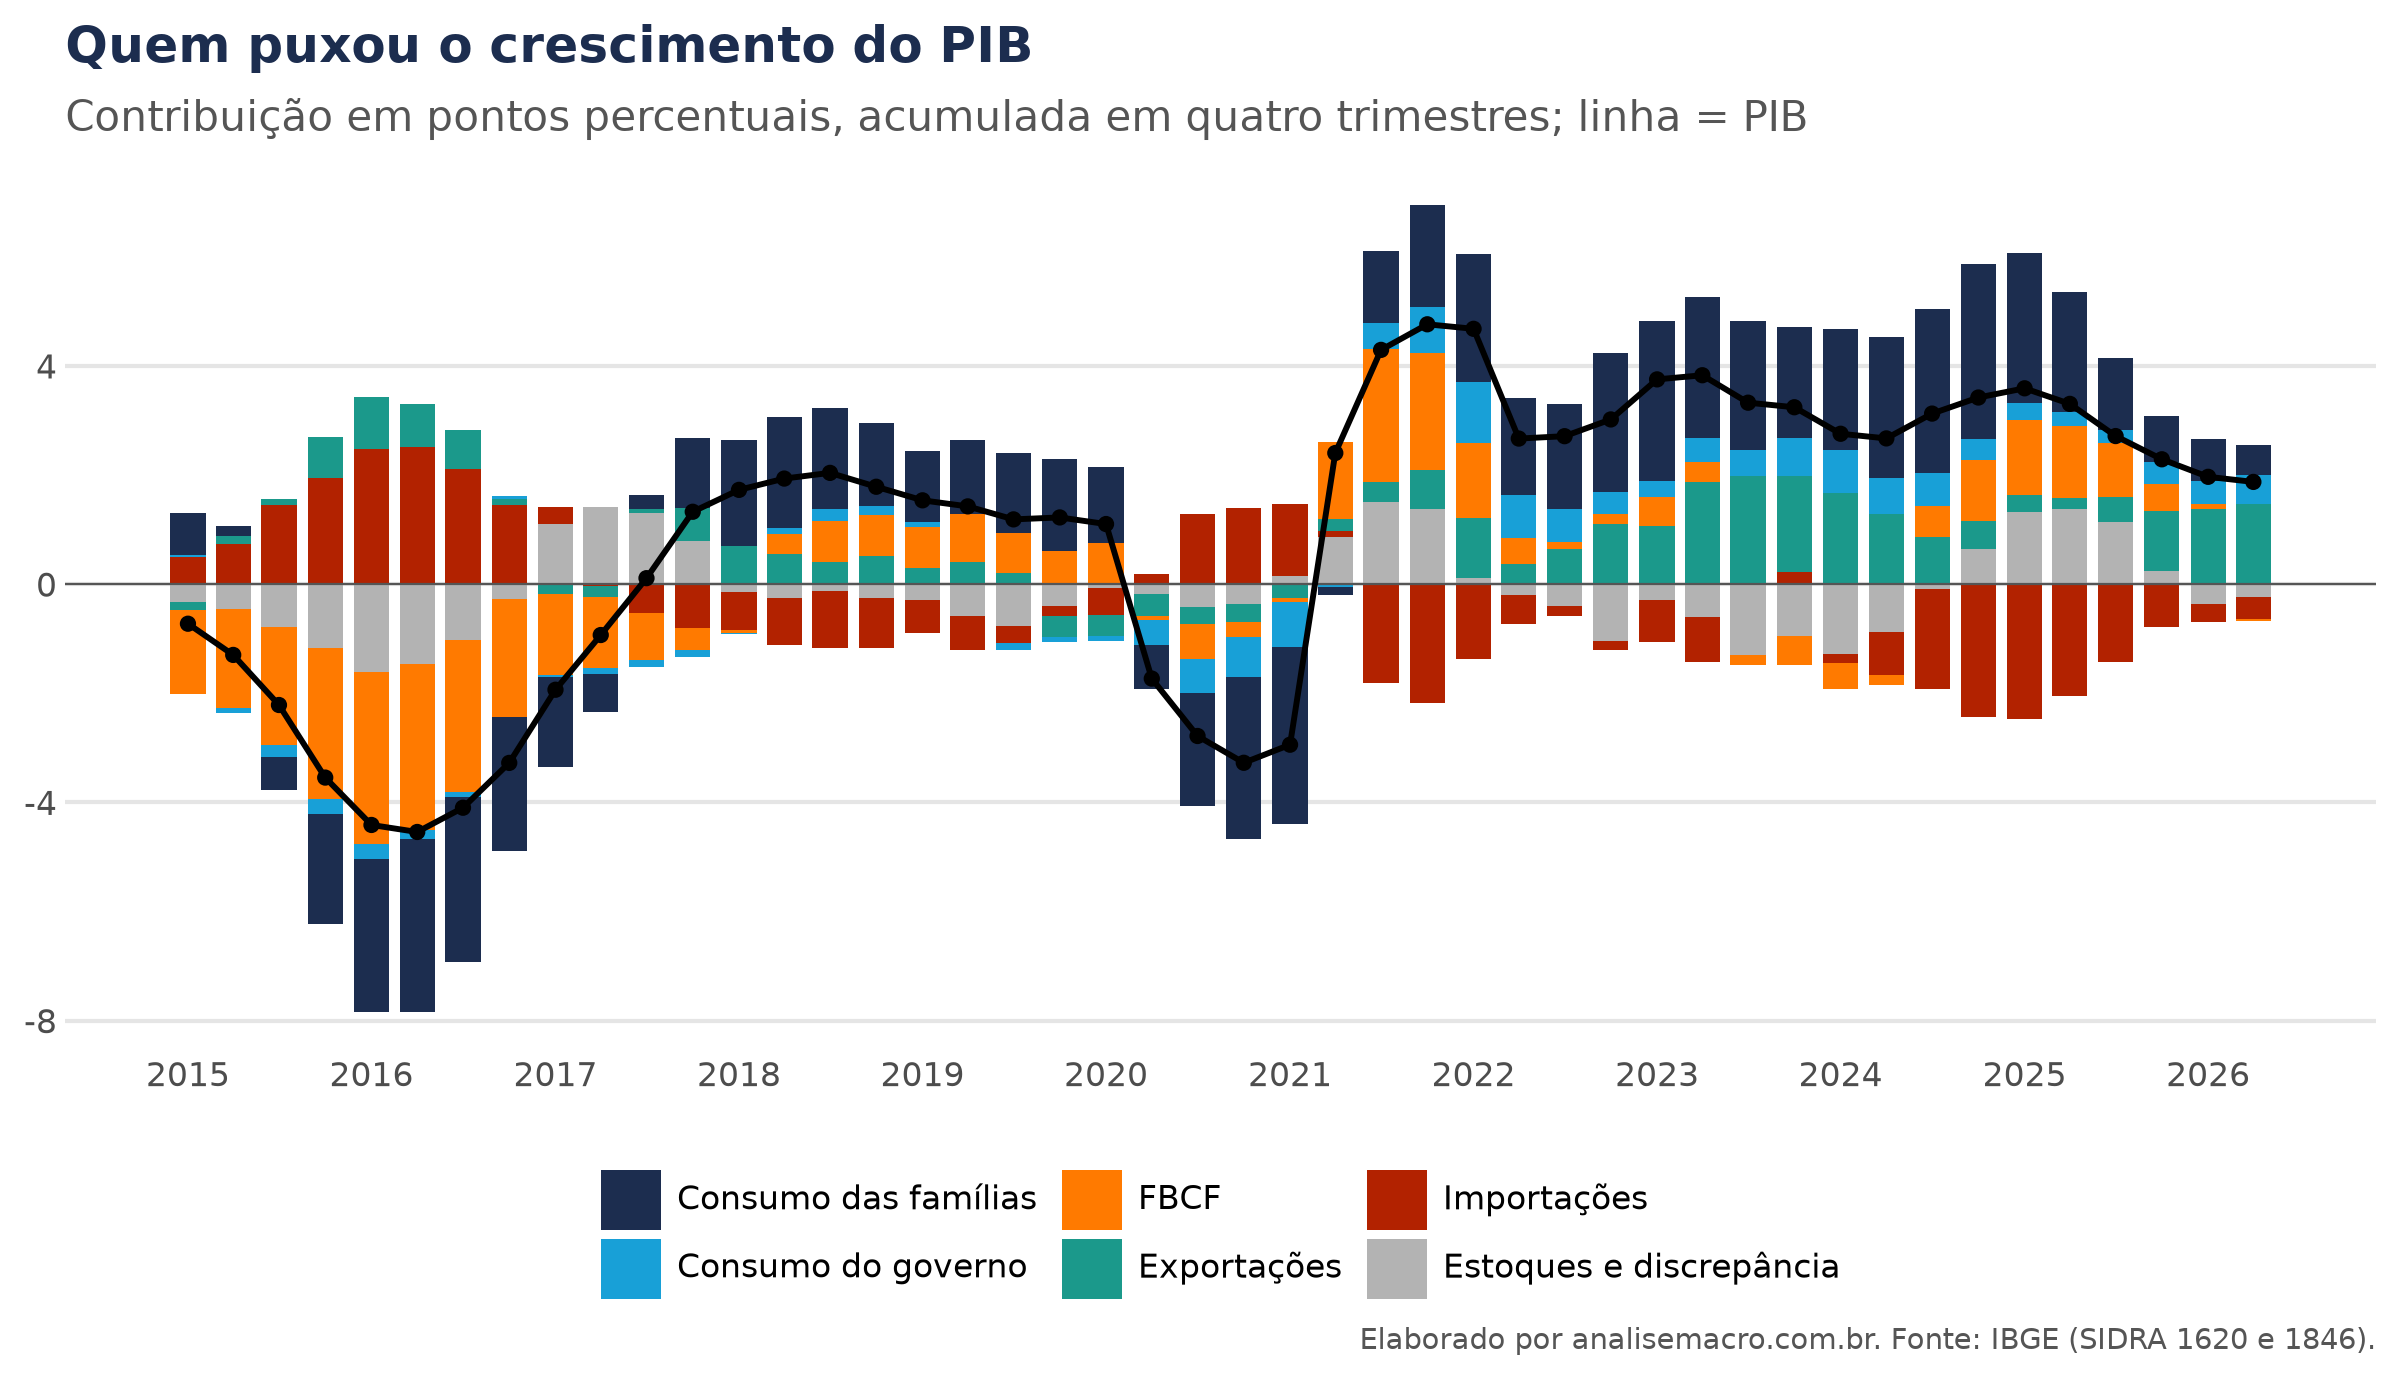
As barras acima do zero puxam o crescimento para cima, e as abaixo puxam para baixo; a linha preta é o crescimento do PIB acumulado em quatro trimestres. O consumo das famílias é a barra que mais pesa na maior parte dos trimestres, para cima nas expansões e para baixo na recessão de 2015 e 2016 e na pandemia.
A FBCF tem um peso menor no PIB, mas muda de sinal com mais força, e por isso aparece grande nas viradas do ciclo.
As importações funcionam como espelho da demanda doméstica. Quando famílias e empresas compram mais, parte da compra vai para fora, e a barra das importações fica abaixo do zero. Na recessão de 2015 e 2016, as importações caíram e a barra delas ficou acima do zero, amortecendo a queda do PIB.
Onde essa análise é usada
As quatro taxas e a contribuição para o crescimento são a base da leitura de uma divulgação do PIB. Com o código pronto, a mesma análise se repete a cada trimestre:
- Comentário da divulgação: no dia em que o IBGE publica o PIB, o código baixa a série inteira, já revisada, e refaz as taxas e os gráficos em segundos.
- Comparação com as projeções: a variação contra o trimestre anterior e a acumulada no ano são as taxas comparadas com as expectativas de mercado e com o cenário de cada instituição.
- Leitura do ciclo: a contribuição mostra se o crescimento vem do consumo, do investimento ou do setor externo, e isso muda a leitura sobre quanto ele tende a durar.
- Acompanhamento mensal: indicadores como o IBC-Br antecipam o PIB entre uma divulgação e outra, e testamos essa relação em O IBC-Br é um bom preditor do PIB?.
Considerações finais
Neste exercício, coletamos os dados do PIB no SIDRA com o sidrapy, calculamos as quatro taxas de variação, separamos o crescimento pela oferta e pela demanda e medimos a contribuição de cada componente da demanda.
A variação contra o trimestre anterior usa a série com ajuste sazonal e mostra o ritmo mais recente. A interanual e as acumuladas usam a série sem ajuste: a interanual depende da base, e a acumulada em quatro trimestres mostra a tendência.
O índice de volume mede o crescimento real, e os valores correntes medem o peso de cada componente. A contribuição para o crescimento combina as duas medidas e diz quanto cada componente puxou o PIB, em pontos percentuais.
Com o Python, essa análise vira um código que coleta os dados, calcula as taxas e refaz os gráficos a cada divulgação. O mesmo caminho serve a quem trabalha com conjuntura em áreas diferentes:
- Economistas: produzir o comentário do PIB no dia da divulgação, com as taxas calculadas e conferidas.
- Analistas de mercado: comparar o resultado com as projeções e atualizar o cenário do ano.
- Gestores e áreas de planejamento: acompanhar quais setores e componentes puxam a economia antes de decidir investimentos.
- Estudantes: aprender contabilidade social aplicando os conceitos aos dados reais do IBGE.
Acesso a todos os cursos da Análise Macro
O AM Black é a assinatura anual da Análise Macro: dá acesso a todos os cursos, de macroeconomia aplicada e econometria a inteligência artificial, com exercícios em R e Python sobre dados econômicos reais.
Referências: IBGE, Contas Nacionais Trimestrais; IBGE, SIDRA; Feijó, C. A.; Ramos, R. L. O. (2017), Contabilidade social.
Leia também:
📩 Quem lê o dado decide melhor
Inflação, juros e atividade não se leem no olho — se leem com método. No Boletim AM eu mostro, todo dia, a estatística, a econometria e a IA por trás da leitura de conjuntura. Com a fonte, com a ressalva e com o código quando ele importa.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.




