A aplicação das técnicas de mineração de texto pode trazer análises quantitativas informativas sobre a emoção, o tom, a categoria e outros padrões de interesse em documentos textuais. Mas antes de qualquer análise vem uma pergunta prática: onde estão esses documentos, e como trazê-los para dentro do Python? Neste artigo apresentamos bases de dados públicas de Economia e Finanças que podem ser exploradas, assim como as ferramentas de programação que fazem a coleta.
O primeiro passo de todo projeto de mineração de textos é identificar, coletar e preparar os dados brutos, e é essa etapa que costuma consumir a maior parte do tempo de trabalho.
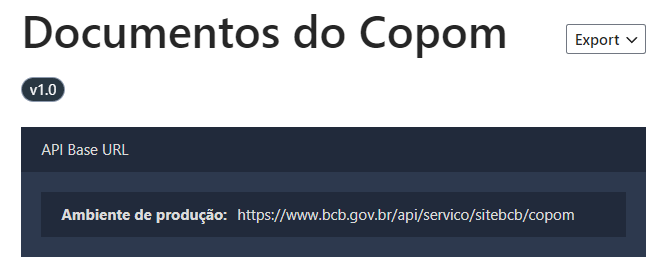
O Banco Central entrega as atas do COPOM por uma API pública documentada, e uma única consulta devolve o texto completo de uma reunião. No exercício que acompanha este artigo, a ata de número 264 retornou 22.479 caracteres de texto pronto para análise.
📬 Estatística, econometria e IA aplicada. Todo dia, no seu e-mail.
O Boletim AM traz modelos estatísticos, econometria e LLMs aplicados a Economia, Finanças e análise de dados, com exemplos em R e Python. Todo domingo, às 20h, uma leitura mais longa que reúne as fontes da semana.
Bases de dados
Documentos textuais podem ser encontrados com facilidade em qualquer lugar, principalmente online. Um post de rede social, um artigo em um site ou um e-book publicado são exemplos de documentos textuais que servem de matéria-prima para as técnicas de mineração de texto. Aqui vamos focar em exemplos de Economia e Finanças que permitem acesso aos dados de forma relativamente fácil.
Banco Central do Brasil
A instituição publica regularmente atas e comunicados sobre as decisões de política monetária, tomadas por um comitê, com informações sobre o que foi discutido pelos diretores do banco nas reuniões.
- Possíveis aplicações: análise de sentimento e análise de tópicos.
- Disponibilização dos dados: via web scraping ou via API.
Bank for International Settlements
A instituição publica regularmente uma base de dados com os discursos proferidos por diretores de bancos centrais de diversos países, em formato compilado e tabular. É a fonte que permite comparar a comunicação de autoridades monetárias de países diferentes sobre o mesmo período.
- Possíveis aplicações: classificação textual e análise de incerteza.
- Disponibilização dos dados: via arquivo de download, com um arquivo por ano.
Fundos de investimento
Diversos fundos de investimento publicam regularmente as chamadas "Cartas do Gestor", com informações sobre o fundo, sobre a economia e sobre a visão do gestor. Quem acompanha muitos fundos recebe mais material do que consegue ler, e é aí que as técnicas de sumarização entram.
- Possíveis aplicações: sumarização textual.
- Disponibilização dos dados: via arquivo de download.
Esses dados são disponibilizados, em geral, de forma não estruturada. Em outras palavras, são textos espalhados e muitas vezes não organizados em uma tabela de fácil manejo, o que exige a etapa de pré-processamento de dados textuais antes de qualquer análise.
Os três formatos em que os dados chegam
As fontes acima cobrem os três formatos mais comuns em que documentos textuais são disponibilizados, e cada um exige um caminho de coleta diferente.
| Formato | Exemplo | O que a coleta exige |
|---|---|---|
| API com resposta estruturada | Atas do COPOM | Consulta ao endereço documentado; o texto já vem em um campo próprio |
| Arquivo tabular compactado | Discursos do BIS | Leitura direta do arquivo; muitos documentos de uma vez |
| Documento em PDF | Cartas de gestores | Extração do texto de dentro do arquivo, página por página |
A ordem também reflete o trabalho que cada um dá. Uma API entrega o texto pronto, um arquivo tabular entrega muitos documentos de uma vez, e um PDF exige extrair os caracteres de uma estrutura que foi feita para impressão, não para análise.
Ferramentas
Existem diversas ferramentas para aplicar técnicas de mineração de texto. Dentre elas, o Python se destaca como uma linguagem versátil e com um amplo conjunto de bibliotecas úteis para trabalhar com esse formato de dado.
Para coletar e realizar alguns processamentos de dados textuais, destaca-se o pandas, além de bibliotecas como requests e as que já vêm com a linguagem, json e urllib. Para os arquivos em PDF, o pypdf percorre a estrutura do documento e devolve os caracteres.
🐼
🌐
📄
📕
Os três exemplos do exercício
No material que acompanha este artigo, cada fonte vira um exemplo funcionando. A coleta da ata do COPOM monta o endereço da API com o número da reunião e recebe de volta um documento com o texto completo, além das datas de referência e publicação.
A base do BIS é lida em uma linha, porque o pandas descompacta o arquivo e monta a tabela sozinho. No recorte de 2026, são 360 discursos, e a contagem por autor mostra Christine Lagarde à frente, com 13 aparições no período.
Já a carta de gestor exige abrir o PDF e percorrer suas páginas. O documento usado no exemplo tem cinco páginas, e o texto de cada uma é guardado em separado, o que ajuda quando o passo seguinte divide o documento em trechos.
As fontes mudam de endereço
Um detalhe prático que raramente aparece nos tutoriais: endereços de download saem do ar. A base de discursos do BIS ficava até 2024 em bis.org/speeches/speeches.zip, e esse endereço hoje responde com erro 404.
A página de download atual organiza a base por ano, o que na prática ficou melhor: dá para baixar apenas o período de interesse em vez da série inteira desde 1996. Quem mantém um projeto de coleta rodando precisa checar as fontes de tempos em tempos, porque a quebra não avisa.
As bibliotecas passam pelo mesmo. Versões anteriores deste material usavam o PyPDFLoader, da biblioteca langchain_community, cujo projeto anunciou a descontinuação. O pypdf resolve a mesma tarefa sem a camada extra, e é o que o exercício usa agora.
Considerações finais
A aplicação das técnicas de mineração de texto pode trazer análises quantitativas informativas sobre a emoção, o tom, a categoria e outros padrões de interesse em documentos textuais, e tudo isso começa por identificar, coletar e preparar os dados brutos.
Neste artigo apresentamos bases de dados públicas de Economia e Finanças que podem ser exploradas, assim como ferramentas de programação úteis. O passo seguinte é o pré-processamento, que transforma o texto coletado em unidades contáveis, e depois as técnicas de extração de informação que produzem os indicadores.
Saber onde estão os dados e como trazê-los para o Python é o que torna a análise possível, e o percurso muda pouco de uma área para outra:
- Economista: monta uma base própria com atas e comunicados de bancos centrais, atualizada a cada reunião.
- Analista de investimentos: coleta cartas de gestores e relatórios em lote, em vez de abrir um arquivo por vez.
- Pesquisador: reúne discursos de autoridades de vários países para comparar a comunicação sobre um mesmo evento.
- Cientista de dados: constrói o processo de coleta que alimenta os modelos, com as fontes verificadas periodicamente.
Aprender a linguagem é o que abre a porta para todas essas frentes.
Linguagem Econômica: mineração de textos de Bancos Centrais
Os dez capítulos do livro digital percorrem o caminho completo: dos primeiros tratamentos de texto ao indicador de sentimentos do COPOM e à classificação do tom da política monetária com IA generativa. Exercícios aplicados, em Python.
Leia também: