
Uma avaliação compara dois grupos, encontra p-valor de 0,32 e conclui que o programa não teve efeito. A conclusão não decorre do resultado. Neste artigo mostramos por que um teste pode falhar em detectar um efeito que existe, e como calcular a chance que ele tinha de encontrá-lo.
Essa chance é o poder estatístico, e sem ela um resultado não significante fica sem interpretação. Ele pode indicar que o efeito não existe, ou que o estudo não tinha tamanho para enxergá-lo.
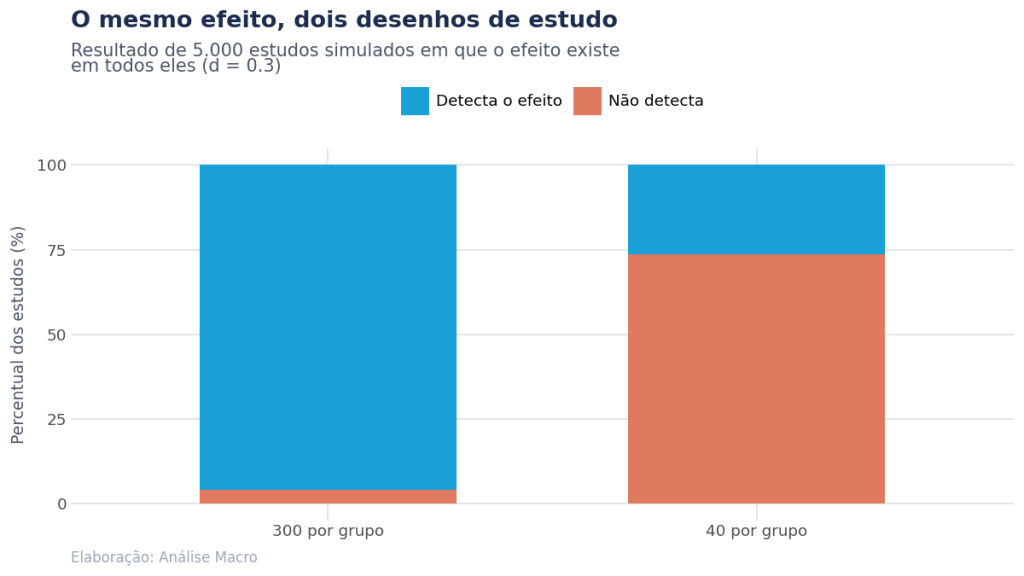
As duas colunas vêm de estudos em que o efeito existe por construção, com o mesmo tamanho. O que muda entre elas é apenas o número de observações por grupo.
No desenho menor, a maioria dos estudos conclui pela ausência de efeito. Quem lesse esses resultados sem considerar o poder diria que o efeito não existe, enquanto ele aparece na quase totalidade dos estudos do desenho maior.
📩 O modelo continua valendo. O que mudou é a velocidade
Quem já sabe econometria tem a parte difícil resolvida: saber qual pergunta fazer e como checar se a resposta faz sentido. No Boletim AM eu mostro, todo dia, como a IA entra nesse trabalho, sem substituir o julgamento de quem entende o modelo.
Todo dia no seu e-mail. Gratuito, e sai num clique.
Os dois erros possíveis
Um teste de hipóteses pode errar de duas maneiras, e elas recebem tratamento diferente.
O erro do tipo I é acusar um efeito que não existe. A probabilidade dele é o nível de significância, fixado pelo pesquisador, em geral em 5%.
O erro do tipo II é deixar passar um efeito que existe. A probabilidade dele não é escolhida: resulta do desenho do estudo, e costuma não ser calculada.
O poder é o complemento do erro do tipo II.
Aqui β é a probabilidade do erro do tipo II e H0 é a hipótese nula, a de que não existe efeito.
Um poder de 80% significa que, se o efeito tiver o tamanho suposto, o teste o encontrará em 80% das repetições do estudo. Nos outros 20%, o mesmo efeito passará despercebido.
De que depende o poder
Três quantidades determinam o poder de um teste de comparação entre duas médias. A primeira é o tamanho do efeito, a diferença entre os grupos medida em desvios-padrão.
As duas médias dos grupos aparecem no numerador e o desvio-padrão comum no denominador. Padronizar dessa forma permite comparar estudos de variáveis diferentes.
As outras duas são o tamanho da amostra, que entra pela raiz quadrada, e o nível de significância, já que um corte mais exigente reduz o poder.
Quanto custa procurar um efeito pequeno
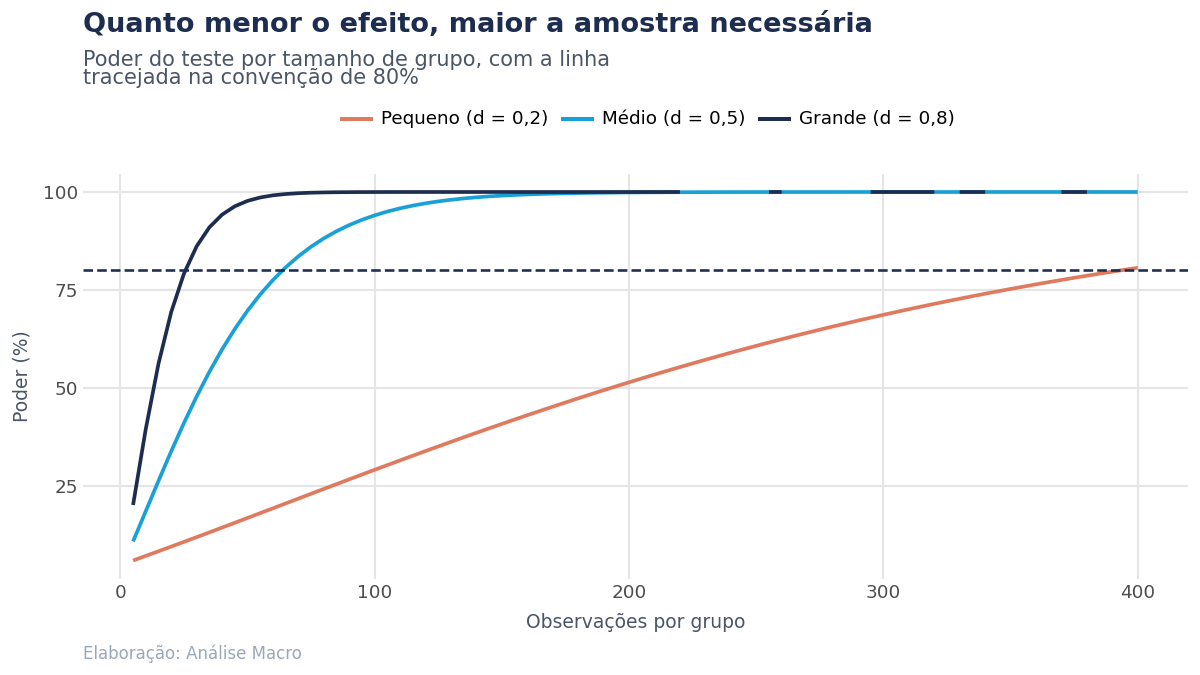
As três curvas sobem com o tamanho da amostra e se achatam perto de cem por cento. A distância horizontal entre elas é o custo de procurar efeitos menores.
A linha tracejada marca a convenção de 80%. Para um efeito grande, ela é cruzada com poucas dezenas de observações por grupo; para um efeito pequeno, são necessárias várias centenas.
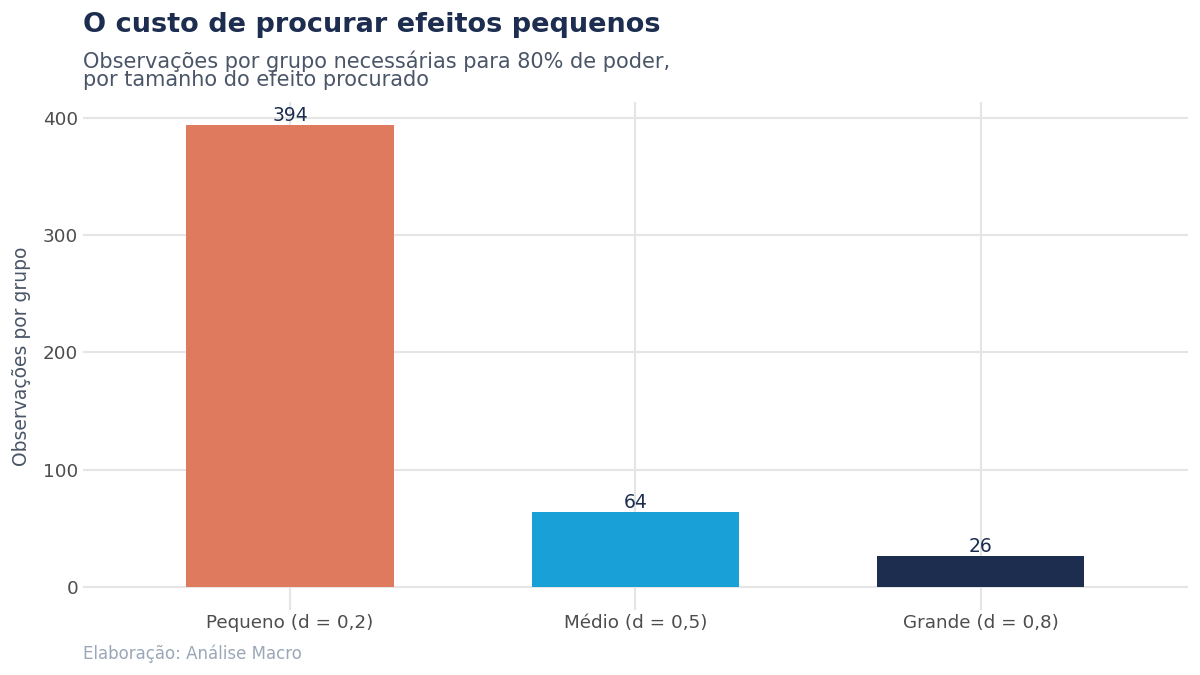
Reduzir o efeito procurado pela metade exige aproximadamente quadruplicar a amostra, porque o tamanho da amostra entra na fórmula pela raiz quadrada.
É essa relação que torna caro estudar efeitos pequenos, e que explica por que avaliações com amostra modesta raramente conseguem distinguir um efeito pequeno de nenhum efeito.
O efeito mínimo detectável
Com a amostra já definida, a pergunta útil muda: qual o menor efeito que esse estudo conseguiria encontrar com segurança razoável.
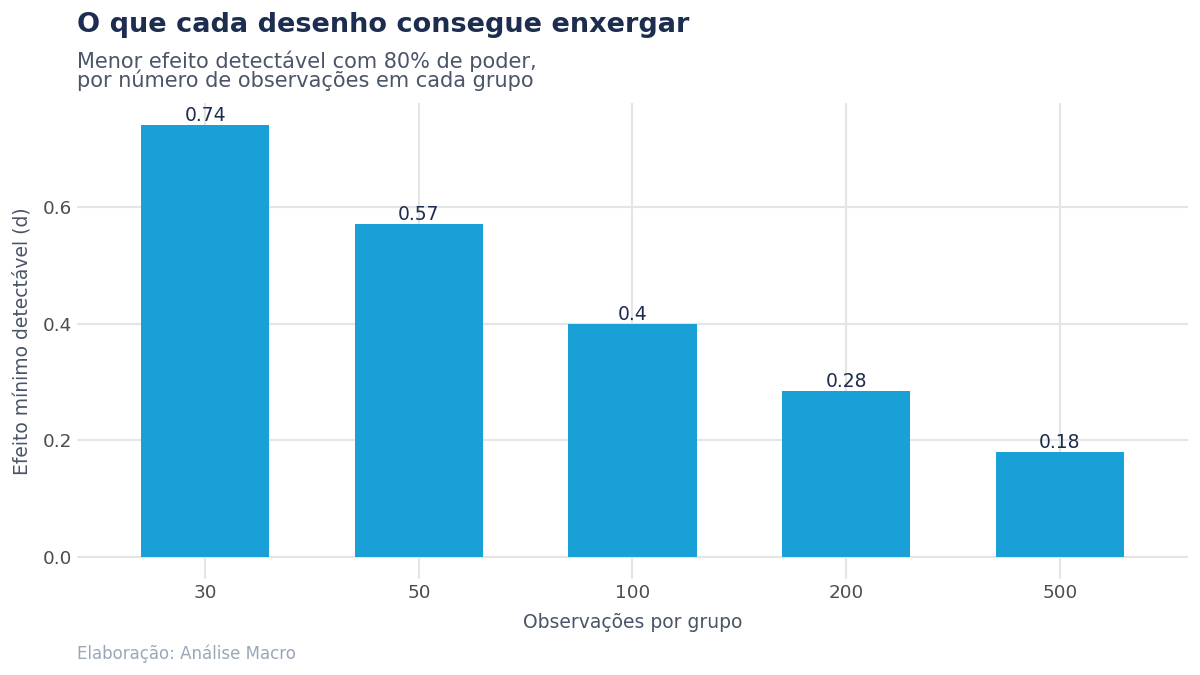
As barras caem conforme a amostra cresce, e a queda desacelera. Dobrar a amostra não dobra a capacidade de detectar efeitos pequenos.
Esse cálculo quase nunca aparece nas leituras de um resultado não significante. Ele responde o que o estudo era capaz de enxergar, antes de qualquer discussão sobre o que ele encontrou.
Um estudo com poucas dezenas de observações por grupo que não encontra efeito pequeno estava, desde o início, com pouca chance de encontrá-lo. O resultado informa pouco sobre o mundo e muito sobre o desenho do estudo.
Os limites do que o exercício mostra
O exercício trata do teste de comparação entre duas médias. Desenhos com múltiplos grupos, dados em painel ou desfechos binários têm fórmulas próprias, embora a lógica das três quantidades permaneça.
O roteiro para ler um resultado não significante
| Passo | O que verificar |
|---|---|
| 1 | Qual o tamanho da amostra em cada grupo? |
| 2 | Qual o menor efeito que esse desenho detectaria com 80% de poder? |
| 3 | O efeito de interesse prático é menor que esse mínimo? Se for, o estudo não podia encontrá-lo. |
| 4 | O intervalo de confiança inclui efeitos relevantes? Se inclui, nada foi descartado. |
| 5 | Reporte o efeito estimado com o intervalo de confiança, que mostra a faixa compatível com os dados. |
O quarto passo é o mais direto na prática. Um intervalo de confiança largo, que vai de um efeito negativo relevante a um positivo relevante, diz com clareza que o estudo não tinha precisão para separar as hipóteses.
Considerações finais
O poder estatístico é decidido antes da coleta e cobrado depois dela. Quem planeja o estudo escolhe o tamanho da amostra sabendo qual efeito quer ser capaz de detectar; quem lê o estudo pronto precisa refazer essa conta ao contrário.
Em Python o cálculo é curto, e cabe tanto no planejamento quanto na leitura crítica de um resultado alheio.
- Analista de dados: dimensiona um teste A/B antes de rodá-lo, em vez de descobrir no fim que a amostra não bastava.
- Economista: lê avaliação de política pública verificando o efeito mínimo detectável antes de aceitar a conclusão de ausência de efeito.
- Gestor de risco: entende por que um backtest curto não distingue uma estratégia mediana de uma sem valor.
- Pesquisador: justifica o tamanho da amostra no desenho do estudo, e não depois do resultado.
- Atuária: avalia se a base de sinistros tem tamanho para detectar a diferença de risco entre perfis.
A pergunta que organiza todos esses casos é a mesma: o que este desenho era capaz de enxergar?
Você viu o poder; aprenda a dimensionar o teste
De estatística descritiva a testes de hipótese e regressão, com Python aplicado a dados econômicos reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
BUTTON, K. S. et al. Power failure: why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, v. 14, n. 5, p. 365-376, 2013.
COHEN, J. Statistical Power Analysis for the Behavioral Sciences. 2. ed. Hillsdale: Lawrence Erlbaum Associates, 1988.
GELMAN, A.; CARLIN, J. Beyond Power Calculations: Assessing Type S (Sign) and Type M (Magnitude) Errors. Perspectives on Psychological Science, v. 9, n. 6, p. 641-651, 2014.
HOENIG, J. M.; HEISEY, D. M. The Abuse of Power. The American Statistician, v. 55, n. 1, p. 19-24, 2001.
WASSERSTEIN, R. L.; LAZAR, N. A. The ASA Statement on p-Values: Context, Process, and Purpose. The American Statistician, v. 70, n. 2, p. 129-133, 2016.
Leia também: Testes múltiplos e p-hacking

