Neste texto aprenderemos sobre regressões lineares, o que são, como funcionam e como podem ser usadas. Abordaremos de forma introdutória e objetiva o assunto e assumimos que o leitor possua algum conhecimento prévio sobre álgebra linear, cálculo diferencial e estatística.
Tomaremos como base o livro de Hyndman e Athanasopoulos (2021), que aborda o assunto de maneira prática e introdutória, focando em previsão. Se você precisar ou quiser se aprofundar, veja também Wooldridge (2020) para uma exposição mais detalhada. Este último costuma ser livro-texto de cursos de graduação, especialmente em disciplinas de econometria.
O modelo linear
Vamos começar entendendo o que é o modelo de regressão linear, suas aplicações e esclarecer algumas nomenclaturas utilizadas.
O que é?
Uma regressão linear é uma forma de modelar a relação entre variáveis utilizando uma função linear (combinação linear) relativamente simples e interpretável, expressa por meio de uma equação. A ideia básica da regressão linear é que tentamos explicar uma variável y assumindo uma relação linear com outra variável x.
Por exemplo, podemos tentar explicar as vendas mensais, y, de produtos/serviços de uma empresa com base no gasto mensal, x, em publicidade/propaganda.
Aplicações
Alguns exemplos de uso de regressões lineares são:
🔮
🔗
📈
⚖️
Nomenclaturas
A variável do lado esquerdo da equação costuma ser referida como y e pode ter vários nomes a depender do interlocutor: variável dependente, explicada, resposta, endógena.
As variáveis do lado direito da equação costumam ser referidas como x e também podem ter vários nomes: variável independente, explicativa, preditora, regressora, exógena, covariável.
Nesse texto usaremos a nomenclatura variável dependente e independente.
Regressão simples
No caso mais simples, a regressão linear relaciona uma variável dependente y e uma única variável independente x. Plotando estas variáveis em um gráfico de dispersão, imagine que o resultado seja esse:
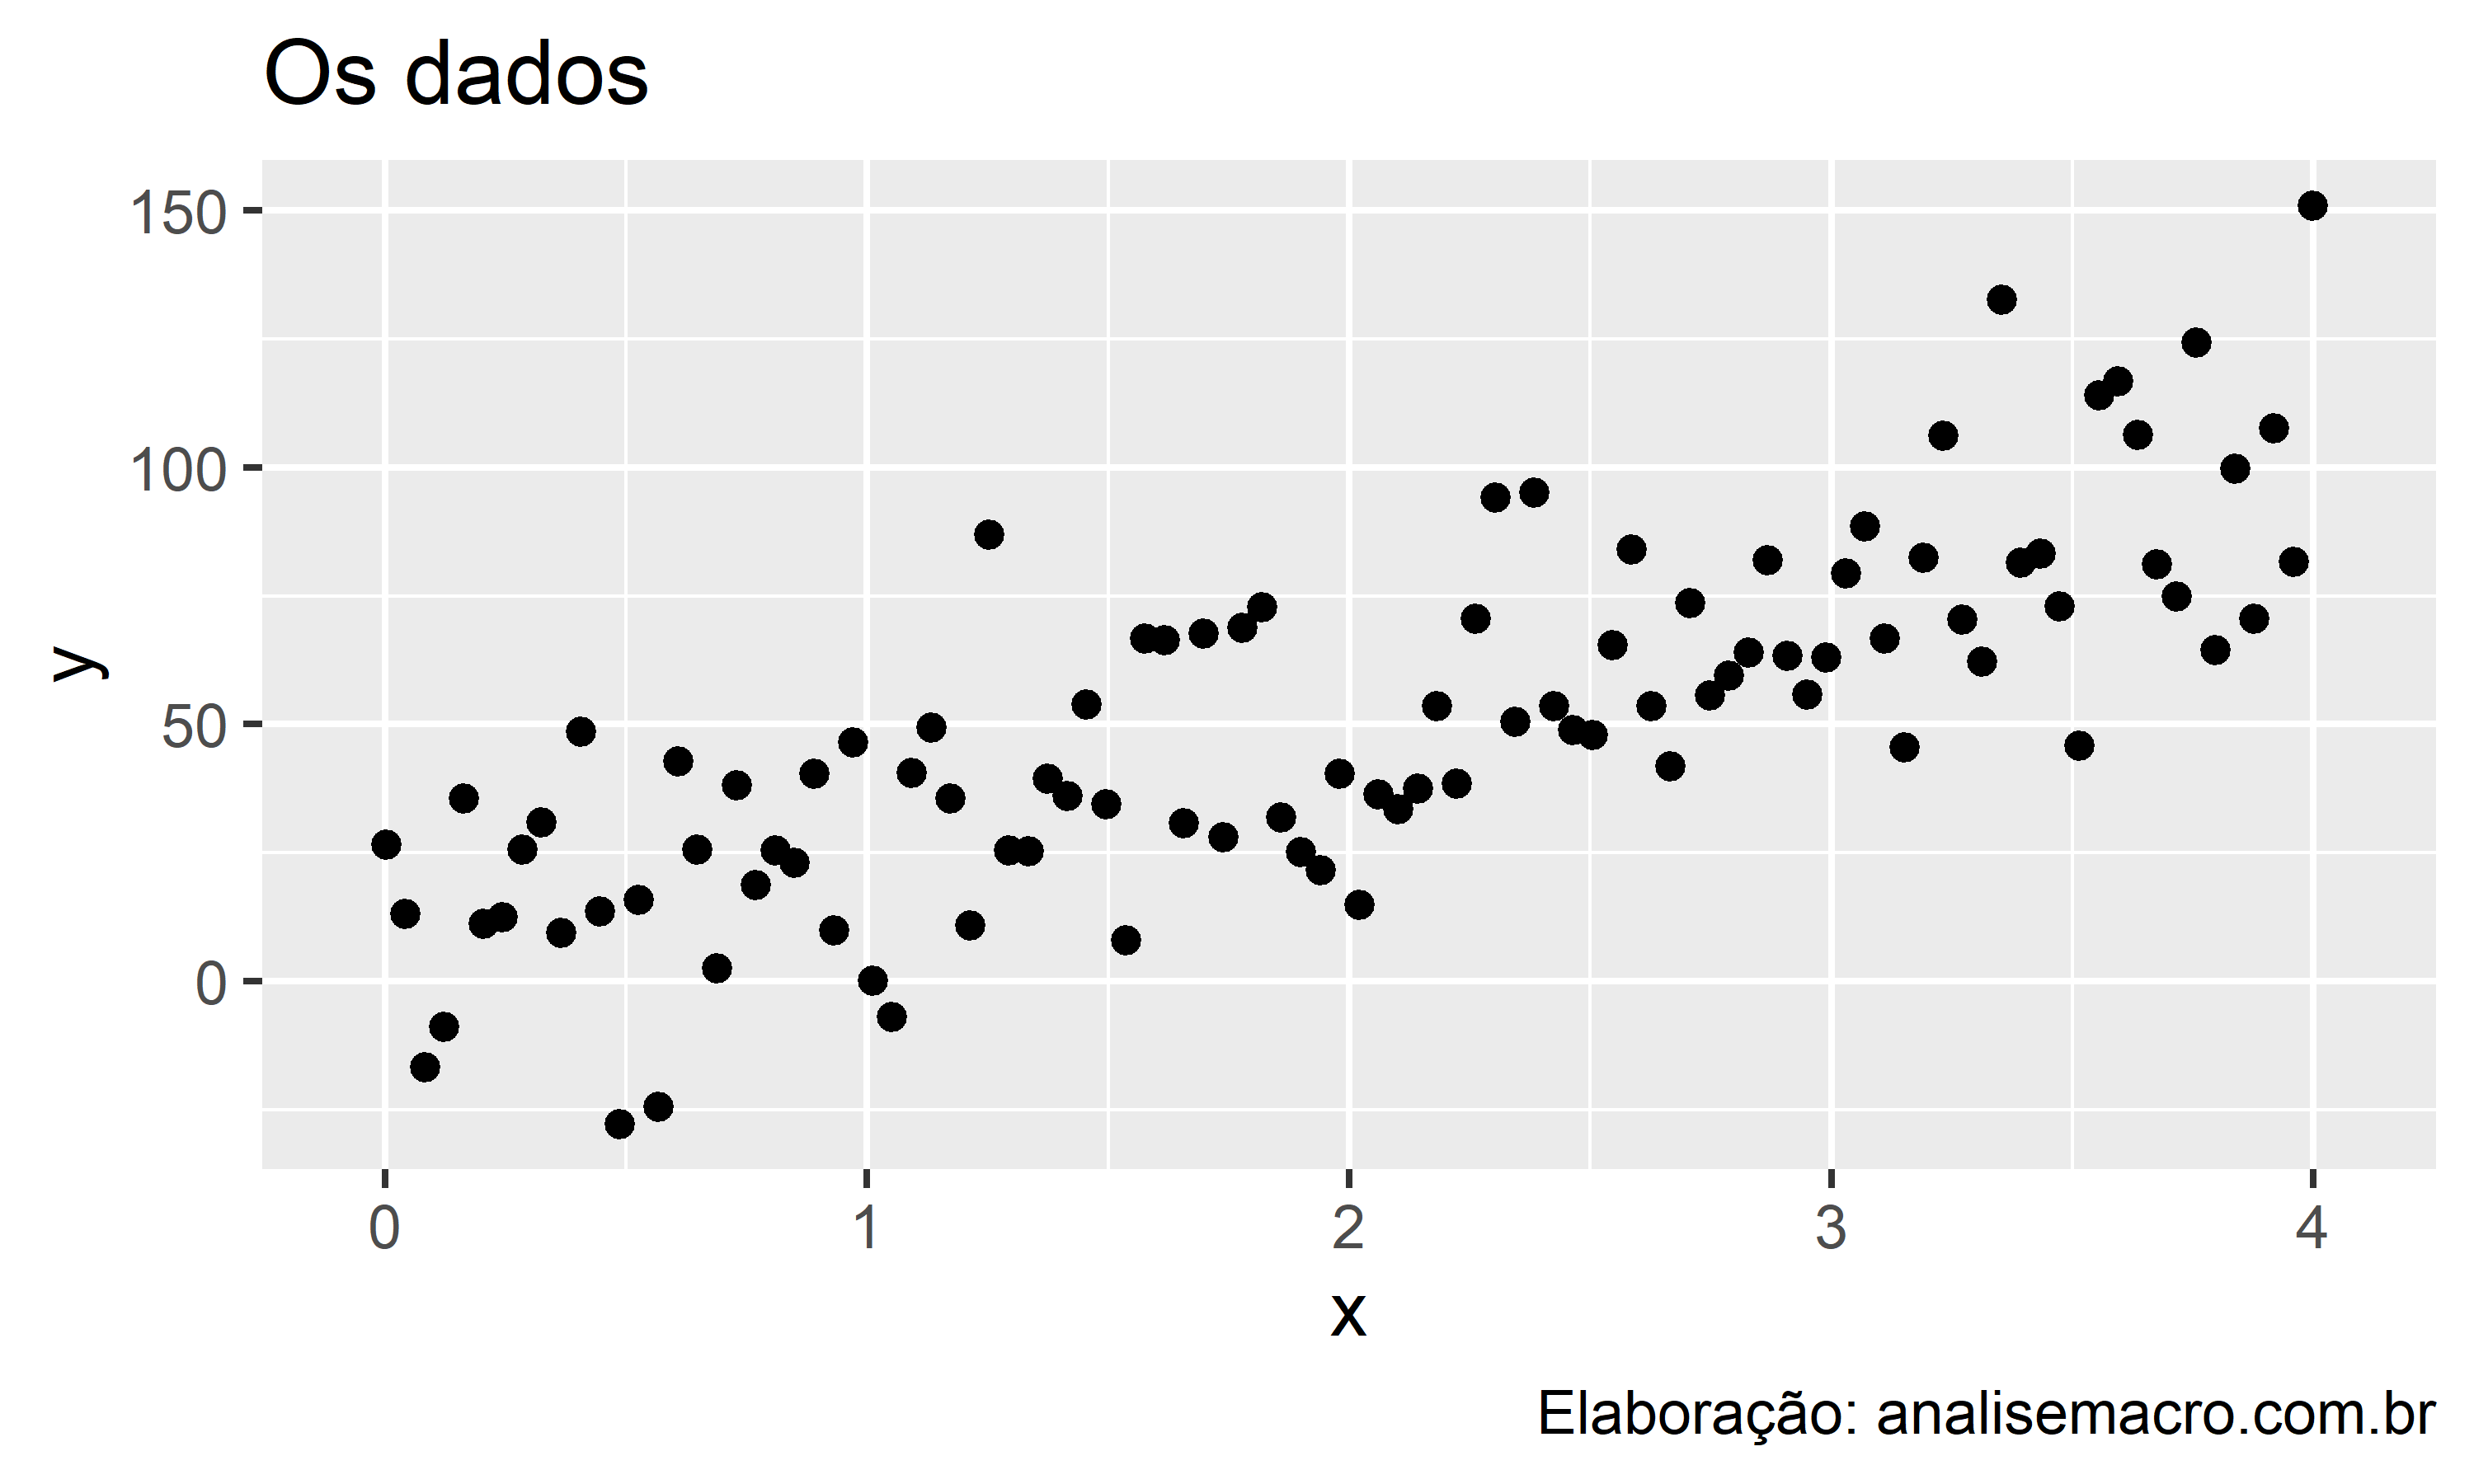
Vamos tomar como exemplo que o y é o preço de imóveis e que o x é a área em metros quadrados. Dessa forma, queremos prever o preço de imóveis com base na área dos mesmos. Em outras palavras, queremos relacionar estas variáveis usando regressão linear, o que significa que queremos encontrar uma linha (reta) que, quando desenhada no gráfico, melhor relacione as variáveis.
Existem muitas possibilidades de linhas para representar a relação entre as variáveis. Das opções abaixo, qual seria a que melhor cumpre esse objetivo?

Seria a linha azul, verde, azul, nenhuma? Uma linha horizontal? Vertical?
É razoável dizer que a linha verde parece ser a reta que melhor relaciona os dados, pois ela é a reta que está menos distante da maioria das observações. E é exatamente isso, ilustrado didaticamente no gráfico acima, que o modelo de regressão linear tenta fazer ao relacionar as variáveis y e x: encontrar uma reta que minimize a distância da mesma com os pontos de dados.
A equação do modelo de regressão linear simples pode ser representada conforme abaixo:
Os coeficientes β0 e β1 são o intercepto e a inclinação da reta, respectivamente, e podem ser entendidos como:
- β0 representa o valor esperado de y quando x = 0;
- β1 representa a mudança média esperada em y resultante de um aumento de uma unidade em x.
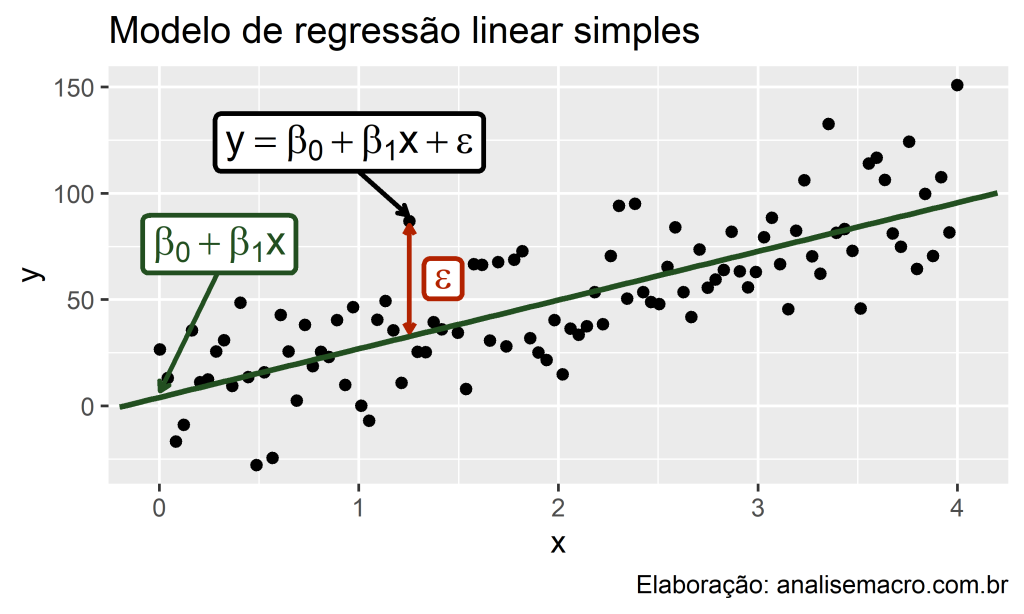
O termo ε é o erro do modelo, ou seja, a distância entre os valores observados e os valores estimados (ε = y − (β0 + β1 x)), pode ser entendido como aquilo que o modelo não consegue explicar (existem muitos detalhes técnicos sobre esse termo que iremos omitir aqui).
Visualmente, estes termos correspondem aos elementos destacados neste gráfico:

No modelo linear, os parâmetros (também chamados de coeficientes) são desconhecidos e estimados a partir dos dados observados das variáveis. No exemplo, a reta tem uma inclinação positiva, o que reflete uma relação positiva entre as variáveis.
Regressão múltipla
A regressão linear múltipla é uma extensão natural do caso simples para quando há mais de uma variável independente no modelo. A representação geral desse modelo é:
Onde y é a variável a ser explicada pelas variáveis independentes x1, x2, ⋯, xk. Vale dizer que o termo de erro ε não significa um "equívoco", mas apenas o desvio da "reta" de ajuste do modelo (nesse caso a representação gráfica teria múltiplas dimensões). Ele captura tudo que pode afetar y mas não está presente em xk.
Na regressão múltipla, cada coeficiente β1, β2, ⋯, βk do modelo mede o efeito de cada variável independente após levar em conta o efeito de todas as demais variáveis do modelo. Sendo assim, dizemos que cada coeficiente mede o efeito marginal das variáveis independentes. Ao analisá-los individualmente costumam-se utilizar a expressão ceteris paribus, que significa "tudo o mais constante".
Premissas
Quando usamos o modelo de regressão linear, implicitamente assumimos algumas premissas sobre a equação anterior. Aqui vamos destacar algumas delas:
Primeiro, assumimos que o modelo é uma aproximação razoável da realidade, ou seja, a relação entre a variável dependente e as variáveis independentes satisfazem essa equação linear.
Segundo, assumimos as seguintes premissas sobre o termo de erro ε da regressão:
- Erros têm média zero, caso contrário, os valores previstos de y serão sistematicamente tendenciosos;
- Erros não são autocorrelacionados, caso contrário, as previsões serão ineficientes, pois haveria mais informações nos dados que poderiam ser exploradas;
- Erros não têm relação com as variáveis independentes, caso contrário, haveria mais informações que deveriam ser incluídas na parte sistemática do modelo.
Também é útil ter os erros distribuídos normalmente com uma variância constante para produzir intervalos de previsão. Vale pontuar que as premissas podem variar conforme o método de estimação dos coeficientes.
O estimador de mínimos quadrados
Para estimar um modelo de regressão linear, geralmente só temos em mãos os dados observados, mas os coeficientes são desconhecidos. Precisamos estimá-los!
Uma maneira (provavelmente a mais utilizada) de estimar os coeficientes do modelo é minimizando o termo de erro. Usando a equação da regressão linear simples, o termo de erro pode ser representado como:
Ou seja, o termo de erro é a diferença entre os valores observados de y e a estimativa ("reta") do modelo. Sendo assim, a técnica de mínimos quadrados ordinários possibilita encontrar valores para os coeficientes por uma forma eficaz, minimizando a soma dos quadrados dos resíduos (erros), ou seja, minimizando:
Isso é chamado de estimação de mínimos quadrados pois computa o menor valor da soma do quadrado dos resíduos, procedimento que pode ser feito por derivada. Costuma-se utilizar várias abreviações para esse método, como MQO, MMQ ou OLS. Existem variações que partem do mesmo princípio, como os Mínimos Quadrados em 2 Estágios (TSLS).
Ao derivar esse problema de minimização em relação a β0 e β1, obtemos que:
Σ (xt − x̄)(yt − ȳ)
Σ (xt − x̄)2
Onde ȳ e x̄ é a média amostral de y e x, respectivamente. Veja que não é um bicho de sete cabeças, certo? Vamos fazer um exemplo numérico para facilitar o entendimento.
Exemplo prático: regressão para previsão de preço de imóveis
Agora que você entendeu o básico sobre o assunto, vamos fazer um exercício aplicado de regressão linear.
Conjunto de dados
Usaremos um conjunto de dados sobre imóveis, o conhecido Ames Housing Data, que possui 82 variáveis sobre 2930 imóveis na cidade de Ames, em Iowa (EUA). Entre as variáveis, existe o Preço de Venda (y) e o Tamanho do Lote em m² (x), sendo assim, nosso objetivo será prever y com base em x. Para mais informações sobre os dados veja De Cock (2011).
O modelo a ser estimado é este:
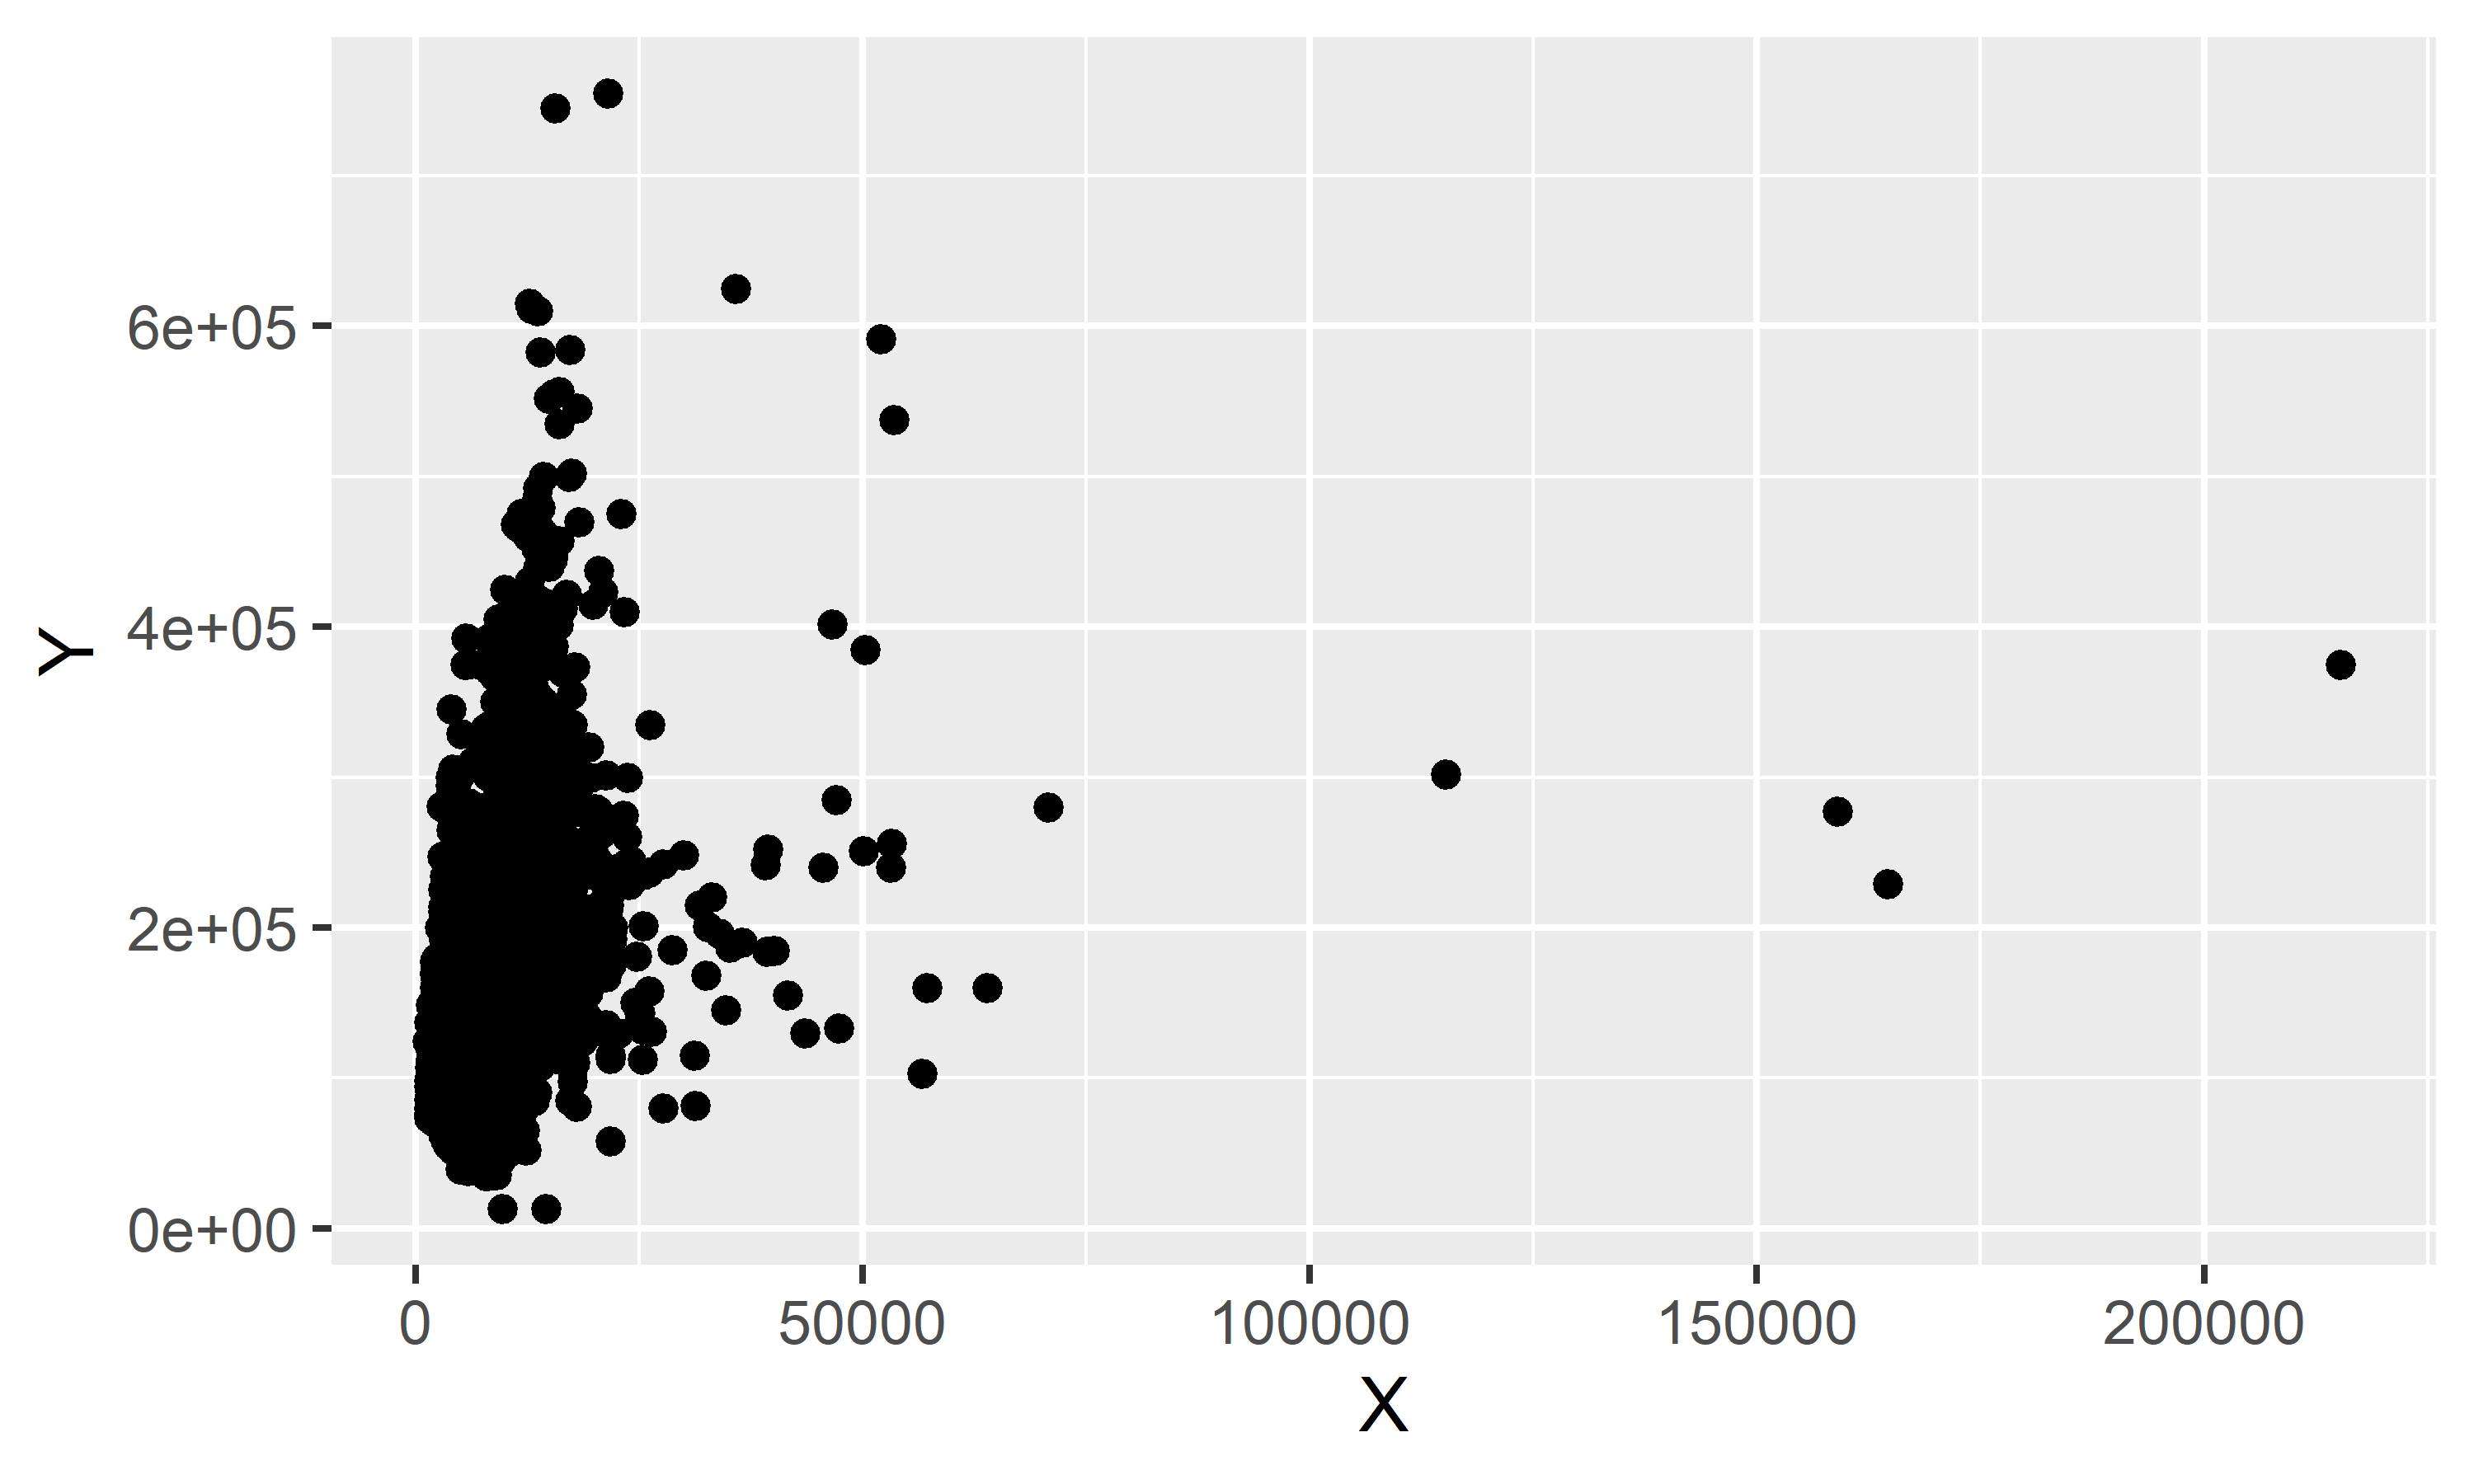
Abaixo importamos os dados e plotamos um gráfico de dispersão entre as variáveis:
library(dplyr)
library(modeldata)
library(ggplot2)
library(splitTools)# Importa dados
dados <- dplyr::select(modeldata::ames, "Y" = "Sale_Price", "X" = "Lot_Area")# Gráfico de dispersão
ggplot2::ggplot(dados) +
ggplot2::aes(y = Y, x = X) +
ggplot2::geom_point()
Separação de amostras
Agora vamos separar o conjunto de dados em duas amostras, de treino e de teste, usando amostragem aleatória simples com proporções 70%/30%, respectivamente. Abaixo reportamos a quantidade de linhas em cada caso:
set.seed(1984)
particoes <- splitTools::partition(
y = dados$Y,
p = c(treino = 0.7, teste = 0.3),
type = "basic"
)# Separa amostras
treino <- dados[particoes$treino, ]
teste <- dados[particoes$teste, ]# Reporta número de linhas
print(paste0("Treino: ", nrow(treino), " linhas"))
print(paste0("Teste: ", nrow(teste), " linhas"))
[1] "Teste: 879 linhas"
Pré-processamento de dados
Conforme pode ser observado no gráfico de dispersão acima, existem valores extremos nos dados. Vamos optar por aplicar a regra de corte do IQR, conforme Hyndman e Athanasopoulos (2021), para remover estes valores dos conjuntos de dados. Tratamos esse tipo de limpeza em detalhe no guia de Pré-processamento: lidando com valores extremos e valores ausentes. Abaixo plotamos um gráfico de dispersão usando a amostra de treino após esse pré-processamento:
regra_iqr <- function(x, side) {
if (side == "lower") {
lower <- quantile(x = x, probs = 0.25, na.rm = TRUE) - 1.5 * IQR(x = x, na.rm = TRUE)
return(lower)
} else if (side == "upper") {
upper <- quantile(x = x, probs = 0.75, na.rm = TRUE) + 1.5 * IQR(x = x, na.rm = TRUE)
return(upper)
} else stop("side tem que ser lower ou upper")
}# Filtra dados
treino <- treino |>
dplyr::filter(
!Y < regra_iqr(Y, "lower") & !Y > regra_iqr(Y, "upper"),
!X < regra_iqr(X, "lower") & !X > regra_iqr(X, "upper")
)
teste <- teste |>
dplyr::filter(
!Y < regra_iqr(Y, "lower") & !Y > regra_iqr(Y, "upper"),
!X < regra_iqr(X, "lower") & !X > regra_iqr(X, "upper")
)# Gráfico de dispersão
ggplot2::ggplot(treino) +
ggplot2::aes(y = Y, x = X) +
ggplot2::geom_point()

[1] "Teste: 792 linhas"
Estimação MQO "na mão"
Vamos focar em aprender primeiro a mecânica do método de mínimos quadrados ordinários, fazendo os cálculos "na mão", com a ajuda de uma planilha eletrônica. Após aprender o fundamento do método, iremos expor os códigos, usando linguagem de programação, que fazem tudo automaticamente!
- Baixe os dados da amostra de treino em formato CSV por esse link.
- Faça o login na sua conta do Google, navegue até o Google Drive e faça o upload do arquivo CSV.
- Abra o arquivo de dados CSV no Google Planilhas (Sheets).
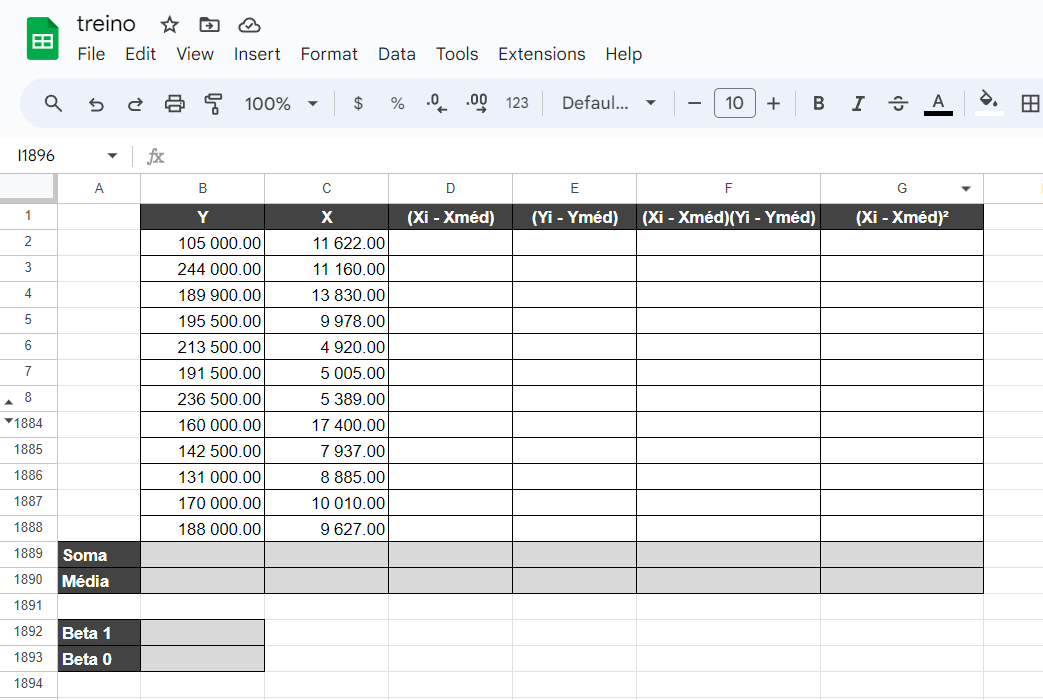
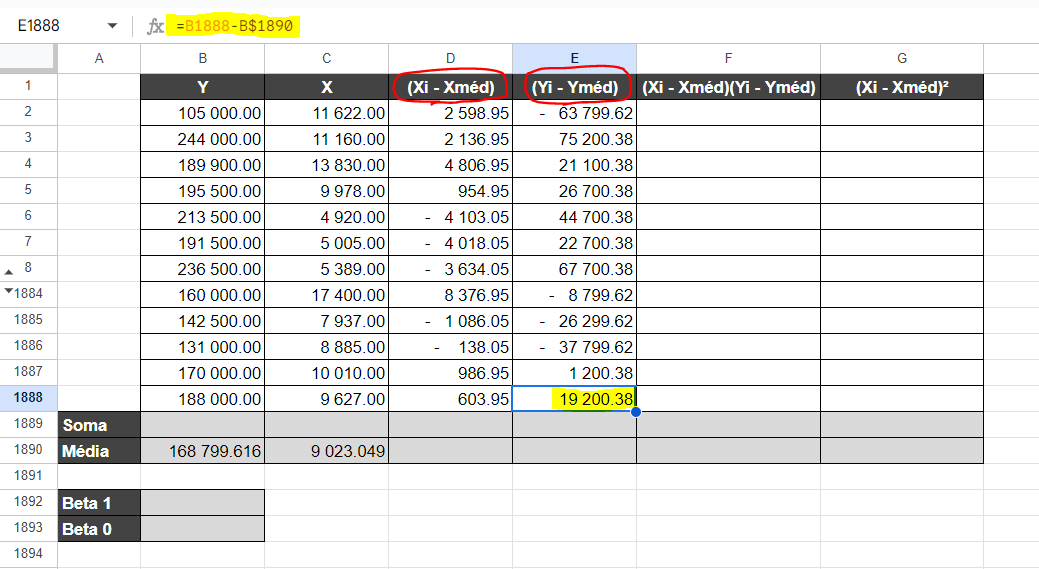
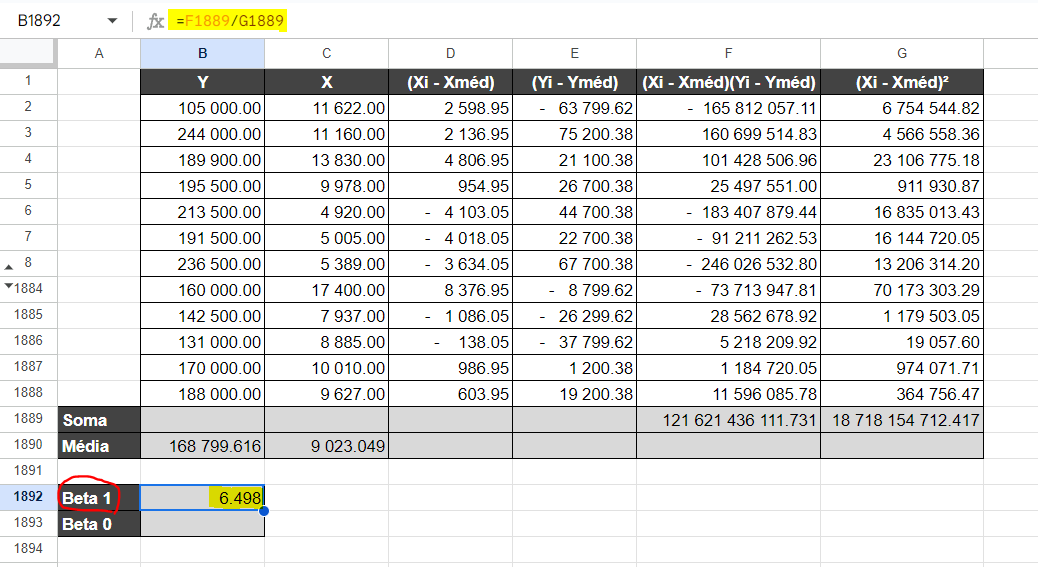
- Adicione, conforme a imagem, os nomes para novas colunas e, no final da tabela, linhas para Soma, Média e Beta 1 e Beta 0 para finalidade de calcular os termos das fórmulas acima (ocultamos várias linhas para caber na imagem).

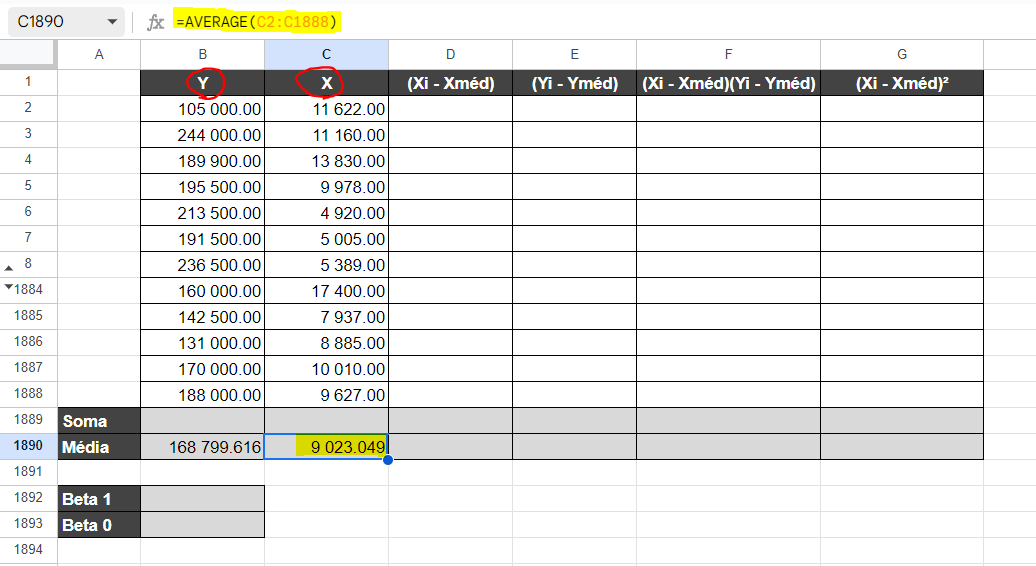
- Comece calculando a média das colunas Y e X e armazene o resultado no final da tabela, conforme a imagem.
- Prossiga calculando cada valor de Y e X menos a média correspondente (o valor da média deve ser fixado na fórmula) e armazene o resultado nas colunas D (X − Xméd) e E (Y − Yméd), conforme a imagem.
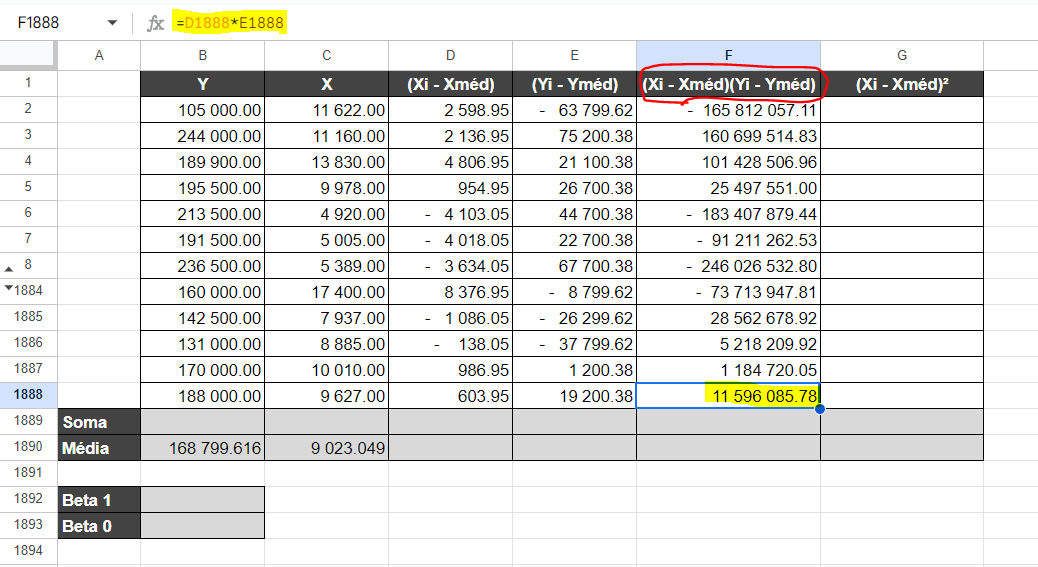
- Na coluna da direita, F, multiplique os valores de D (X − Xméd) pelos valores de E (Y − Yméd), conforme a imagem.
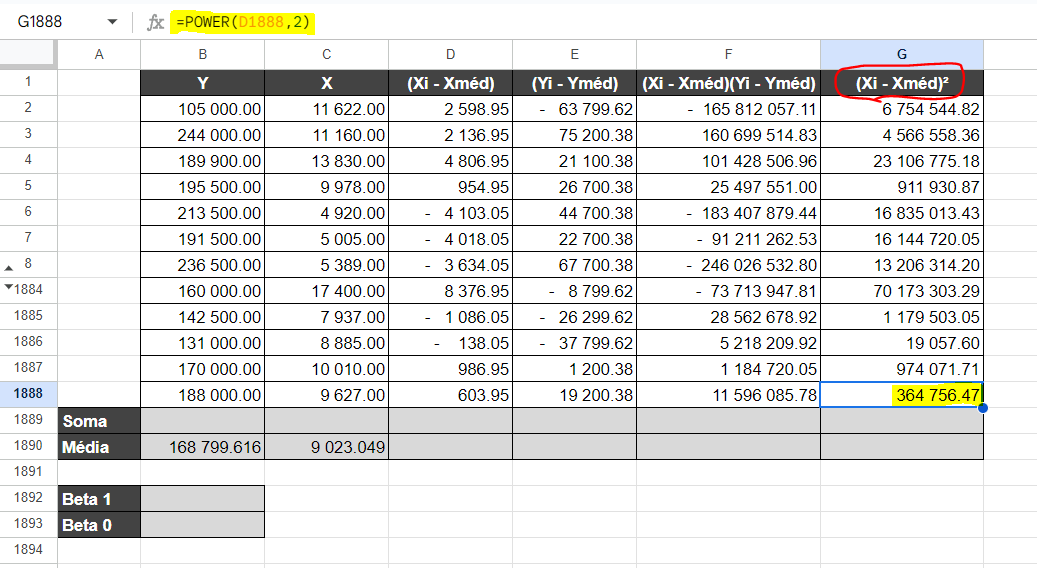
- Na última coluna, G, calcule o quadrado da coluna D (X − Xméd), conforme a imagem.
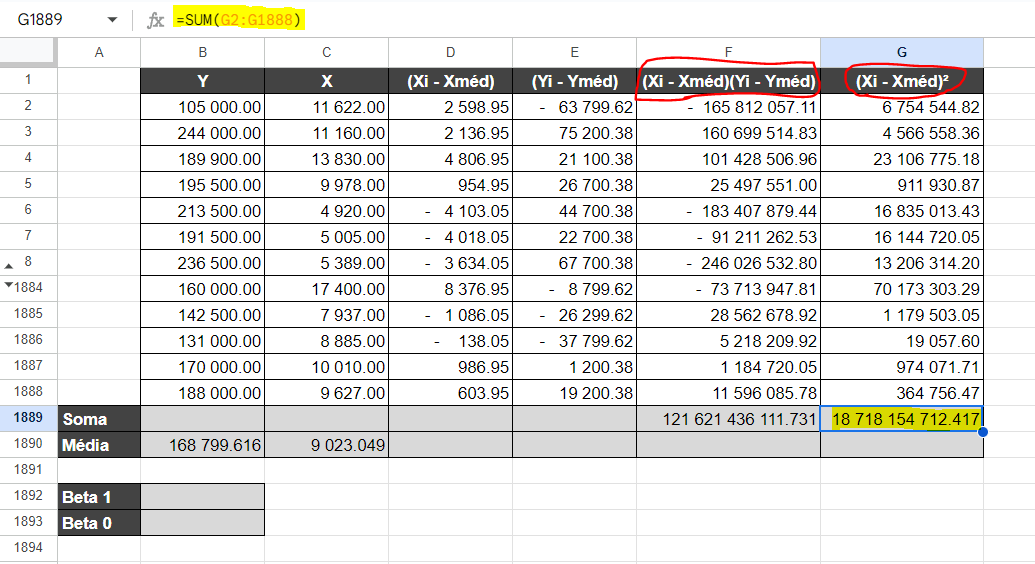
- Prossiga calculando a soma das duas últimas colunas, F e G, e armazene o resultado no final da tabela, conforme a imagem.
- Por fim, podemos calcular os coeficientes começando pelo Beta 1, basta aplicar a fórmula acima, conforme a imagem.
- Finalize calculando o coeficiente Beta 0 aplicando a fórmula da imagem.
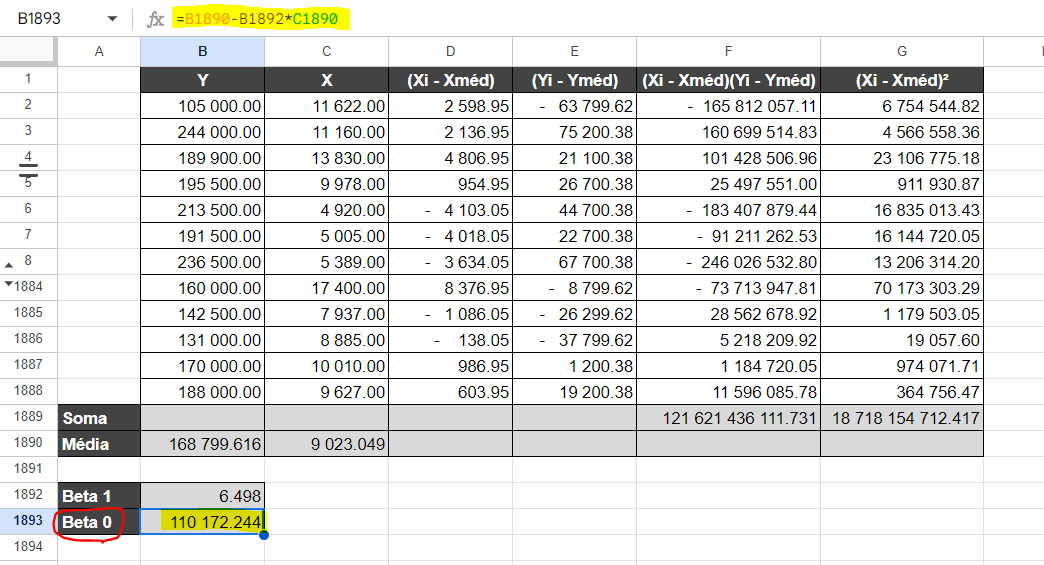
Viu só? Nem doeu e agora você sabe fazer uma regressão linear "no braço" (nem todo mundo sabe)!
Se deu tudo certo você chegou a estes valores:
121.621.436.111,731
18.718.154.712,417
= 6,498
O chapéu significa que é o coeficiente estimado, pois o coeficiente "verdadeiro" é desconhecido. Dessa forma, este é o simples modelo estimado para o preço dos imóveis em Ames, Iowa:
📩 Quem lê o dado decide melhor
Inflação, juros e atividade não se leem no olho, se leem com método. No Boletim AM mostramos, todo dia, a estatística, a econometria e a IA por trás da leitura de conjuntura. Com a fonte, com a ressalva e com o código quando ele importa.
Veja a aula completa em vídeo
Nesta aula, percorremos o mesmo caminho deste texto com o código rodando na tela, da teoria do modelo linear até a estimação no R.
Estimação MQO no R
Agora que entendemos a mecânica do método, podemos deixar o trabalho pesado com o computador. No R, a função lm() estima o modelo com uma linha, recebendo a fórmula Y ~ X e o conjunto de dados:
modelo <- lm(formula = Y ~ X, data = treino)# Reporta resultados
summary(modelo)
lm(formula = Y ~ X, data = treino)Residuals:
Min 1Q Median 3Q Max
-191832 -38373 -11002 35593 185467Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 1.102e+05 3.965e+03 27.78 <2e-16 ***
X 6.497e+00 4.149e-01 15.66 <2e-16 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 56770 on 1885 degrees of freedom
Multiple R-squared: 0.1151, Adjusted R-squared: 0.1146
F-statistic: 245.2 on 1 and 1885 DF, p-value: < 2.2e-16
Repare que os coeficientes estimados pela função são os mesmos que calculamos na planilha: o intercepto em 1,102 × 105, ou seja, 110.172, e a inclinação em 6,497. A diferença na última casa decimal vem apenas do arredondamento da planilha.
Com o modelo estimado, podemos prever a amostra de teste e medir o erro pela raiz do erro quadrático médio (RMSE), que expressa o erro médio na mesma unidade da variável dependente, em dólares:
previsao <- predict(modelo, newdata = teste)# Acurácia pelo RMSE
erro_treino <- treino$Y - modelo$fitted.values
erro_teste <- teste$Y - previsao
rmse_treino <- sqrt(mean(erro_treino^2, na.rm = TRUE))
rmse_teste <- sqrt(mean(erro_teste^2, na.rm = TRUE))# Imprime valores
print(paste0("RMSE de treino: ", rmse_treino))
print(paste0("RMSE de teste: ", rmse_teste))
[1] "RMSE de teste: 49921.7191925989"
O R² de 0,1151 indica que o tamanho do lote explica cerca de 11,5% da variação do preço de venda. É um valor baixo, e isso faz sentido: o preço de um imóvel depende de muitas outras características além da área do terreno, como localização, ano de construção e qualidade do acabamento. O caminho natural, a partir daqui, é a regressão múltipla.
Vale notar que o erro de teste ficou abaixo do erro de treino neste exercício. O comportamento usual é o oposto, e a relação entre o ajuste dentro da amostra e o desempenho fora dela é o que se estuda no dilema de viés e variância em modelos preditivos.
Considerações finais
A regressão linear é o ponto de partida de boa parte da econometria e do aprendizado de máquina. Entender a mecânica do estimador de mínimos quadrados, como fizemos aqui na planilha e no R, é o que permite ler criticamente um resultado em vez de apenas rodar uma função.
O mesmo caminho percorrido neste exercício, que consiste em importar, separar amostras, tratar e estimar, se aplica a boa parte dos problemas de modelagem. O que muda é a aplicação:
- Economista: estimar elasticidades e relações entre variáveis macroeconômicas, com o cuidado de interpretar cada coeficiente ceteris paribus.
- Analista de dados: construir o modelo de referência (baseline) contra o qual qualquer método mais sofisticado precisa provar que vale a pena.
- Analista de mercado: relacionar preços, volumes e indicadores, e medir o erro fora da amostra antes de confiar na previsão.
- Estudante e pesquisador: dominar o método que é pré-requisito para praticamente toda a econometria aplicada.
Aprender a linguagem é o que abre a porta para todas essas frentes.
Referências
De Cock, D. (2011). Ames, Iowa: Alternative to the Boston Housing Data as an End of Semester Regression Project. Journal of Statistics Education, 19(3).
Hyndman, R.J., & Athanasopoulos, G. (2021). Forecasting: principles and practice, 3rd edition. OTexts: Melbourne, Australia.
Wooldridge, J. M. (2020). Introductory Econometrics: A Modern Approach. 7th edition. Cengage Learning.
Aprenda a construir a análise completa
O AM Black é a assinatura anual com acesso a todas as formações da Análise Macro: da regressão linear à modelagem econométrica aplicada, em R e em Python, pelo mesmo caminho percorrido aqui.
Leia também: