
A previsão da taxa de desocupação com um VECM, o modelo vetorial de correção de erros, projeta o desemprego brasileiro junto com a atividade econômica, os juros e a renda do trabalho, respeitando a relação de longo prazo entre essas séries. Neste tutorial, mostramos como montar essa previsão no Python, do teste de raiz unitária à projeção com intervalo de 95%.
Existem inúmeras formas de prever uma série econômica, e isso pode deixar qualquer iniciante confuso. As perguntas aparecem logo de cara: quais variáveis usar? Qual o melhor modelo? Como medir a acurácia das previsões? Aqui respondemos a cada uma delas para um caso concreto, com dados públicos do Banco Central e do IBGE.
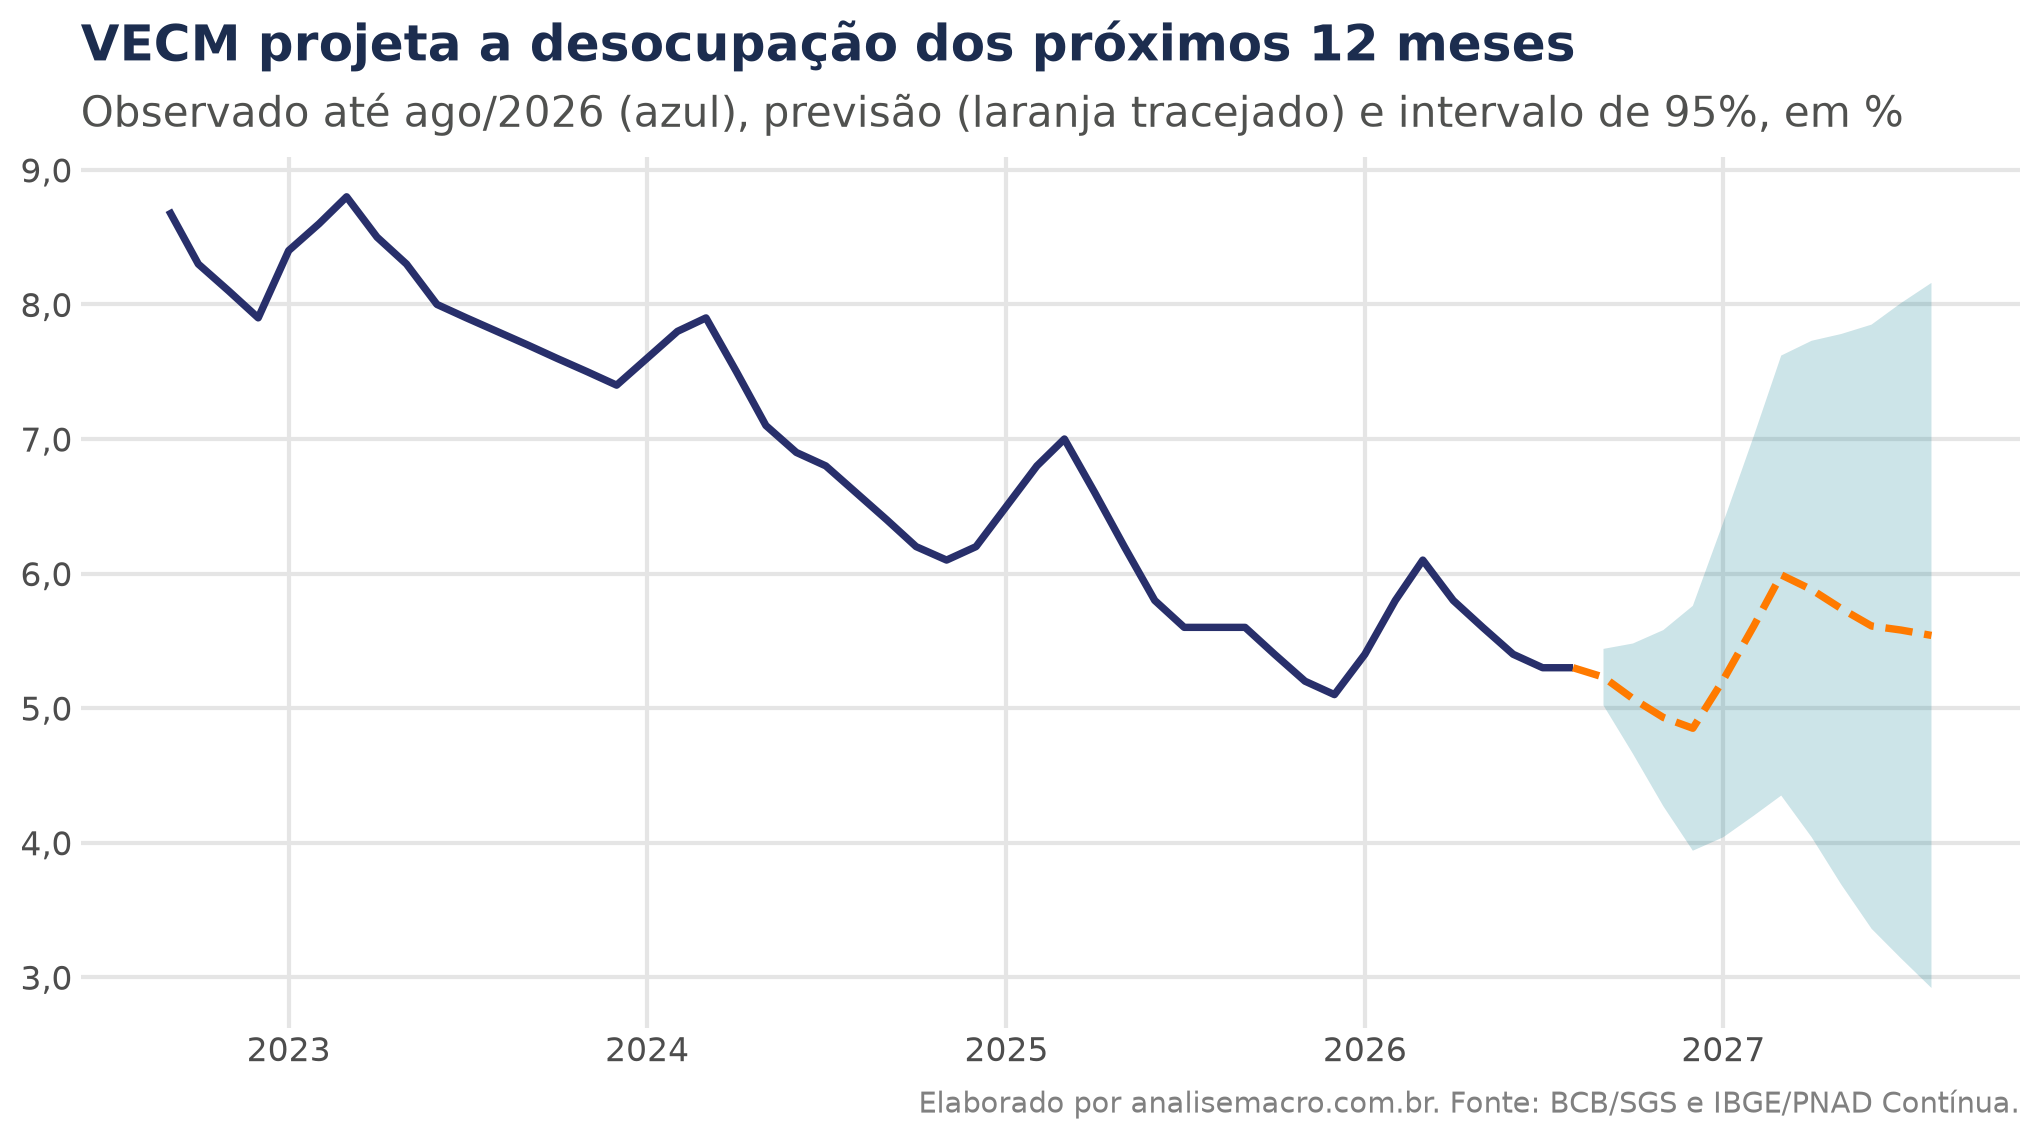
No nosso exemplo, com dados até agosto de 2026, o modelo projeta a desocupação em torno de 4,9% em dezembro, uma alta sazonal para perto de 6% em março de 2027 e cerca de 5,5% em agosto de 2027. A faixa sombreada se abre com o horizonte: em 12 meses, ela vai de 2,9% a 8,2%.
📩 Boletim AM
Receba análises e conteúdos sobre modelos estatísticos clássicos, econometria feita com hipóteses sérias e LLMs acessados em ambientes de trabalho reais, tudo aplicado à economia, ao mercado financeiro e à análise de dados.
O que é um VECM e por que usá-lo para prever o desemprego
A taxa de desocupação mede a parcela da força de trabalho que procura emprego e não encontra. Ela tende a cair quando a atividade cresce, a subir quando os juros apertam o crédito e a se mover junto com a renda do trabalho.
Um modelo que olha só para o passado da própria desocupação descarta essa informação. Por isso usamos um modelo multivariado, que projeta as quatro séries ao mesmo tempo.
Mas há um obstáculo. Desemprego, atividade, juros e renda são séries não estacionárias: elas não voltam para uma média fixa, e o choque de hoje fica incorporado no nível de amanhã. Quando a primeira diferença já é estacionária, dizemos que a série é integrada de ordem 1, ou I(1). Explicamos esse conceito em Estacionariedade de Séries Temporais, o que é isso?
Regredir uma série I(1) contra outra pode produzir relações estatisticamente fortes entre variáveis sem ligação nenhuma, a chamada regressão espúria. Trabalhar só com as variações resolve esse problema, mas joga fora a informação de longo prazo.
A cointegração é o caso em que séries I(1) vagam juntas. A analogia clássica é a do bêbado que passeia com o cachorro: os dois caminham sem rumo, mas a distância entre eles não cresce indefinidamente, porque um puxa o outro de volta. Detalhamos essa ideia em O andar do bêbado e seu cachorro: entendendo cointegração no Python.
O VECM junta as duas coisas. Ele explica a variação de cada série pelas variações passadas e pela distância entre o bêbado e o cachorro no mês anterior:
Aqui yt é o vetor com as quatro séries, Δ é a primeira diferença e β′yt−1 é o desvio em relação ao equilíbrio de longo prazo no mês anterior. As matrizes Γi guardam a dinâmica de curto prazo, Dt reúne constante, dummies sazonais e a dummy da pandemia, e εt é o erro.
O vetor β diz qual combinação das séries é estável no longo prazo. O vetor α diz com que velocidade cada série reage quando o sistema se afasta desse equilíbrio. Se a desocupação está alta demais para o nível de atividade, um α negativo na sua equação faz com que ela tenda a cair nos meses seguintes.
Quais dados usamos para prever a taxa de desocupação
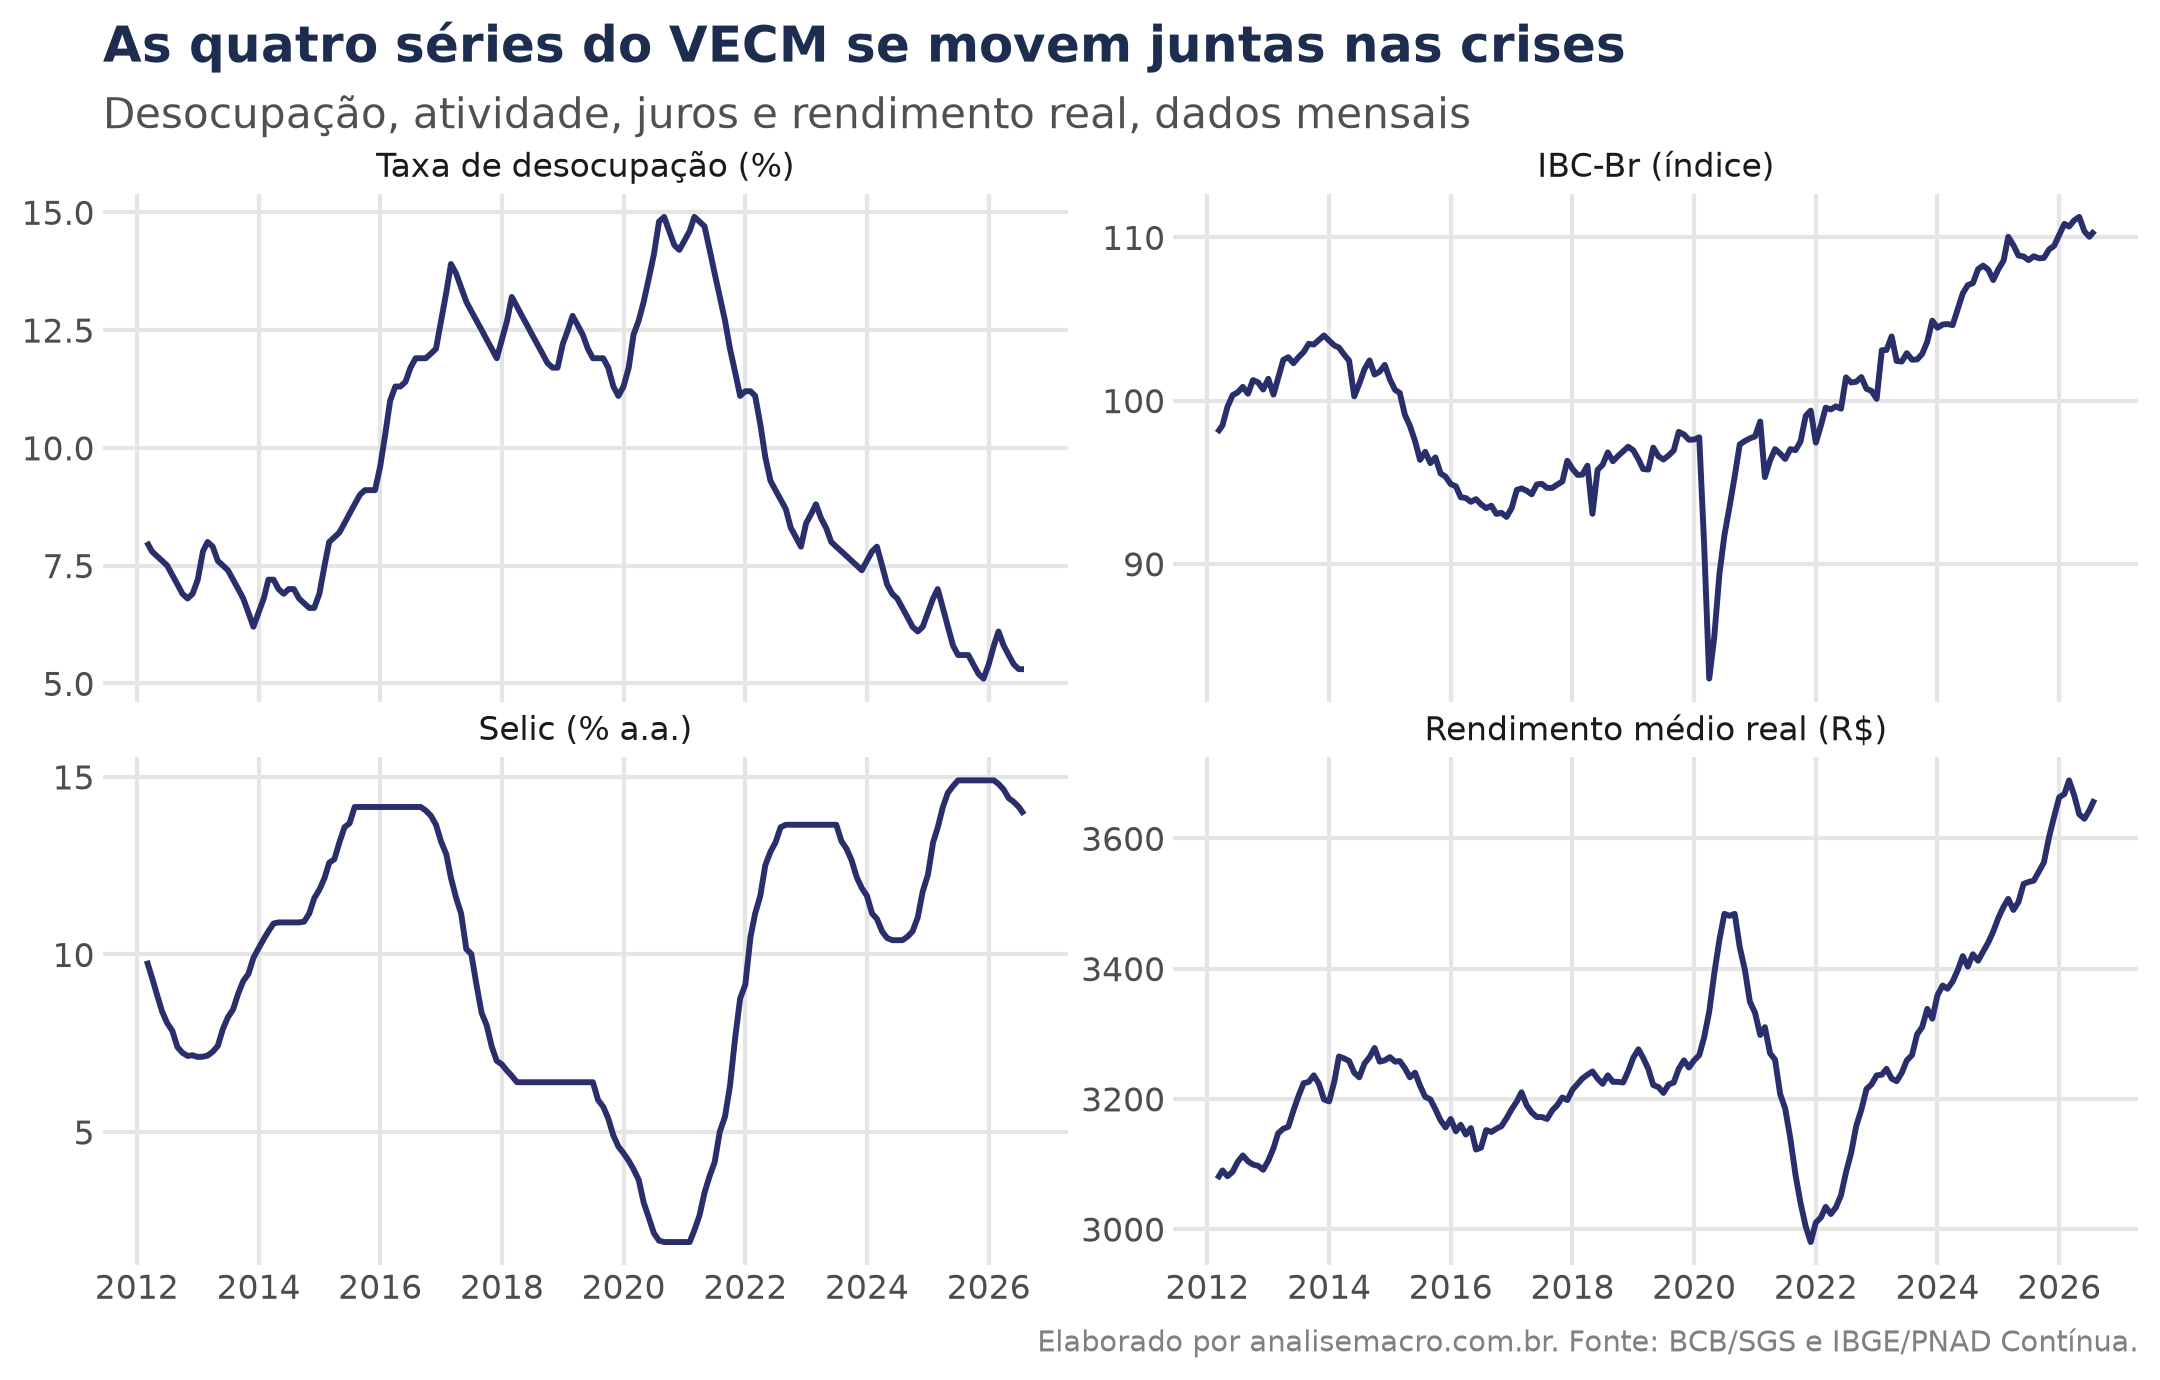
Usamos dados mensais de março de 2012 a agosto de 2026, 174 observações, todas coletadas no SGS, o Sistema Gerenciador de Séries Temporais do Banco Central, com a biblioteca python-bcb. Cada série entra por um motivo econômico:
- Taxa de desocupação (PNAD Contínua/IBGE): a variável que queremos prever. É uma média de trimestres móveis, por isso é suave e sazonal, com alta no início do ano.
- IBC-Br com ajuste sazonal (BCB): mede a atividade econômica mensal, uma prévia do PIB. Mais atividade significa mais vagas.
- Selic acumulada no mês, anualizada (BCB): juros mais altos encarecem crédito e investimento, e o efeito chega ao emprego com defasagem.
- Rendimento médio real (PNAD Contínua/IBGE): quanto o trabalhador ganha, já descontada a inflação.
Desocupação e atividade formam a relação conhecida como Lei de Okun, que estimamos em Lei de Okun: qual a relação entre crescimento econômico e desemprego? E o uso do IBC-Br como termômetro da atividade aparece em O IBC-Br é um bom preditor do PIB?
No gráfico acima, nenhuma série oscila em torno de uma média fixa. A desocupação sobe forte entre 2015 e 2017, sobe de novo na pandemia e cai de forma contínua depois de 2021, enquanto o IBC-Br faz o movimento espelhado.
A pandemia aparece como um choque abrupto em todas as séries ao mesmo tempo. Para que ele não domine a estimação, incluímos uma dummy de impulso, uma variável que vale 1 entre abril e julho de 2020 e 0 nos demais meses.
As etapas da modelagem
Cada etapa da previsão tem um teste que a justifica. O código faz todas em sequência, e basta rodá-lo de novo a cada divulgação da PNAD para atualizar tudo.
Teste de raiz unitária
O VECM pressupõe séries I(1). O teste ADF (Dickey-Fuller aumentado) responde se a série tende a voltar para uma média, com a hipótese nula de raiz unitária. O teste KPSS inverte a pergunta: a nula é a estacionariedade. Usar os dois reduz o risco de apoiar a conclusão num único teste, que costuma ter pouco poder em amostras curtas.
No nosso exemplo, nenhuma das quatro séries rejeita a raiz unitária no nível pelo ADF. Na diferença, IBC-Br, Selic e rendimento são claramente estacionários. A desocupação fica perto do limite (p-valor de 0,077), porque a média de trimestres móveis deixa a variação mensal muito persistente; com o gráfico e o KPSS, tratamos as quatro como I(1).
Escolha das defasagens por critério de informação
Os critérios de informação medem o ajuste do modelo e cobram uma penalidade por parâmetro: o AIC cobra menos, o BIC cobra mais e o HQIC fica no meio. No nosso exemplo, AIC, HQIC e FPE escolhem 3 defasagens e o BIC escolhe 1. Adotamos o AIC, que tende a errar menos fora da amostra; com uma defasagem só, sobra autocorrelação nos resíduos da desocupação.
Teste de cointegração de Johansen e a escolha do posto
O teste de Johansen estima quantas relações de longo prazo independentes existem entre as séries, o posto de cointegração. Com posto zero não há relação de longo prazo, e o modelo certo seria um VAR nas diferenças; com quatro séries, o posto pode ir até 3.
O resultado depende das defasagens incluídas, por isso rodamos o teste de 1 a 6 defasagens. No nosso exemplo, o traço e o máximo autovalor indicam posto 1 em cinco das seis especificações e posto 2 só com 3 defasagens. Adotamos posto 1, o mais estável, que também é o que a teoria sugere: uma relação de longo prazo entre desemprego, atividade e renda.
O vetor de cointegração estimado
| Série | β (longo prazo) | α (velocidade de ajuste) |
|---|---|---|
| Taxa de desocupação | 1,000 | −0,065 |
| IBC-Br (log × 100) | 0,839 | −0,371 |
| Selic | 0,064 | −0,011 |
| Rendimento real (log × 100) | −0,406 | 0,123 |
VECM com 3 defasagens, posto 1, dummies sazonais e dummy da pandemia. Dados até agosto de 2026.
O vetor β vem normalizado na desocupação. Para ler os coeficientes como efeito sobre ela, invertemos o sinal: no nosso exemplo, cada 1% a mais de atividade está associado, no longo prazo, a uma desocupação 0,84 ponto percentual menor.
O α da desocupação, de −0,065, diz que ela corrige cerca de 6,5% do desvio em relação ao equilíbrio a cada mês. Ou seja, quando o desemprego está acima do que a atividade e a renda indicam, ele tende a cair nos meses seguintes, de forma gradual.
Diagnóstico dos resíduos
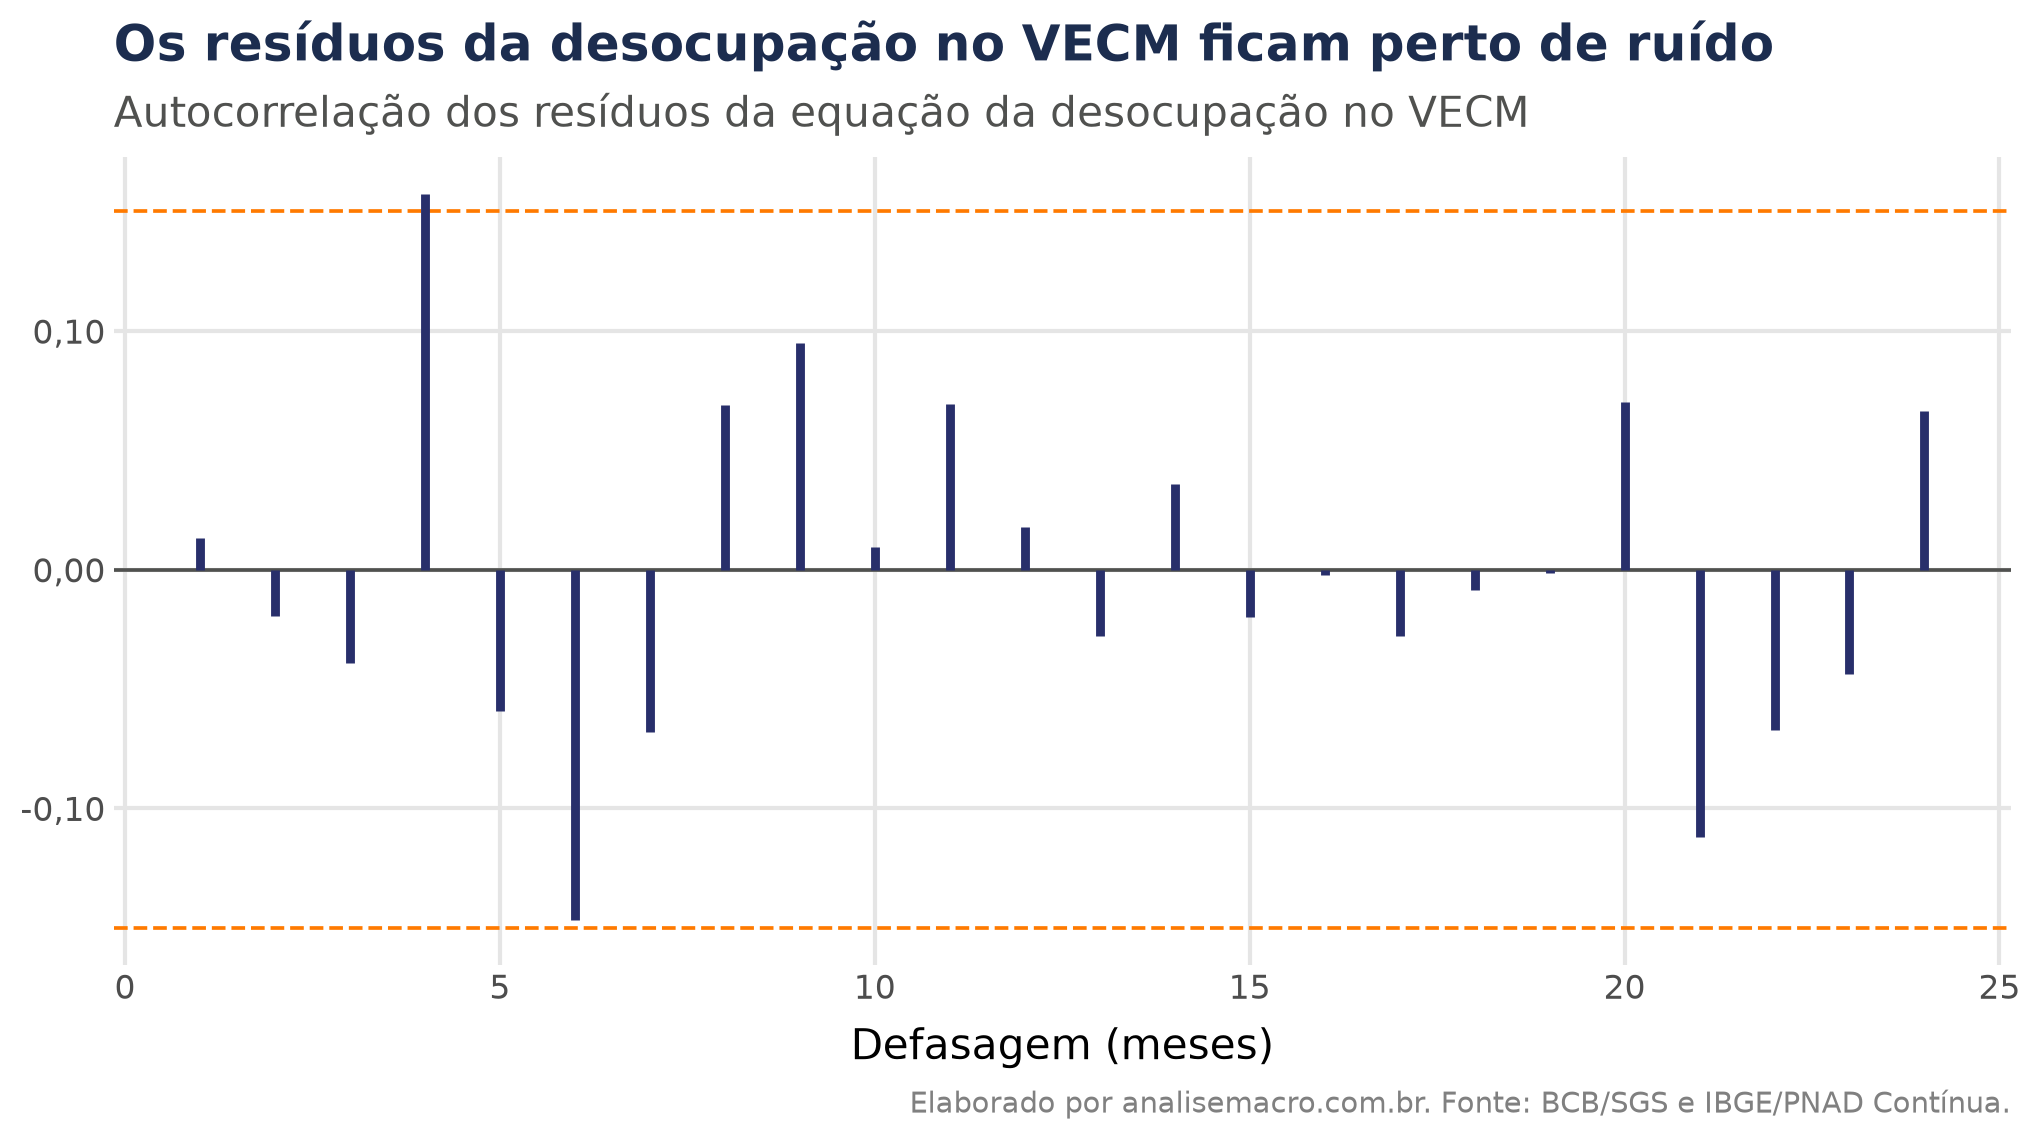
Um modelo bem especificado deixa nos resíduos apenas ruído. Na figura acima, só as defasagens 4 e 6 encostam na banda de 95%, e o teste de Ljung-Box da equação da desocupação, que testa a autocorrelação conjunta até 12 meses, dá p-valor de 0,33, compatível com ruído.
Dois testes pedem cautela. O Portmanteau conjunto, que soma a autocorrelação das quatro equações, rejeita a ausência de autocorrelação, puxado sobretudo pela Selic. E a normalidade é rejeitada pelos meses de choque. Isso não invalida a previsão pontual; o que fica afetado é a precisão dos intervalos, que devem ser lidos como aproximação.
Avaliação fora da amostra contra o passeio aleatório
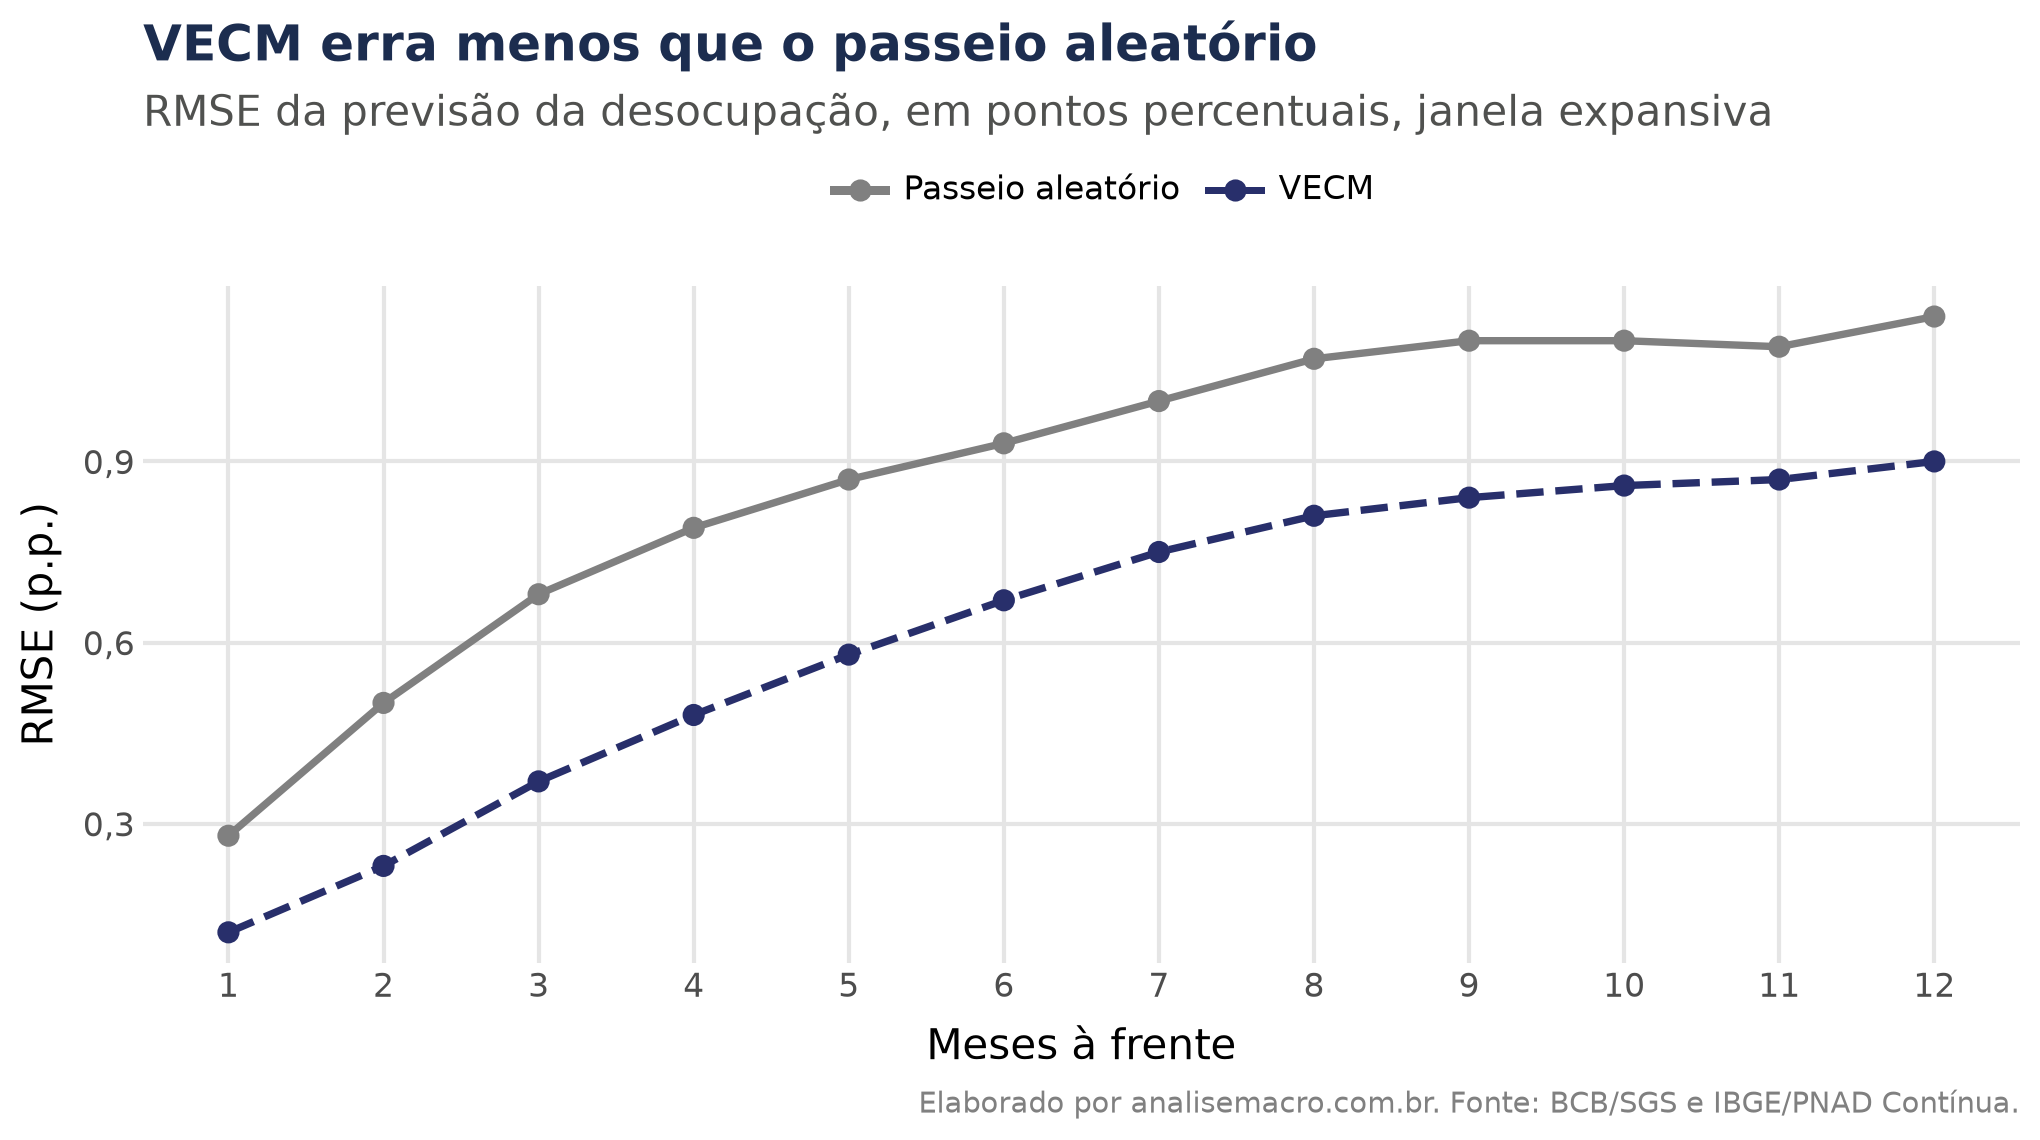
Um bom ajuste dentro da amostra não garante uma boa previsão. Para medir a acurácia, usamos uma janela expansiva: estimamos o VECM com os dados até um mês, projetamos os 12 meses seguintes, guardamos o erro e repetimos acrescentando um mês, até o fim dos dados.
O erro precisa de uma régua. O passeio aleatório, que repete o último valor observado, é o benchmark mais simples: se o VECM não errar menos do que ele, a especificação não se paga. A métrica é o RMSE, a raiz do erro quadrático médio, em pontos percentuais.
| Meses à frente | RMSE VECM (p.p.) | RMSE passeio aleatório (p.p.) | Razão |
|---|---|---|---|
| 1 | 0,12 | 0,28 | 0,43 |
| 3 | 0,37 | 0,68 | 0,54 |
| 6 | 0,67 | 0,93 | 0,72 |
| 12 | 0,90 | 1,14 | 0,79 |
Razão abaixo de 1: o VECM erra menos que o benchmark. Dados até agosto de 2026.
No nosso exemplo, o VECM erra menos em todos os horizontes. Em um mês, o erro cai para menos da metade, porque as dummies sazonais conhecem a alta do início do ano que o passeio aleatório ignora. Em 12 meses, a vantagem é de cerca de 20%, e vem do termo de correção de erros, que puxa a projeção para a relação de longo prazo.
Duas ressalvas delimitam o resultado. As defasagens e o posto foram escolhidos com a amostra completa, o que dá ao modelo uma pequena vantagem. E o período avaliado cobre uma fase longa de queda do desemprego, em que um modelo com relação de longo prazo tende a se sair bem.
A previsão com intervalo de 95%
Com o modelo avaliado, projetamos os 12 meses seguintes com a amostra completa, como mostra o gráfico do início do post. O intervalo de previsão de 95% indica a faixa em que a desocupação deve ficar com essa probabilidade, se o modelo estiver correto. A projeção carrega o padrão sazonal e a tendência que a relação com atividade e renda indica.
O intervalo é tão importante quanto o ponto central. Uma projeção sem faixa de incerteza dá a impressão de uma precisão que nenhum modelo tem, e é a faixa que permite comparar a projeção com um cenário alternativo ou com as expectativas de mercado.
Aplicações práticas da previsão do desemprego
- Cenários macroeconômicos: a desocupação entra nas projeções de consumo, de massa salarial e de inflação de serviços.
- Política monetária: um mercado de trabalho apertado pressiona salários e preços; projetar a desocupação ajuda a antecipar a leitura do Copom.
- Crédito e inadimplência: bancos usam a trajetória do desemprego para calibrar provisões e testes de estresse.
- Planejamento fiscal: seguro-desemprego e arrecadação sobre a folha dependem do nível de emprego.
- Comparação com o consenso: o modelo dá uma referência quantitativa para confrontar com as projeções de mercado.
Considerações finais
Prever uma série econômica exige mais do que estimar um modelo. A sequência que seguimos se repete em qualquer previsão com VECM: testar a ordem de integração, escolher as defasagens por critério de informação, justificar o posto de cointegração, diagnosticar os resíduos e medir o erro fora da amostra contra um benchmark simples antes de confiar na projeção.
Com o Python, essa sequência vira um código que coleta os dados direto do Banco Central e pode ser rodado de novo a cada divulgação, sem refazer nada à mão. O mesmo caminho serve a várias frentes:
- Economistas e analistas macro: montar e atualizar cenários de mercado de trabalho com modelos que respeitam o longo prazo.
- Profissionais de bancos e gestoras: alimentar modelos de risco de crédito e de estratégia com projeções próprias.
- Servidores e consultores do setor público: projetar despesas e receitas sensíveis ao emprego.
- Estudantes e pesquisadores: aplicar raiz unitária, cointegração e avaliação de previsão em dados brasileiros reais.
Aprenda a construir previsões macroeconômicas no Python
Na Formação em Análise Macroeconômica, você aprende a coletar, modelar e projetar indicadores como desemprego, inflação, PIB e juros no Python. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
- JOHANSEN, S. Statistical analysis of cointegration vectors. Journal of Economic Dynamics and Control, v. 12, n. 2-3, p. 231-254, 1988.
- LÜTKEPOHL, H. New Introduction to Multiple Time Series Analysis. Berlin: Springer, 2005.
- SEABOLD, S.; PERKTOLD, J. Vector Error Correction Models (VECM). Documentação do statsmodels.
Leia também:
📩 Modelo, dado e ressalva — todo dia
Este exercício é um recorte. No Boletim AM eu mostro econometria aplicada o ano inteiro, e como a IA entra nesse trabalho sem substituir o julgamento de quem entende o modelo.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.