Neste post iremos revelar algumas coisas que nunca te contaram sobre análise exploratória e como usá-la para ter uma visão geral aplicada a dados macroeconômicos.
Antes de tudo, precisamos entender onde a análise exploratória de dados, do inglês exploratory data analysis (EDA), está inserida no contexto de uma análise descritiva ou de modelos que usem dados macroeconômicos. Para tais contextos, é fundamental conhecer os dados antes de partir para qualquer exercício empírico, ou seja, queremos uma fotografia que mostre um panorama geral sobre os dados. Esse primeiro passo é extremamente útil para identificar possíveis "pontos cegos" que gerariam problemas no seu modelo ou que poderiam ser interpretados de forma errônea em sua análise conjuntural, por exemplo.
Em outras palavras, a famosa expressão garbage in, garbage out (lixo entra, lixo sai) resume perfeitamente a importância da análise exploratória. Você precisa saber se os dados a serem utilizados possuem a qualidade (características) necessária para fazer uma análise ou se estão simplesmente cheios de sujeiras (outliers, valores ausentes, quebras, etc.). É neste momento que você aprenderá mais sobre os dados, identificando padrões e comportamentos, assim como saberá o que precisará fazer (tratamentos) para torná-los úteis. O tratamento de valores extremos e valores ausentes é justamente o passo seguinte a essa inspeção.
📩 Onde a estatística vira decisão
O método que você acabou de ver não envelheceu: o que mudou foi o tempo que ele leva. No Boletim AM eu mostro, todo dia, estatística, econometria e IA aplicadas à economia, ao mercado financeiro e à análise de dados. Com dado real e sem enrolação.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.
Mas de que tipo de dados estamos falando?
Em geral, os dados macroeconômicos mais usados possuem uma estrutura de série temporal, mas outras estruturas, como dados em painel, microdados, etc., também possuem aplicações em macroeconomia. Focando em séries temporais, podemos destacar algumas coisas nas quais você deve ficar de olho ao fazer uma análise exploratória de dados:
- Sazonalidade;
- Tendência;
- Autocorrelação;
- Estacionariedade.
Algumas estatísticas e gráficos que irão te ajudar a inspecionar esses padrões e comportamentos:
- Média, mediana, desvio padrão e IQR;
- Gráfico de histograma;
- Gráfico de linha;
- Gráfico de sazonalidade;
- Correlogramas ACF e PACF;
- Testes de estacionariedade ADF, KPSS e PP.
Parece ser bastante coisa com que se preocupar em uma análise exploratória, e realmente é, podendo ainda ampliarmos este escopo, mas, se usarmos as ferramentas adequadas, podemos colocar tudo isso em prática de maneira rápida e eficiente, direcionando o foco para a análise propriamente dita. Na linguagem R, existem diversos pacotes modernos com utilidades para análise exploratória de dados, e exploraremos a seguir alguns destes pacotes.
Para reproduzir o exercício a seguir, você precisará dos seguintes pacotes de R: ggplot2, dplyr, magrittr, tsibble, skimr, feasts e forecast. Eles fazem parte do ecossistema {tidyverts}, que organiza séries temporais no R em formato tidy.
Os dados: indicadores mensais da economia norte-americana
Para exemplificar uma análise exploratória de dados macroeconômicos, usaremos um conjunto de dados que traz informações sobre indicadores econômicos mensais da economia norte-americana. A fonte dos dados é o FRED e eles já estão salvos em um dataset no R.
São 574 observações mensais, de julho de 1967 a abril de 2015, com cinco variáveis: consumo pessoal, população, taxa de poupança, duração mediana do desemprego em semanas e número de desempregados. A variável que exploraremos é a duração do desemprego, que responde a uma pergunta concreta: quantas semanas uma pessoa tipicamente passa desempregada antes de voltar a trabalhar.
O primeiro tratamento é converter a tabela para uma tsibble, que é a tabela com um índice de tempo declarado. É essa declaração que permite ao R reconhecer a frequência mensal da série e habilitar as funções de série temporal usadas adiante.
Estatísticas descritivas
As medidas de estatística descritiva, como média, desvio padrão, percentis, etc., servem para obter uma visão geral dos dados. É um bom primeiro passo se você não tem expertise sobre a variável com a qual irá desenvolver uma análise. O pacote {skimr} faz esse trabalho de calcular estas estatísticas de uma maneira simples e bem apresentada, bastando apontar o objeto com os dados.
| Variável | Média | Desvio padrão | Mínimo | Mediana | Máximo |
|---|---|---|---|---|---|
| Consumo pessoal (US$ bi) | 4.820,1 | 3.556,8 | 506,7 | 3.936,9 | 12.193,8 |
| População (mil) | 257.159,7 | 36.682,4 | 198.712,0 | 253.060,0 | 320.402,3 |
| Taxa de poupança (%) | 8,57 | 2,96 | 2,2 | 8,4 | 17,3 |
| Duração do desemprego (semanas) | 8,61 | 4,11 | 4,0 | 7,5 | 25,2 |
| Desempregados (mil) | 7.771,3 | 2.642,0 | 2.685,0 | 7.494,0 | 15.352,0 |
Note que, além das estatísticas descritivas, também são apresentadas informações como nº e taxa de valores ausentes, gráfico de histograma, valores mínimos e máximos, etc., a depender do tipo de variável sobre a qual serão computados tais cálculos, que são informações bastante úteis para identificar possíveis problemas nos dados. Na linha da duração do desemprego, a média de 8,61 semanas supera a mediana de 7,5, o primeiro sinal de que a distribuição puxa para a direita. Se quiser se aprofundar nessas medidas, veja o post sobre estatísticas robustas: mediana, IQR e MAD.
Histograma: como os dados se distribuem
Talvez apenas com estatísticas descritivas não seja possível ter uma visão clara sobre o comportamento da variável de interesse, ou seja, sobre como os dados estão distribuídos. Para resolver isso, é conveniente gerar um gráfico de histograma, que pode ser criado com o {ggplot2}. Se quiser entender a lógica por trás dessa construção, temos um guia sobre visualização de dados com ggplot2.
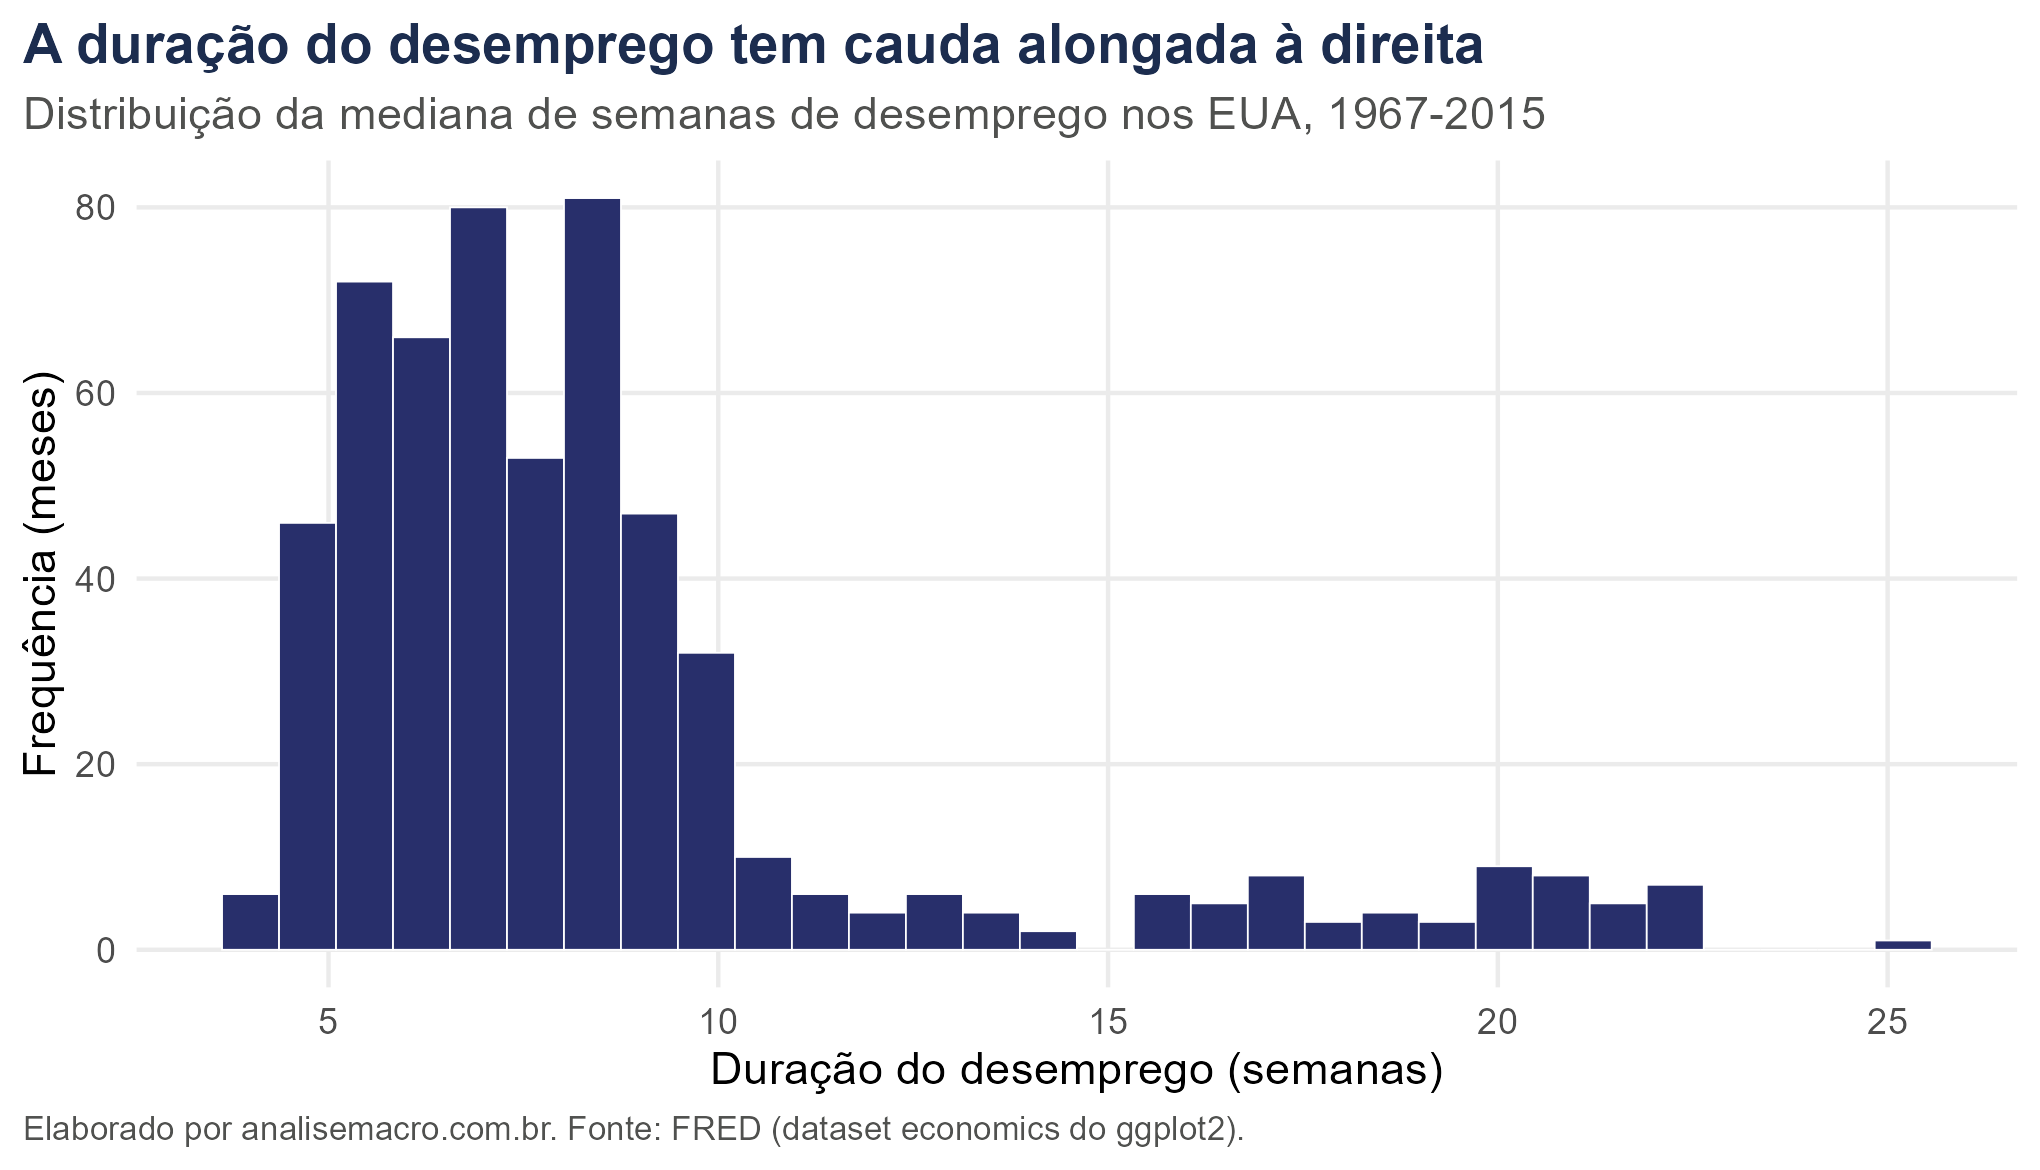
A visualização gráfica dos dados é muito importante, pois nos permite identificar rapidamente algumas coisas interessantes nos dados, como neste caso do histograma. A distribuição dos dados apresenta uma cauda alongada à direita, ou seja, possivelmente há algumas poucas observações dessa variável (duração do desemprego) com valores mais "extremos". A questão que surge é: em qual período do tempo aconteceram estes valores? Ou seja, qual é a tendência da variável? O gráfico de histograma na análise exploratória tem um post dedicado, com versões em R e Python.
Tendência: para onde a série caminha
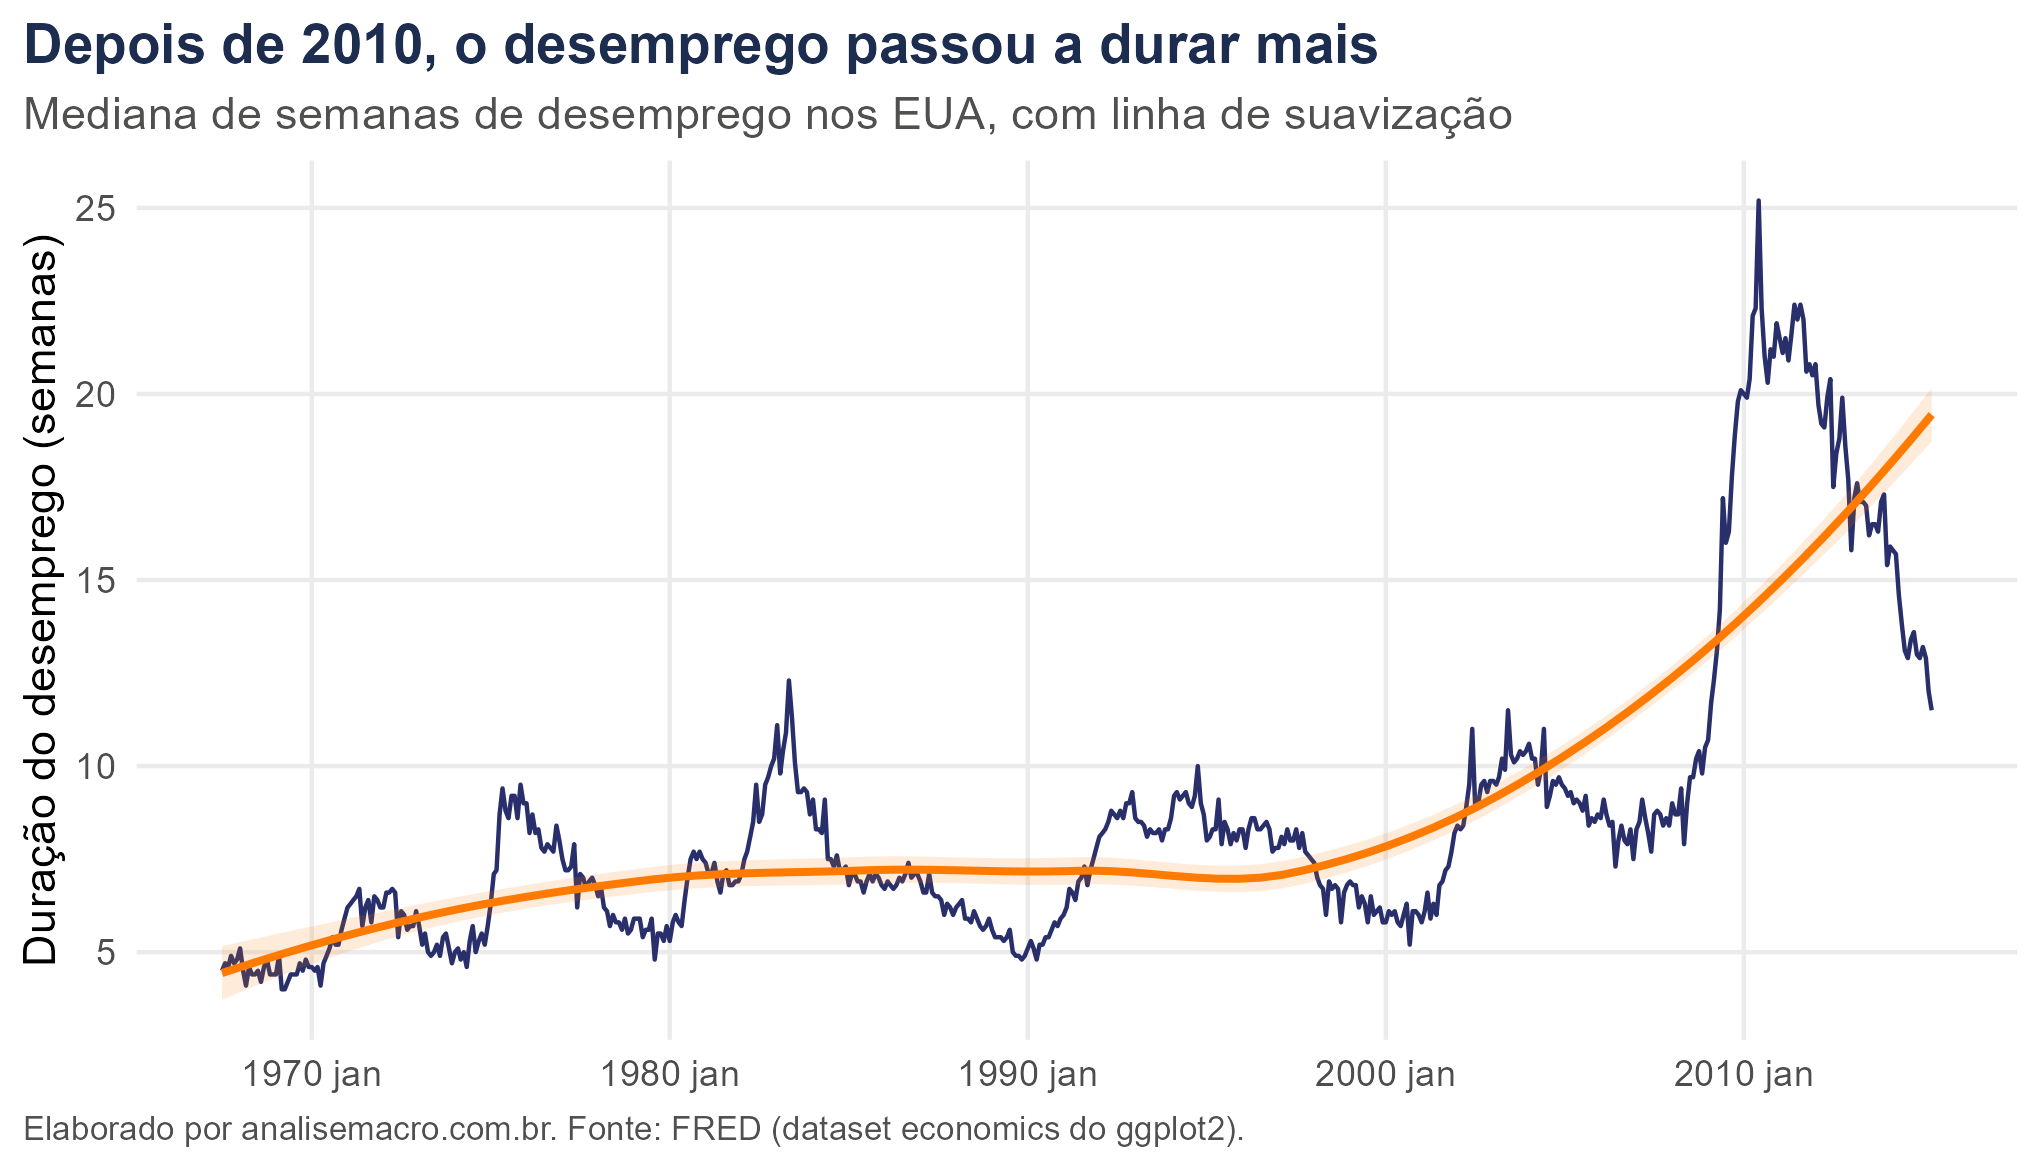
O jeito mais direto de identificar a tendência de uma variável é através de um gráfico de linha. Abaixo geramos um gráfico de linha e adicionamos uma linha de suavização, que pode facilitar o rápido entendimento em alguns casos. É o gráfico que abre este post.
Dessa forma, conseguimos identificar que, no período mais recente, ou seja, nas últimas observações a partir de 2010, há uma tendência de aumento no tempo de duração do desemprego, superando o histórico observado nas décadas anteriores. A série sai de um patamar em torno de 7 semanas, onde ficou por quatro décadas, e chega ao pico de 25,2 semanas em 2010. Note que, com apenas dois gráficos e algumas estatísticas descritivas, já conseguimos insumos interessantes para uma análise mais aprofundada.
Sazonalidade: o padrão que se repete dentro do ano
A olho nu, no gráfico anterior não parece haver comportamento que indique sazonalidade, mas como poderíamos identificar tal comportamento em uma variável? Novamente, a análise gráfica pode auxiliar nessa tarefa. O gráfico de sazonalidade gerado abaixo basicamente é um gráfico de linha, com a exceção de que o eixo X mostra os dados da sazonalidade observada da variável. No caso de dados em frequência mensal, o eixo X será os meses.
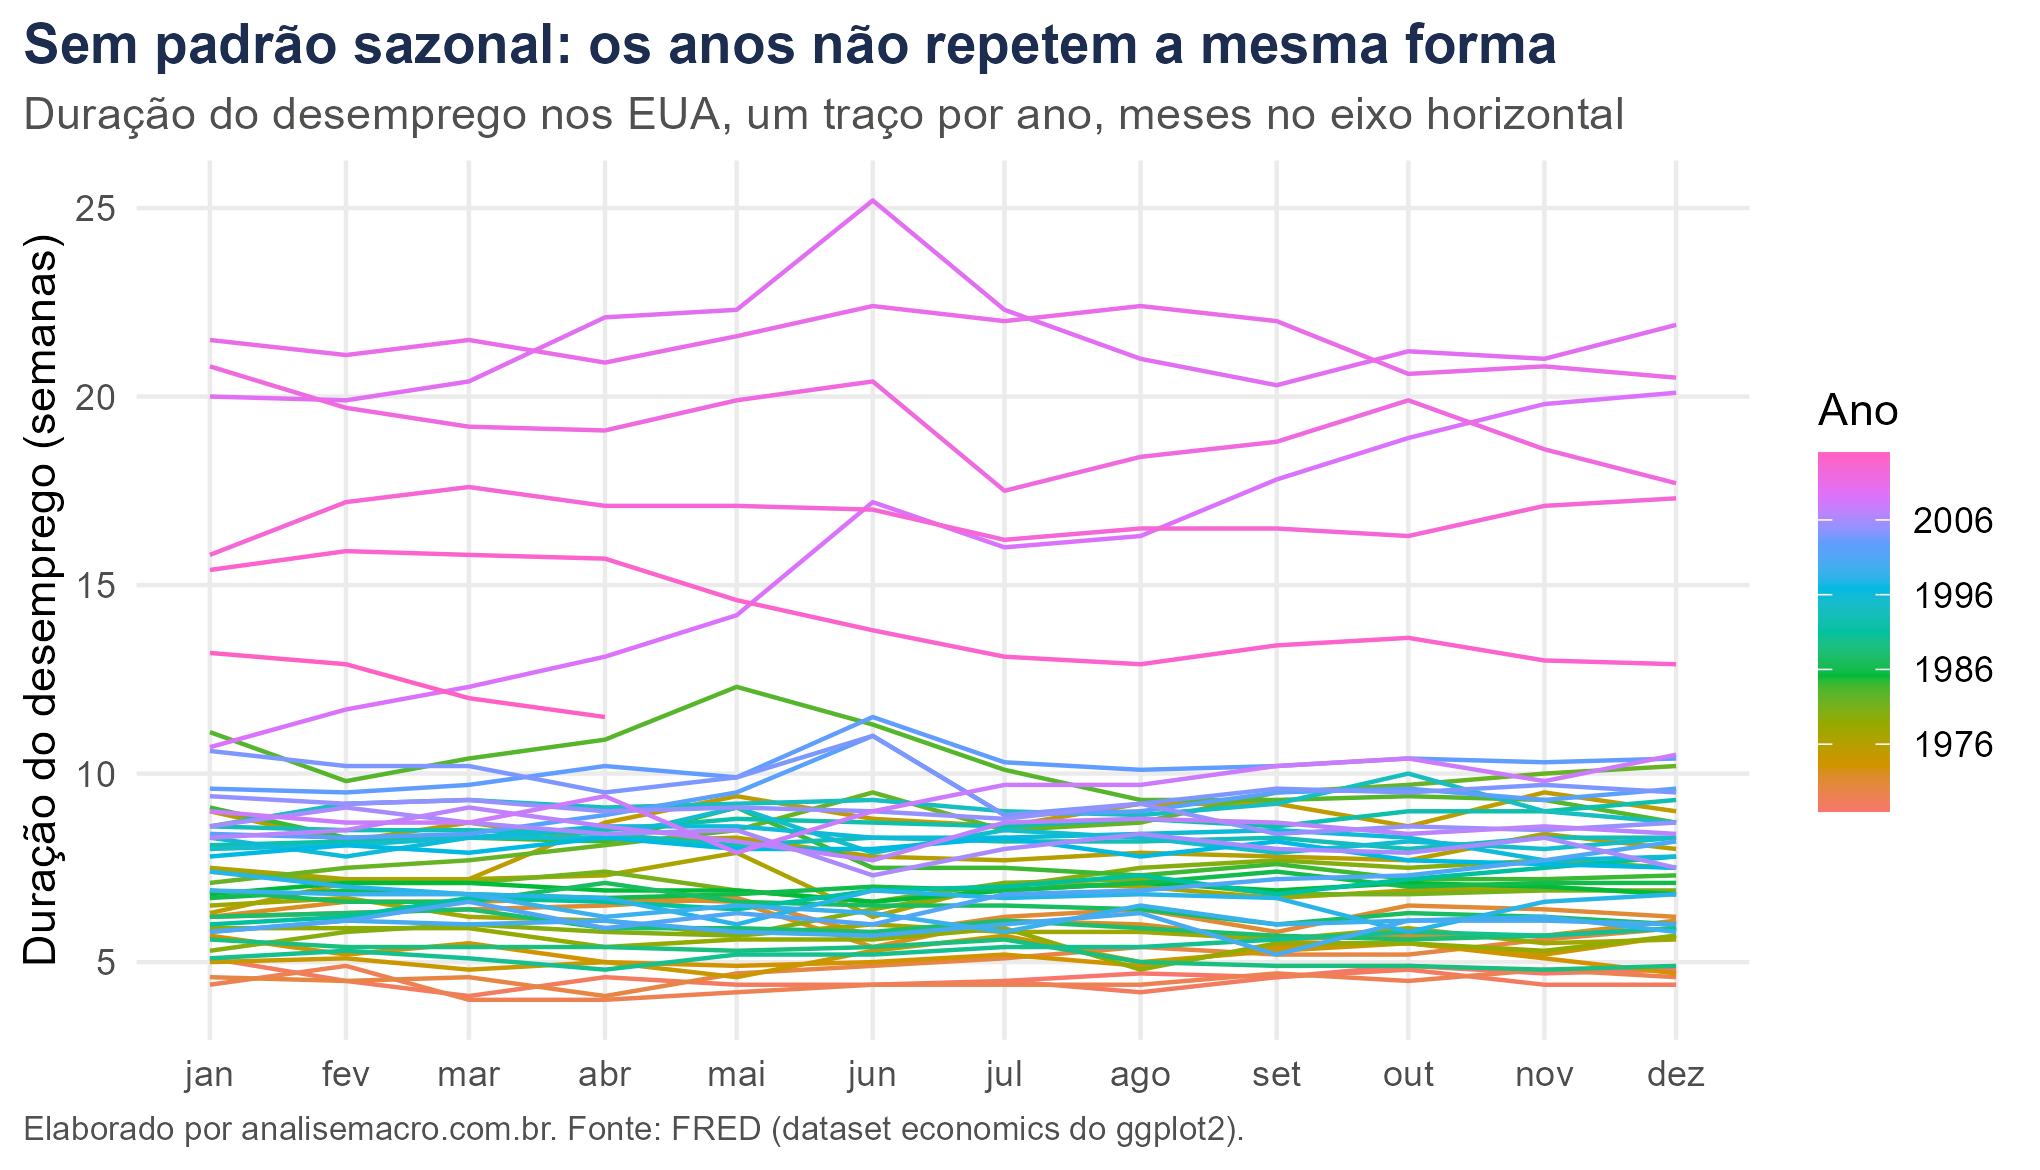
O gráfico facilita identificar mais claramente padrões sazonais, que para essa variável não há, além de ser mais fácil de visualizar em quais anos o padrão muda. Os traços de 2009 a 2013 ficam isolados no alto, o que mostra a mudança de patamar. Quando a sazonalidade existe, o passo seguinte costuma ser separá-la da tendência: tratamos disso em como extrair componentes de tendência e sazonalidade de uma série temporal.
Estacionariedade: a série volta para a média?
Outro ponto importante, principalmente em contextos de modelagem econométrica, é a estacionariedade da série, ou seja, a média e a variância são constantes ao longo do tempo? Quando em uma variável estes pressupostos não são verdadeiros, dizemos que a série possui raiz unitária (é não estacionária), de modo que os choques que a variável sofre geram um efeito permanente. Parece ter sido esse o caso da variável em questão, a duração do desemprego. Vimos que as flutuações da variável se alteraram consideravelmente, e isso tem fortes implicações relacionadas a teorias econômicas que tratam de ciclos.
Mas, fugindo da teoria, como verificamos de maneira prática se a variável é estacionária? O pacote {forecast} possui uma excelente função que permite aplicar testes, como o ADF, KPSS e PP, que já retornam o número de diferenças necessárias para a série ser estacionária. No nosso exemplo, o retorno é 1.
Se o valor retornado for maior do que zero, significa que a série é não estacionária e precisa ser diferenciada na ordem do valor retornado para ser estacionária. O tema tem um post próprio, com os testes explicados um a um: estacionariedade de séries temporais.
Autocorrelação: a memória da série
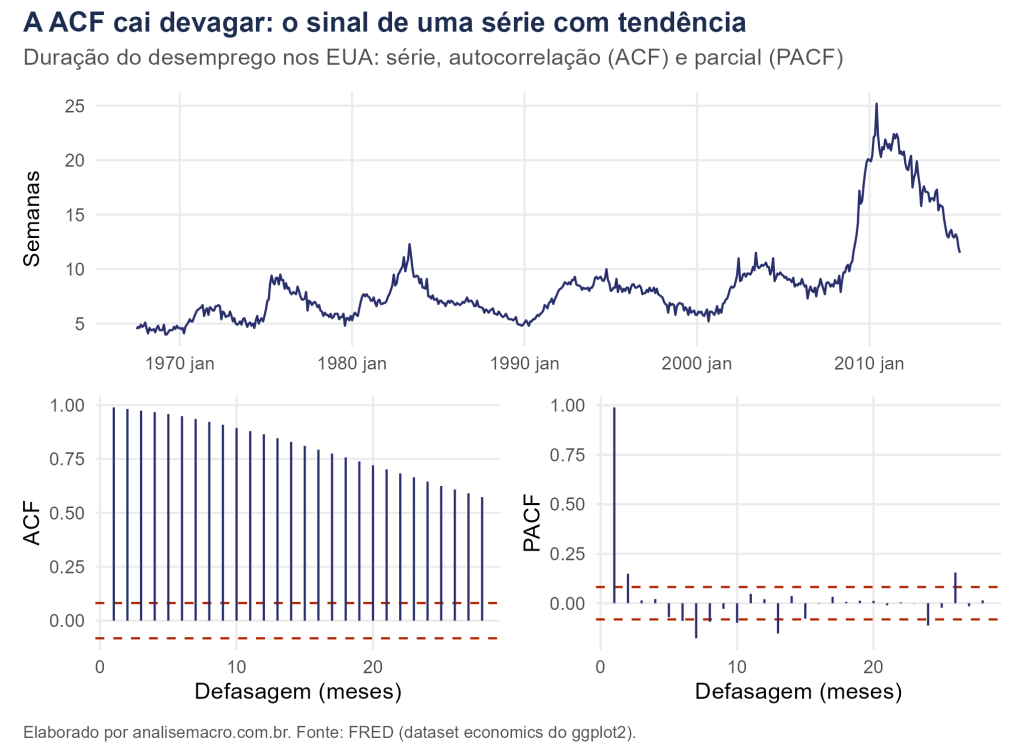
Por fim, outra questão importante em séries temporais é a identificação de possíveis correlações (a relação linear) entre os valores defasados da série. Os correlogramas ACF e PACF podem ajudar neste ponto. Como a série não possui sazonalidade, mas possui uma certa tendência, as autocorrelações iniciais tendem a ser grandes e positivas, pois as observações próximas no tempo também estão próximas em valor. Assim, a função de autocorrelação (ACF) de uma série temporal com tendência tende a ter valores positivos que diminuem lentamente à medida que as defasagens aumentam.
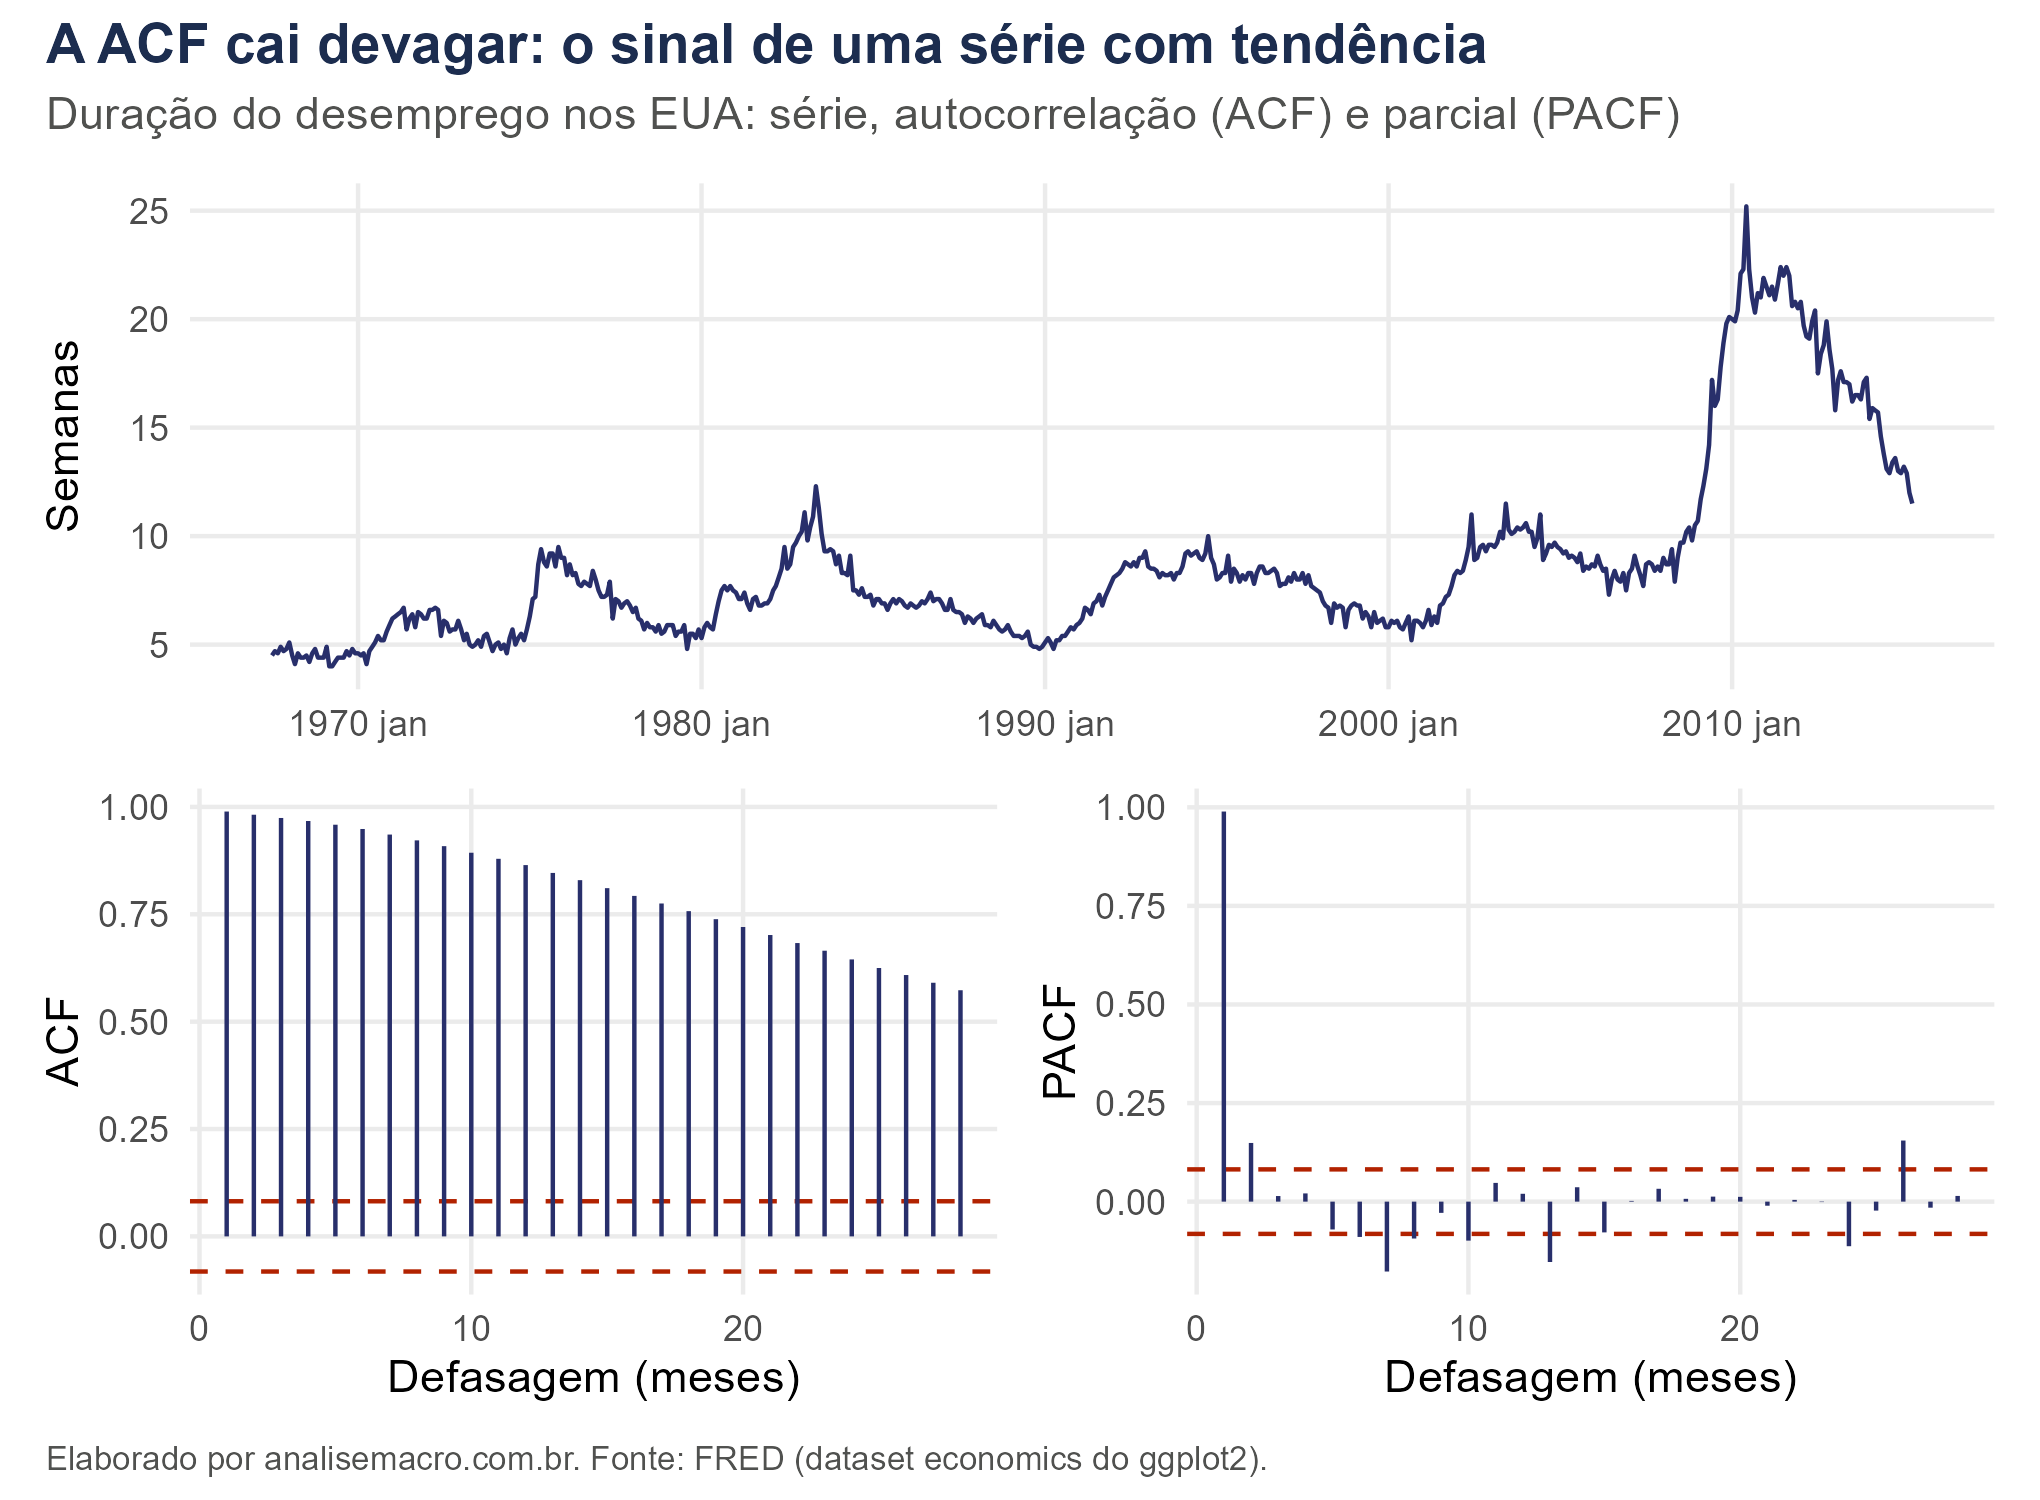
Se fôssemos, por exemplo, implementar uma modelagem ARIMA nessa série, seria apropriado gerar os correlogramas na série estacionária, ou seja, na variável duração do desemprego em primeira diferença. Para construir essa defasagem, veja como criar defasagens de uma variável no R, e para o passo seguinte, os modelos ARIMA e a metodologia Box-Jenkins.
Onde a análise exploratória entra no dia a dia
Os seis passos acima não são um exercício de sala de aula. Eles mudam decisões concretas em quatro situações comuns.
Na modelagem e previsão, a estacionariedade define se o modelo trabalha com o nível da série ou com a primeira diferença. Estimar em nível uma série com raiz unitária produz regressão espúria, aquela em que duas séries sem relação real aparecem fortemente associadas só porque ambas crescem ao longo do tempo.
Na análise de conjuntura, o gráfico de sazonalidade indica se faz sentido comparar um mês com o mesmo mês do ano anterior ou com o mês imediatamente anterior. Sem essa checagem, uma queda sazonal normal vira notícia de reversão de tendência.
No tratamento da base, o histograma e as estatísticas descritivas revelam valores extremos e faltantes antes que eles contaminem a estimação. Descobrir isso depois do modelo pronto custa refazer o trabalho.
Na escolha da especificação, os correlogramas ACF e PACF sugerem quantas defasagens entram no modelo. A PACF concentrada na primeira defasagem, como no nosso exemplo, aponta para uma estrutura autorregressiva de ordem baixa.
Considerações finais
Este exercício buscou navegar pelos principais padrões e comportamentos de dados macroeconômicos, usando ferramentas do R para identificá-los. O que ele mostra, no fundo, é que conhecer os dados é uma etapa com método próprio, e não uma formalidade antes da modelagem.
Aprender a fazer isso em R muda o dia a dia de quem trabalha com dados econômicos, cada um à sua maneira:
- Analista econômico: monta o retrato de qualquer série nova em minutos, antes de escrever o relatório sobre ela.
- Economista de pesquisa: identifica quebras e raiz unitária antes de especificar o modelo, evitando resultado espúrio.
- Gestor e analista de investimentos: verifica se o indicador que embasa a tese tem tendência, sazonalidade ou apenas ruído.
- Profissional de risco: reconhece a cauda pesada de uma distribuição antes de supor normalidade nos cálculos.
- Servidor público e técnico de órgão setorial: avalia a qualidade da base antes de publicar número oficial ou projeção.
Você pode se aprofundar nos assuntos relacionados por meio destes posts do blog da Análise Macro:
- 5 armadilhas dos dados (macro)econômicos no Brasil
- Como extrair componentes de tendência e sazonalidade de uma série temporal
- {tidyverts}: séries temporais no R
- Gerando previsões desagregadas de séries temporais
- Como criar defasagens de uma variável no R
- Como reverter a primeira diferença de uma série temporal?
- Visualizando dados com ggplot2
- Como importar dados do Banco Central, IPEADATA e Sidra no R?
Da análise exploratória ao modelo
Conhecer os dados é o primeiro passo; o seguinte é modelar. O AM Black é a assinatura anual que dá acesso a todos os cursos da Análise Macro, em R e em Python, da estatística descritiva à modelagem de séries temporais.