
Introdução
O PIB trimestral do Brasil sobe e desce dentro de cada ano, e só a série com ajuste sazonal mostra a tendência da economia. As duas versões estão no SIDRA, o Sistema IBGE de Recuperação Automática, e podemos coletá-las direto no Python com a biblioteca sidrapy.
Neste exercício, coletamos dados do SIDRA com Python para montar o PIB em duas versões, a série original e a série com ajuste sazonal. Depois, com as mesmas ferramentas, calculamos quanto a agropecuária, a indústria e os serviços contribuíram para o crescimento do PIB.
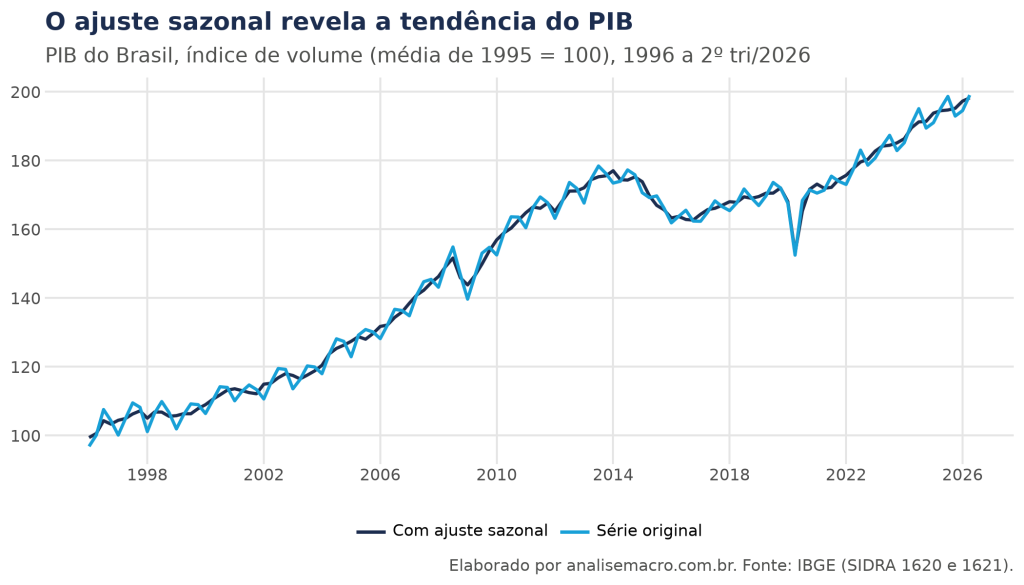
Na figura acima, a série original, em ciano, oscila dentro de cada ano, porque alguns trimestres produzem mais do que outros por razões de calendário, como a colheita da safra de grãos. A série com ajuste sazonal, em navy, retira esse movimento e mostra a trajetória da economia: a expansão até 2014, a recessão de 2015 e 2016 e a queda do segundo trimestre de 2020, na pandemia.
📬 Boletim AM
Receba análises e conteúdos sobre modelos estatísticos clássicos, econometria feita com hipóteses sérias e LLMs acessados em ambientes de trabalho reais, tudo aplicado à economia, ao mercado financeiro e à análise de dados.
O que é o SIDRA e como funciona a sua API
O SIDRA reúne as tabelas das pesquisas do IBGE: Contas Nacionais, IPCA, PNAD Contínua, produção industrial e muitas outras. Cada tabela tem um número, e com esse número podemos baixar os dados sem passar por planilha.
O acesso é feito por uma API, um endereço na internet que devolve dados quando recebe um pedido no formato combinado. Explicamos esse mecanismo em O que são APIs e como utilizá-las no Python?
A API do SIDRA recebe o pedido como uma sequência de parâmetros, cada um formado por uma letra e um valor:
- t: o código da tabela, que identifica a pesquisa e o indicador;
- n: o nível territorial (1 é o Brasil, 2 as grandes regiões, 3 as unidades da federação, 6 os municípios);
- o valor depois do nível: os códigos das unidades territoriais, ou
allpara todas; - v: as variáveis da tabela;
- p: os períodos;
- c: a classificação e as suas categorias. Em
c11255/90707, a classificação 11255 são os setores e subsetores das Contas Nacionais, e a categoria 90707 é o PIB a preços de mercado.
A página de ajuda da API do SIDRA descreve todos os parâmetros. A biblioteca sidrapy recebe cada um deles como um argumento da função get_table() e devolve a tabela pronta como um DataFrame do pandas.
Como encontrar a tabela e os códigos no SIDRA
Os códigos de cada tabela aparecem na própria interface do SIDRA. Buscamos a pesquisa pelo nome, aqui as Contas Nacionais Trimestrais, e abrimos a tabela de interesse. O PIB sem ajuste sazonal está na tabela 1620, e o PIB com ajuste sazonal, na tabela 1621.
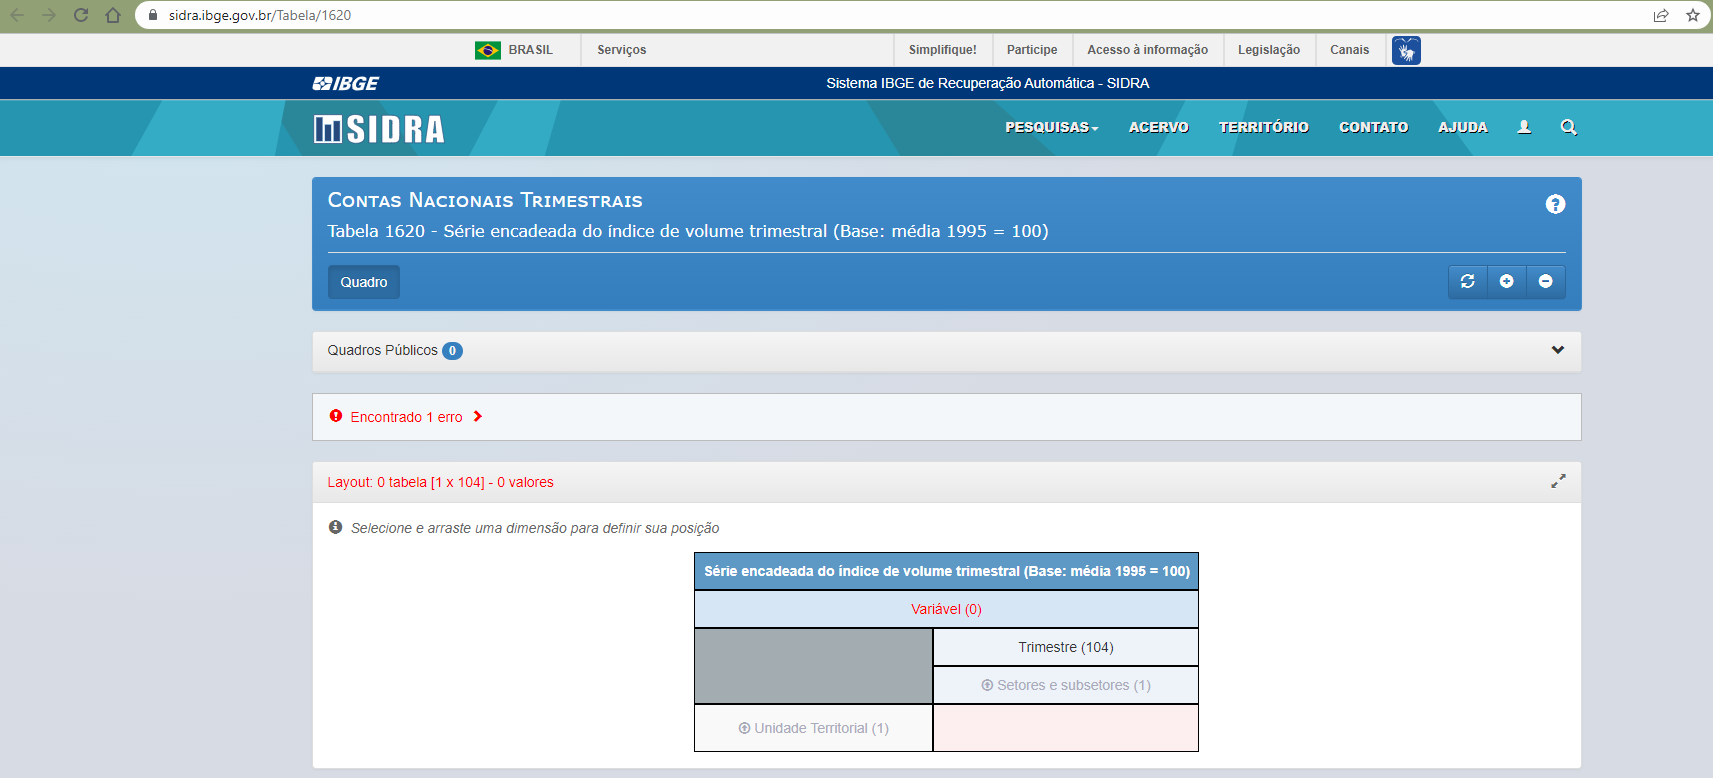
Na tabela 1620, marcamos a variável "Série encadeada do índice de volume trimestral (Base: média 1995 = 100)", a categoria "PIB a preços de mercado" em Setores e subsetores, todos os trimestres e a unidade territorial Brasil.
O botão de link, no rodapé da página, abre a janela com os parâmetros para a API.
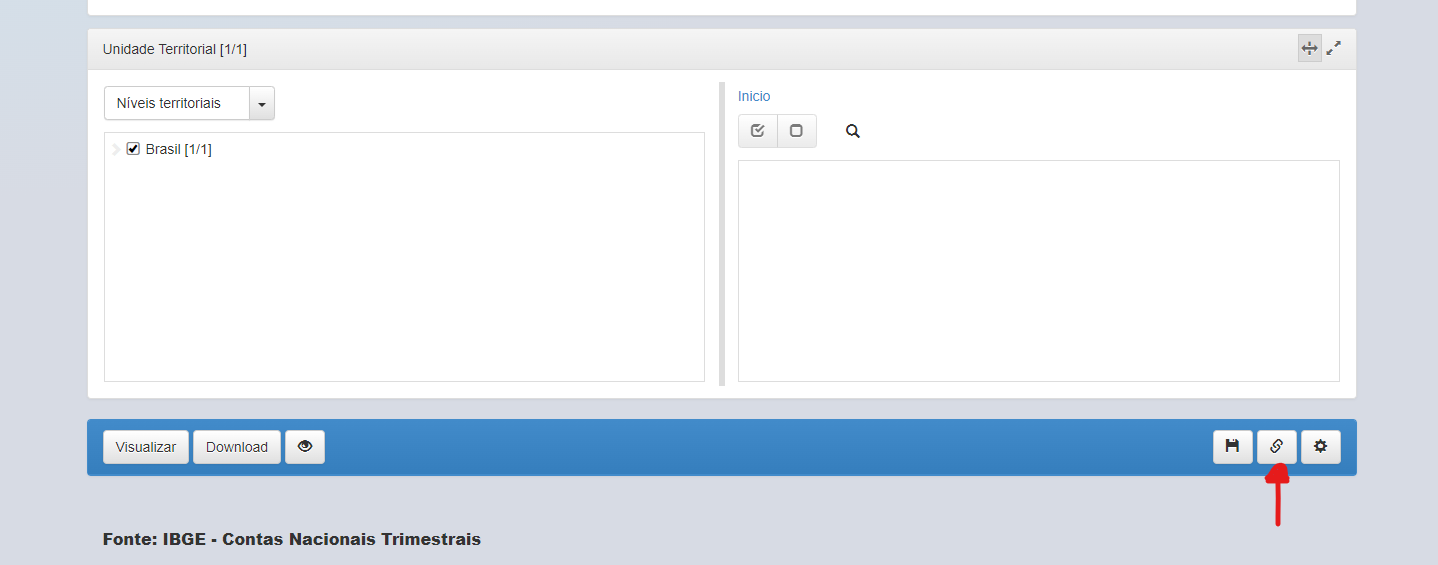
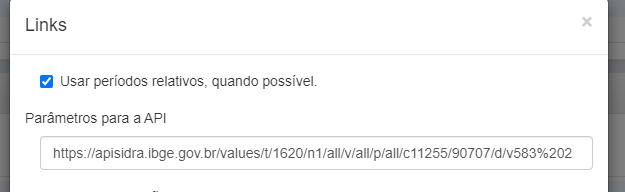
O endereço gerado é https://apisidra.ibge.gov.br/values/t/1620/n1/all/v/all/p/all/c11255/90707/d/v583%202. Cada trecho depois de /values corresponde a um argumento do get_table():
| Parâmetro | Argumento do get_table() | Valor |
|---|---|---|
| t | table_code | 1620 |
| n | territorial_level | 1 |
| valor depois de n1 | ibge_territorial_code | all |
| v | variable | all |
| p | period | all |
| c | classification | 11255/90707 |
O último trecho, d/v583 2, fixa em duas as casas decimais da variável 583 e pode ficar de fora do pedido.
Coletando o PIB com o sidrapy
Antes de começar, instalamos o sidrapy e o plotnine.
# instala as bibliotecas usadas no exercício
!pip install -q sidrapy plotnine
O sidrapy faz o pedido à API do SIDRA, o pandas organiza as tabelas e o plotnine faz os gráficos com a gramática de gráficos, a mesma lógica do ggplot2 do R. Se o pandas for novidade, começamos por ele em Introdução ao pandas.
import pandas as pd                                     # manipulação de dados
import sidrapy                                          # acesso à API do SIDRA
from plotnine import *                                  # gramática de gráficos
import matplotlib                                       # motor por baixo do plotnine

matplotlib.rcParams["text.parse_math"] = False          # "$" deixa de ser lido como LaTeX
matplotlib.rcParams["figure.dpi"] = 96                  # figuras em tamanho de tela
Definimos uma vez as cores e o tema dos gráficos da Análise Macro, para que as duas figuras saiam no mesmo padrão.
navy, ciano = "#1c2d4f", "#18a0d7"                      # cores da marca
cores_am = ["#282f6b", "#1B998B", "#FF7A00", "#00798C", "#b22200"]  # paleta oficial da casa

tema_am = (                                             # tema reaproveitado nos dois gráficos
    theme_minimal(base_size=10)                         # base limpa
    + theme(
        plot_title=element_text(weight="bold", color=navy, ha="left", size=12),  # título navy
        plot_subtitle=element_text(color="#50514F", ha="left"),                  # subtítulo cinza
        plot_caption=element_text(color="#50514F", size=8, ha="right"),          # rodapé com a fonte
        panel_grid_minor=element_blank(),               # sem grade secundária
        legend_position="bottom",                       # legenda embaixo
        legend_title=element_blank(),                   # legenda sem título
        figure_size=(7, 4),                             # tamanho em polegadas
    )
)
A tabela como a API entrega
Começamos pela tabela 1621, o PIB com ajuste sazonal, com os mesmos parâmetros que lemos no endereço da API.
pib_sa_bruto = sidrapy.get_table(
    table_code="1621",                                  # t: PIB com ajuste sazonal
    territorial_level="1",                              # n: nível territorial Brasil
    ibge_territorial_code="all",                        # todas as unidades desse nível
    period="all",                                       # p: todos os trimestres
    classification="11255/90707",                       # c: setores (11255), categoria PIB (90707)
)
pib_sa_bruto.head()                                     # as primeiras linhas, como a API devolve
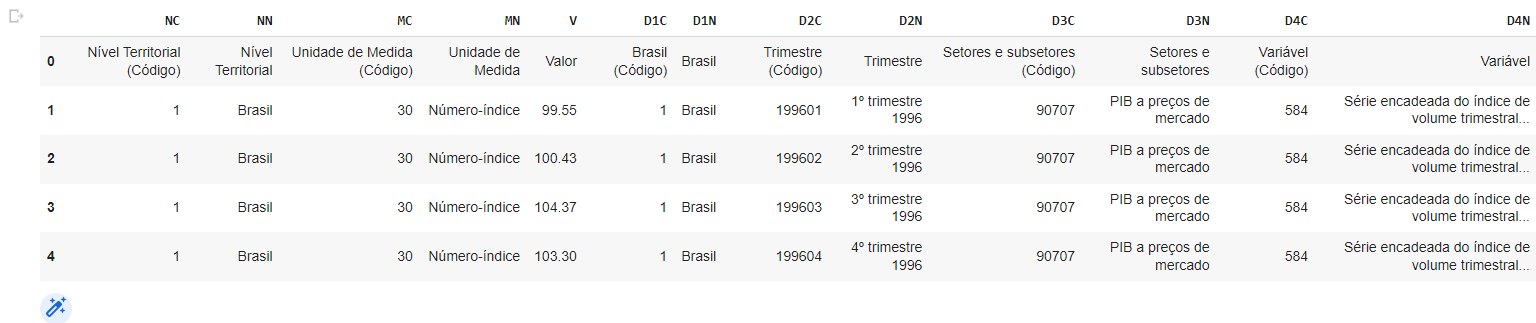
A primeira linha da tabela repete os rótulos das colunas ("Valor", "Trimestre (Código)", "Setores e subsetores (Código)"), e os nomes das colunas são siglas: V é o valor, D2C é o código do trimestre e D3C é o código do setor.
Todos os valores vêm como texto, inclusive o número do índice. Para fazer cálculos, precisamos convertê-los em número.
E o tempo? O código do trimestre junta o ano e o número do trimestre: 199601 é o primeiro trimestre de 1996. Para o Python reconhecer a sequência no tempo, transformamos esse código em um período trimestral do pandas e, em seguida, na data do primeiro dia do trimestre.
Uma função para qualquer tabela trimestral
Vamos usar o mesmo tratamento em três tabelas do SIDRA, por isso reunimos os passos numa função. Ela recebe o número da tabela e as categorias da classificação 11255, e devolve uma tabela com três colunas: a data, o código do setor e o valor.
def coleta_sidra(tabela, categorias):
    """Baixa uma tabela trimestral do SIDRA e devolve data, setor e valor."""
    bruto = sidrapy.get_table(
        table_code=tabela,                              # código da tabela
        territorial_level="1",                          # Brasil
        ibge_territorial_code="all",                    # todas as unidades do nível
        period="all",                                   # todos os trimestres
        classification=f"11255/{categorias}",           # setores pedidos, separados por vírgula
    )
    return (
        bruto
        .iloc[1:]                                       # descarta a linha de rótulos
        .rename(columns={"D2C": "trimestre", "D3C": "setor", "V": "valor"})  # nomes legíveis
        .assign(
            data=lambda x: pd.PeriodIndex(              # "199601" vira o período 1996Q1
                x["trimestre"].str[:4] + "Q" + x["trimestre"].str[-1], freq="Q"
            ).to_timestamp(),                           # e o período vira a data do 1º dia
            valor=lambda x: pd.to_numeric(x["valor"], errors="coerce"),  # texto vira número
        )
        .loc[:, ["data", "setor", "valor"]]             # só as colunas de interesse
    )
PIB: série original e série com ajuste sazonal
Com a função pronta, coletamos as duas versões do PIB e as empilhamos numa só tabela, com uma coluna que identifica a série.
pib = pd.concat([                                       # empilha as duas versões do PIB
    coleta_sidra("1620", "90707").assign(serie="Série original"),      # sem ajuste sazonal
    coleta_sidra("1621", "90707").assign(serie="Com ajuste sazonal"),  # com ajuste sazonal
])
pib.pivot(index="data", columns="serie", values="valor").tail()  # os trimestres mais recentes
As duas séries são índices de volume. Elas medem a quantidade produzida em cada trimestre em relação à média de 1995, que é igual a 100. Um índice de 200 significa que a economia produz o dobro do que produzia em 1995, já sem o efeito da variação dos preços.
A sazonalidade é o padrão que se repete todo ano no mesmo trimestre. No PIB brasileiro, a colheita de grãos concentra a produção agropecuária no primeiro semestre, e o fim do ano tem mais comércio e serviços.
Por que isso atrapalha? Comparar um trimestre com o anterior na série original mistura esse padrão de calendário com a mudança efetiva da atividade. Uma alta do segundo trimestre sobre o primeiro pode ser só a safra.
O ajuste sazonal estima o componente que se repete todo ano e o retira da série. O IBGE faz esse ajuste com o método X-13ARIMA-SEATS e publica o resultado na tabela 1621. Com a série ajustada, podemos comparar trimestres consecutivos. O método aparece passo a passo em Ajuste sazonal no Python com o X13-ARIMA-SEATS.
O gráfico é feito com o plotnine, camada por camada: os dados, as linhas, as escalas, os textos e o tema. A lógica dessa construção está em A gramática dos gráficos: como deixar de criar gráficos no Excel e usar o plotnine no Python.
ultimo = pib["data"].max()                              # trimestre mais recente
fim = f"{ultimo.quarter}º tri/{ultimo.year}"           # rótulo do fim da amostra

g_pib = (
    ggplot(pib, aes(x="data", y="valor", color="serie"))  # dados e mapeamento
    + geom_line(size=0.9)                               # as duas séries
    + scale_color_manual(values={"Série original": ciano, "Com ajuste sazonal": navy})  # cores
    + scale_x_datetime(date_breaks="4 years", date_labels="%Y")  # eixo em anos
    + scale_y_continuous(breaks=range(80, 241, 20))     # marcas a cada 20 pontos
    + labs(title="O ajuste sazonal revela a tendência do PIB",
           subtitle=f"PIB do Brasil, índice de volume (média de 1995 = 100), 1996 a {fim}",
           x="", y="",
           caption="Elaborado por analisemacro.com.br. Fonte: IBGE (SIDRA 1620 e 1621).")  # textos
    + tema_am                                           # tema da casa
)
g_pib
No gráfico da introdução, gerado por esse código, a série original oscila em torno da série ajustada, com alguns trimestres acima e outros abaixo, sempre na mesma posição do ano. A série ajustada passa pelo meio dessas oscilações e mostra a trajetória que interessa à análise de conjuntura: a expansão até 2014, a recessão de 2015 e 2016, a recuperação lenta até 2019, a queda da pandemia em 2020 e a retomada dos anos seguintes.
Contribuição para o crescimento do PIB
O crescimento do PIB resume a atividade em um número. A pergunta seguinte é de onde ele vem: quanto do crescimento se deve à agropecuária, quanto à indústria e quanto aos serviços?
A contribuição para o crescimento responde a essa pergunta em pontos percentuais. A soma das contribuições dos componentes é igual ao crescimento do PIB, e cada parcela mostra quanto daquele crescimento veio de um setor.
Pela ótica da oferta, o PIB é a soma do valor adicionado pela agropecuária, pela indústria e pelos serviços, mais os impostos líquidos sobre produtos. O valor adicionado é o que cada setor produz descontados os insumos que comprou de outros setores. A estrutura completa das contas está em Analisando as Contas Nacionais Trimestrais no Python.
A contribuição do componente i no trimestre t multiplica o peso dele no PIB um ano antes pelo seu crescimento real:
Aqui wi,t−4 é a participação do componente no PIB, a preços correntes, no mesmo trimestre do ano anterior, e gi,t é a variação real do componente contra esse mesmo trimestre, em %.
Por que multiplicar pelo peso? Porque um setor grande move o PIB mais do que um setor pequeno com o mesmo crescimento. Um setor que pesa 60% do PIB e cresce 3% acrescenta 1,8 ponto ao crescimento total; um setor que pesa 6% e cresce 10% acrescenta 0,6 ponto.
O peso é nominal porque mede o tamanho de cada setor com os preços do período-base. O crescimento é real porque mede quanto a produção do setor mudou, sem o efeito dos preços.
Para os dois ingredientes, usamos duas tabelas das Contas Nacionais Trimestrais: a 1620, com o índice de volume de cada componente, e a 1846, com os valores a preços correntes, em R$ milhões.
setores = {"90687": "Agropecuária", "90691": "Indústria", "90696": "Serviços",
           "90706": "Impostos líquidos", "90707": "PIB"}   # categorias da classificação 11255
codigos = ",".join(setores)                             # "90687,90691,..." para a API

volume = coleta_sidra("1620", codigos)                  # índice de volume de cada componente
correntes = coleta_sidra("1846", codigos)               # valores a preços correntes (R$ milhões)
O crescimento real de cada componente é a variação do índice de volume contra o mesmo trimestre do ano anterior, a variação interanual. Com dados trimestrais, isso é a variação em relação a quatro linhas antes.
Essa comparação dispensa o ajuste sazonal, porque compara trimestres na mesma posição do ano: o segundo trimestre deste ano contra o segundo trimestre do ano passado.
crescimento = (
    volume
    .sort_values(["setor", "data"])                     # ordena cada setor no tempo
    .assign(cresc=lambda x: x.groupby("setor")["valor"].pct_change(4) * 100)  # variação contra 4 trimestres antes, em %
    .loc[:, ["data", "setor", "cresc"]]                 # só o que interessa
)
O peso de cada componente é o seu valor a preços correntes dividido pelo PIB a preços correntes do mesmo trimestre. Defasamos esse peso em quatro trimestres, para usar a participação do período-base.
pib_corrente = (
    correntes
    .query("setor == '90707'")                          # só o PIB nominal
    .loc[:, ["data", "valor"]]                          # data e valor
    .rename(columns={"valor": "pib"})                   # nome do denominador
)

peso = (
    correntes
    .merge(pib_corrente, on="data")                     # PIB do mesmo trimestre ao lado
    .sort_values(["setor", "data"])                     # ordena cada setor no tempo
    .assign(peso=lambda x: (x["valor"] / x["pib"]).groupby(x["setor"]).shift(4))  # participação de um ano antes
    .loc[:, ["data", "setor", "peso"]]                  # só o que interessa
)
A contribuição é o produto das duas colunas. Para o próprio PIB, o peso é igual a 1, e a contribuição é o crescimento do PIB, o que permite comparar a soma dos componentes com o crescimento observado.
contribuicao = (
    crescimento
    .merge(peso, on=["data", "setor"])                  # crescimento e peso na mesma linha
    .assign(contrib=lambda x: x["peso"] * x["cresc"],   # peso do período-base vezes crescimento real
            componente=lambda x: x["setor"].map(setores))  # nome do componente
    .dropna()                                           # o primeiro ano não tem período-base
)

componentes = ["Agropecuária", "Indústria", "Serviços", "Impostos líquidos"]  # ordem das barras

(
    contribuicao
    .pivot(index="data", columns="componente", values="contrib")  # um componente por coluna
    .assign(soma=lambda x: x[componentes].sum(axis=1))  # soma das contribuições
    .loc[:, componentes + ["soma", "PIB"]]              # componentes, soma e crescimento do PIB
    .round(2)                                           # duas casas decimais
    .tail()                                             # os trimestres mais recentes
)
A soma das contribuições fica próxima do crescimento do PIB, em geral a poucos décimos de ponto. Por que não é exata? O IBGE calcula o volume de cada trimestre com os preços do ano anterior e encadeia os resultados, e o peso nominal de um ano antes aproxima esse cálculo.
O gráfico começa em 2015 e mostra as contribuições em barras empilhadas e o crescimento do PIB em linha.
inicio = "2015-01-01"                                   # recorte do gráfico

barras = (
    contribuicao
    .query("componente != 'PIB' and data >= @inicio")   # só os componentes, no recorte
    .assign(componente=lambda x: pd.Categorical(x["componente"], componentes))  # fixa a ordem
)
linha = contribuicao.query("componente == 'PIB' and data >= @inicio")  # o PIB, no recorte

g_contrib = (
    ggplot()
    + geom_hline(yintercept=0, color="#808080")         # linha do zero
    + geom_col(barras, aes(x="data", y="contrib", fill="componente"), width=70)  # barras empilhadas
    + geom_line(linha, aes(x="data", y="contrib"), color=navy, size=0.9)   # crescimento do PIB
    + geom_point(linha, aes(x="data", y="contrib"), color=navy, size=1.4)  # um ponto por trimestre
    + scale_fill_manual(values=[cores_am[1], cores_am[2], ciano, "#B8C2CC"])  # cores dos componentes
    + scale_x_datetime(date_breaks="1 year", date_labels="%Y")  # eixo em anos
    + labs(title="De onde vem o crescimento do PIB brasileiro",
           subtitle="Contribuição para a variação interanual do PIB (p.p.); a linha é o PIB (%)",
           x="", y="",
           caption="Elaborado por analisemacro.com.br. Fonte: IBGE (SIDRA 1620 e 1846).")  # textos
    + tema_am                                           # tema da casa
)
g_contrib
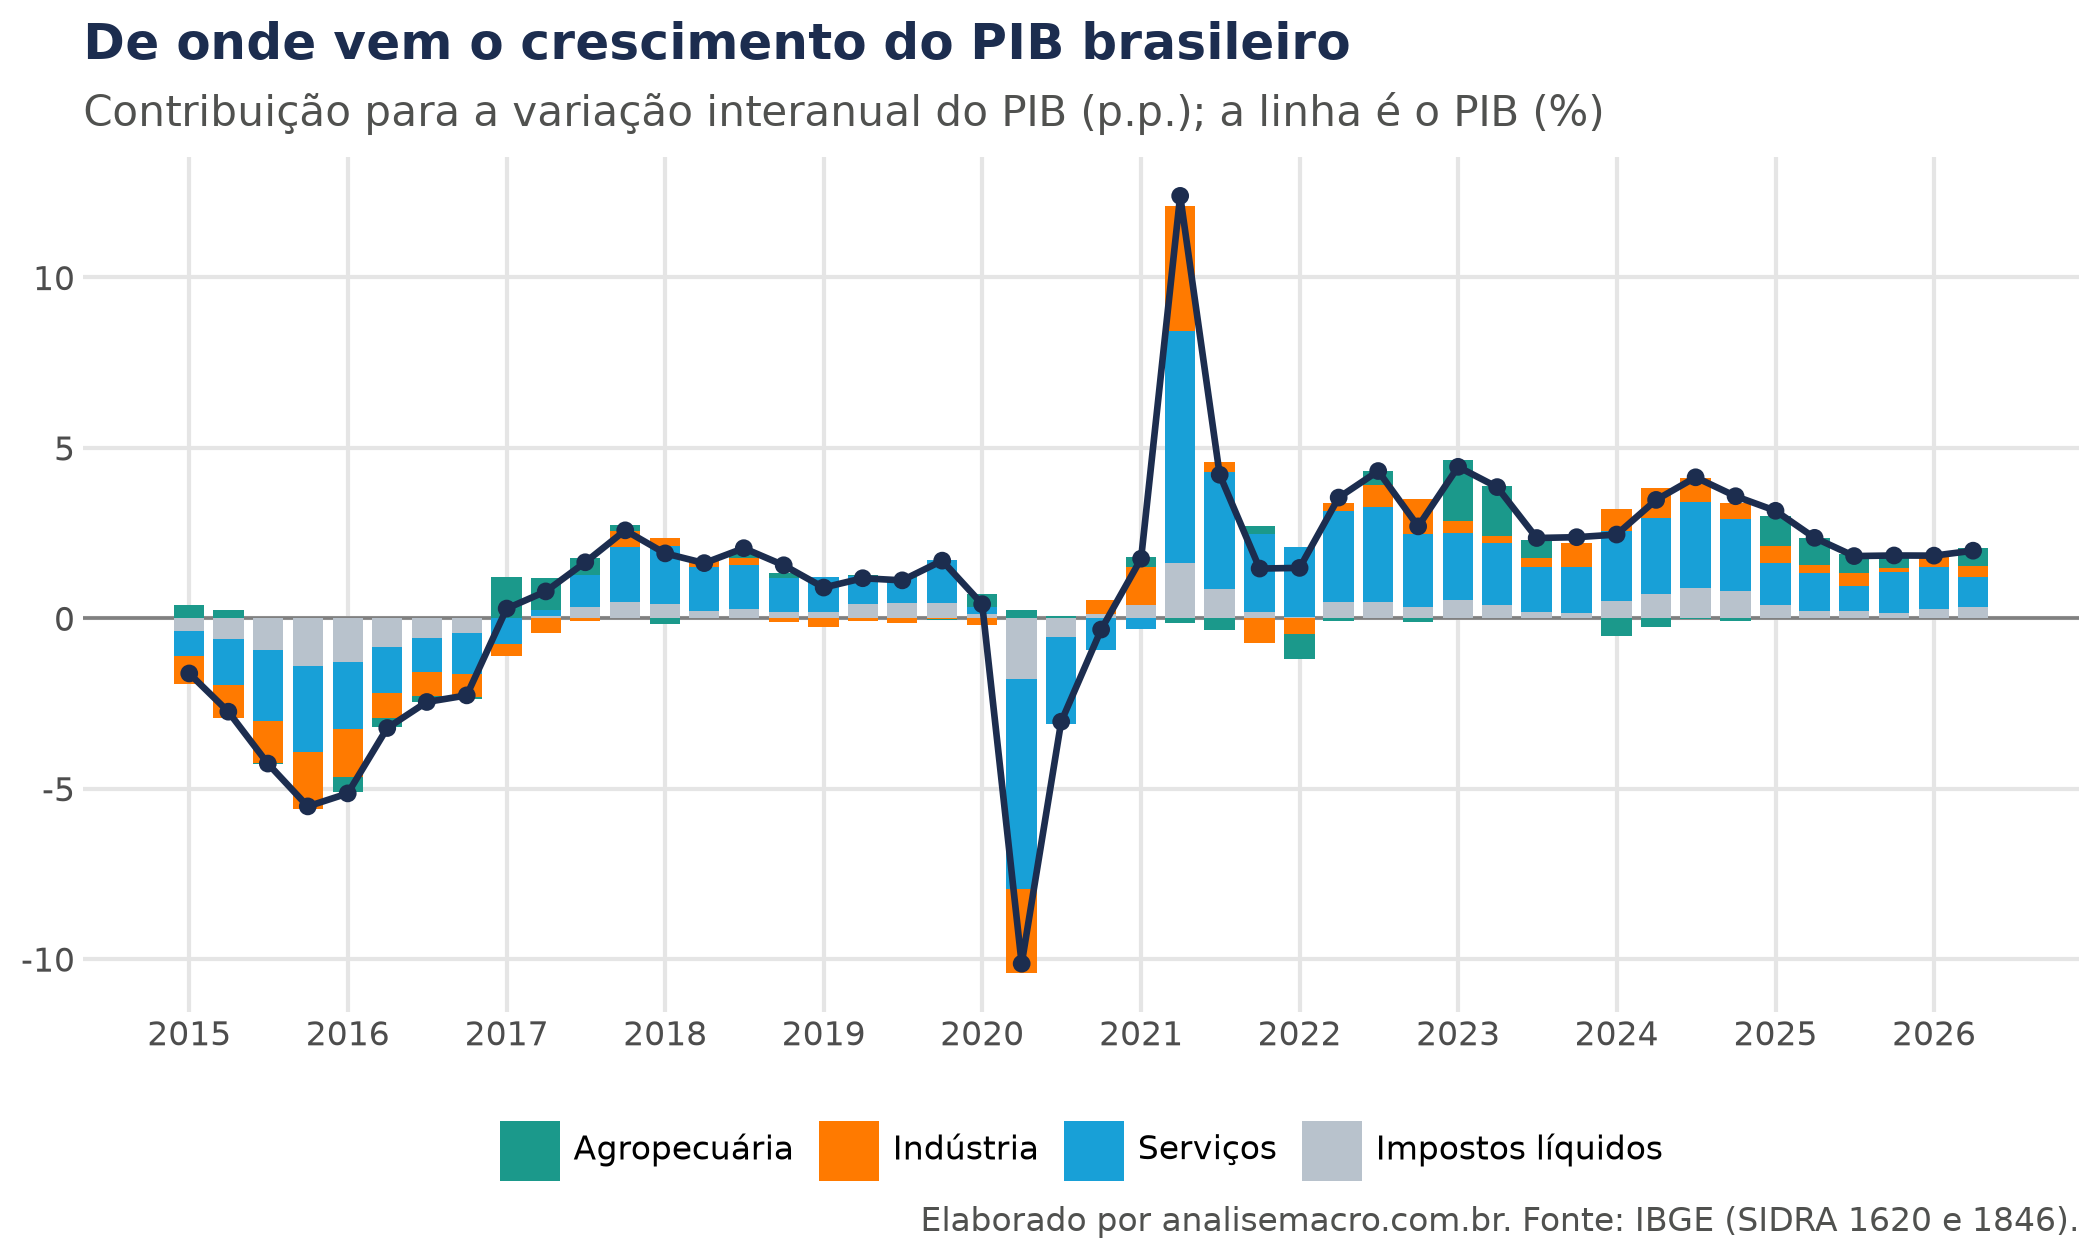
Na figura acima, as barras dos serviços formam a maior parte do crescimento na maioria dos trimestres, porque os serviços respondem por cerca de 60% do PIB. A indústria puxou o PIB para baixo na recessão de 2015 e 2016 e na queda de 2020.
A agropecuária pesa pouco no PIB, mas cresce muito em anos de safra recorde. Em 2017 e em 2023, a sua contribuição aparece com destaque.
Os impostos líquidos sobre produtos acompanham o volume de bens e serviços vendidos, por isso a sua contribuição tende a ter o mesmo sinal do crescimento do PIB. Outras leituras dos mesmos dados aparecem em Como analisar os dados do PIB usando o Python.
Aplicações no dia a dia
A coleta pelo SIDRA e as duas leituras do PIB aparecem em várias rotinas de trabalho:
- Comentar a divulgação do PIB: no dia em que o IBGE publica as Contas Nacionais Trimestrais, a função atualiza todas as séries de uma vez, e o gráfico de contribuições mostra quais setores puxaram o resultado.
- Acompanhar a conjuntura: a série com ajuste sazonal indica se a economia acelerou ou desacelerou no trimestre.
- Montar bases para modelos: a mesma função coleta outras tabelas trimestrais do IBGE, como a ótica da demanda, com o consumo das famílias, o investimento e as exportações.
- Automatizar relatórios: o código roda de novo a cada divulgação, sem planilha e sem copiar números à mão.
Considerações finais
O sidrapy dá acesso, pelo Python, a qualquer tabela do IBGE publicada no SIDRA. O trabalho se repete em todas elas: encontrar o código da tabela e das categorias na interface, pedir os dados com get_table() e tratar a tabela para que o tempo vire data e o valor vire número.
Com o PIB coletado, o ajuste sazonal permite comparar trimestres consecutivos, e a contribuição para o crescimento mostra quais setores puxaram a atividade em cada período. Saber coletar e tratar esses dados tem uso em várias áreas:
- Economistas de bancos e consultorias: acompanhar o PIB e preparar a leitura de cada divulgação.
- Analistas de mercado: ligar o desempenho dos setores ao resultado das empresas que acompanham.
- Analistas do setor público: montar bases de dados do IBGE para estudos e relatórios.
- Estudantes e pesquisadores: reproduzir os números das Contas Nacionais com dados sempre atualizados.
Acesso a todo o conteúdo da Análise Macro
Com o AM Black, a assinatura anual, você acessa todo o acervo da Análise Macro, de macroeconomia e econometria aplicadas a Python, R e IA.
Leia também:
📈 Do pacote à análise: o curso de Análise de Conjuntura
Baixar a série é o primeiro passo — e o mais fácil. O que vem depois é tratar, encadear e transformar o dado bruto em leitura de conjuntura. É esse percurso que o curso faz, com as séries brasileiras que você já usa: PIB, produção industrial, PNAD Contínua, CAGED, crédito e inflação.
Curso completo, com código pronto para rodar. R$ 997.




