
O ciclo de análise de dados separa um projeto em seis etapas, cada uma com uma entrega própria: objetivo, dados, exploração, modelagem, validação e implantação. Só passamos para a seguinte quando a anterior produz o que a próxima precisa: sem o objetivo definido não sabemos que dado buscar, e sem a tabela pronta não há o que modelar.
Neste artigo percorremos as seis etapas uma a uma: o que cada uma entrega, quais habilidades exige e com que ferramentas se trabalha. O fio condutor é um caso de queda de engajamento numa empresa de streaming, retomado em todas as etapas.
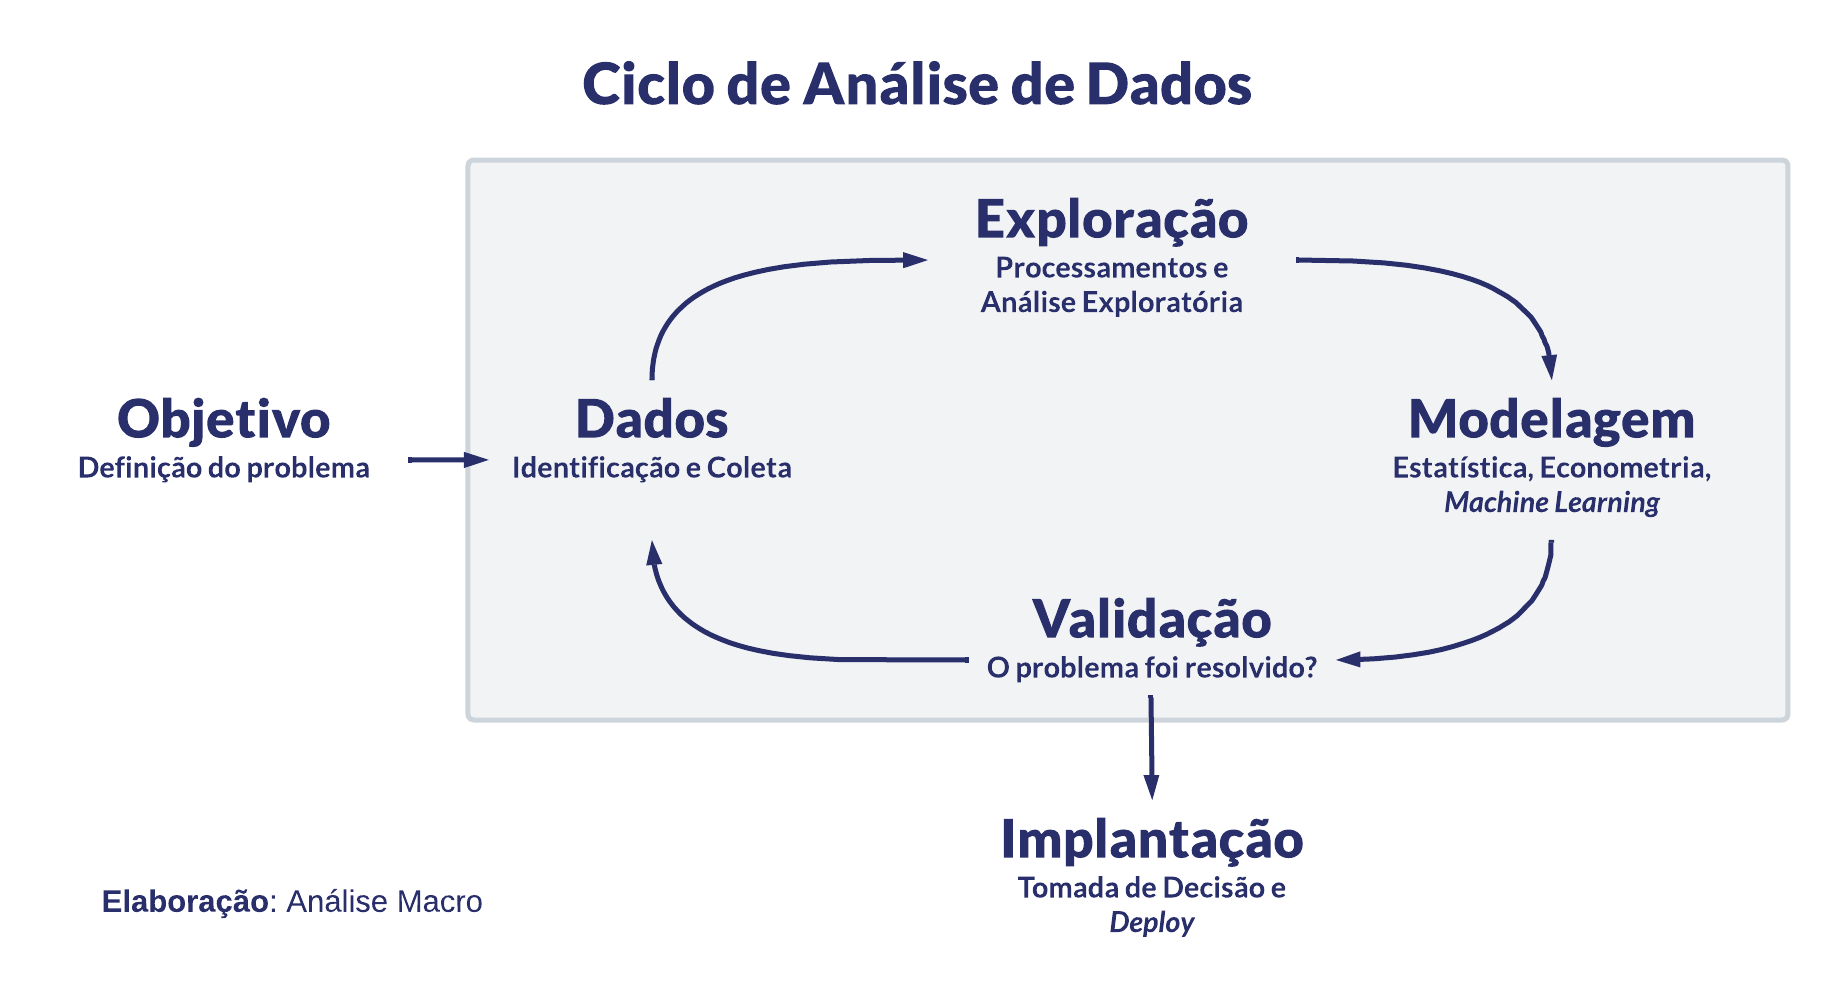
As setas do diagrama voltam da validação para os dados, e é isso que faz do método um ciclo. Quando a solução testada não resolve o problema, refazemos o percurso sabendo qual variável faltou ou qual modelo não serviu.
📩 Acompanhe nossas análises
O Boletim AM traz análises sobre IA, estatística, econometria e papers semanais, direto no seu e-mail.
Por que trabalhar com um ciclo
Analisar dados envolve idas e vindas. Tentamos uma abordagem, ela não funciona, e voltamos alguns passos sabendo algo que antes não sabíamos. Com as etapas nomeadas, conseguimos dizer em qual delas o projeto parou e o que já foi descartado.
Os obstáculos de um projeto de dados cabem em quatro categorias: dados indisponíveis, dados incorretos, dados ausentes e objetivos mal definidos. Os três primeiros são técnicos: buscamos outra fonte, corrigimos o registro ou tratamos o campo vazio.
O quarto sai mais caro porque só se revela na entrega. Uma análise tecnicamente impecável pode responder a pergunta errada, e quem percebe é quem recebe o resultado, com o trabalho já pago. É por isso que o ciclo começa pelo objetivo e não pelos dados.
Etapa 1: objetivo
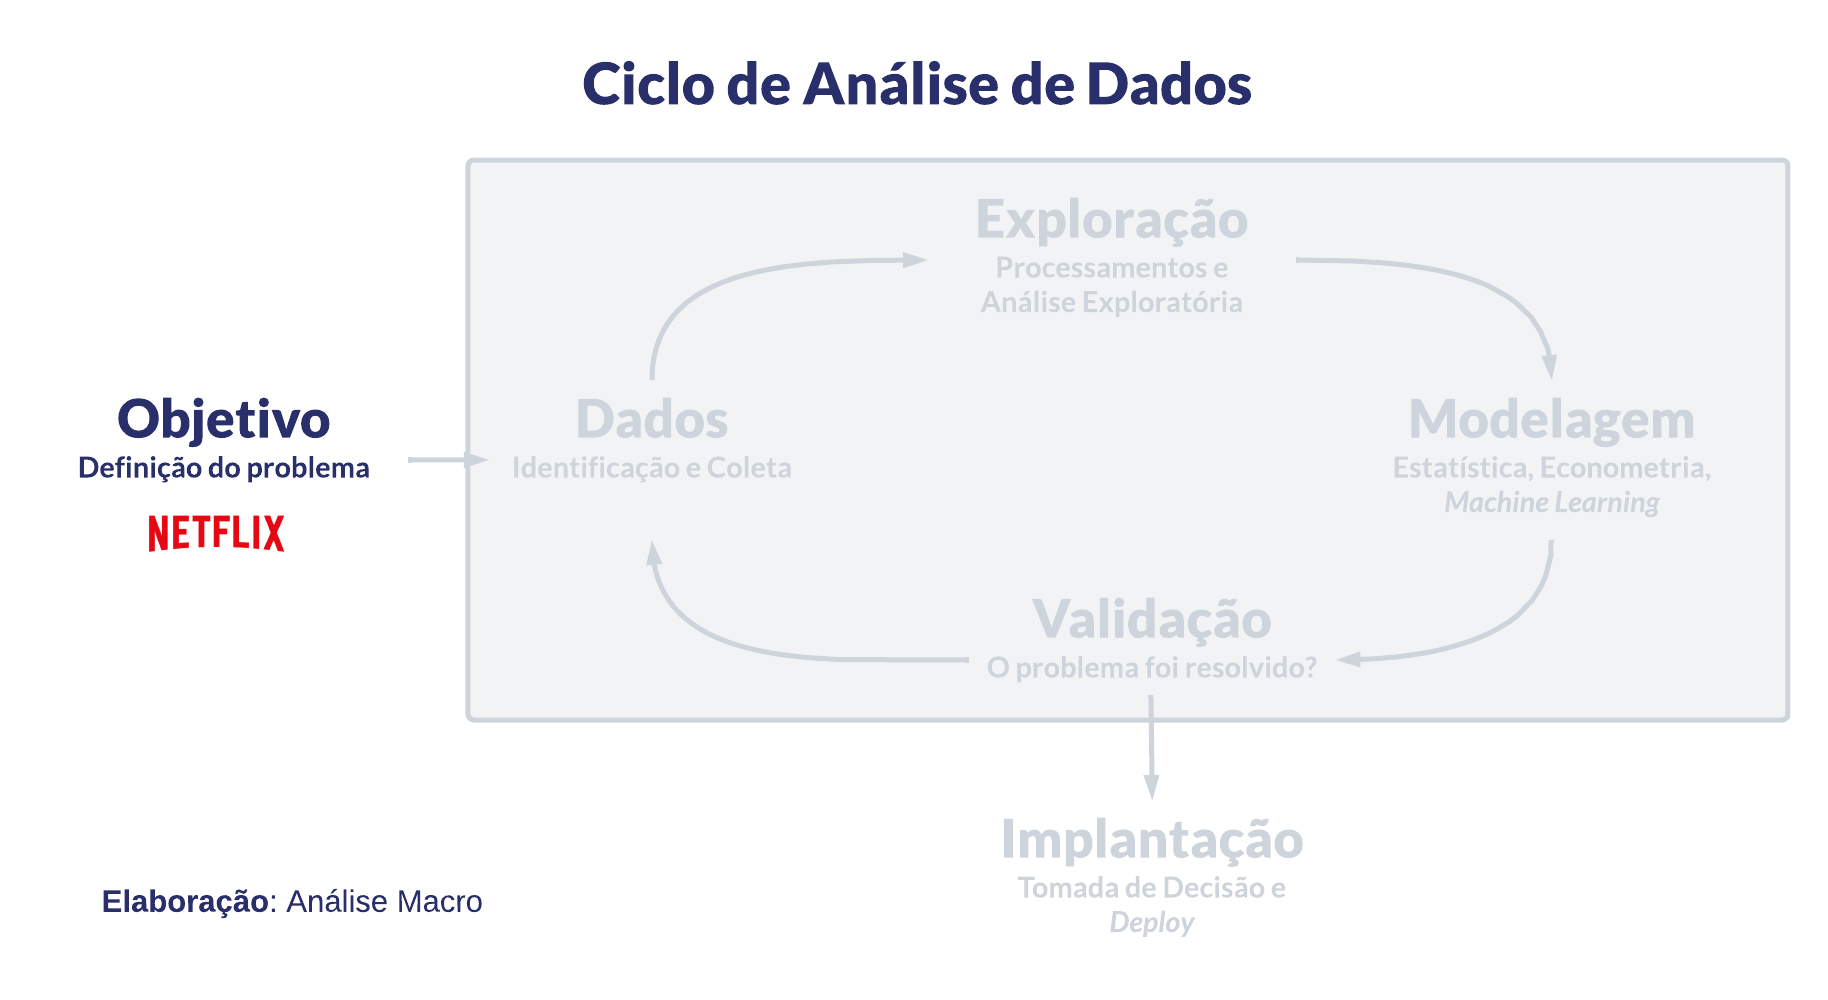
A primeira etapa transforma uma queixa da área de negócio numa pergunta que os dados conseguem responder. O trabalho aqui é de conversa, não de código: quem convive com o problema sabe o que já foi tentado e o que a empresa considera um resultado aceitável.
No nosso exemplo, o setor que monitora o engajamento de uma empresa de streaming percebe queda no tempo de uso e no número de títulos assistidos. O problema é a queda de engajamento, e o objetivo passa a ser aumentá-lo para evitar cancelamentos de assinatura.
Esse enunciado já restringe o que vem depois. Ele fixa a variável que queremos mover, o tempo de uso, e o resultado que mede o sucesso do projeto, a assinatura mantida.
O que a etapa cobra é conhecimento do negócio e clareza na conversa. Sem confirmar com a área o que significa engajamento e qual queda preocupa, corremos o risco de entregar, três semanas depois, a resposta de outra pergunta.
Etapa 2: dados
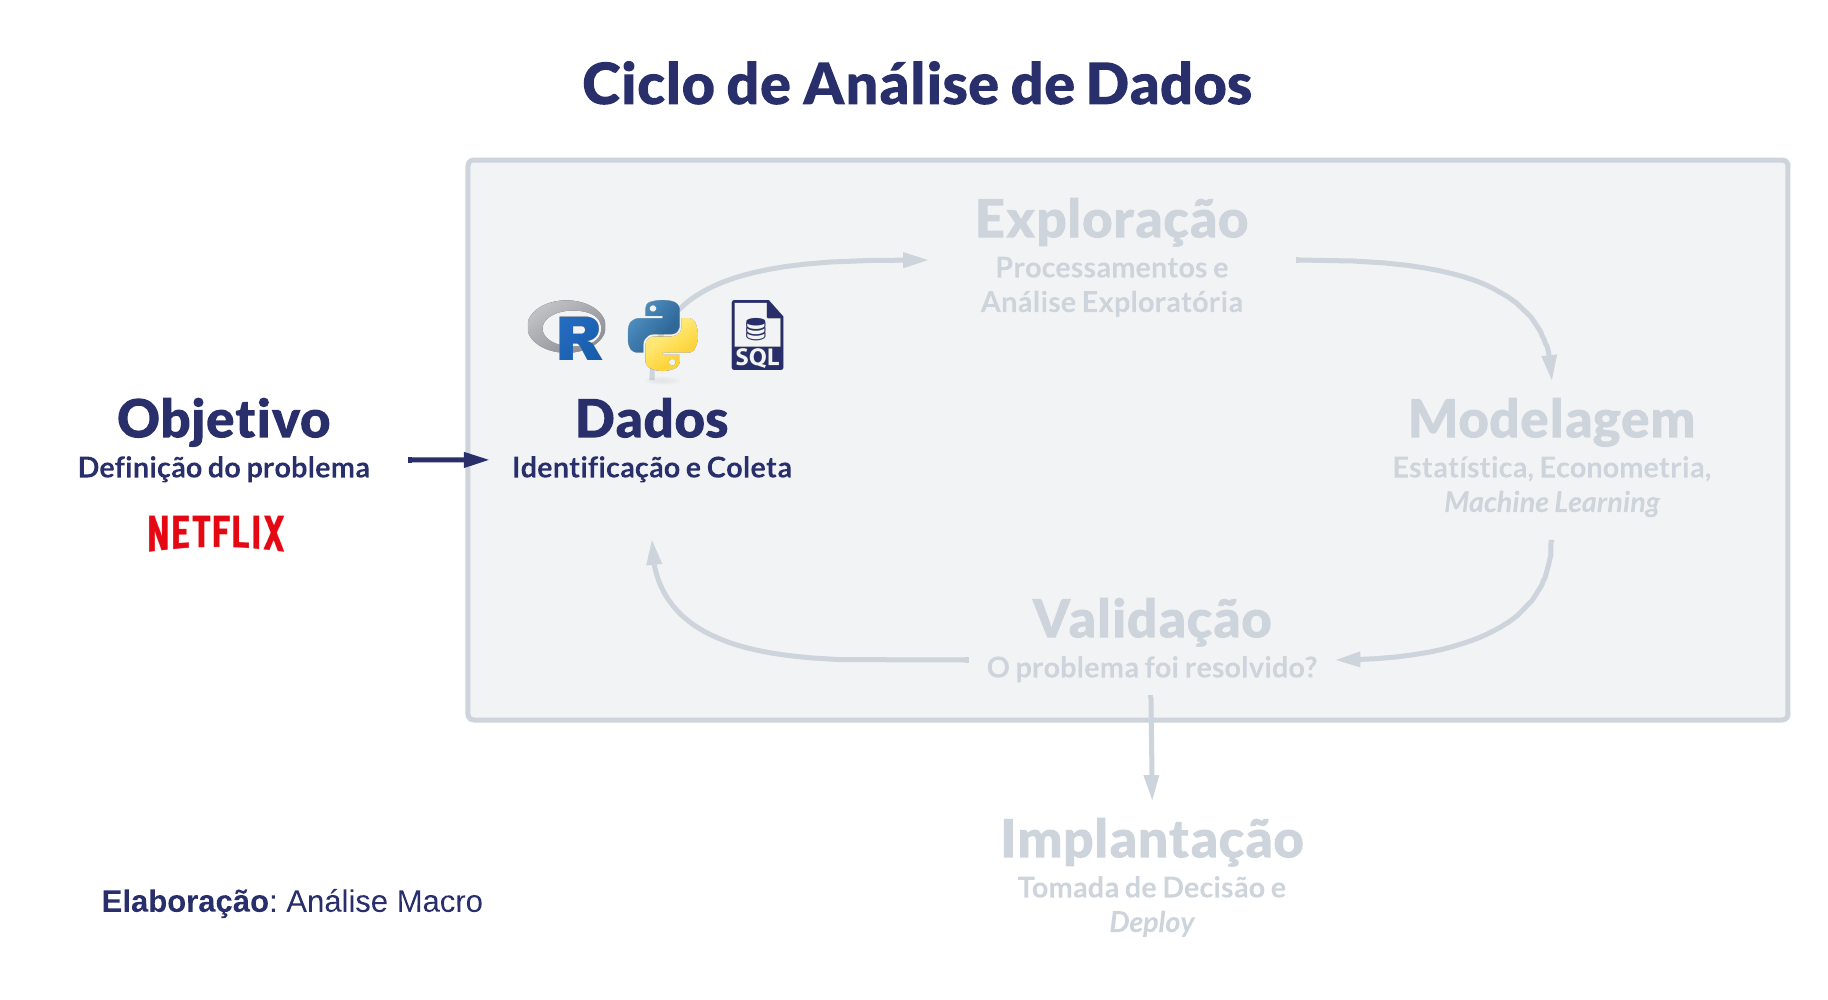
Com o problema definido, identificamos quais dados podem respondê-lo e como obtê-los. Os internos exigem acesso aos bancos da empresa e permissão para usá-los; os externos exigem encontrar uma fonte pública confiável e aceitar o recorte que ela oferece.
Internamente, o exemplo do streaming pede o histórico de tempo de uso, horas assistidas, categorias e temas dos títulos, elenco e direção, além de dados de região, idioma e faixa etária dos usuários. Externamente, dados dos concorrentes ajudam a testar se o engajamento migrou para outro serviço.
A programação entra pela primeira vez aqui. Consultar bancos de dados, chamar APIs e ler arquivos são as tarefas da coleta, feitas com R, Python e SQL.
O SQL é a linguagem de consulta com que pedimos dados a um banco relacional, aquele que guarda a informação em tabelas ligadas entre si. Mostramos o essencial dela em Entendendo o basicão de SQL para usuários de Python.
A coleta também falha, e nem sempre com uma mensagem de erro: uma série que muda de unidade no meio do período, um endpoint que devolve resposta vazia e código de sucesso. Tratamos desses casos em Como lidar com erros de coleta de dados.
Etapa 3: exploração
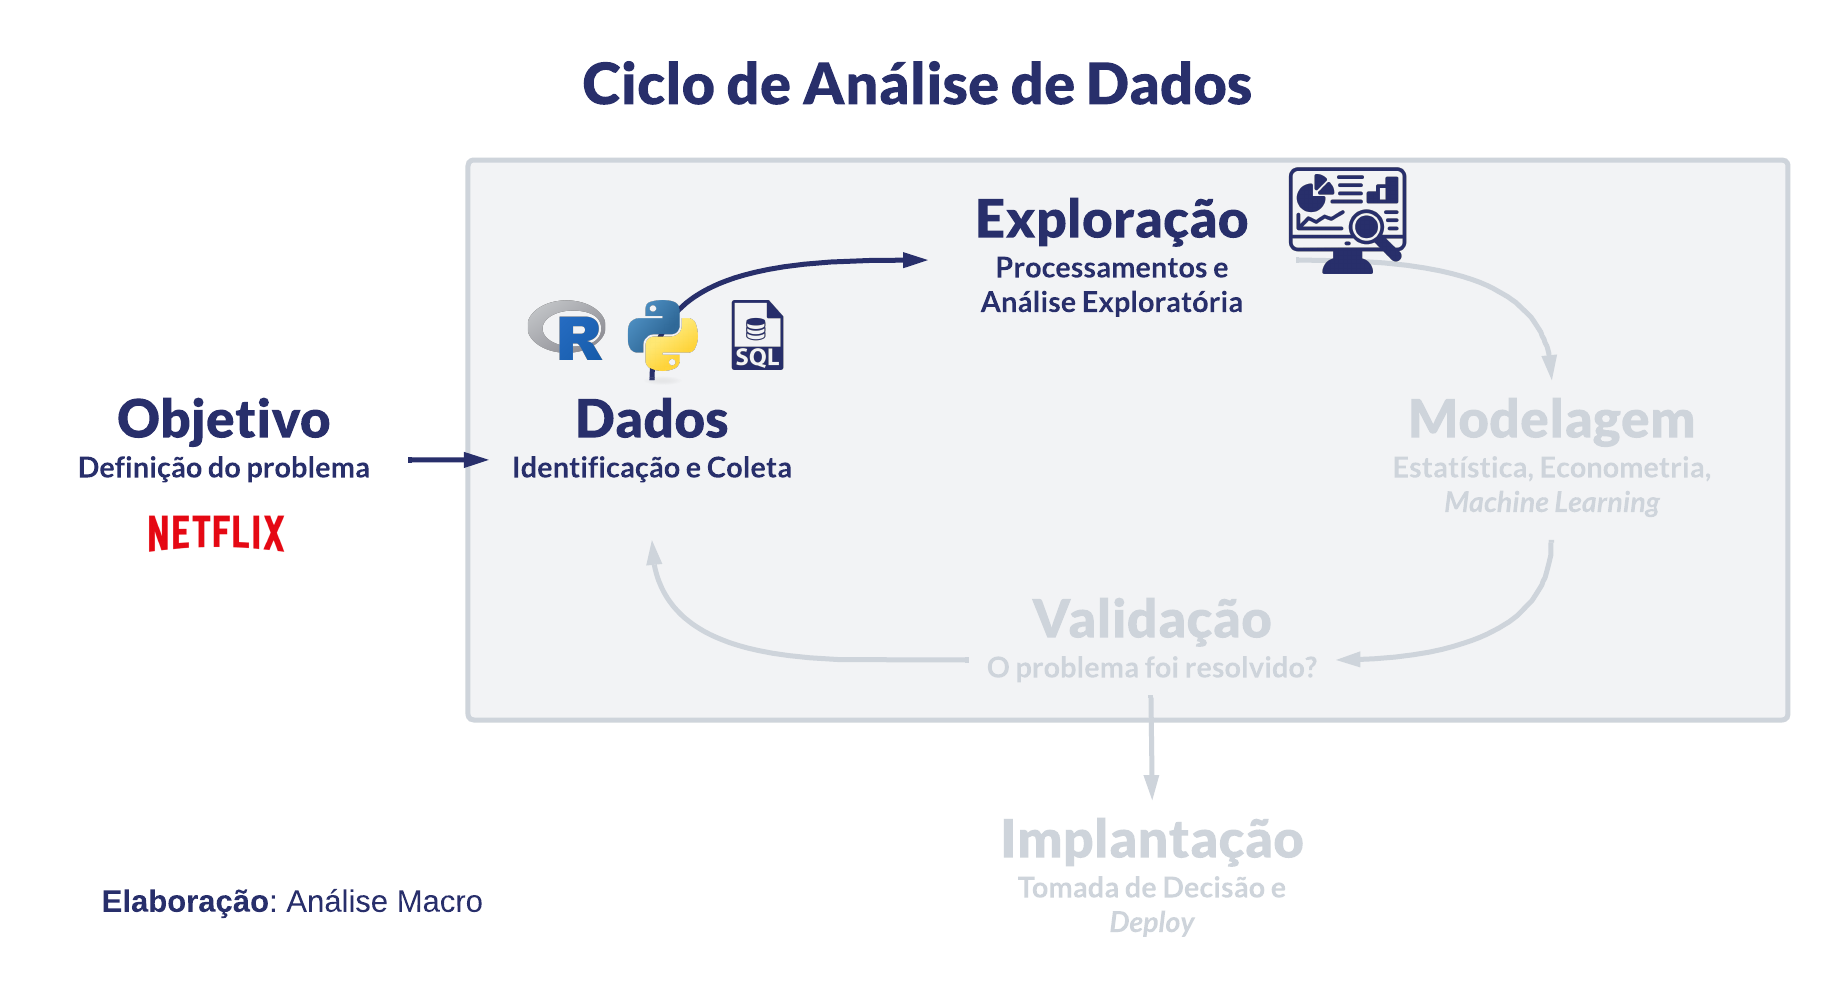
A exploração descreve o que há nos dados antes de qualquer modelo: como cada variável se distribui, quais se movem juntas e quais observações destoam das demais. Uma variável que se move junto com o alvo é candidata a entrar no modelo; uma que não varia nunca pode sair.
Antes disso, os dados brutos precisam virar uma tabela em que cada linha é uma unidade de observação e cada coluna é uma variável. No exemplo do streaming, cada linha é um assinante e as colunas são o tempo de uso, as categorias assistidas e a idade da conta.
Essa tabela tem nome próprio, Tabela Analítica Base, e é a entrada tanto dos gráficos quanto dos modelos que vêm depois.
No caso do streaming, a etapa envolve limpar e cruzar tabelas, olhar a distribuição das variáveis, identificar a variável-alvo (aquela que o modelo vai prever) e examinar correlações, tendências e sazonalidades.
Os valores ausentes e os extremos exigem uma decisão explícita: descartar a linha reduz a amostra, imputar inventa um valor plausível, e manter deixa o extremo puxar a estimativa. Mostramos as alternativas em Pré-processamento: lidando com valores extremos e valores ausentes.
O tratamento depende do tipo de cada variável: as contínuas assumem qualquer valor num intervalo, enquanto as categóricas classificam a observação em grupos. Detalhamos essa distinção em Variáveis Contínuas vs Variáveis Categóricas.
Pular a exploração sai caro. Uma série que troca de unidade, um campo vazio ou um valor mil vezes maior que os demais são achados desta etapa, e o que não encontramos aqui segue para a estimação: no melhor caso ela falha e percebemos, no pior devolve um número plausível e errado.
Aplicamos a etapa inteira a séries econômicas em Análise exploratória e seleção de séries temporais econômicas para modelagem.
As ferramentas da etapa organizam tabelas e desenham gráficos: tidyverse e ggplot2 no R, pandas e plotnine no Python.
Etapa 4: modelagem
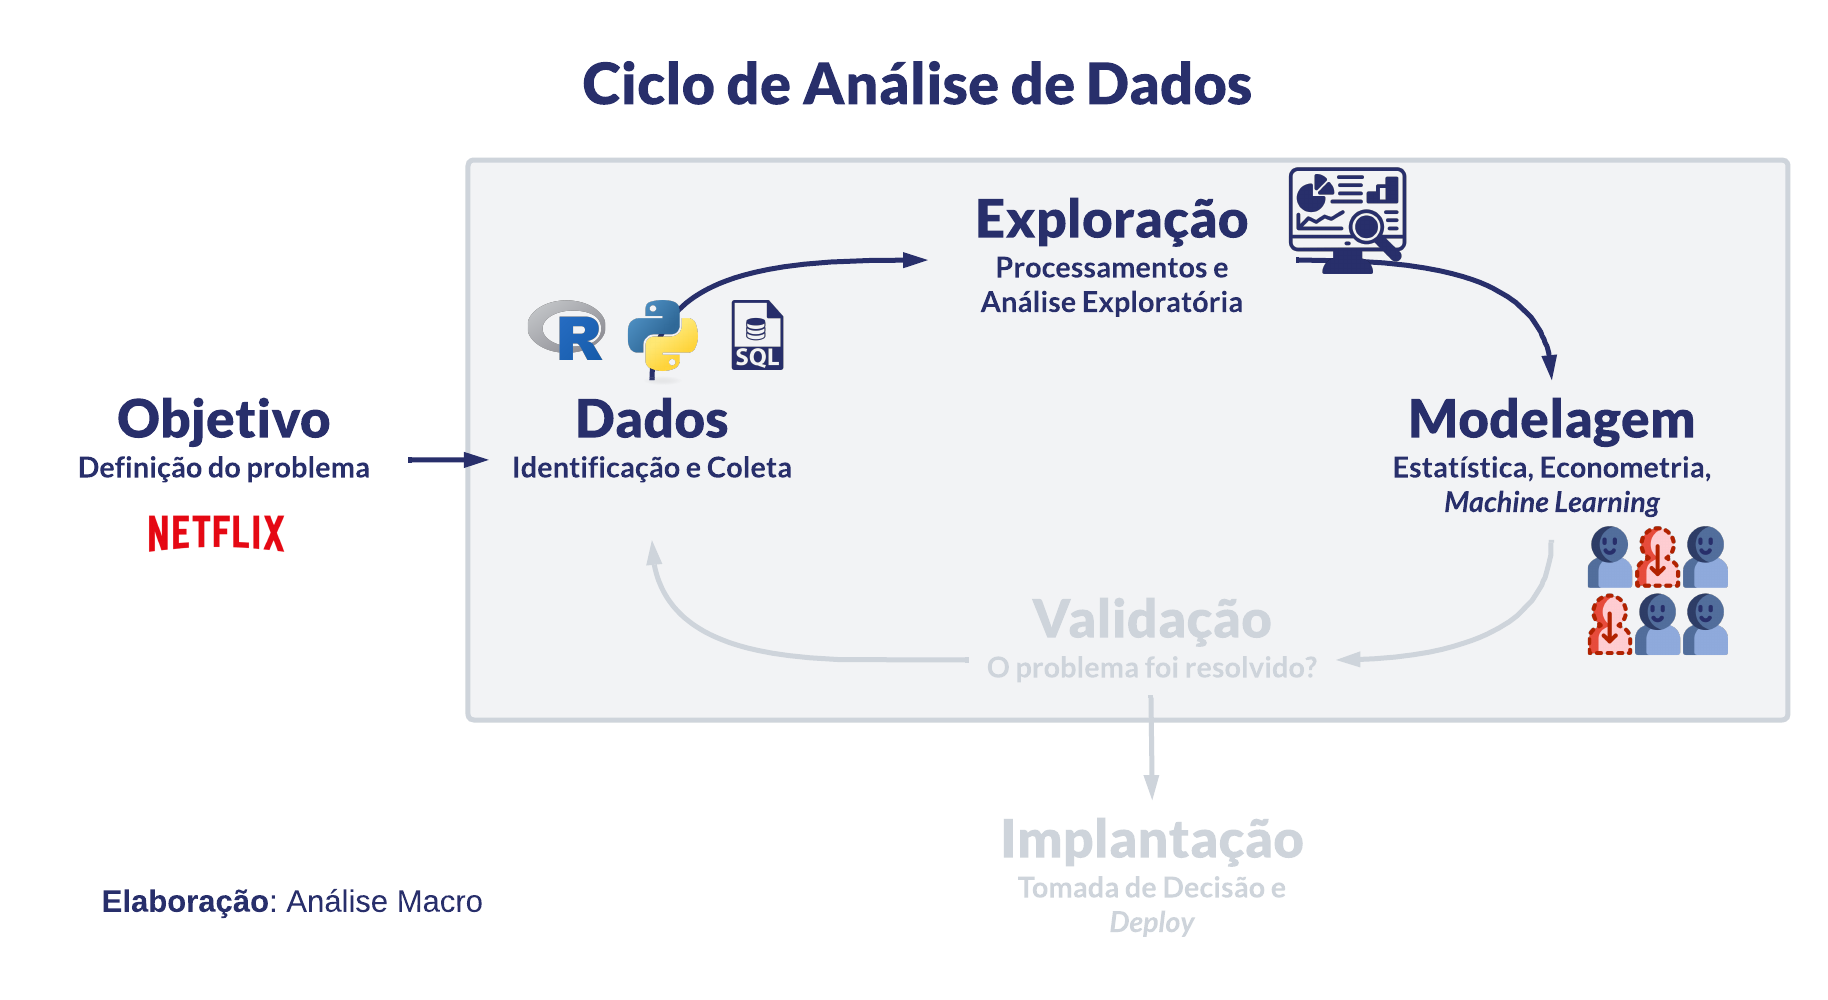
A modelagem levanta e testa soluções para o problema. Nem toda solução precisa de um algoritmo: às vezes a resposta está numa contagem bem feita.
Uma consulta SQL que agrega e sumariza dados já responde perguntas descritivas, do tipo quanto e quantos. Testes de hipótese e regressão medem se uma diferença observada se sustenta. Modelos econométricos estimam o efeito de uma variável sobre outra. E o machine learning entra quando importa acertar a previsão, mesmo sem explicação clara do mecanismo.
No exemplo do streaming, uma solução seria reduzir o churn, o cancelamento de assinaturas. Identificamos o perfil de quem cancelou e estimamos a probabilidade de cancelamento de cada usuário, o que permite agir antes que ele saia.
Tecnicamente, é um modelo supervisionado de classificação, que aprende com casos passados a separar quem cancela de quem fica. A regressão logística costuma ser o ponto de partida nesse tipo de problema.
A escolha da técnica sai da definição do problema e dos dados disponíveis. Um modelo mais complexo só se justifica quando o ganho de acerto compensa o que ele cobra depois: mais tempo até entrar no ar e mais custo de manutenção todo mês.
- Consulta e agregação. SQL para sumarizar dados e responder perguntas descritivas.
- Estatística e econometria. Testes de hipótese e regressão para medir relações e produzir inferência.
- Machine learning. Classificação e regressão preditiva quando o objetivo é acertar a previsão.
Etapa 5: validação
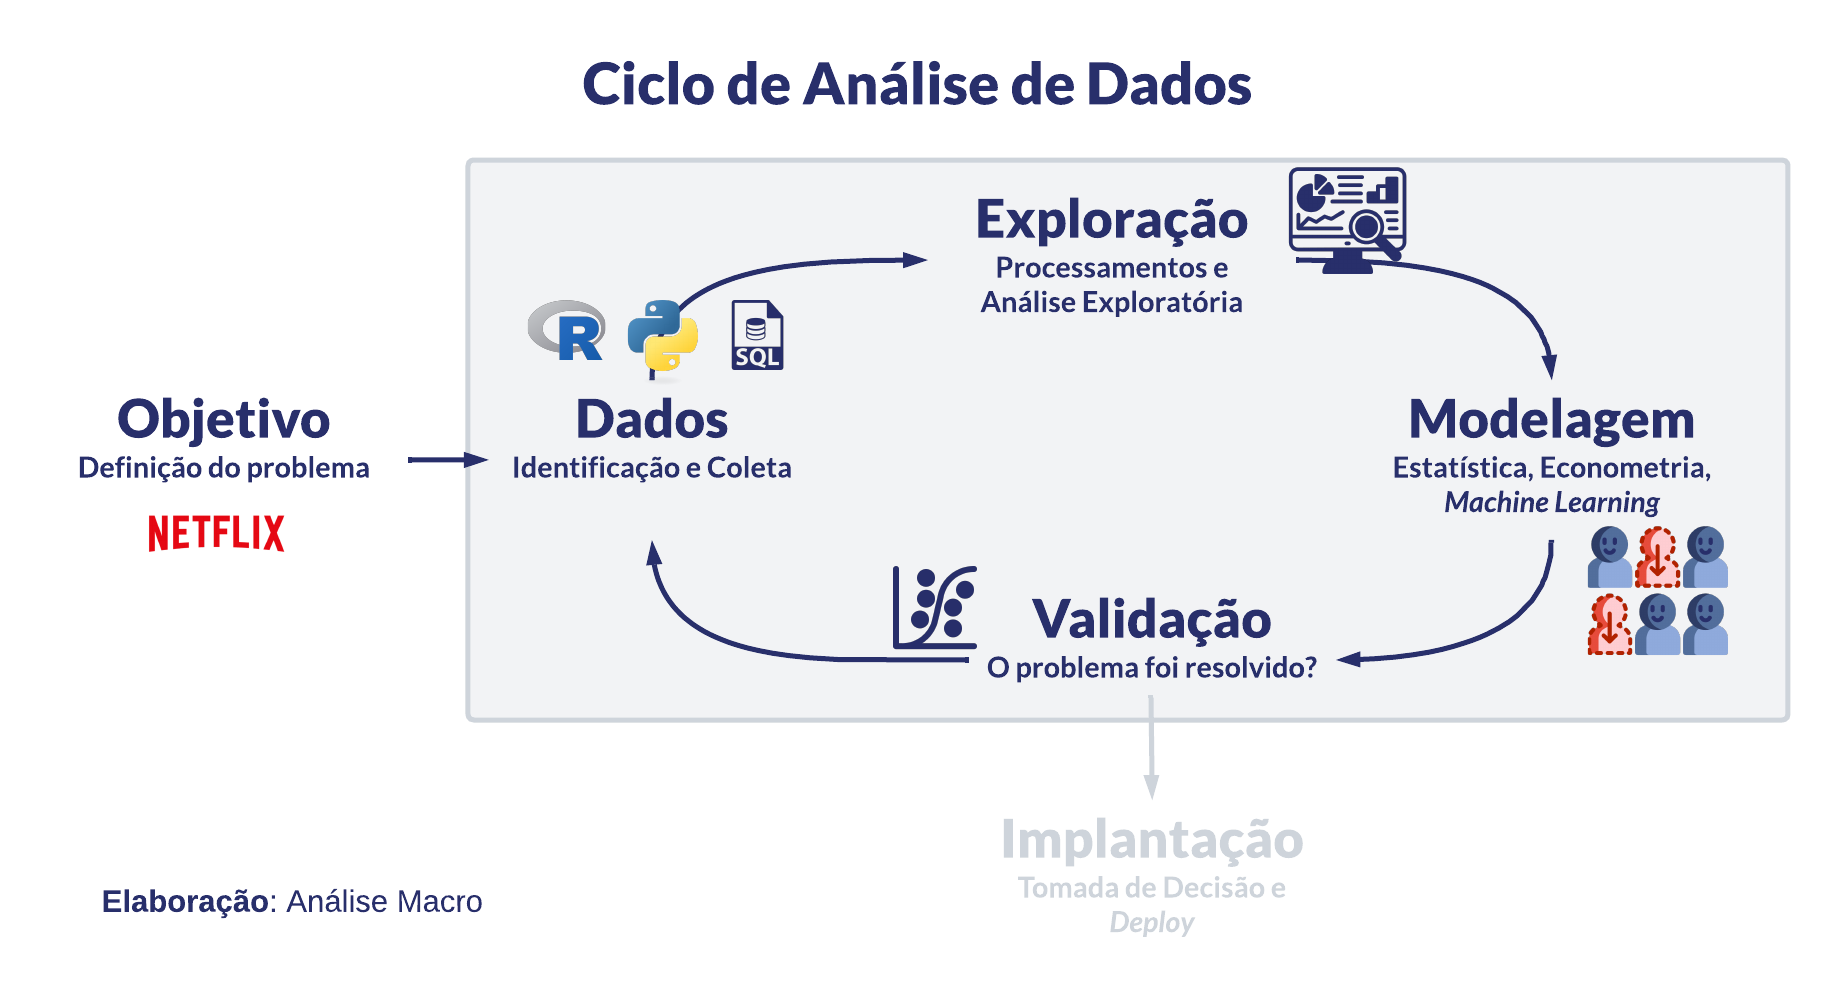
A validação responde se a solução resolve o problema que motivou o projeto. No caso do streaming, a pergunta não é se o modelo acerta muito, e sim se ele identifica a tempo quem vai cancelar.
No exemplo, estimamos o modelo numa parte dos assinantes, a amostra de treino, e medimos o acerto na parte que ficou de fora, a amostra de teste.
Um modelo que acerta muito nos dados com que aprendeu, mas erra nos que nunca viu, ajustou-se ao ruído daquela amostra em vez de captar o padrão que se repete, situação conhecida como sobreajuste.
A validação cruzada existe para tornar essa avaliação mais confiável, repetindo o teste em várias divisões dos dados em vez de confiar em uma só. Tratamos das técnicas, inclusive as específicas para dados ordenados no tempo, em Validação Cruzada [R e Python].
A etapa exige também independência de quem avalia. Descartar um modelo depois de semanas trabalhando nele é decisão difícil, e por isso o critério de aceite precisa estar definido antes de a estimação começar.
Etapa 6: implantação
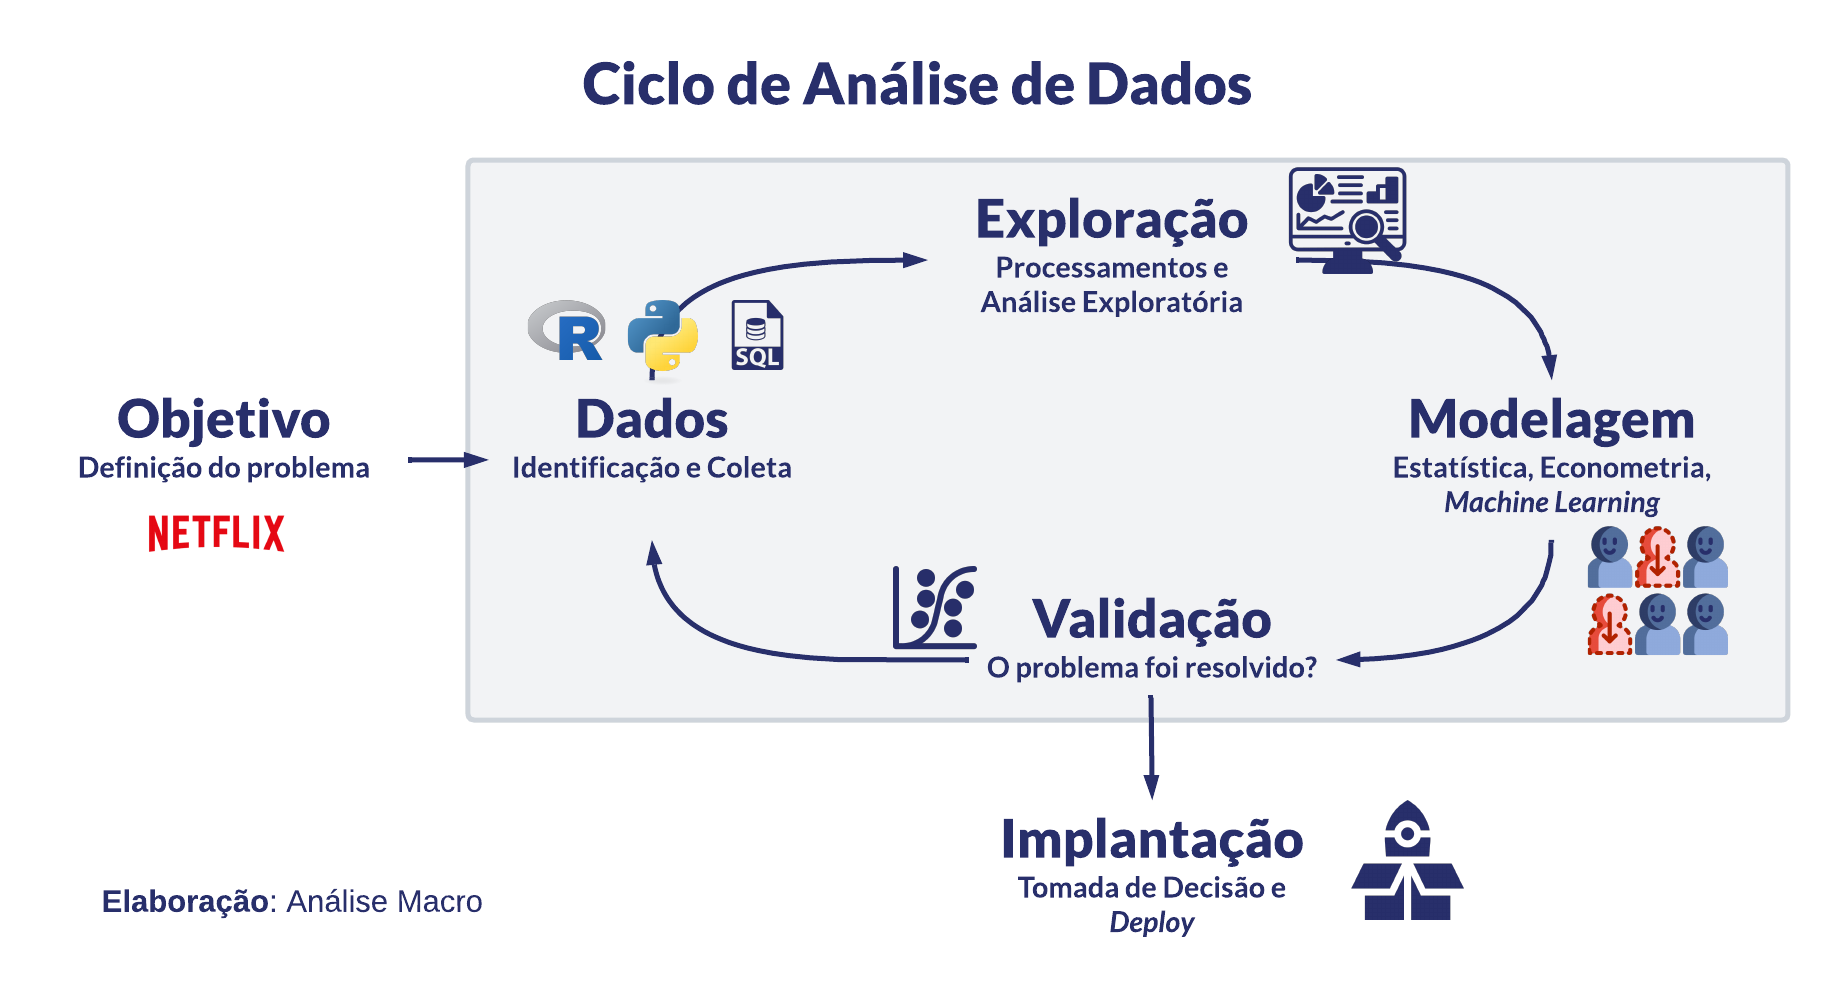
A última etapa leva o resultado até quem toma decisão. A forma varia com a frequência do uso: uma apresentação basta quando a decisão é tomada uma vez, e o uso diário pede um painel que se atualiza sozinho ou um modelo rodando em produção.
No exemplo do streaming, o analista leva aos gestores a lista de assinantes com maior risco de cancelar e o que eles têm em comum. O modelo de classificação também pode ir para produção e recomendar títulos ou oferecer desconto automaticamente a quem tem alta probabilidade de cancelar.
A decisão só muda quando o resultado chega a quem decide, e é essa entrega que a etapa precisa garantir. Quando a entrega é uma apresentação, o que pesa é a argumentação; quando é um modelo em produção, o que pesa é a infraestrutura que o mantém no ar.
Quando a entrega precisa se repetir, o caminho é automatizar o percurso inteiro, da coleta ao painel. Mostramos como planejar isso em Como planejar um pipeline de previsão macroeconômica.
O que cada etapa entrega
| Etapa | O que entrega | Habilidades e ferramentas |
|---|---|---|
| Objetivo | O problema formulado como pergunta respondível | Conhecimento da área e comunicação |
| Dados | Os dados internos e externos coletados | R, Python, SQL, APIs |
| Exploração | Tabela organizada e os padrões encontrados | Estatística, tidyverse, pandas, visualização |
| Modelagem | A solução candidata, do SQL ao machine learning | Econometria, machine learning, programação |
| Validação | A evidência de que a solução funciona | Amostragem, validação cruzada, interpretação |
| Implantação | O resultado nas mãos de quem decide | Comunicação, nuvem, automação |
As seis etapas do ciclo de análise de dados. Elaboração: Análise Macro.
Onde o ciclo aparece na prática
O exemplo do streaming é didático, mas o mesmo percurso se repete em problemas bem diferentes.
Numa área de crédito, o objetivo é reduzir a inadimplência. Os dados são o histórico de pagamento e o cadastro do cliente, o modelo estima a probabilidade de calote, e a implantação é o sistema que aprova ou nega a proposta no momento do pedido.
Numa consultoria macroeconômica, o objetivo é projetar a inflação. Os dados vêm das APIs do IBGE e do Banco Central, a modelagem é econométrica, e a entrega é um relatório que se atualiza sozinho a cada divulgação.
Num time de produto, o objetivo é entender por que os usuários abandonam um cadastro. A exploração dos eventos de navegação costuma mostrar em qual campo eles param, e o ciclo termina aí: encerrar sem modelar também é um resultado.
O que muda entre os casos é o dado e a técnica. A sequência das perguntas é a mesma.
Considerações finais
O ciclo de análise de dados dá ordem a um trabalho que, sem método, avança por tentativa e erro. As idas e vindas continuam existindo, e o que muda é conseguirmos dizer em qual etapa o projeto travou e o que já foi descartado.
Percorrer o ciclo inteiro exige habilidades que vão da conversa com a área de negócio até o modelo em produção. R e Python cobrem as quatro etapas técnicas do meio, da coleta à visualização, sem trocar de ferramenta a cada passo.
O mesmo caminho aparece em quase todo problema resolvido com dados, e o que muda de uma profissão para outra é a aplicação:
- Analista de dados: estrutura o projeto desde a pergunta até o painel entregue, sem pular a exploração.
- Economista: vai da coleta em APIs públicas ao relatório de conjuntura que se atualiza sozinho.
- Gestor: sabe em que etapa o projeto está e o que cobrar de cada uma delas.
- Profissional de risco: aplica a validação com o rigor que a decisão de crédito ou de capital exige.
Em todos esses casos, saber programar permite executar as seis etapas sem depender de terceiros a cada passo.
Aprenda a percorrer o ciclo na prática
A formação Do Zero à Análise de Dados Econômicos e Financeiros cobre as etapas deste ciclo na prática, da coleta de dados à visualização, usando Python e inteligência artificial, sem exigir conhecimento prévio. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Leia também: