A volatilidade mede o tamanho típico das oscilações de um ativo, sem olhar para a direção delas. Uma ação que sobe 3% num dia e cai 3% no outro é mais volátil que uma que anda 0,2% por pregão, mesmo que as duas terminem o mês no mesmo lugar.
Esse tamanho é o que determina quanto se pode perder num intervalo curto. Por isso a volatilidade entra no dimensionamento de posição, no cálculo de risco de uma carteira e no preço de uma opção.
A forma usual de medi-la é o desvio-padrão dos retornos. E aqui aparece o problema que motiva este exercício: um desvio-padrão calculado sobre dez anos devolve um número, como se o risco do mercado fosse uma característica fixa do ativo.
Por que a volatilidade precisa de um modelo próprio
Quem acompanha o mercado sabe que existem semanas em que nada acontece e semanas em que tudo acontece. Em março de 2020, o Ibovespa andava mais em um pregão do que costuma andar num mês inteiro de calmaria.
Um único desvio-padrão para toda a amostra mistura os dois regimes e produz um número que não descreve nenhum dos dois. A carteira dimensionada por ele fica pequena demais nos períodos calmos e grande demais justamente quando o mercado vira.
O que se quer, então, é uma medida de risco que mude a cada dia, acompanhando o que acabou de acontecer. Essa ideia se apoia numa propriedade estatística das séries financeiras, a heterocedasticidade condicional.
A palavra parece pior do que a ideia. "Heterocedasticidade" significa variância que não é constante ao longo do tempo. "Condicional" significa que essa variância depende da informação disponível até o dia anterior, e é essa dependência que torna a previsão possível.
Os três fatos estilizados dos retornos
Três regularidades aparecem em séries de retorno de praticamente qualquer ativo, em qualquer mercado, e são elas que o modelo precisa reproduzir.
📈
📊
🔁
O terceiro fato é o que abre espaço para os modelos de volatilidade. Se a direção fosse previsível, haveria dinheiro fácil na mesa e o mercado corrigiria isso. O tamanho ser previsível não contraria a eficiência de mercado, e é justamente o que se pode modelar.
O que o modelo GARCH faz
Os modelos ARCH e GARCH, criados nos anos 1980 por Robert Engle e Tim Bollerslev, descrevem a variância de amanhã como função do que já se observou. O GARCH(1,1) faz isso com três ingredientes:
O σ2t é a variância de hoje, ou seja, o risco que o modelo atribui ao pregão de hoje. Os outros três termos dizem de onde ela vem.
O ε2t−1 é o choque de ontem ao quadrado: o tamanho da surpresa do último pregão, sem sinal. Quanto maior o solavanco de ontem, maior o risco que o modelo projeta para hoje, e o coeficiente α mede a intensidade dessa reação.
O σ2t−1 é a variância de ontem, e o coeficiente β diz quanto dela se carrega para hoje. É esse termo que distingue o GARCH do ARCH: como a variância de ontem já continha a de anteontem, um único parâmetro resume toda a história passada, e o modelo consegue descrever meses de turbulência sem estimar dezenas de coeficientes.
O ω é a parcela fixa, a âncora que impede a variância de vagar sem rumo e faz com que ela sempre tenda a voltar para um nível de referência.
A soma α + β resume o comportamento do modelo. Quanto mais perto de 1, mais devagar o risco volta ao normal depois de um susto. Essa velocidade se traduz numa medida direta, a meia-vida, que conta em quantos pregões metade do choque se dissipa:
ln(0,5)
ln(α + β)
Com esses dois números, α + β e a meia-vida, já se sabe quanto tempo um susto de mercado contamina as decisões de risco. O exercício a seguir estima ambos para o Ibovespa.
O exercício: GARCH(1,1) para o Ibovespa
A série usada são os retornos diários do Ibovespa desde 2010, coletados da B3 direto pelo R. O gráfico abaixo compara a volatilidade estimada pelo modelo com a medida mais comum de mercado, o desvio-padrão de uma janela móvel de 22 pregões.
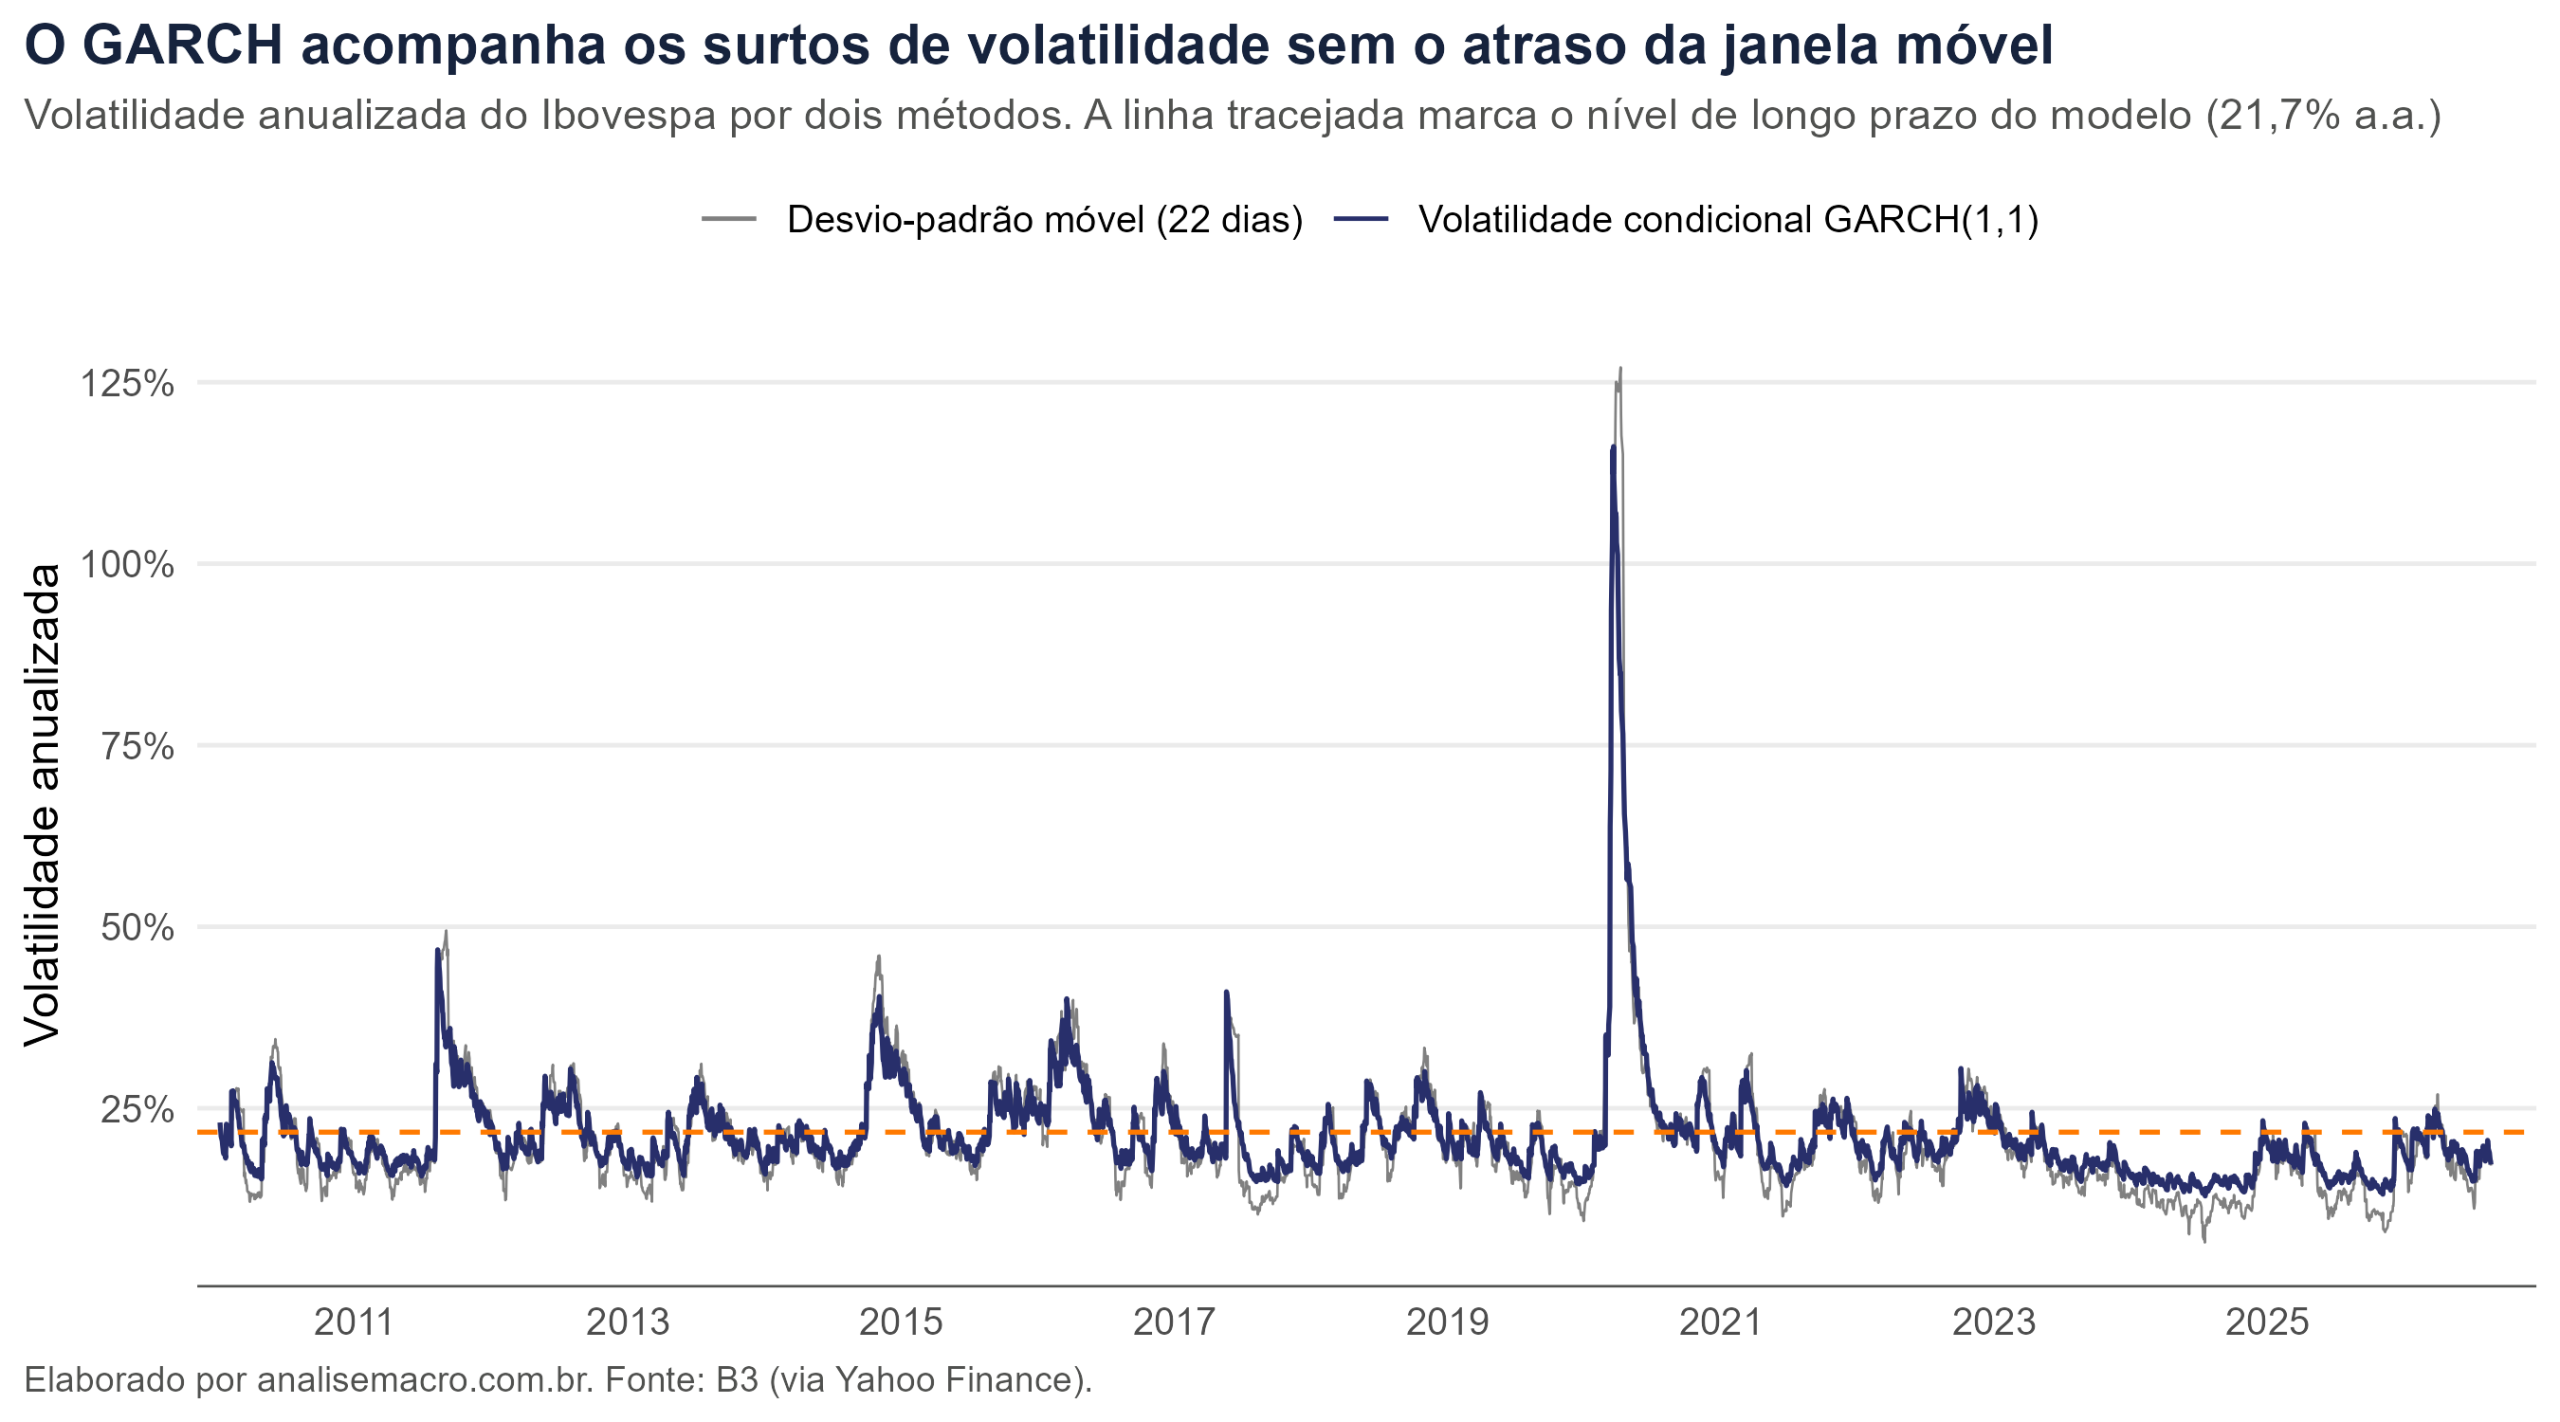
As duas linhas contam a mesma história, com uma diferença que aparece na hora de usar o número. A janela móvel reage com atraso e segura o susto por exatos 22 dias, mesmo depois de o mercado ter acalmado, porque o choque só deixa de contar quando sai da janela. O GARCH sobe no instante do choque e desce de forma suave, no ritmo que os próprios dados indicam.
Código do exercício
💡 Quer obter o código completo deste exercício, com o script em R pronto para rodar? Ele coleta a série do Ibovespa, calcula os log-retornos, roda os diagnósticos, estima o GARCH(1,1) e gera os cinco gráficos deste post. Obtenha em:
Os fatos estilizados nos dados do Ibovespa
Antes de estimar, o exercício verifica se as três regularidades aparecem mesmo na série brasileira. O agrupamento de volatilidade é visível a olho nu.
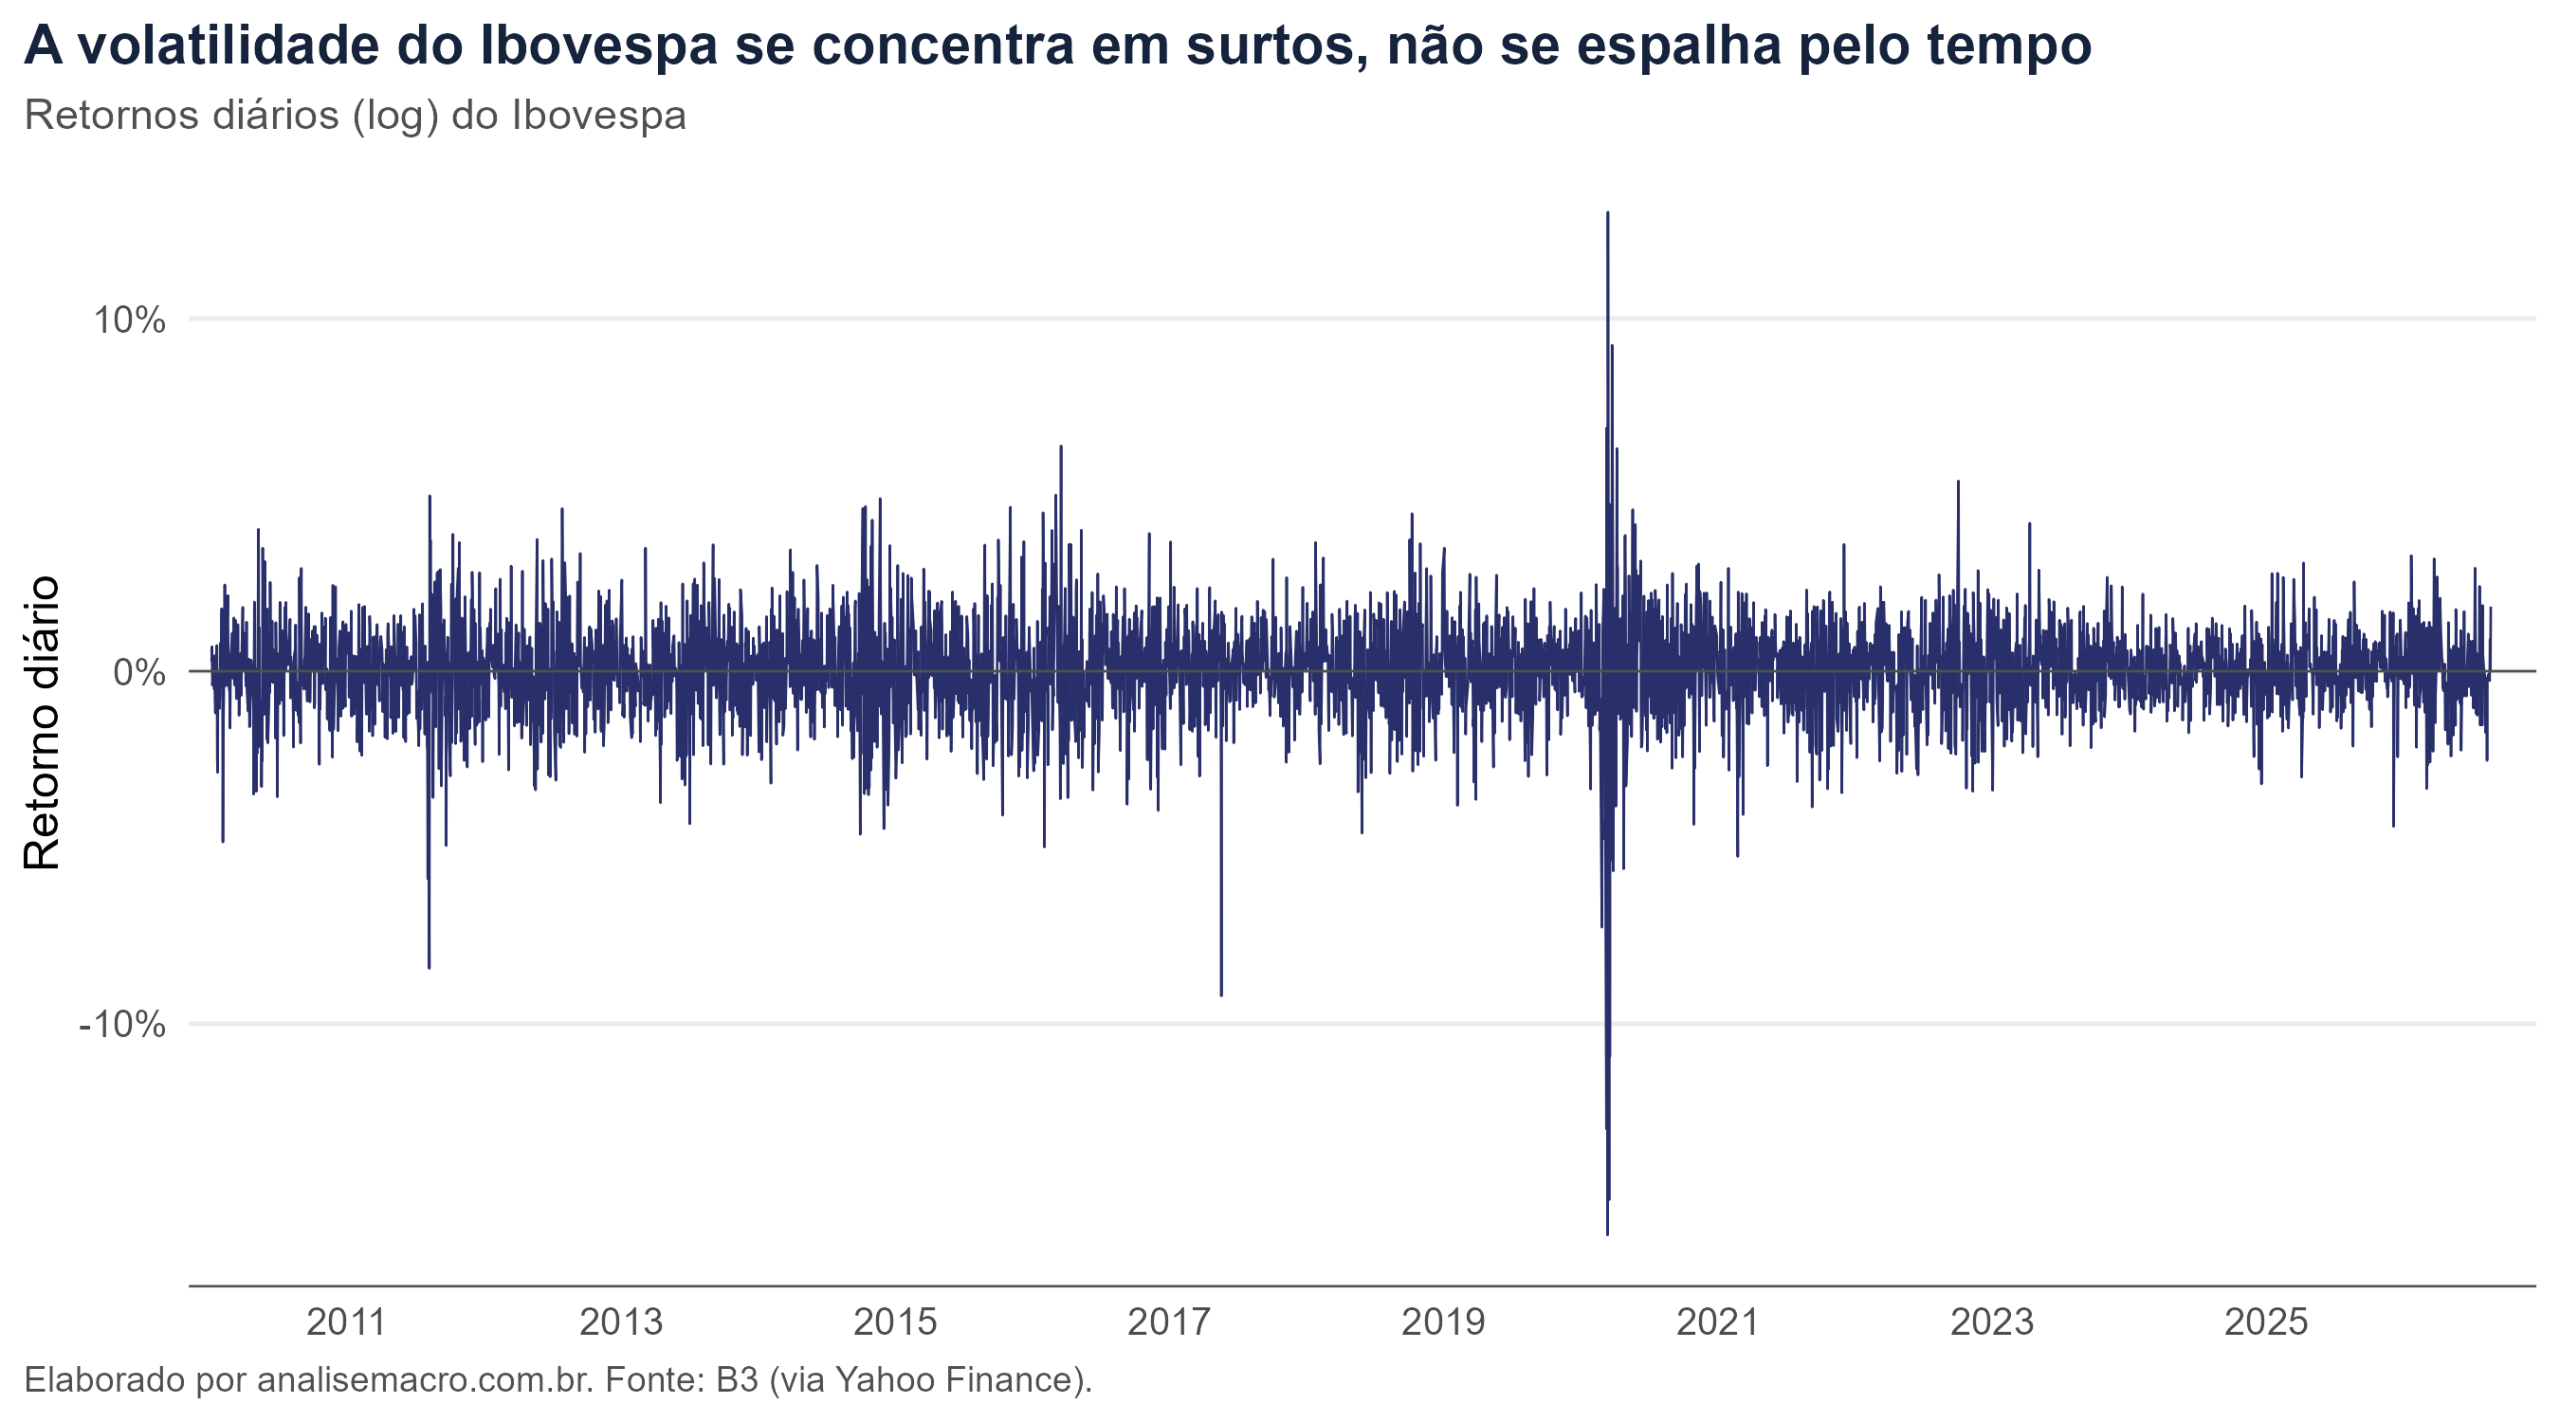
O pico de 2020 vem acompanhado de semanas inteiras de oscilações grandes em volta dele. É esse encadeamento, e não o evento extremo em si, que o modelo captura.
O segundo fato, as caudas pesadas, aparece no Q-Q plot, que compara os retornos observados com os que a distribuição normal preveria. Se os retornos fossem normais, os pontos ficariam todos sobre a linha tracejada.
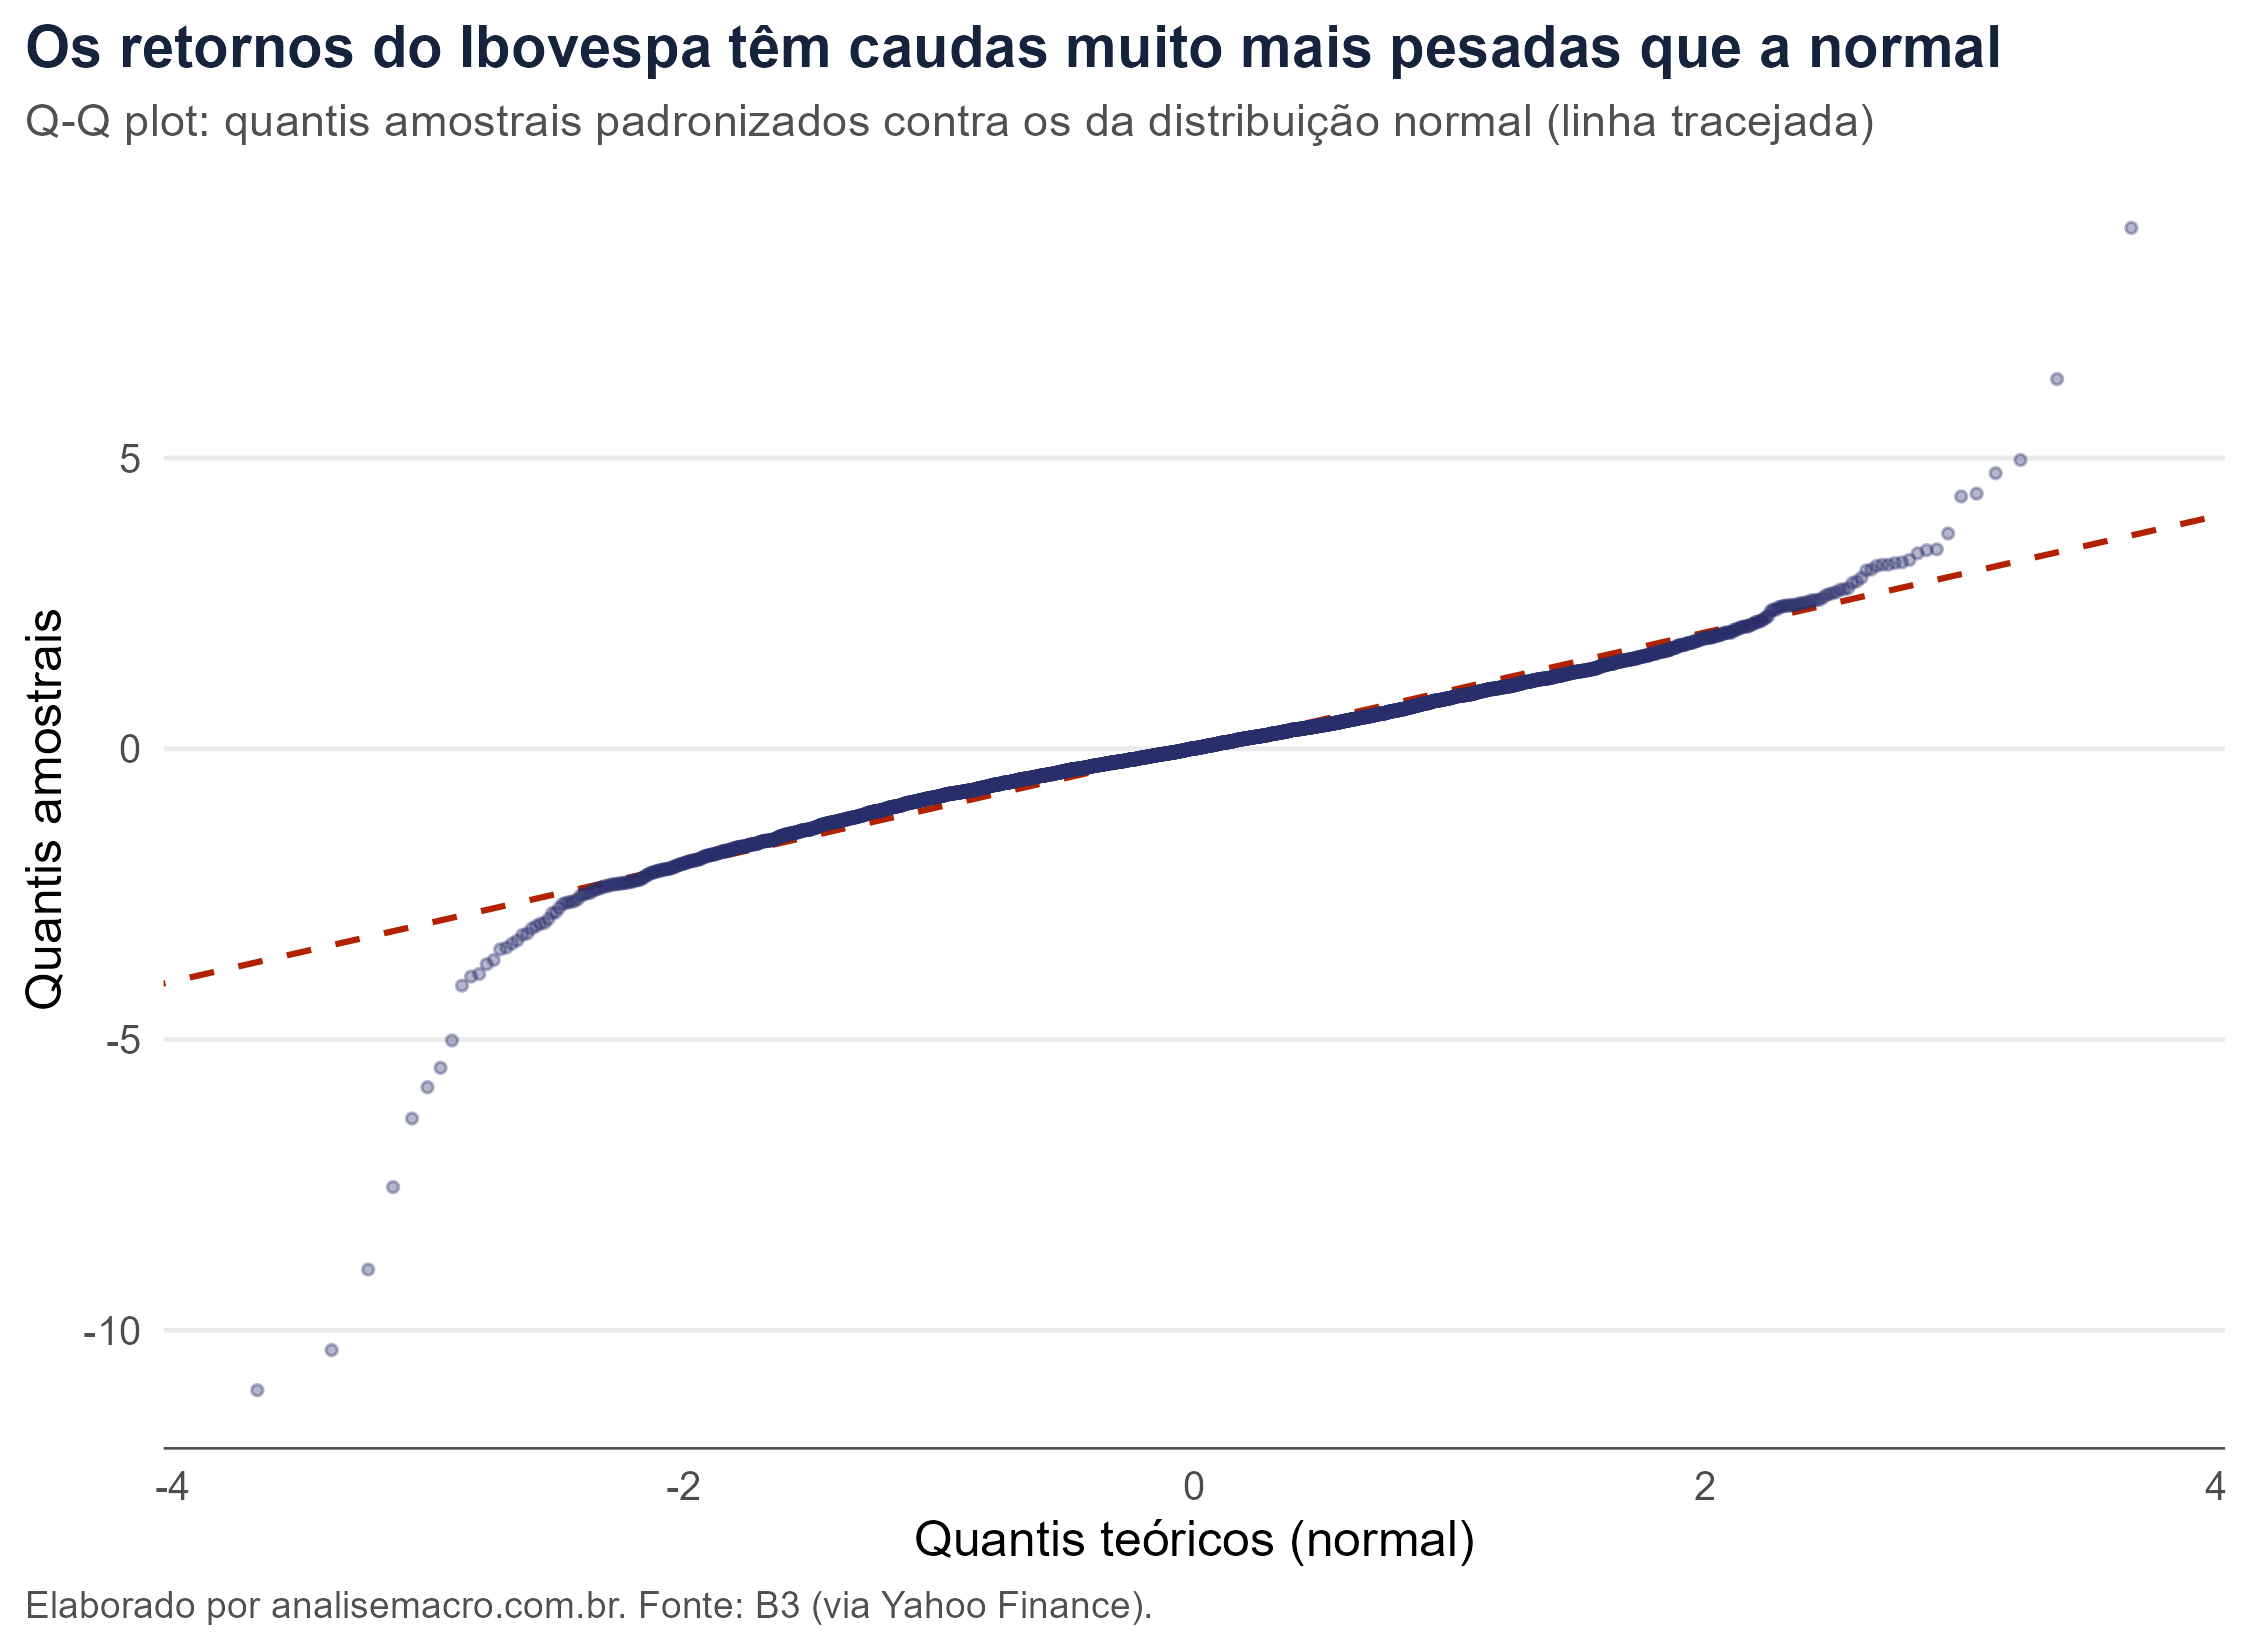
O afastamento nas pontas é grande: há pregões a mais de onze desvios-padrão da média, movimentos que sob a normal seriam praticamente impossíveis. Por isso a estimação usa a distribuição t de Student, cujas caudas mais grossas acomodam esses extremos.
O terceiro fato exige um teste. A função de autocorrelação mede o quanto o valor de hoje se relaciona com os dos dias anteriores, e o exercício a aplica a dois objetos: o retorno com sinal, que carrega a direção, e o retorno ao quadrado, que carrega só o tamanho.
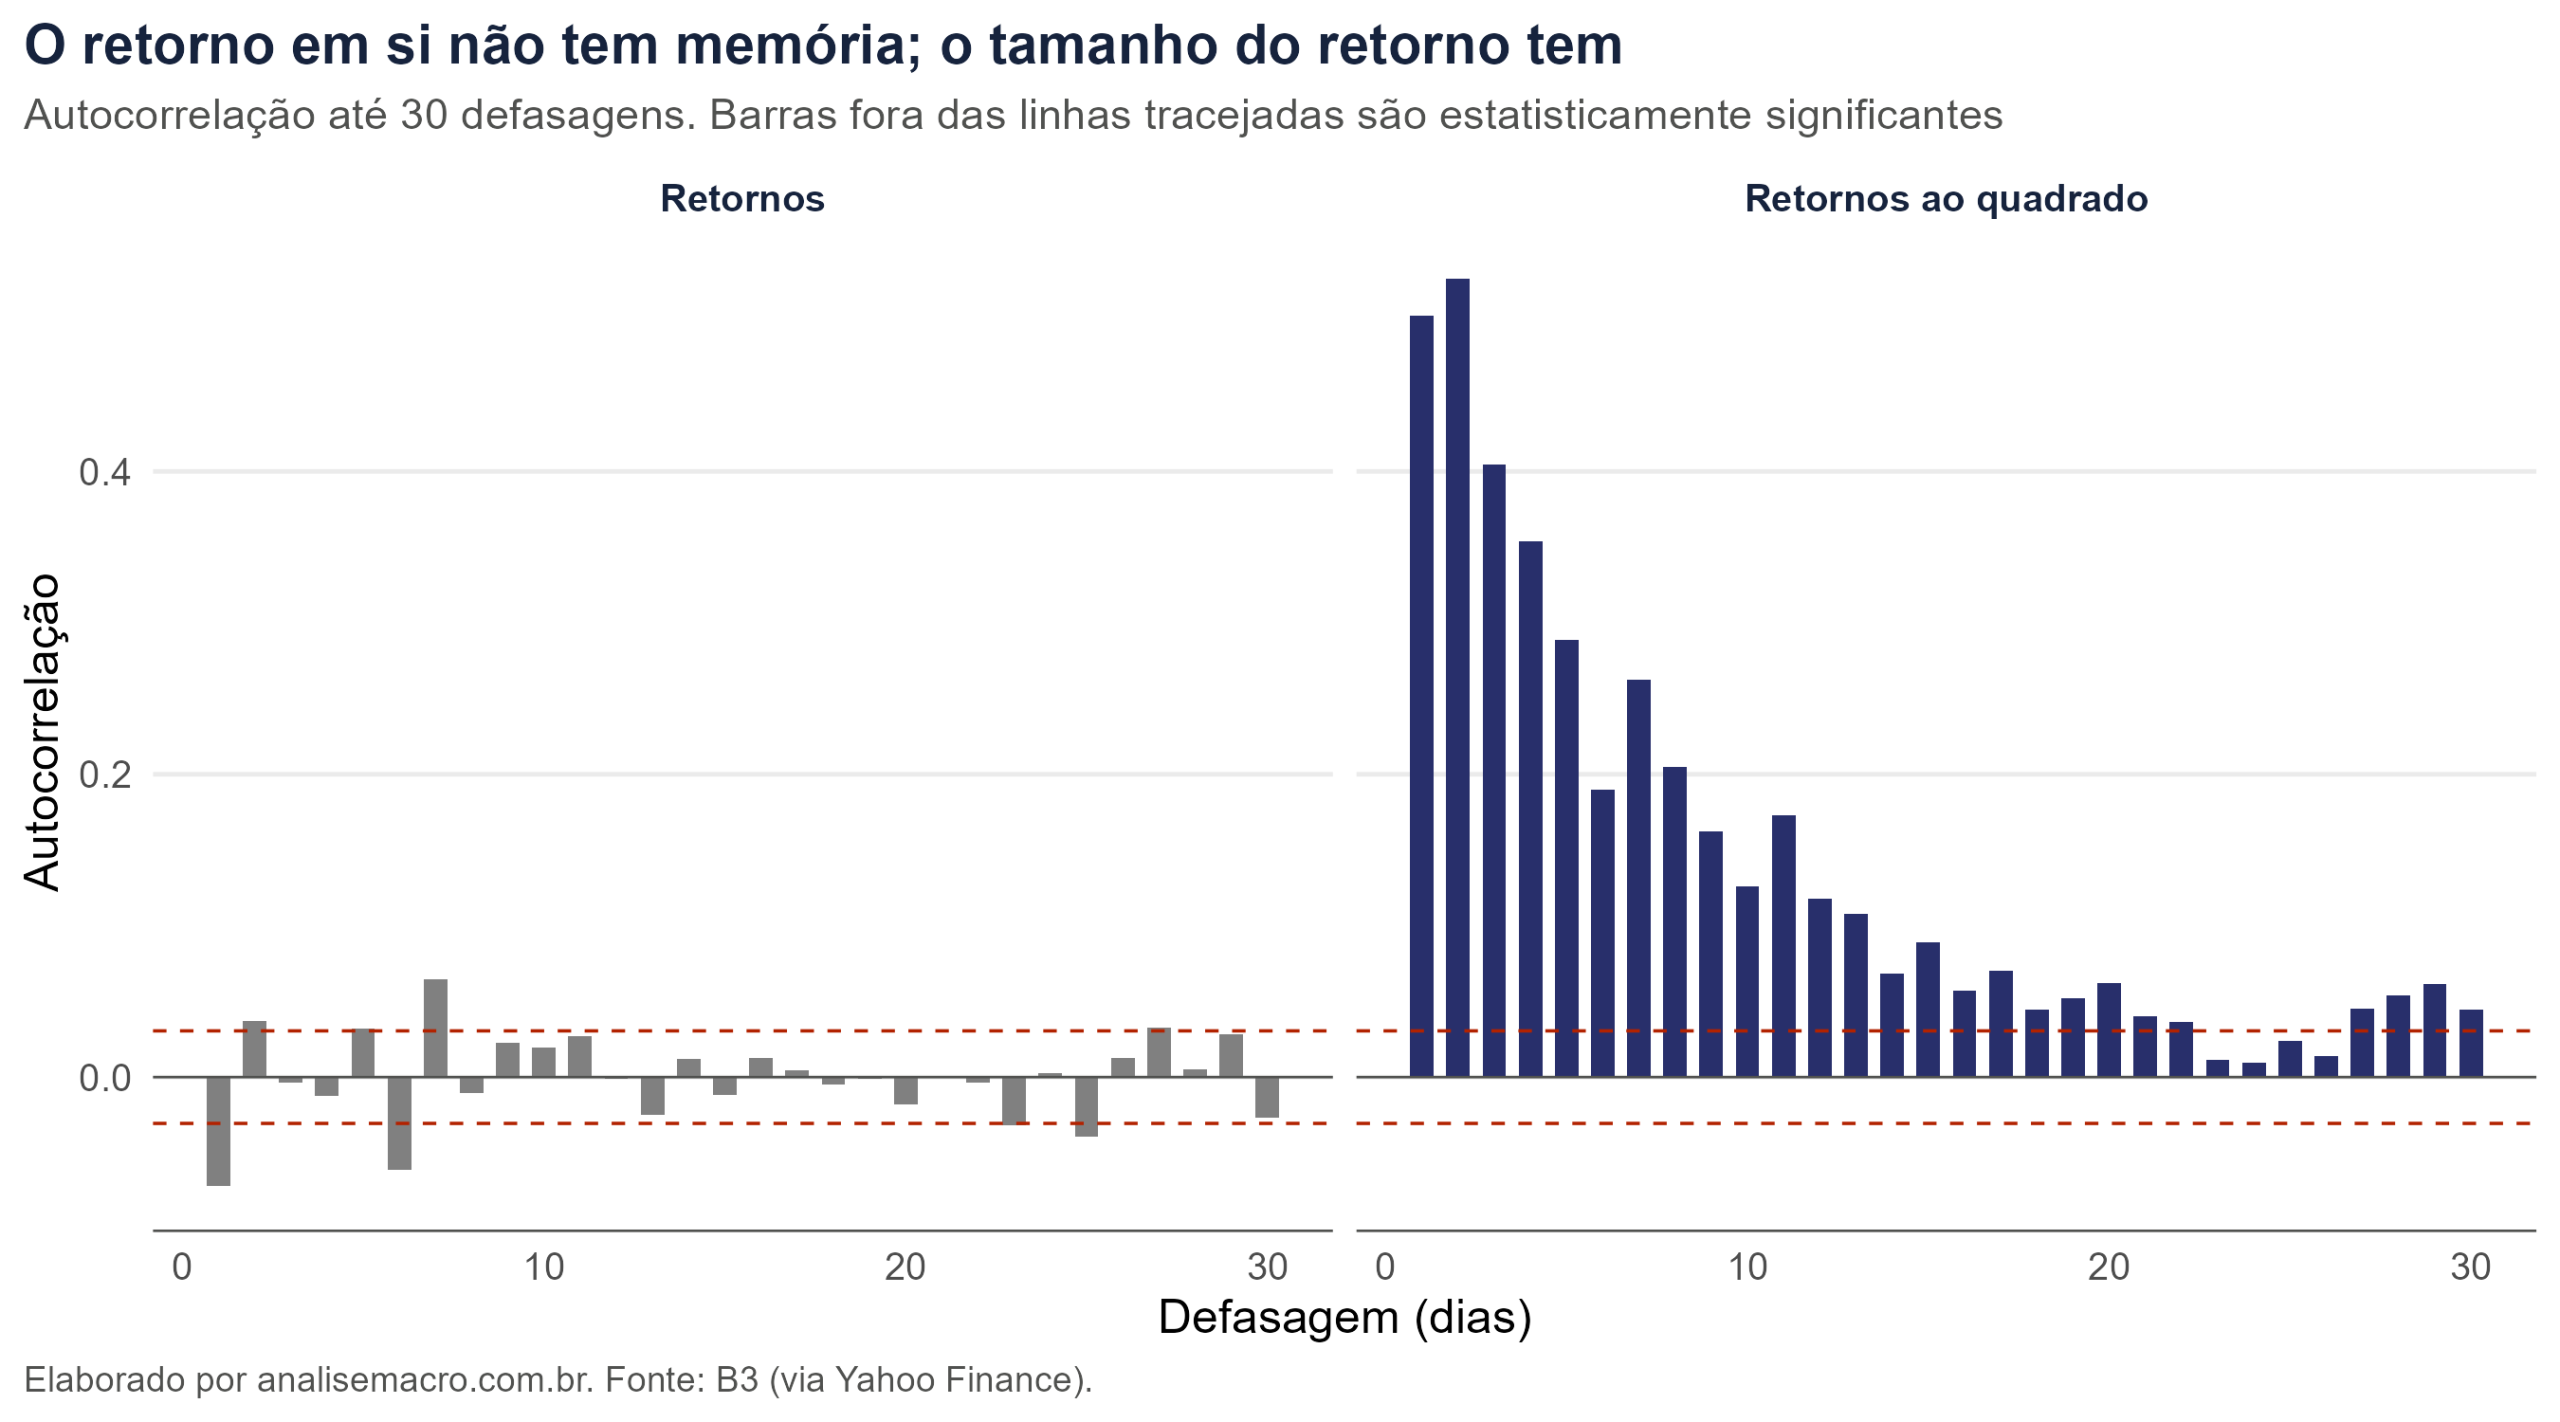
À esquerda, as barras dos retornos ficam quase todas dentro das bandas de significância: a direção do movimento de amanhã não é previsível pelo passado, o que se espera de um mercado minimamente eficiente.
À direita, as barras dos retornos ao quadrado são altas e demoram dezenas de dias para diminuir: o tamanho do movimento é bastante previsível. Não dá para saber se o mercado sobe ou cai amanhã, mas dá para estimar o quanto ele vai balançar, e é disso que o GARCH se alimenta.
O que os coeficientes estimados dizem
Estimado com o pacote rugarch, o modelo devolve os parâmetros da equação apresentada acima, todos estatisticamente significantes.
| Parâmetro | Estimativa | O que significa |
|---|---|---|
| α | 0,0624 | Reação: quanto um choque de ontem eleva o risco de hoje |
| β | 0,9175 | Persistência: quanto do risco de ontem se carrega para hoje |
| α + β | 0,9799 | Persistência total: quanto tempo um susto demora a passar |
| shape | 9,25 | Graus de liberdade da t de Student: quanto menor, mais pesadas as caudas |
Coeficientes do GARCH(1,1) estimado para os retornos diários do Ibovespa desde 2010. Fonte: B3, via Yahoo Finance.
O β de 0,9175 contra um α de 0,0624 mostra onde está o peso: o risco de hoje vem muito mais do nível de risco que já vinha se acumulando do que da surpresa de ontem. O choque isolado empurra pouco, mas o que ele empurra fica.
A soma dos dois dá 0,98. Aplicada à fórmula da meia-vida, essa persistência corresponde a 34 pregões, ou cerca de sete semanas, para que metade de um choque se dissipe.
Esse é o argumento prático a favor do modelo. Um susto de mercado não se resolve em poucos dias: ele contamina o mês e meio seguinte. Quem trata risco como constante não enxerga esse efeito.
Da volatilidade estimada ao peso da carteira
A volatilidade estimada vira decisão de alocação através do teorema da separação de Tobin. James Tobin mostrou em 1958 que a decisão de investimento se divide em duas partes independentes: primeiro se escolhe a melhor carteira de ativos arriscados, depois se decide quanto do patrimônio colocar nela, mantendo o restante no ativo livre de risco.
A segunda decisão tem uma consequência direta: se metade do patrimônio está num ativo que oscila 20% ao ano, a carteira inteira oscila 10%. A exposição funciona como um regulador do risco total.
O volatility targeting parte daí. Fixado um alvo de risco, o peso no ativo arriscado passa a ser o alvo dividido pela volatilidade estimada:
σalvo
σt
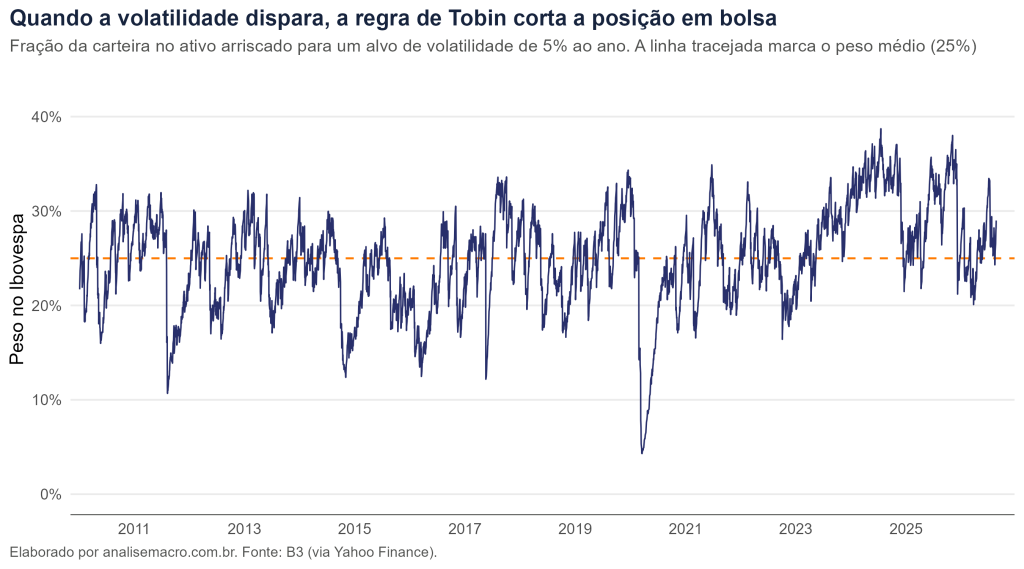
Como o GARCH atualiza a volatilidade σt todos os dias, o peso wt se atualiza sozinho. Com um alvo de 5% ao ano aplicado ao Ibovespa, o peso médio ao longo do período fica em torno de 25%.
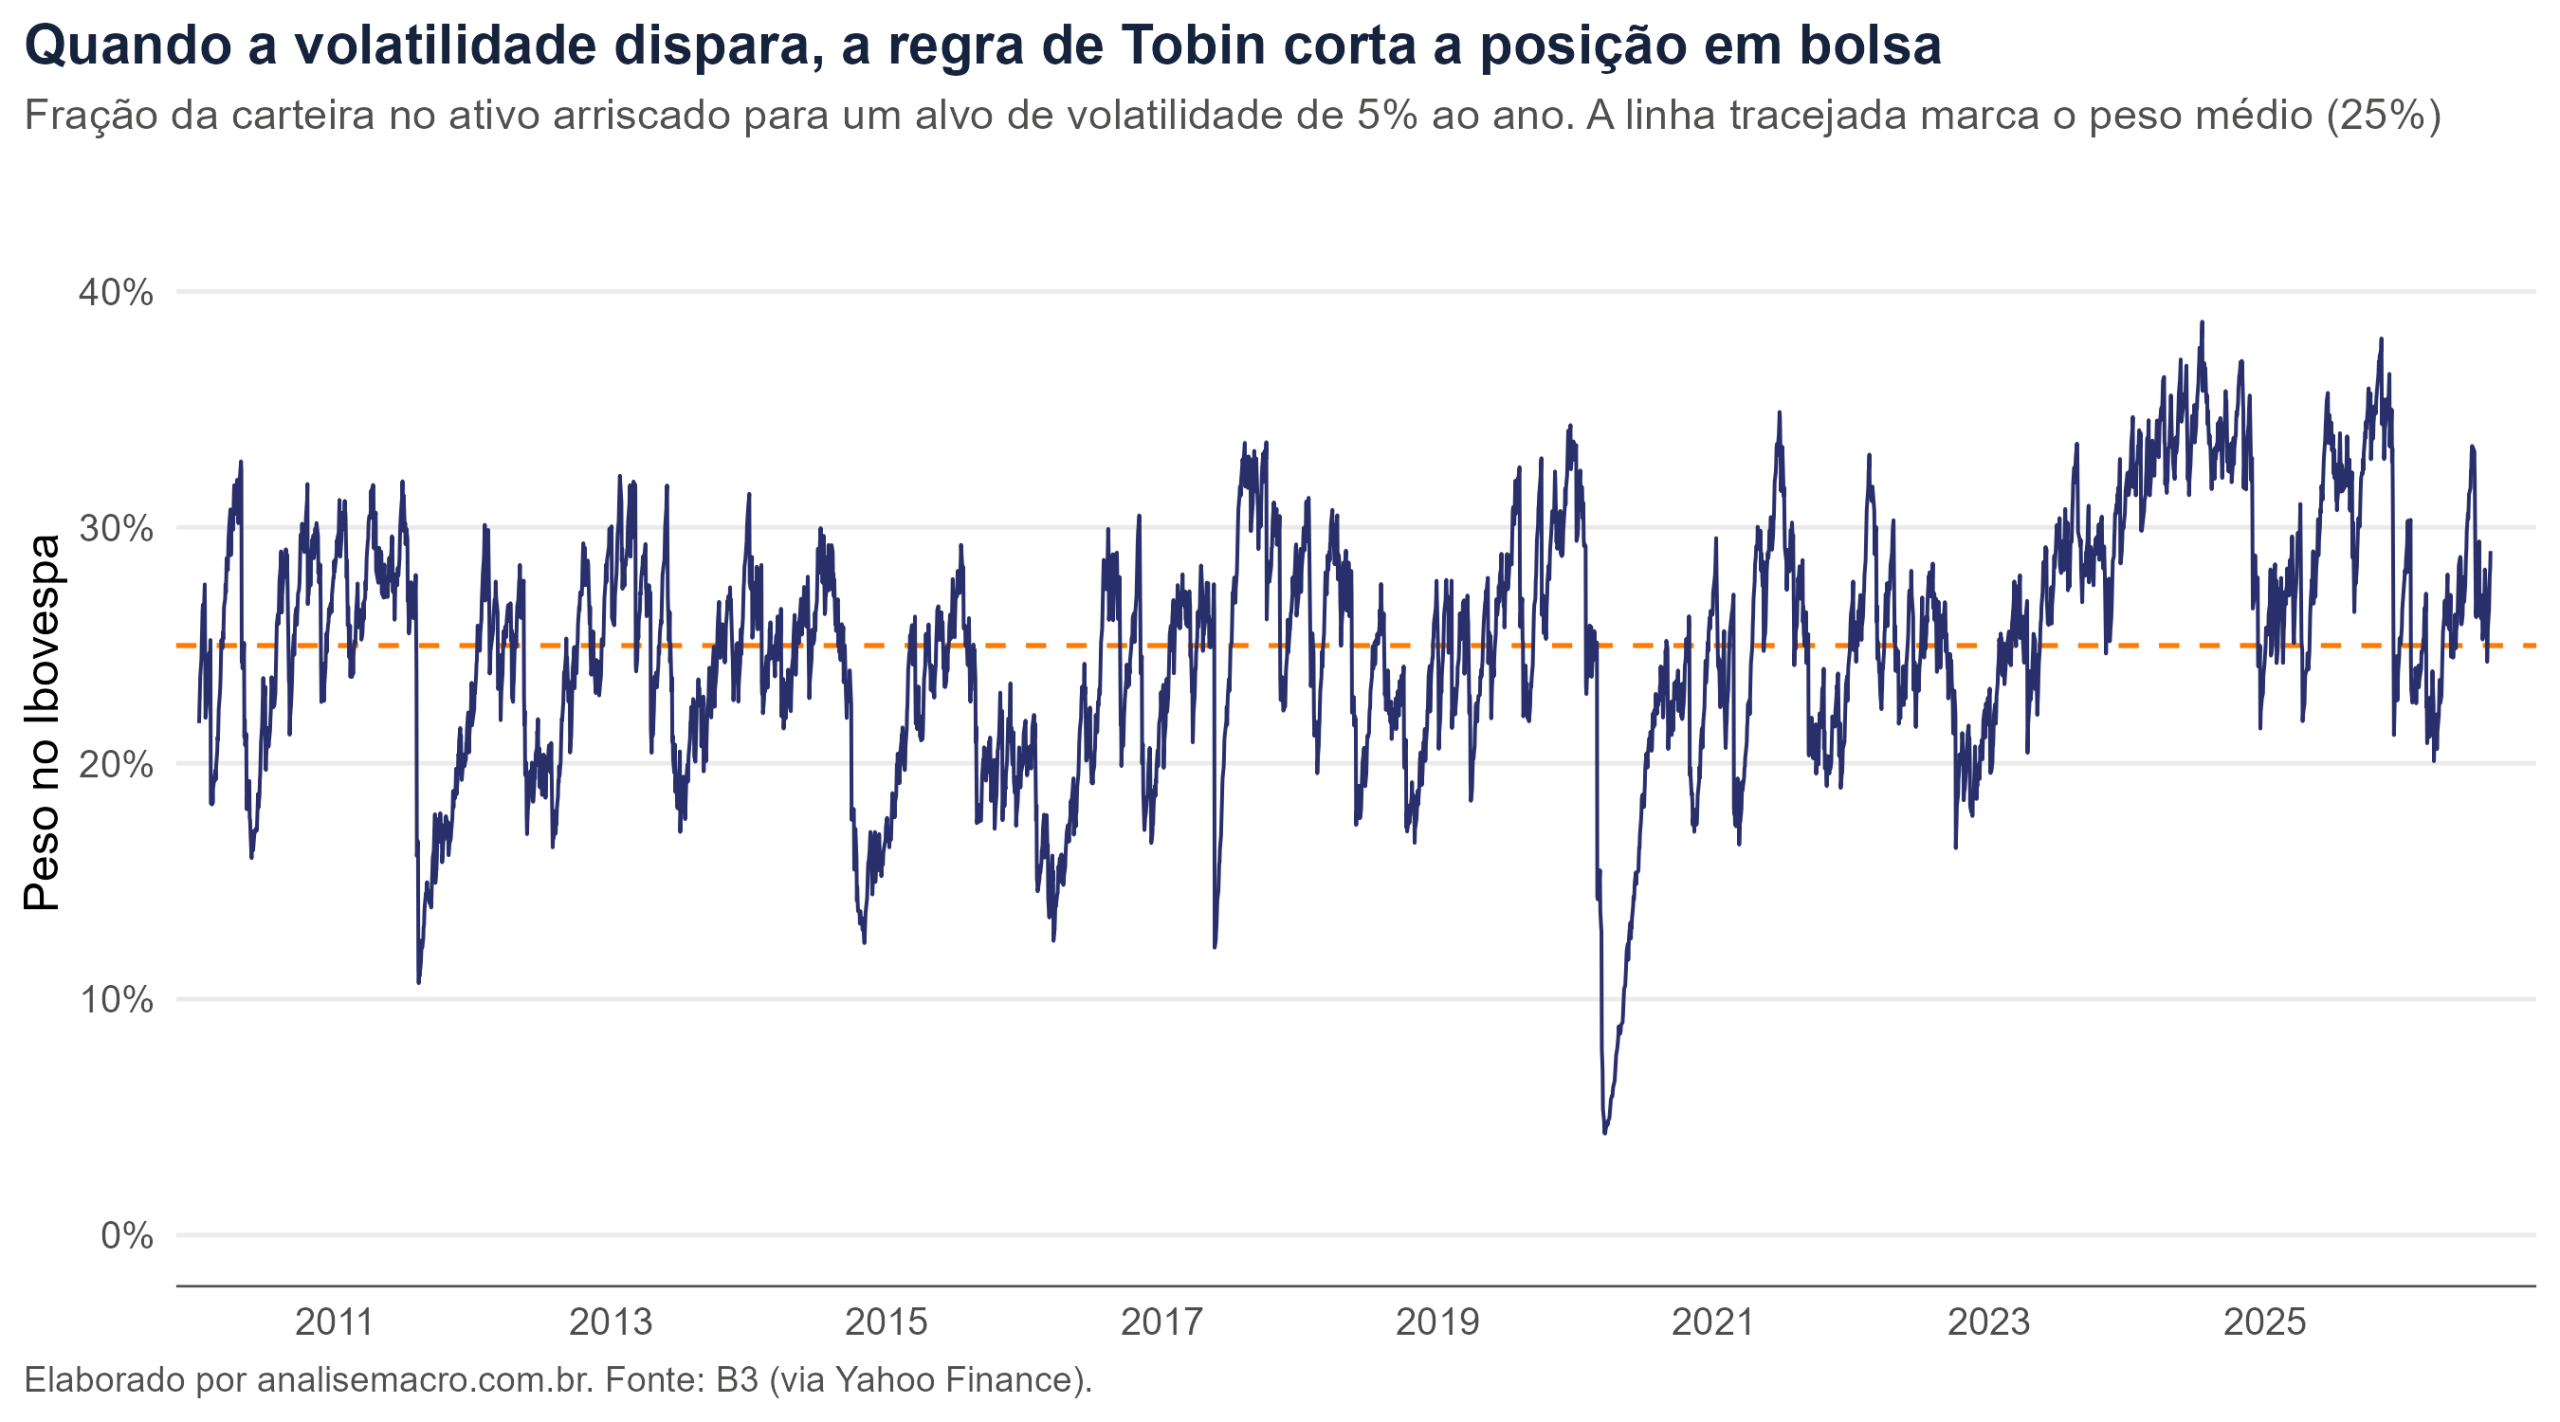
No auge da crise de 2020, quando a volatilidade do Ibovespa superou 100% ao ano, a regra derruba a exposição para 4,3%. A volatilidade quadruplicou, então a posição caiu para um quarto, e o risco total da carteira permaneceu no alvo escolhido.
A regra opera sem nenhuma opinião sobre a direção do mercado: ela responde apenas ao risco medido, subindo a exposição quando o mercado acalma e cortando quando ele agita.
Da volatilidade prevista para a alocação futura
O modelo também projeta a volatilidade dos próximos pregões, e a mesma regra de Tobin se aplica à volatilidade prevista. A pergunta prática passa a ser: dado o que o modelo projeta, quanto deveria estar alocado em bolsa daqui a um mês?
Com a volatilidade corrente abaixo da média histórica, o modelo projeta alta gradual do risco, e a alocação recua de 27,4% no dia seguinte para 25,8% em vinte pregões. Estendendo o horizonte para 120 pregões, a curva revela até onde a previsão do modelo vai.
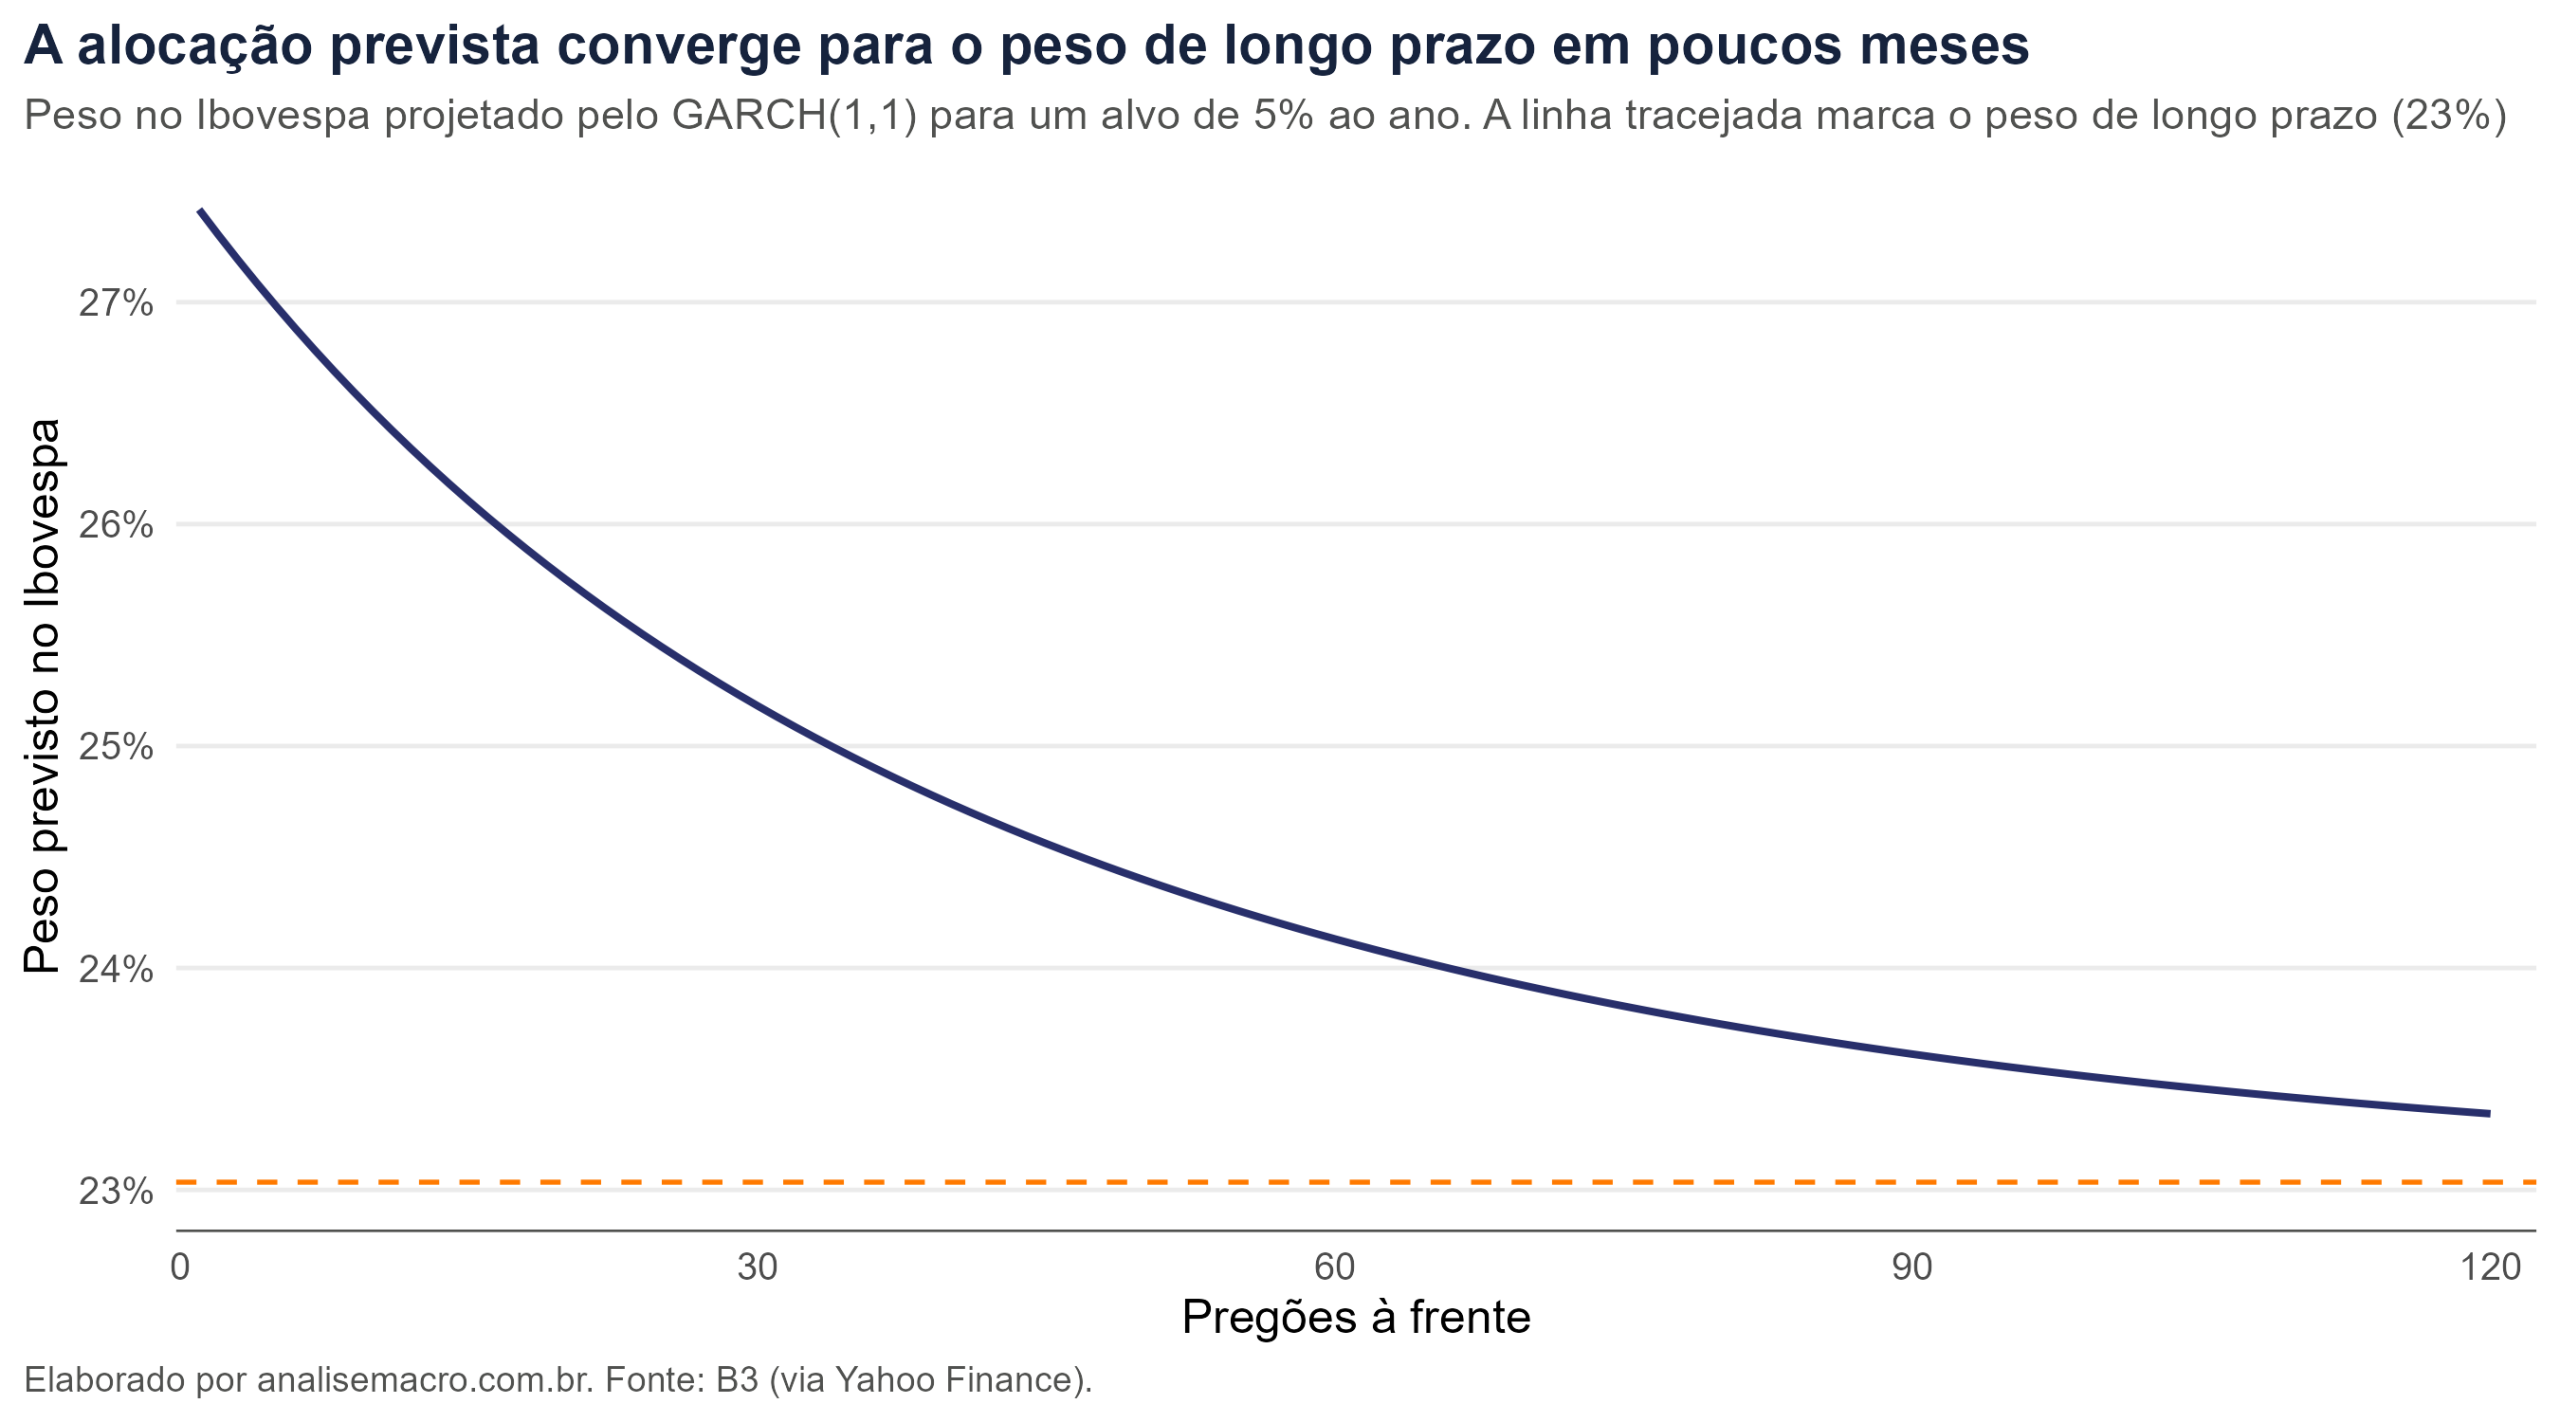
A alocação prevista converge para o peso de longo prazo, de 23%, e para por ali. Depois de dois ou três meses, o modelo devolve sempre o mesmo número, que é o que se obteria sem modelo nenhum, usando apenas a volatilidade histórica.
A previsão carrega informação nova no curto prazo, e não no longo. A meia-vida de 34 pregões é exatamente o que governa essa velocidade de convergência: quanto mais persistente a volatilidade, mais tempo a previsão leva para perder relevância.
Onde os modelos de volatilidade são usados
O mesmo caminho, estimar a volatilidade condicional e transformá-la em decisão, aparece em contextos diferentes do exemplo da carteira.
- Cálculo de VaR e testes de estresse. O Valor em Risco depende de uma estimativa de volatilidade. Usar a condicional em vez do desvio-padrão fixo faz o limite de perda acompanhar o regime de mercado, em vez de subestimar o risco em crise.
- Dimensionamento de posição. Mesas de operação ajustam o tamanho das posições ao risco corrente, e não ao risco médio dos últimos anos.
- Precificação de opções. A volatilidade é o principal parâmetro de um modelo de apreçamento. Comparar a estimada pelo GARCH com a implícita no preço de mercado indica se a opção está cara ou barata.
- Pesquisa macroeconômica. A volatilidade condicional mede a reação da incerteza dos mercados a choques e a decisões de política monetária.
As ferramentas por trás

- quantmod: coleta o histórico de preços de ativos e índices direto do provedor de dados de mercado.
- rugarch: estima a família de modelos GARCH, calcula a persistência e projeta a volatilidade à frente.
- PerformanceAnalytics: converte preços em retornos e oferece as métricas usuais de risco.
- ggplot2: constrói os gráficos, aqui no padrão visual da Análise Macro.
Considerações finais
A volatilidade muda de regime, e medi-la com um número fixo esconde exatamente a informação que interessa a quem dimensiona risco. O exercício com o Ibovespa mostra três coisas que valem além dele.
O risco tem memória longa. Com persistência de 0,98, um choque no Ibovespa leva 34 pregões para perder metade da força. Quem redimensiona a carteira poucos dias depois de uma queda ainda está operando em regime de turbulência.
A janela móvel responde mal nas duas pontas. Ela demora a reconhecer o choque e depois o mantém por exatos 22 dias, mesmo com o mercado já calmo, porque o corte por calendário não corresponde ao comportamento do dado.
A volatilidade estimada vira decisão. A mesma série que descreve o passado alimenta uma regra de alocação que dispensa qualquer previsão sobre a direção do mercado.
Quanto às limitações: o GARCH(1,1) trata altas e quedas de mesma magnitude como choques equivalentes, embora quedas costumem elevar mais a volatilidade que altas do mesmo tamanho, o chamado efeito alavanca. Variantes como o EGARCH e o GJR-GARCH acrescentam essa assimetria. Os conceitos de base estão em volatilidade de ativos financeiros e fatos estilizados.
Quer aprender a construir análises como esta?
Coletar dados de mercado, tratar séries, estimar modelos e produzir gráficos como os deste post são exatamente as etapas cobertas na formação em R da Análise Macro, pensada para quem começa sem pré-requisito. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Leia também:
Referências: Bollerslev, T. (1986). Generalized autoregressive conditional heteroskedasticity. Journal of Econometrics, 31(3), 307–327. · Engle, R. F. (1982). Autoregressive conditional heteroscedasticity with estimates of the variance of United Kingdom inflation. Econometrica, 50(4), 987–1007. · Tobin, J. (1958). Liquidity preference as behavior towards risk. The Review of Economic Studies, 25(2), 65–86.