A decomposição da variância no VAR mede quanto do erro de previsão de uma variável vem de cada tipo de choque da economia. Com ela, podemos responder a uma pergunta que interessa a quem acompanha juros: quando a inflação surpreende, quanto disso vira incerteza sobre a Selic?
Pense em uma guerra do outro lado do Atlântico, em uma região produtora de energia. O barril de petróleo dispara e, com alguma defasagem, sobem também a gasolina, o frete e outros preços da cesta do IPCA. Com surpresas inflacionárias e mais risco no cenário, o Banco Central tem mais trabalho para decidir a taxa de juros, e os economistas tendem a errar mais sobre a trajetória futura da Selic.
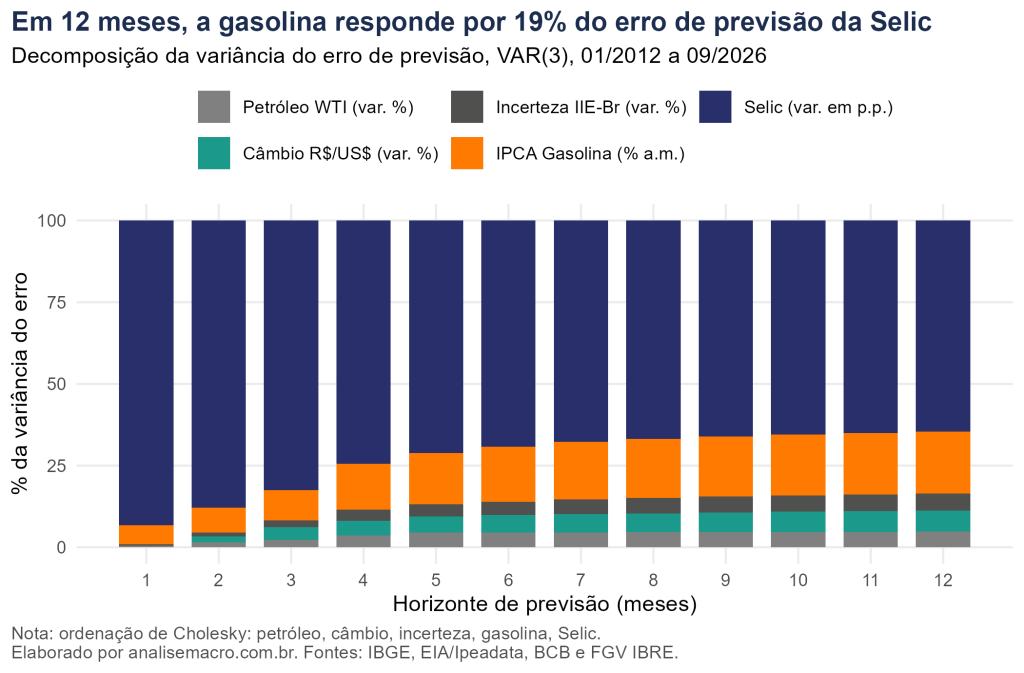
Neste exercício, medimos essa relação com um modelo VAR estimado em R com dados mensais brasileiros de 2012 a 2026. No nosso exemplo, os choques na inflação da gasolina respondem por 5,7% do erro de previsão da Selic um mês à frente e por 19% em doze meses.
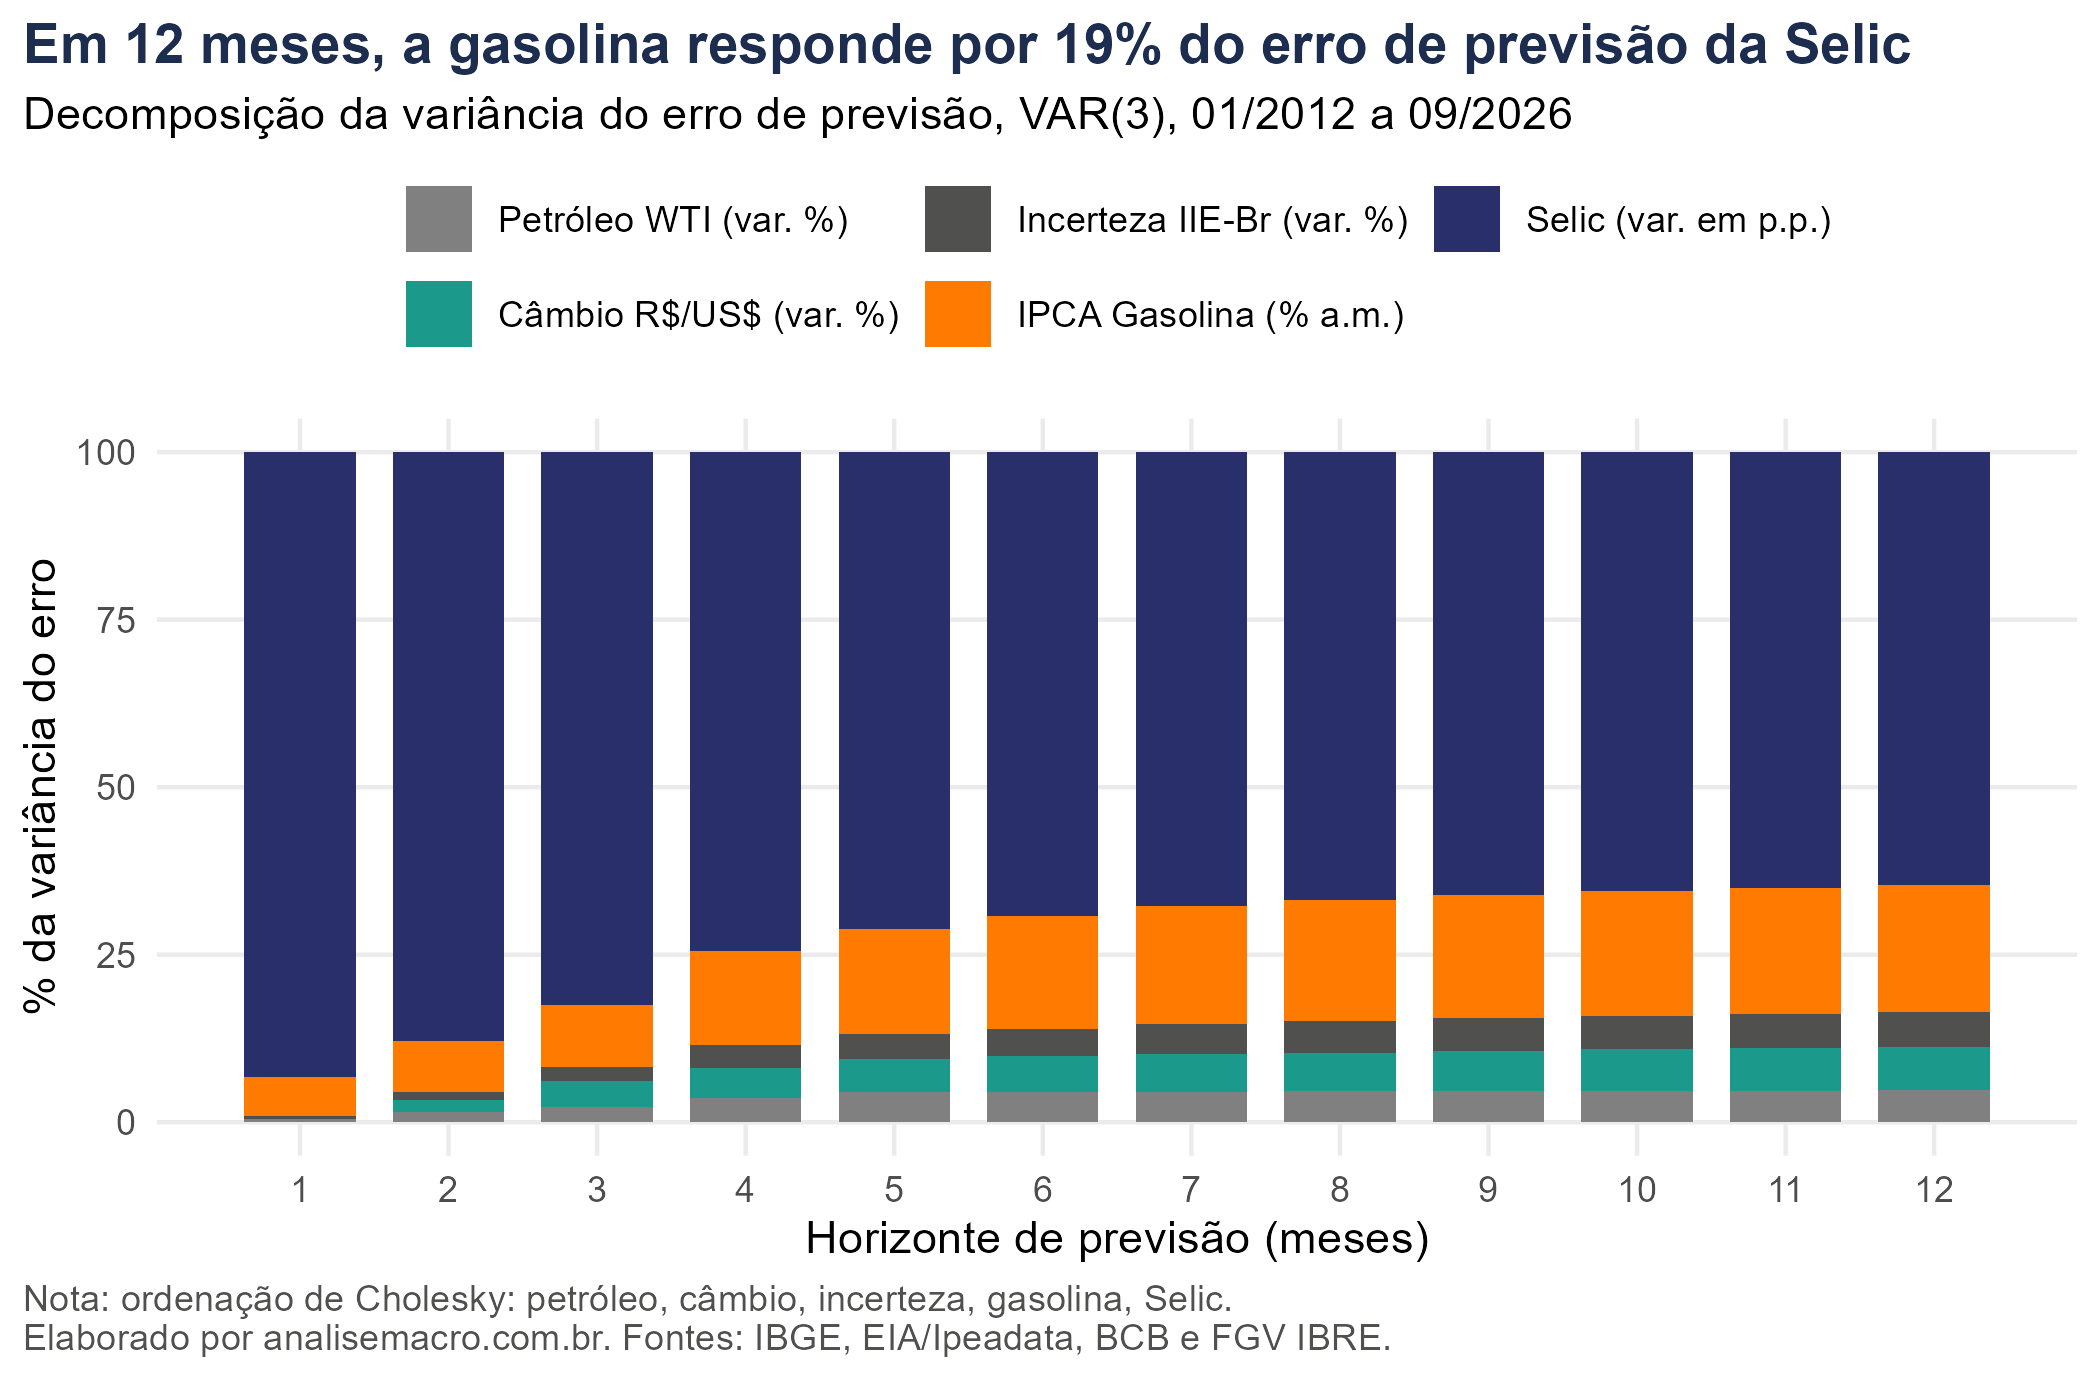
Cada barra da figura é um horizonte de previsão, e cada cor é a fatia do erro atribuída a um choque. No primeiro mês, 93% do erro vem da própria Selic. Em doze meses, essa fatia cai para 65%, e a gasolina passa a ocupar quase um quinto da barra.
📩 Boletim AM
Receba análises e conteúdos sobre modelos estatísticos clássicos, econometria feita com hipóteses sérias e LLMs acessados em ambientes de trabalho reais, tudo aplicado à economia, ao mercado financeiro e à análise de dados.
O que é um modelo VAR
Um VAR, ou vetor autorregressivo, é um sistema de equações em que cada variável é explicada pelo seu próprio passado e pelo passado das demais. Ele acomoda o fato de que câmbio afeta inflação, inflação afeta juros e juros afetam câmbio, sem impor de antemão quem causa quem.
Com p defasagens, o modelo se escreve assim:
Aqui yt reúne as variáveis do sistema no mês t, c é um vetor de constantes, cada Ai é uma matriz de coeficientes e ut é o erro de previsão um mês à frente.
Em palavras: o valor de cada variável hoje é uma combinação dos valores de todas elas nos últimos p meses, mais uma surpresa que o passado não previa. Aprofundamos a estimação e a previsão com esse modelo em Vetor Autorregressivo [Aplicações em R e Python].
No nosso exemplo, o sistema tem cinco variáveis mensais:
- Petróleo WTI: variação percentual do barril em dólares, a referência internacional dos combustíveis;
- Câmbio: variação percentual do R$/US$, que converte o preço internacional para reais;
- Incerteza: variação percentual do Indicador de Incerteza da Economia Brasil (IIE-Br), que mede quanto a incerteza aparece na imprensa e na dispersão das previsões dos analistas;
- Gasolina: inflação mensal do subitem gasolina no IPCA;
- Selic: variação mensal da taxa anualizada, em pontos percentuais.
O que a decomposição da variância mede
A decomposição da variância dos erros de previsão, conhecida pela sigla em inglês FEVD, responde a uma pergunta: em um horizonte de h meses, que parcela da incerteza sobre uma variável se deve a cada choque do sistema?
Para chegar a ela, o VAR é reescrito como uma soma de choques passados. Cada choque estrutural ε é atribuído a uma variável, e os coeficientes θ dizem quanto um choque ocorrido s meses atrás ainda move cada variável hoje. A fatia do choque j no erro de previsão da variável k é:
O numerador soma o efeito ao quadrado do choque j sobre a variável k em todos os meses até o horizonte. O denominador soma o mesmo para os K choques do sistema. Ou seja, as fatias de todos os choques somam 100% em cada horizonte.
A decomposição é a irmã da função impulso-resposta. A impulso-resposta mostra o caminho de uma variável depois de um choque; a decomposição mostra quanto esse choque pesa na incerteza total sobre ela. Um exemplo de impulso-resposta com dados brasileiros está em Em quanto um choque cambial afeta a inflação? Analisando funções impulso-resposta no VAR.
A ordenação de Cholesky
Os erros do VAR são correlacionados: no mês em que o câmbio surpreende, a gasolina também tende a surpreender. Para separar os choques, usamos a decomposição de Cholesky, que impõe uma ordem de reação dentro do mês. A primeira variável só responde a si mesma no mês; a segunda responde à primeira; e assim por diante.
A ordem que adotamos segue a formação de preços:
A ordem é uma hipótese de identificação, e por isso a testamos mais adiante com duas alternativas.
Como o exercício foi construído
O caminho tem cinco etapas, e cada uma corresponde a uma decisão que muda o resultado final.
Coletar as séries. A inflação da gasolina vem do SIDRA, o sistema de tabelas do IBGE; o petróleo WTI, do Ipeadata; o câmbio e a Selic, do SGS do Banco Central; o IIE-Br, da planilha que a FGV IBRE publica a cada divulgação. No R, os pacotes sidrar, ipeadatar e rbcb trazem cada série com uma chamada.
Para a Selic, usamos a taxa acumulada no mês e anualizada na base de 252 dias úteis. Essa versão fica na mesma escala da meta do Copom, enquanto a taxa em % ao mês oscila com o número de dias úteis de cada mês, e esse vaivém de calendário entraria no modelo como movimento de juros.
Testar a estacionariedade. Uma série estacionária oscila em torno de uma média estável. O VAR precisa dessa propriedade; sem ela, as regressões podem apontar relações que não existem. Aplicamos três testes que partem de hipóteses opostas: ADF e Phillips-Perron, que supõem raiz unitária, e KPSS, que supõe estacionariedade. Explicamos esses testes em Estacionariedade de Séries Temporais [R e Python].
Escolher as defasagens. Poucas defasagens deixam dinâmica de fora; defasagens demais gastam graus de liberdade, porque cada uma acrescenta 25 coeficientes ao sistema. Partimos do número indicado pelo critério de Akaike (AIC) e acrescentamos defasagens até que os testes de autocorrelação dos resíduos deixassem de rejeitar.
Diagnosticar os resíduos. Conferimos a estabilidade do sistema, a ausência de autocorrelação, a normalidade e a homocedasticidade. É esse diagnóstico que diz se a decomposição pode ser lida e com que cuidado.
Calcular a decomposição com intervalo de confiança. A estimativa pontual vem acompanhada de um intervalo construído por bootstrap, que simula muitas amostras alternativas a partir do próprio modelo. A ideia do bootstrap é apresentada em Usando Bagging e Bootstrap no R.
O exemplo: gasolina e Selic de 2012 a 2026
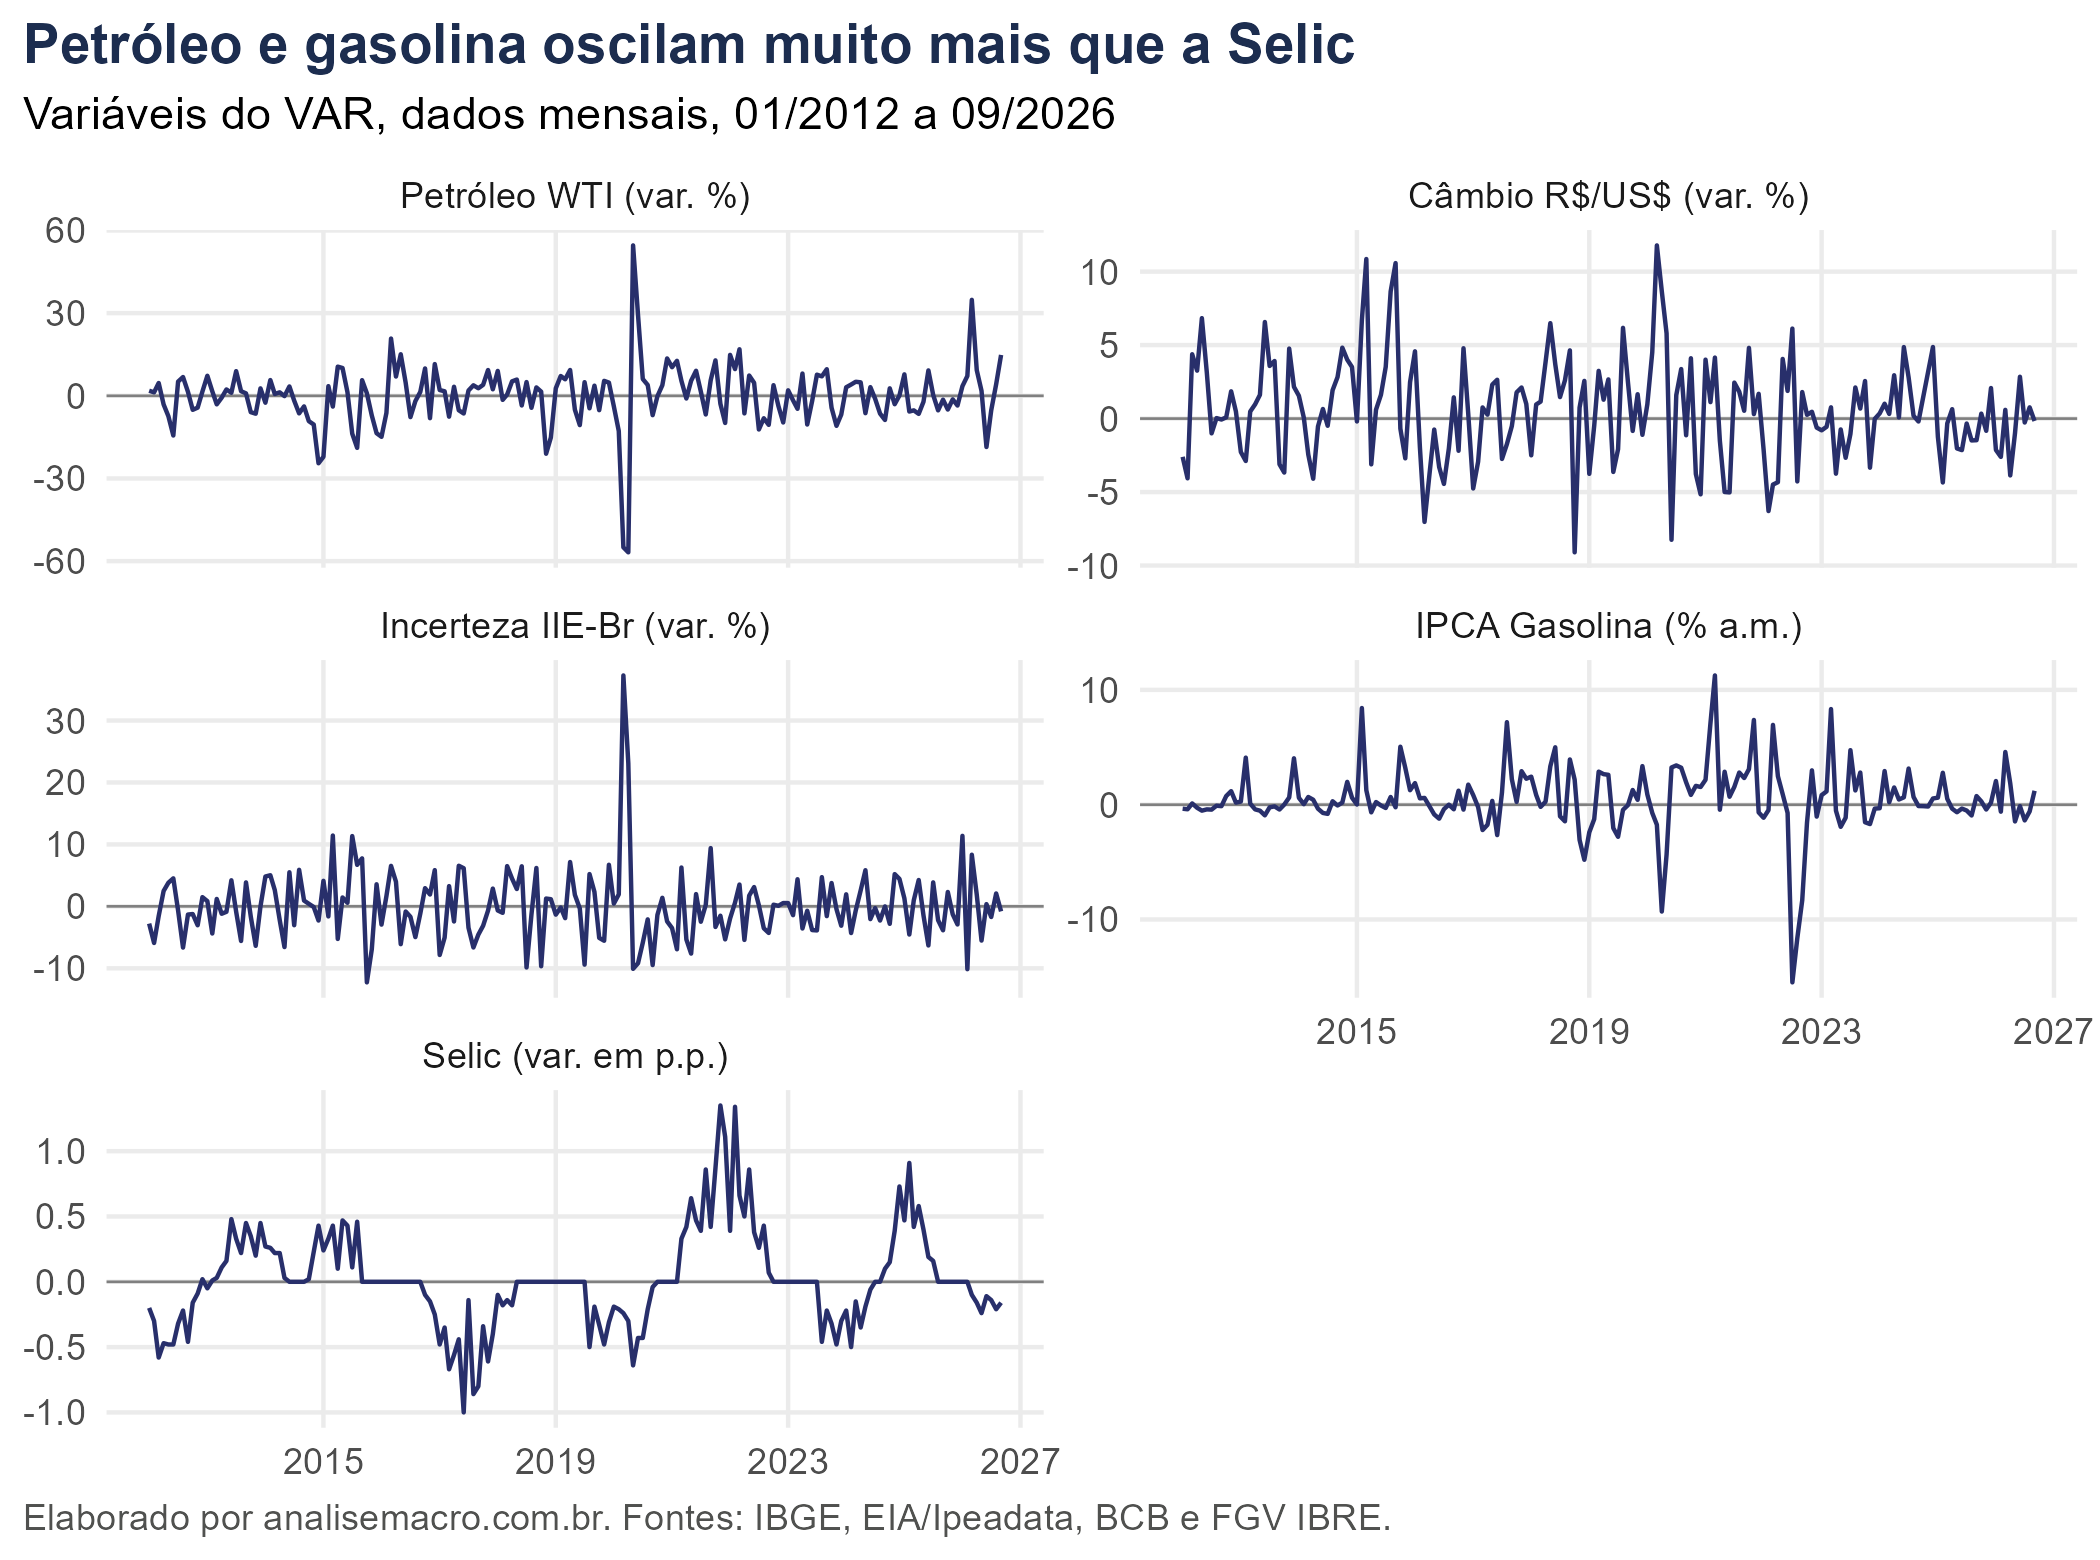
As cinco séries oscilam em torno do zero, sem tendência visível. A gasolina tem picos de vários pontos percentuais em um único mês, ligados aos reajustes nas refinarias. A Selic se move em passos pequenos e na mesma direção por vários meses, o retrato de um Copom que conduz os ciclos de forma gradual.
Os testes confirmam o que o gráfico sugere: pela maioria dos seis resultados de cada série, todas entram no VAR sem nova diferença. Na escolha das defasagens, o AIC indicou duas, mas com duas o teste Portmanteau ainda acusava autocorrelação nos resíduos. Com três defasagens, os dois testes deixaram de rejeitar, e o modelo final é um VAR(3).
| Diagnóstico do VAR(3) | Resultado | Leitura |
|---|---|---|
| Maior raiz (módulo) | 0,94 | Sistema estável |
| Portmanteau (16 defasagens) | p-valor 0,26 | Sem autocorrelação |
| LM Breusch-Godfrey (12 defasagens) | p-valor 0,11 | Sem autocorrelação |
| OLS-CUSUM (maior desvio) | 1,02 (crítico 1,36) | Coeficientes estáveis |
| Jarque-Bera multivariado | p-valor < 0,001 | Caudas pesadas |
| ARCH multivariado (5 defasagens) | p-valor < 0,001 | Variância muda no tempo |
Diagnóstico dos resíduos do VAR(3), dados mensais de 01/2012 a 09/2026.
As duas últimas linhas da tabela são comuns em dados macroeconômicos mensais. A amostra inclui a pandemia, reajustes bruscos de combustíveis e ciclos de juros de vários pontos, e esses meses produzem resíduos muito maiores que os demais.
Caudas pesadas e variância que muda no tempo preservam os coeficientes, mas tornam pouco confiável um intervalo calculado sob a hipótese de erros normais. Por isso usamos o bootstrap selvagem: em cada simulação, o resíduo de cada mês é multiplicado por +1 ou −1 sorteados ao acaso, e cada mês mantém o tamanho da sua própria surpresa.
A leitura da decomposição
No primeiro mês, 93,3% do erro de previsão da Selic vem de choques na própria Selic. Dentro do mês, a principal surpresa sobre os juros é a própria decisão do Copom, e a política monetária ajusta a taxa em passos graduais a partir das decisões anteriores.
Com o horizonte mais longo, a gasolina ganha peso: sai de 5,7% no primeiro mês para 16,9% no sexto e 19,0% no décimo segundo. Um choque na gasolina mexe pouco na Selic de imediato, mas pesa na incerteza sobre os juros de alguns meses à frente, o tempo que a inflação leva para chegar às expectativas e à reação do Copom.
| Horizonte | Selic | Gasolina | Câmbio | Incerteza | Petróleo |
|---|---|---|---|---|---|
| 1 mês | 93,3% | 5,7% | 0,0% | 0,5% | 0,5% |
| 3 meses | 82,5% | 9,3% | 3,8% | 2,1% | 2,3% |
| 6 meses | 69,2% | 16,9% | 5,4% | 4,0% | 4,5% |
| 12 meses | 64,6% | 19,0% | 6,4% | 5,2% | 4,8% |
Fatia de cada choque na variância do erro de previsão da Selic. VAR(3), ordenação petróleo, câmbio, incerteza, gasolina, Selic.
As fatias do petróleo e do câmbio ficam abaixo da fatia da gasolina em todos os horizontes. Parte do efeito deles sobre os juros passa pelo preço da gasolina, e a ordenação base atribui a cada um só o que ele move diretamente.
Intervalo de confiança e sensibilidade à ordenação
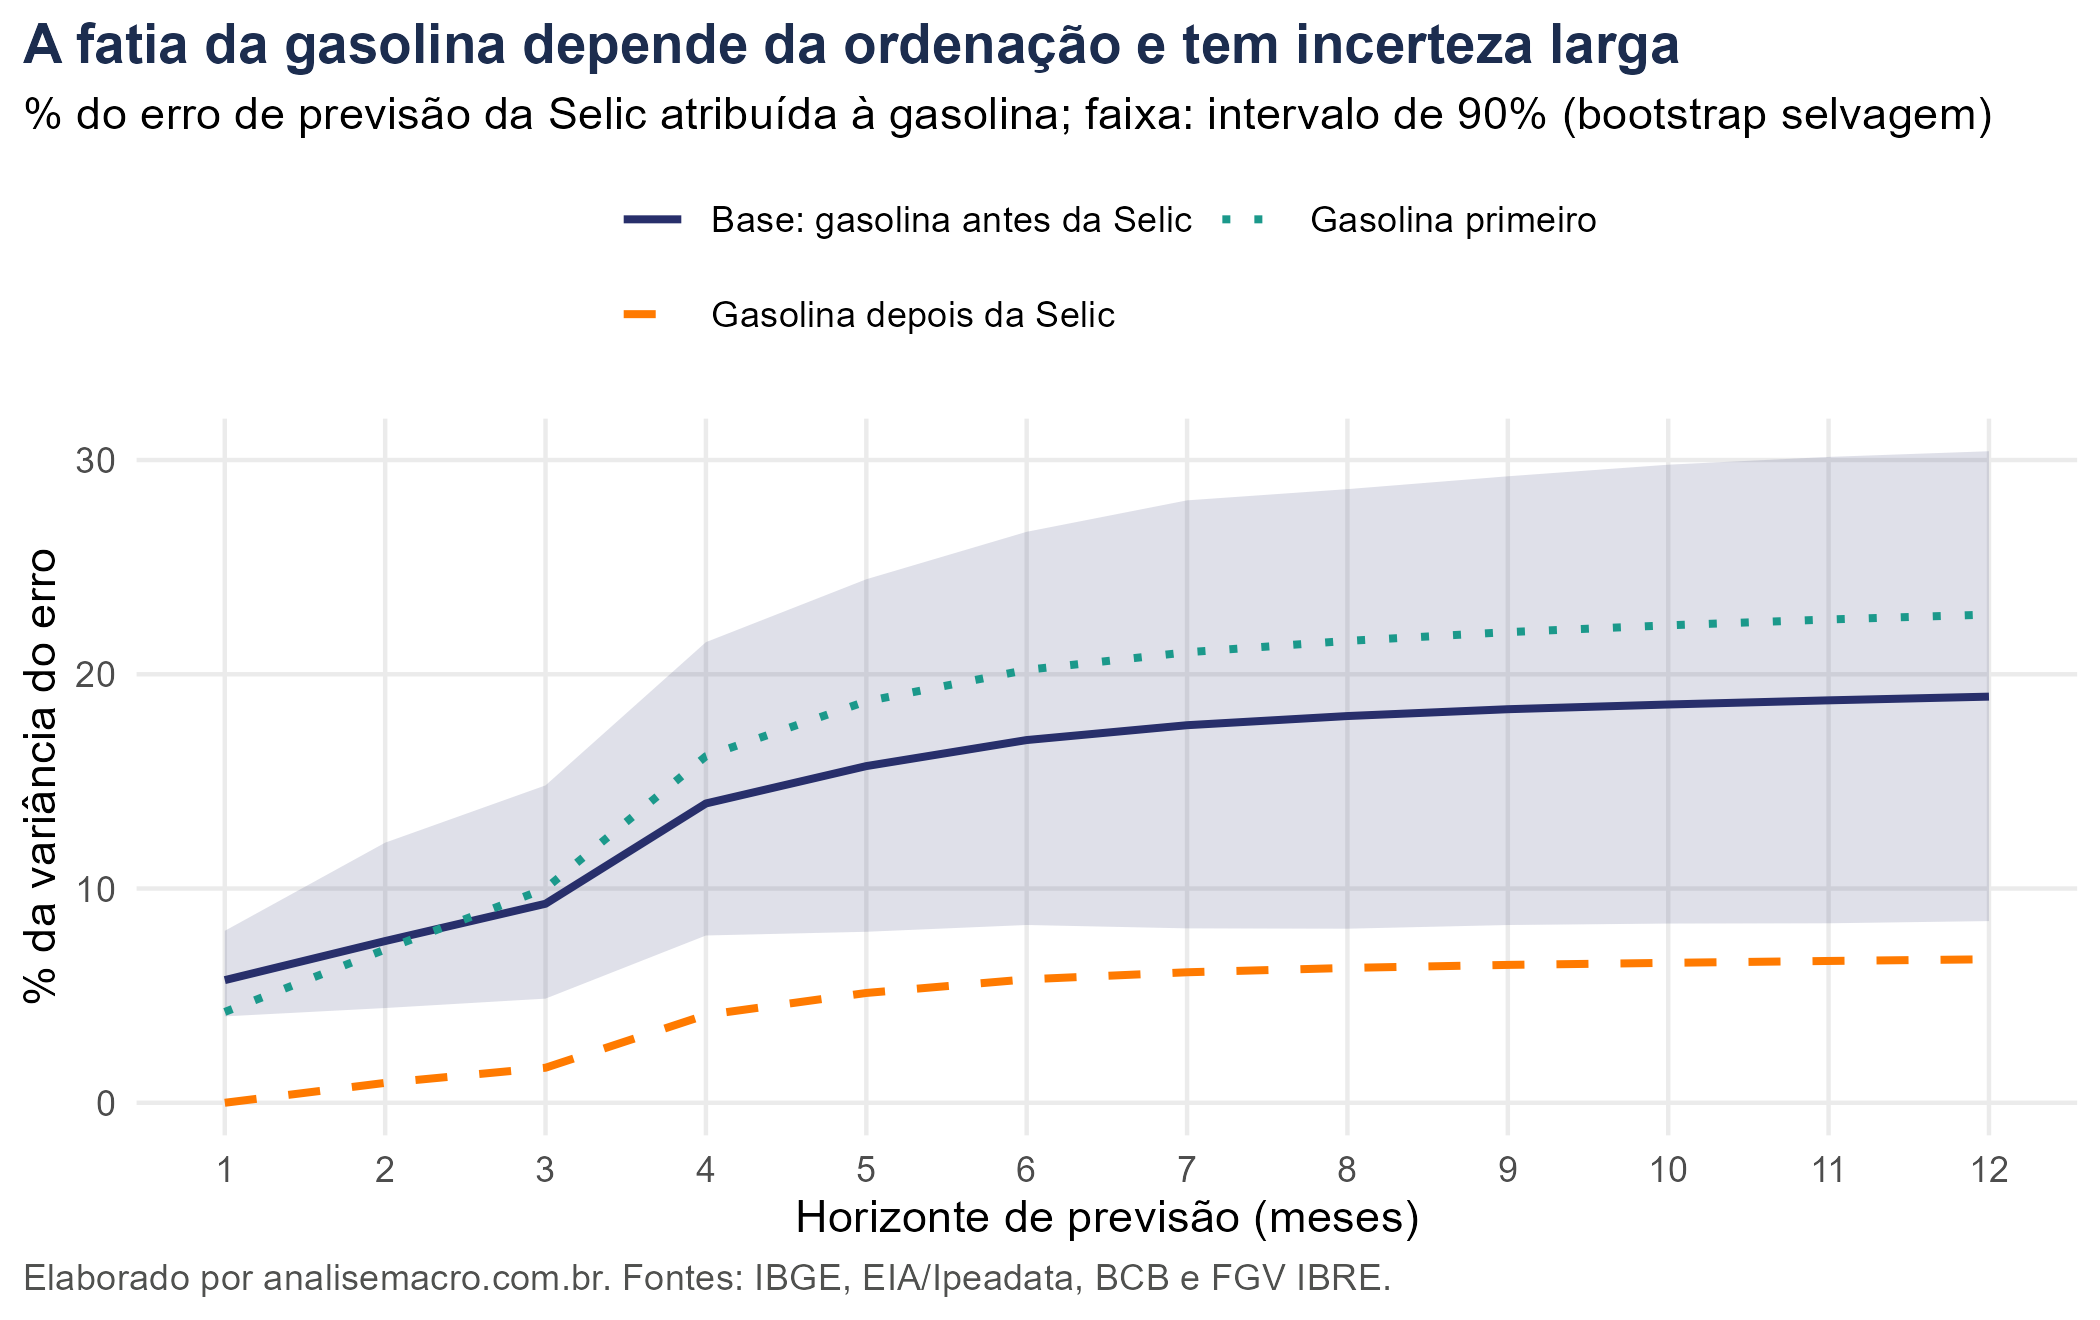
A faixa clara é o intervalo de 90% da ordenação base. Em doze meses, ele vai de 8,5% a 30,4%. O limite inferior fica acima de zero, o que sugere uma contribuição da gasolina que aparece também nas amostras simuladas. A largura da faixa mostra que o tamanho exato dessa contribuição é medido com pouca precisão.
As linhas mostram a mesma fatia em três ordenações. Com a gasolina em primeiro lugar, ela chega a 22,8% em doze meses. Com a gasolina depois da Selic, o Copom deixa de reagir à gasolina dentro do mês, a fatia começa em zero por construção e chega a 6,7% em doze meses.
Ou seja, o resultado que resiste às três hipóteses é qualitativo: a gasolina explica pouco do erro de previsão da Selic no mês do choque e mais nos meses seguintes. O tamanho dessa parte depende de quem reage a quem dentro do mês, e por isso a ordenação precisa vir sempre declarada junto do número.
Onde a decomposição da variância é usada
- Cenários de política monetária: ao separar quanto da incerteza sobre os juros vem de inflação, câmbio ou da própria política, a decomposição indica quais variáveis o analista precisa acompanhar com mais atenção em cada horizonte.
- Gestão de renda fixa: a curva de juros precifica a Selic futura. Saber que choques de combustíveis ganham peso em seis a doze meses ajuda a montar posições e estresses nos vértices intermediários.
- Previsão macroeconômica: se um choque pesa pouco no erro de previsão de uma variável, incluí-lo no modelo tende a melhorar pouco a previsão. A decomposição orienta que séries valem o custo de entrar.
- Choques de oferta: o mesmo método mede quanto petróleo e câmbio explicam da inflação, uma pergunta recorrente quando o preço internacional dispara. A relação entre petróleo e bomba aparece em Volatilidade do petróleo e preço da gasolina no Brasil.
- Incerteza e risco: trocar o IIE-Br por outra medida de incerteza permite medir quanto ela pesa nos juros. Uma medida alternativa é construída em Construindo um Indicador de Incerteza usando Python.
Considerações finais
A decomposição da variância transforma uma pergunta de conjuntura, quanto um choque de combustíveis complica a previsão dos juros, em um número com intervalo de confiança e hipóteses declaradas. Com dados públicos e o R, o exercício inteiro roda de novo a cada mês, sem refazer planilha.
O R reúne no mesmo script a coleta no IBGE, no Banco Central e no Ipeadata, os testes de estacionariedade, o VAR, o bootstrap e os gráficos. O mesmo caminho serve para qualquer sistema de variáveis macroeconômicas. O que muda é a aplicação:
- Economistas de bancos e consultorias: medir quanto cada fonte de choque pesa nas projeções de juros e inflação;
- Gestores e analistas de renda fixa: ligar choques de commodities e câmbio à incerteza sobre a Selic futura;
- Analistas de risco: montar cenários de estresse com choques identificados em vez de choques arbitrários;
- Pesquisadores e estudantes: estimar, diagnosticar e identificar um VAR com o rigor que um trabalho acadêmico exige.
Aprenda a construir modelos como este no R
Na Formação Do Zero à Análise de Dados Econômicos e Financeiros usando R, você aprende a coletar, tratar, modelar e apresentar dados econômicos, o caminho que levou a este VAR. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual da Análise Macro.
Referências: Sims, C. A. (1980), Macroeconomics and Reality, Econometrica; Lütkepohl, H. (2005), New Introduction to Multiple Time Series Analysis; Kilian, L. e Lütkepohl, H. (2017), Structural Vector Autoregressive Analysis; Pfaff, B. (2008), VAR, SVAR and SVEC Models: Implementation Within R Package vars, Journal of Statistical Software.
Leia também:
📩 Modelo, dado e ressalva — todo dia
Este exercício é um recorte. No Boletim AM eu mostro econometria aplicada o ano inteiro, e como a IA entra nesse trabalho sem substituir o julgamento de quem entende o modelo.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.