
Entender a origem dos dados e suas principais características é fundamental para produzir análises ou previsões úteis na ciência de dados. As estatísticas descritivas ajudam muito nesse sentido e sumarizam informações relevantes sobre as variáveis, mas às vezes isso não é suficiente. Para obter uma visão geral dos dados é importante explorar também os métodos de visualização.
O que é visualização de dados?
A visualização de dados é a sua exibição visual, através de representações tabulares, gráficas ou por diagramas, como forma de comunicar alguma informação. É um processo que aplica conjuntamente matemática, estatística, artes gráficas e comunicação, portanto é uma das tarefas menos automatizáveis da análise e ciência de dados, sendo dificilmente substituível por máquinas no curto prazo. Nesse sentido, em tempos de Inteligência Artificial, robôs e Big Data, a visualização de dados é uma habilidade importante para se ter no currículo, principalmente se usada em conjunto com técnicas de data storytelling. Naturalmente, existem diversas formas de visualizar dados através de gráficos, desde as mais simples até as mais complexas. Exemplos comuns que vemos no nosso cotidiano são os gráficos de barras, linhas, colunas, de pizza, etc., que são simples de entender e podem ser usados para propósitos diferentes. No entanto, quando o objetivo é analisar a distribuição dos dados, o gráfico de boxplot é uma ótima opção. É um tipo de gráfico que é fácil de produzir e interpretar.Análise de dados possíveis com gráficos de boxplot
Os gráficos de boxplot, também chamado de diagrama de caixa, são ferramentas poderosas para analisar e visualizar dados. Eles são especialmente úteis para analisar a distribuição dos dados. Algumas análises de dados comuns que podem ser feitas usando gráficos de boxplot são:- Identificação de medidas de tendência central: o boxplot exibe a mediana da distribuição, que é uma medida de tendência central. Você pode usar o gráfico para identificar rapidamente a mediana e ter uma ideia da localização central dos dados.
- Avaliação da dispersão dos dados: o comprimento da caixa no gráfico de boxplot representa a dispersão dos dados. Quanto maior a caixa, maior é a variabilidade nos dados. Você pode comparar os comprimentos das caixas em diferentes grupos ou categorias para avaliar a dispersão relativa dos dados.
- Detecção de assimetria: os boxplots podem ajudar a identificar assimetria na distribuição dos dados. Se a mediana não estiver no centro da caixa, isso pode indicar uma assimetria positiva (cauda direita) ou negativa (cauda esquerda) nos dados. Essa assimetria pode sugerir tendências e padrões relevantes para sua análise. Além disso, se um "bigode" (segmento de linha que se estende a partir da caixa) for significativamente mais longo em uma direção do que na outra, isso também pode indicar assimetria.
- Identificação de valores atípicos: os boxplots mostram pontos que estão além dos "bigodes" do gráfico. Esses pontos são chamados de valores atípicos ou outliers. Ao analisar o gráfico de boxplot, você pode identificar facilmente se há valores atípicos e determinar sua magnitude.
- Comparação entre grupos ou categorias: os gráficos de boxplot permitem comparar várias distribuições lado a lado. Você pode visualizar as diferenças nas medianas, dispersões e presença de valores atípicos entre diferentes grupos ou categorias.
O que é um gráfico de boxplot?
Um gráfico de boxplot, também conhecido como diagrama de caixa ou gráfico de caixa e bigodes, é uma representação visual das principais estatísticas descritivas de um conjunto de dados. Ele exibe informações sobre a distribuição dos dados, incluindo a mediana, os quartis, a amplitude e a presença de valores atípicos. Um gráfico de boxplot consiste em uma caixa retangular e dois segmentos de linha chamados de "bigodes". A visualização é composta pelos seguintes elementos: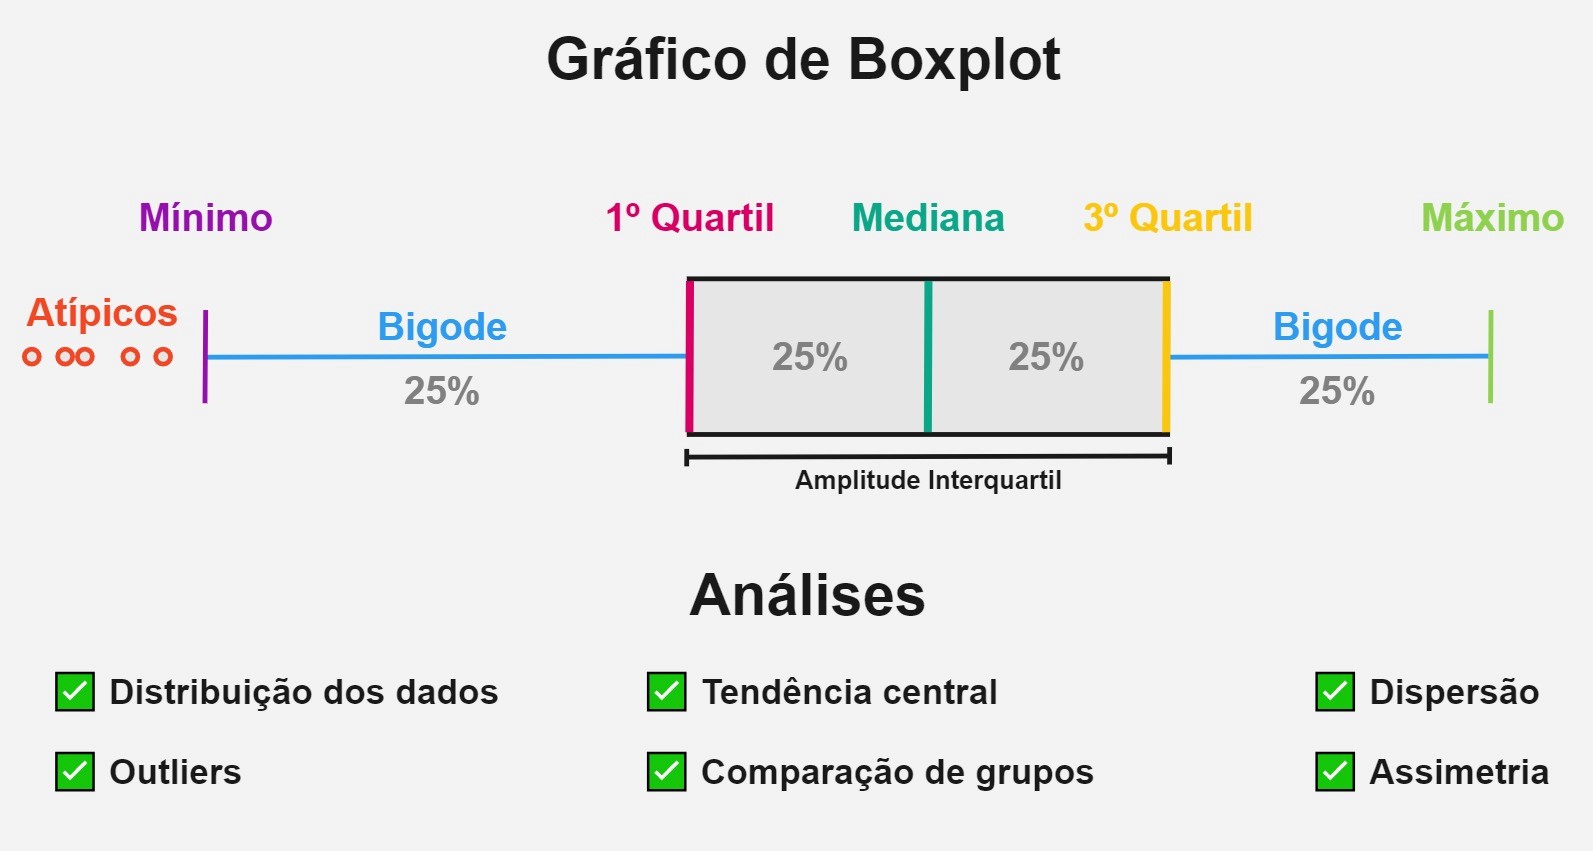
- Caixa: a caixa é desenhada de forma a incluir o intervalo interquartil (IQR), que representa a variação dos dados no meio do conjunto. O IQR é a diferença entre o terceiro quartil (Q3) e o primeiro quartil (Q1). A mediana (valor central da distribuição) é representada por uma linha dentro da caixa.
- Bigodes: os bigodes se estendem a partir da caixa e mostram a extensão dos dados. O comprimento dos bigodes é calculado com base na amplitude dos dados, excluindo os valores atípicos. O ponto em cada bigode é chamado de "whisker", indicando o limite inferior e superior dos dados.
- Valores atípicos: valores que estão além dos bigodes são representados como pontos individuais e são considerados valores atípicos. Esses pontos podem indicar observações que estão significativamente distantes da maioria dos dados.
📩 Onde a estatística vira decisão
O método que você acabou de ver não envelheceu: o que mudou foi o tempo que ele leva. No Boletim AM eu mostro, todo dia, estatística, econometria e IA aplicadas à economia, ao mercado financeiro e à análise de dados. Com dado real e sem enrolação.
Receber o Boletim AM → Todo dia no seu e-mail. Gratuito, e sai num clique.Como gerar gráficos de boxplot?
Em análise e ciência de dados podemos gerar gráficos de boxplot de maneira fácil usando linguagens de programação, como R e Python. A vantagem de usar linguagens de programação para visualizar dados é a possibilidade de customização, flexibilidade para visualizações estáticas ou interativas e a integração com o restante do fluxo de análise ou ciência de dados. Além disso, existem pacotes que possibilitam gerar visualizações com poucos ou um único comando/função, como os famososggplot2, matplotlib, plotly, plotnine e outros.
Abaixo mostramos um exemplo de gráfico de boxplot com a variável que mostra a evolução ao longo do tempo pelo termo de pesquisa "Artificial intelligence" na procura do Google, nos países Brasil e Estados Unidos. Os dados são do período de 2004 até hoje, índice de 0 a 100, e a fonte é o Google Trends.
Os códigos abaixo foram reexecutados e estão atualizados. O Google Trends passou a limitar requisições automatizadas: quando recebe muitas chamadas seguidas, devolve o código de status 429 em vez dos dados. Consultar um país por vez, com pausa entre as chamadas, é o que mantém a coleta funcionando.
R
# Carregar pacotes
library(gtrendsR)  # acesso aos dados do Google Trends
library(ggplot2)   # gramática de gráficos
library(dplyr)     # manipulação de dados

# Coleta, um país por vez, com nova tentativa se o Trends bloquear
coletar_interesse <- function(pais, tentativas = 4) {
  for (i in seq_len(tentativas)) {
    resposta <- try(
      gtrendsR::gtrends(
        keyword      = "Artificial intelligence",  # o termo pesquisado
        geo          = pais,                       # o país da consulta
        time         = "all",                      # toda a série, desde 2004
        onlyInterest = TRUE                        # só o interesse ao longo do tempo
      ),
      silent = TRUE
    )
    if (!inherits(resposta, "try-error")) {
      return(resposta$interest_over_time)
    }
    Sys.sleep(20)                                  # aguarda antes de tentar de novo
  }
  stop("Google Trends recusou a consulta para ", pais)
}

interesse_br <- coletar_interesse("BR")   # série do Brasil
Sys.sleep(15)                             # pausa entre os dois países
interesse_us <- coletar_interesse("US")   # série dos Estados Unidos

tabela <- dplyr::bind_rows(interesse_br, interesse_us)

# A coluna hits vem como texto quando o Google marca valores menores que 1
tabela <- tabela |>
  dplyr::mutate(
    hits = as.numeric(hits),                                  # índice de 0 a 100
    pais = dplyr::recode(geo, "BR" = "Brasil", "US" = "EUA")  # rótulo do eixo
  )

# Gráfico de boxplot
tabela |>
  ggplot2::ggplot() +
  ggplot2::aes(x = hits, y = pais) +
  ggplot2::geom_boxplot() +
  ggplot2::labs(
    title    = "Gráfico de Boxplot",
    subtitle = 'Interesse ao longo do tempo pelo termo "Artificial intelligence" nas pesquisas\n do Google',
    y        = "País",
    x        = "Índice Google Trends (0 a 100)",
    caption  = "Dados: Google Trends | Elaboração: Análise Macro"
  )
Python
# Importar bibliotecas
from pytrends.request import TrendReq   # acesso aos dados do Google Trends
import pandas as pd                     # manipulação de dados
import plotnine as p9                   # gramática de gráficos
import time                             # pausa entre as requisições

# Coleta, um país por vez, com nova tentativa se o Trends bloquear
def coletar_interesse(pais, tentativas=4):
    requisicao = TrendReq()
    for _ in range(tentativas):
        try:
            requisicao.build_payload(
                kw_list=["Artificial intelligence"],   # o termo pesquisado
                geo=pais,                              # o país da consulta
                timeframe="all"                        # toda a série, desde 2004
            )
            tabela = requisicao.interest_over_time()
            if not tabela.empty:
                return tabela.assign(geo=pais).reset_index()
        except Exception:
            pass
        time.sleep(20)                                 # aguarda antes de tentar de novo
    raise RuntimeError(f"Google Trends recusou a consulta para {pais}")

interesse_br = coletar_interesse("BR")   # série do Brasil
time.sleep(15)                           # pausa entre os dois países
interesse_us = coletar_interesse("US")   # série dos Estados Unidos

tabela = pd.concat([interesse_br, interesse_us])

# Nome curto para o índice e rótulo do país no lugar da sigla
tabela = (
    tabela
    .rename(columns={"Artificial intelligence": "hits"})
    .assign(pais=lambda d: d["geo"].map({"BR": "Brasil", "US": "EUA"}))
)

# Gráfico de boxplot
grafico = (
    p9.ggplot(tabela)
    + p9.aes(x="hits", y="pais")
    + p9.geom_boxplot()
    + p9.labs(
        title="Gráfico de Boxplot",
        subtitle='Interesse ao longo do tempo pelo termo "Artificial intelligence"\nnas pesquisas do Google',
        y="País",
        x="Índice Google Trends (0 a 100)",
        caption="Dados: Google Trends | Elaboração: Análise Macro",
    )
)

print(grafico)
O que as duas caixas mostram
Na execução mais recente do código, as estatísticas por país deixam explícito o que o desenho resume:| País | Mínimo | Q1 | Mediana | Q3 | Máximo |
|---|---|---|---|---|---|
| Brasil | 0 | 1 | 2 | 4 | 100 |
| Estados Unidos | 3 | 5 | 8 | 12 | 100 |
Quando o boxplot não basta
O boxplot esconde a forma da distribuição dentro da caixa. Duas variáveis com os mesmos quartis podem ter uma distribuição com um pico só e outra com dois picos, e o desenho sairia idêntico nos dois casos. Quando essa diferença importa, o gráfico de histograma completa a leitura, porque mostra a frequência em cada faixa de valor. Para a relação entre duas variáveis, o caminho é o gráfico de dispersão, e para a evolução no tempo, o gráfico de linha.Conclusão
Neste artigo entendemos sobre a importância da visualização de dados e vimos o que é, como funciona e como gerar gráficos de boxplot. Esse tipo de gráfico é útil para diversas análises e pode ser facilmente produzido e personalizado usando linguagens de programação, como R e Python.Da visualização à análise completa
Explorar a distribuição é o primeiro passo; o seguinte é modelar. O AM Black é a assinatura anual que dá acesso a todos os cursos da Análise Macro, em R e em Python, da estatística descritiva à econometria aplicada.
Referências
Wikipedia contributors. (2023, June 4). Box plot. In Wikipedia, The Free Encyclopedia. Retrieved 16:48, June 6, 2023, from https://en.wikipedia.org/w/index.php?title=Box_plot&oldid=1158421606