Boa parte do que se mede em economia vem em categorias: setor de atividade, ocupação, escolaridade, cor ou raça. Não faz sentido calcular a média de um setor nem o desvio-padrão de uma ocupação, e por isso esse tipo de variável exige um conjunto próprio de ferramentas. Neste artigo mostramos como analisar a relação entre duas variáveis qualitativas, usando dados da PNAD Contínua.
A pergunta do exercício: existe relação entre cor ou raça e o tipo de curso profissional que um estudante do ensino médio frequenta?
Para responder, percorremos três etapas:
- montar a tabela que cruza as duas variáveis;
- testar se a diferença observada é grande demais para ser acaso;
- medir o tamanho dessa diferença.
As duas primeiras etapas são rotina em qualquer análise. A terceira costuma ficar de fora, e neste exercício ela inverte a leitura: o teste aponta uma associação entre as variáveis, mas a medida de tamanho mostra que essa associação é fraca demais para sustentar qualquer afirmação forte.
Receba as próximas análises no seu e-mail
Associação entre variáveis, testes estatísticos e leitura de microdados aparecem toda semana nas análises do Boletim AM. A assinatura é gratuita e chega direto no seu e-mail.
A tabela de contingência
A distinção entre o que se conta e o que se mede é o ponto de partida, e está detalhada em variáveis quantitativas e qualitativas: o que são e como analisar.
Uma tabela de contingência cruza duas variáveis categóricas e conta quantos casos caem em cada combinação. Cada célula é uma contagem: quantas pessoas têm, ao mesmo tempo, determinada cor ou raça e determinado tipo de curso.
| Curso técnico | Qualificação profissional | Nenhum dos dois | |
|---|---|---|---|
| Branca | 1.730 | 682 | 24.294 |
| Preta ou parda | 2.225 | 1.106 | 35.569 |
Olhando os números brutos, o grupo preto ou pardo tem mais pessoas em curso técnico, e seria tentador concluir que há maior acesso nesse grupo.
A conclusão está errada porque os dois grupos têm tamanhos muito diferentes na população. Tomemos dois grupos, um com mil pessoas e outro com cem. Se cem pessoas do primeiro fazem curso técnico e vinte do segundo, a contagem favorece o primeiro grupo, mas a proporção é de 10% contra 20%, e o acesso é maior no segundo. Contagens absolutas comparam o tamanho dos grupos, não o acesso dentro de cada um.
A comparação correta: percentual dentro de cada grupo
A pergunta sobre acesso exige comparar proporções dentro de cada linha: que fração de cada grupo faz cada tipo de curso?
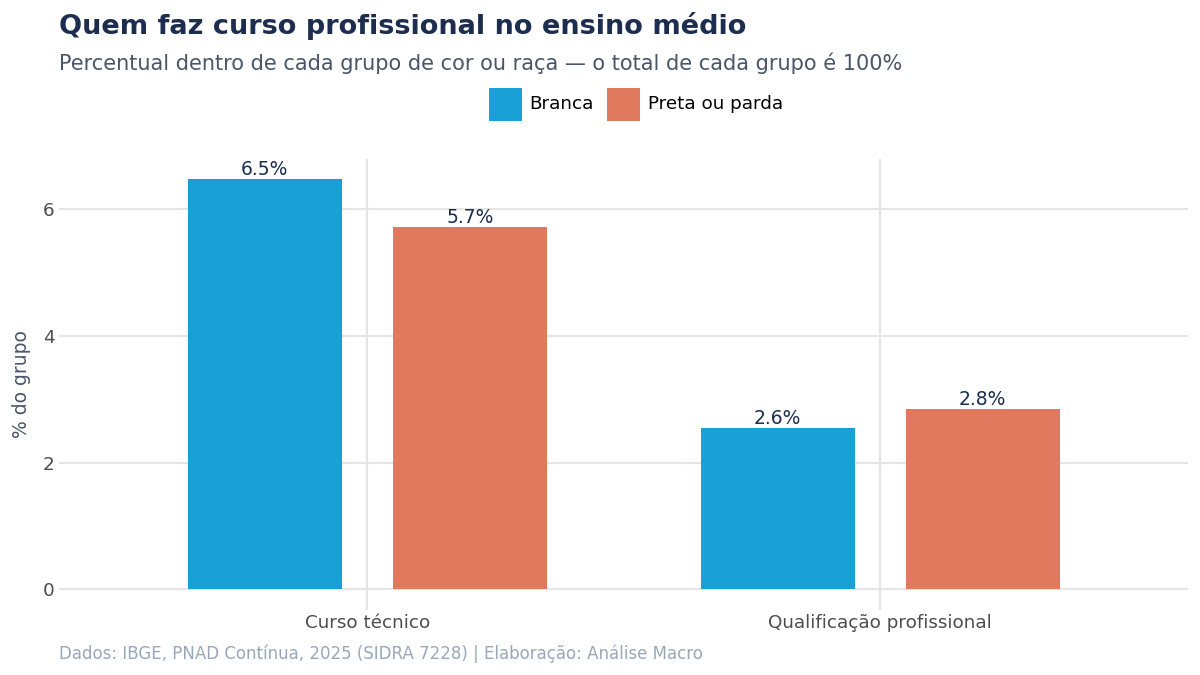
A leitura muda de direção. Em curso técnico, a proporção é maior entre pessoas brancas, o oposto do que os números brutos sugeriam. Em qualificação profissional a diferença é menor e aponta para o outro lado.
Toda tabela de contingência começa por aí: converter para percentual na direção que responde à pergunta feita. Se a pergunta é sobre acesso de cada grupo, o percentual é calculado por linha.
A hipótese nula: e se não houvesse relação nenhuma?
O teste qui-quadrado compara a tabela observada com a que existiria sob independência entre as duas variáveis.
Independência, aqui, significa que a distribuição de cursos seria idêntica em todos os grupos. Se determinada fração do total faz curso técnico, essa mesma fração apareceria dentro de cada grupo de cor ou raça.
A partir dessa hipótese, calculamos a frequência esperada de cada célula: o total da linha multiplicado pelo total da coluna, dividido pelo total geral.
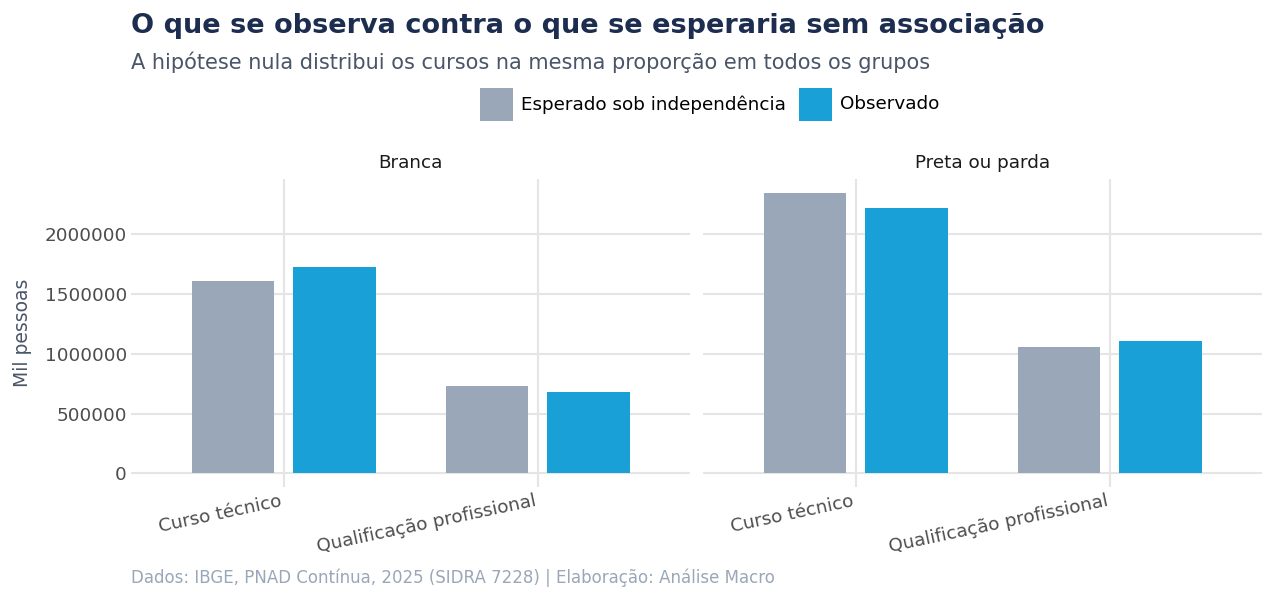
As barras cinzas mostram a frequência esperada sob independência; as azuis, a frequência que foi de fato observada. As duas alturas são próximas em todas as combinações: existe diferença, mas ela é pequena diante do tamanho das barras. Essa impressão visual volta a importar adiante, porque o teste formal devolve um resultado que parece contradizê-la.
A estatística do teste
O qui-quadrado resume todas essas diferenças num único número. Para cada célula da tabela:
- calcula-se o quanto o observado se afasta do esperado;
- eleva-se essa diferença ao quadrado, para que desvios para cima e para baixo não se cancelem ao serem somados;
- divide-se pelo valor esperado da célula;
- somam-se todos os resultados.
O termo Oij é a contagem observada na célula e Eij a esperada sob independência. A divisão pelo esperado torna a medida comparável entre células de tamanhos diferentes. Um desvio de cem pessoas numa célula que esperava duzentas é grave; numa que esperava vinte mil, é irrelevante.
A soma desses termos segue uma distribuição própria, a qui-quadrado, que aparece no catálogo de distribuições de probabilidade em dados ao lado das demais famílias contínuas.
O número que sai daí depende da escala da tabela e do tamanho da amostra, e por isso precisa ser convertido em probabilidade. Essa conversão é o papel do p-valor.
O que o p-valor responde
Essa conversão se apoia na distribuição que a estatística assume sob a hipótese nula, o mesmo raciocínio que sustenta a margem de erro de uma pesquisa e que o Teorema Central do Limite fundamenta.
O p-valor responde a uma pergunta bem delimitada: se as duas variáveis fossem independentes, qual a chance de o acaso da amostragem produzir uma diferença deste tamanho ou maior?
Quando essa chance é muito pequena, a explicação "foi coincidência" fica difícil de sustentar. É o caso aqui: o p-valor fica tão próximo de zero que, se as duas variáveis fossem independentes, seria preciso repetir a pesquisa um número imenso de vezes para o acaso produzir uma diferença como a observada.
Pelos critérios usuais, a associação é estatisticamente significante, e é nesse ponto que a maior parte das análises se encerra.
Significante não quer dizer grande
O p-valor mede a chance de o acaso produzir aquela diferença. Ele não diz nada sobre o tamanho dela. São duas perguntas distintas, e a segunda costuma ser a que orienta a decisão.
Reportar o tamanho do efeito ao lado do teste cumpre o mesmo papel que atribuir probabilidade a um cenário em simulação de cenários com distribuição de probabilidades: informa a magnitude, e não apenas a existência.
A confusão entre as duas tem uma consequência incômoda: quanto maior a amostra, mais fácil fica detectar diferenças cada vez menores. Com dezenas de milhões de observações, quase qualquer diferença passa a ser significante, inclusive as irrelevantes na prática.
Por isso o teste precisa vir acompanhado de uma medida de tamanho de efeito, que responde à outra pergunta: além de existir, a associação é forte?
O V de Cramér
Para tabelas de contingência, a medida usual é o V de Cramér. Ele parte do próprio qui-quadrado e o divide pelo tamanho da amostra e pelas dimensões da tabela. Essa divisão resolve o problema do n: como o qui-quadrado cresce proporcionalmente ao número de observações, dividir por ele devolve uma medida que depende apenas das proporções da tabela. Dobrar a amostra mantendo as mesmas proporções dobra o qui-quadrado, mas não altera o V de Cramér.
Aqui n é o total de observações e k é o menor entre o número de linhas e o de colunas da tabela. Como o χ2 aparece dividido por n, dobrar a amostra sem mudar as proporções deixa o V intacto.
O resultado fica numa escala fixa, fácil de interpretar:
- 0 indica independência perfeita entre as variáveis;
- 1 indica associação total.
Neste exercício, o V de Cramér fica muito próximo de zero. A conclusão completa reúne as duas informações: existe uma associação estatisticamente detectável entre cor ou raça e tipo de curso profissional, e ela é muito fraca. Quem reportasse apenas o p-valor concluiria que a relação entre as duas variáveis é relevante, quando os próprios dados mostram o contrário.
A demonstração da armadilha
Dá para isolar o efeito do tamanho da amostra num experimento simples: mantemos exatamente as mesmas proporções da tabela e variamos apenas o total de observações.
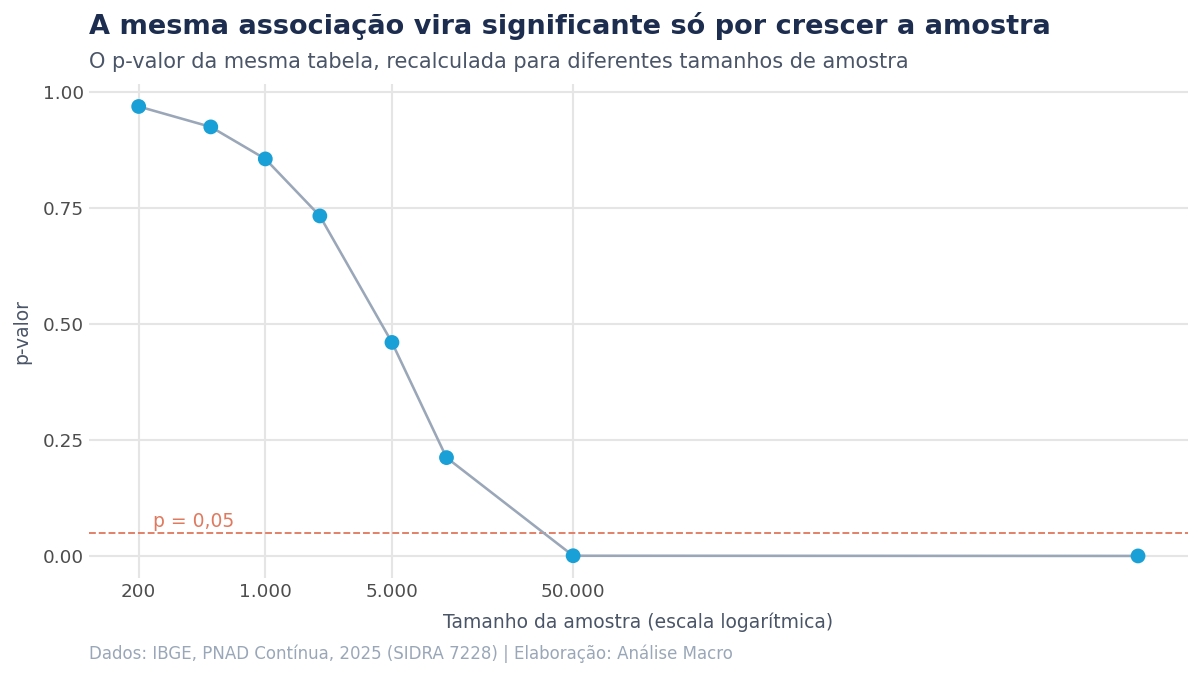
Repetir um cálculo variando só um parâmetro, para ver o que ele governa, é o procedimento da simulação de Monte Carlo.
O V de Cramér não se move, porque as proporções são idênticas em todos os casos. Já o p-valor despenca conforme a amostra cresce.
Com poucas centenas de pessoas, a mesma tabela seria classificada como "não significante". Com dezenas de milhões, vira "altamente significante". Nada mudou nos dados além do tamanho da amostra.
Onde a associação se concentra
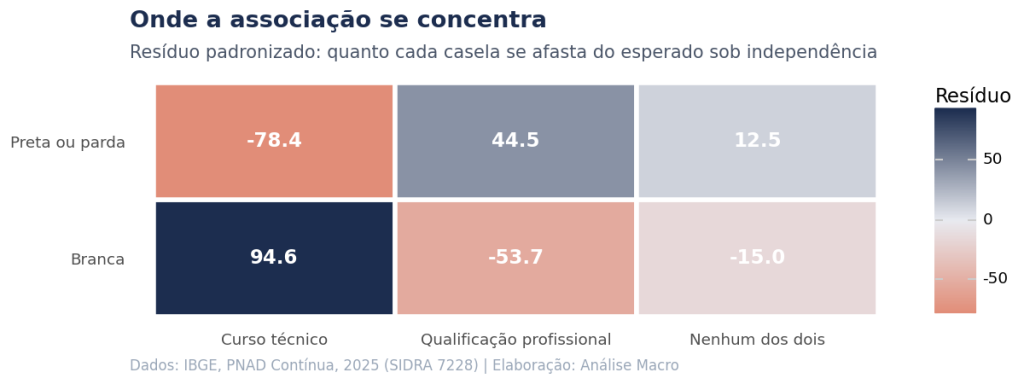
O qui-quadrado entrega um número único para a tabela inteira, mas não diz de onde ele veio. Para localizar as células que mais contribuem, usa-se o resíduo padronizado: a diferença entre observado e esperado, dividida pela raiz do valor esperado. A divisão coloca todas as células na mesma escala, de modo que um desvio numa célula pequena e outro numa célula grande possam ser comparados diretamente.
A regra de leitura usual trata resíduos acima de 2 em módulo como células que se afastam do esperado. O valor 2 vem da distribuição normal: sob independência, os resíduos se comportam aproximadamente como uma normal padrão, e valores acima de 2 são raros nessa distribuição. A regra funciona em amostras de tamanho comum, mas exige cuidado quando a amostra é muito grande, porque o resíduo cresce com a raiz do número de observações.
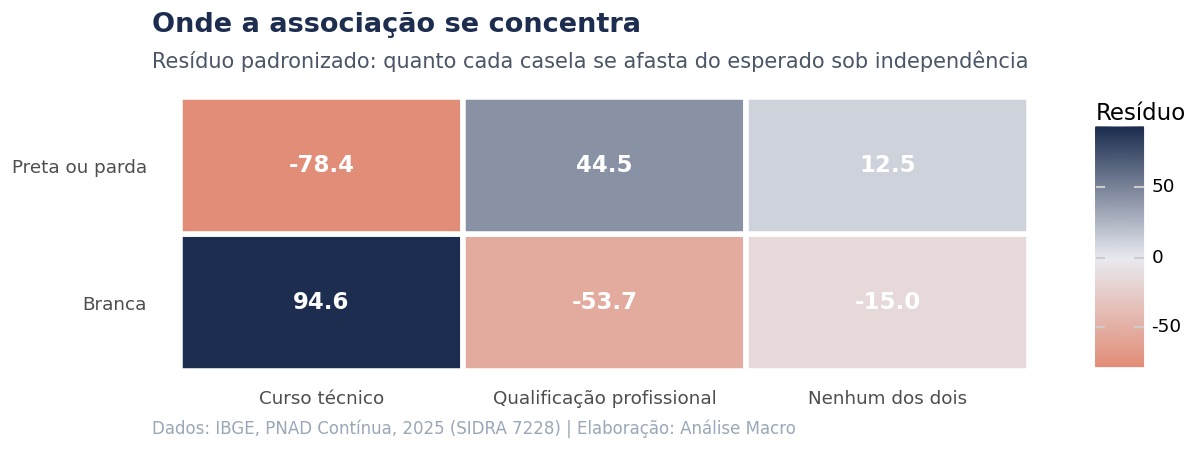
É o caso aqui: com uma amostra de dezenas de milhões, todas as células ultrapassam 2, e a regra deixa de discriminar. O que informa, nessa situação, é a ordem de grandeza entre elas.
As células de curso técnico têm resíduo várias vezes maior que as de "nenhum dos dois", com sinais opostos entre os dois grupos de cor ou raça. A associação da tabela se concentra ali, enquanto a ausência de curso quase não contribui para o resultado.
Quando o teste não vale
🔢
👥
📏
Variáveis categóricas dispensam média e desvio-padrão, mas a escolha entre medidas resistentes e medidas sensíveis reaparece sempre que a variável volta a ser numérica, assunto das estatísticas robustas: mediana, IQR e MAD.
A primeira condição é sobre frequências esperadas pequenas. A regra usual pede pelo menos cinco casos em cada célula esperada; abaixo disso, a aproximação que sustenta o teste perde validade, e o caminho é o teste exato de Fisher.
A segunda é sobre independência das observações. Se a mesma pessoa aparece em mais de uma célula, ou se há medidas repetidas do mesmo indivíduo, o teste não se aplica.
A terceira é sobre a unidade da tabela. O qui-quadrado exige contagens absolutas de pessoas ou de casos. A PNAD Contínua, como boa parte das tabulações do IBGE, publica os resultados em milhares de pessoas: aplicar o teste sobre esses valores equivale a dividir a amostra por mil, e o qui-quadrado sai mil vezes menor do que deveria. A conversão para a contagem absoluta precisa ser feita antes do teste.
O roteiro completo
| Passo | O que fazer |
|---|---|
| 1 | Monte a tabela de contingência com as contagens absolutas. |
| 2 | Converta para percentual na direção que responde à pergunta feita. |
| 3 | Rode o teste e obtenha o p-valor. |
| 4 | Calcule o tamanho do efeito com o V de Cramér. Sozinho, o p-valor faz uma associação irrelevante parecer forte. |
| 5 | Olhe os resíduos para descobrir quais células explicam a associação. |
Os dois últimos passos costumam ser pulados. Sem o tamanho de efeito, uma associação irrelevante pode ser reportada como achado importante; sem os resíduos, sabe-se que a tabela como um todo se afasta da independência, mas não em quais categorias isso acontece.
Você fez o teste; aprenda a análise completa
Da estatística descritiva à modelagem de microdados, com Python aplicado a dados reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
AGRESTI, A. Categorical data analysis. 3. ed. Hoboken: John Wiley & Sons, 2013.
FIENBERG, S. E. The analysis of cross-classified categorical data. 2. ed. New York: Springer, 2007.
HABERMAN, S. J. The analysis of residuals in cross-classified tables. Biometrics, v. 29, n. 1, p. 205-220, 1973.
PEARSON, K. On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine, série 5, v. 50, n. 302, p. 157-175, 1900.
Leia também: Como gerar sumários de estatísticas descritivas · O alicerce da ciência de dados: entendendo o processo gerador dos dados