Muitas perguntas econômicas têm a forma "qual a probabilidade de...". Qual a chance de a inflação estourar o teto da meta, de uma carteira perder mais do que certo percentual no ano, de a dívida pública passar de determinado patamar. Neste artigo mostramos como responder esse tipo de pergunta quando a fórmula que daria a resposta não existe em forma útil.
A pergunta que vamos responder: dado o comportamento recente da inflação, qual a chance de o IPCA acumulado em doze meses estourar o teto da meta?
O Banco Central persegue uma meta de inflação com uma banda de tolerância para cima e para baixo. O limite superior dessa banda é o teto, e ultrapassá-lo obriga o presidente da instituição a escrever uma carta aberta explicando os motivos. Saber a probabilidade disso acontecer tem valor prático.
Receba as próximas análises no seu e-mail
Simulação, incerteza e cenários para variáveis macroeconômicas aparecem toda semana nas análises do Boletim AM. A assinatura é gratuita e chega direto no seu e-mail.
Por que a fórmula não resolve
Para responder pela via analítica, seria preciso conhecer a distribuição de probabilidade do IPCA acumulado em doze meses, ou seja, do resultado de encadear as variações mensais de um ano inteiro num único número. Esse acumulado, porém, não é uma variável simples.
Ele é o resultado da composição de doze variações mensais, que se multiplicam em vez de se somar. Uma inflação de 1% em dois meses seguidos produz 2,01%, e não 2%, porque o segundo mês incide sobre o índice já corrigido pelo primeiro.
Cada π é a variação de um mês, e π12m o acumulado do ano. Somar variáveis aleatórias é um problema conhecido, com solução fechada em muitos casos. Multiplicá-las não tem a mesma saída: a distribuição do produto de doze variáveis aleatórias não tem expressão simples, e obtê-la exigiria hipóteses tão restritivas sobre a inflação mensal que o resultado deixaria de descrever o caso real.
A simulação de Monte Carlo resolve por outro caminho. Em vez de deduzir a distribuição, geramos milhares de realizações possíveis do processo e contamos quantas satisfazem a condição de interesse. A proporção observada é a estimativa da probabilidade.
O símbolo 1{⋯} vale 1 quando o cenário sorteado termina acima do teto e 0 quando não termina, de modo que a soma conta os casos e a divisão por N devolve a proporção.
O método substitui a derivação matemática por repetição: em vez de resolver a integral que daria a probabilidade exata, aproximamos essa probabilidade contando casos entre milhares de cenários sorteados. Como gerar milhares de cenários leva segundos num computador comum, a aproximação sai mais barata que a solução exata na maioria das aplicações.
Os três passos do método
⚙️
🎲
🧮
O primeiro passo define como o dado é gerado, e é o único que exige julgamento do analista. É preciso escolher uma distribuição para a inflação mensal e fixar seus parâmetros. Aqui supomos que ela segue uma normal, com média e dispersão iguais às observadas no período recente. A escolha é discutível, e voltamos a ela na seção sobre os limites do método.
Essa escolha é o ponto em que o exercício encontra o diagnóstico de qual distribuição descreve os dados, porque supor uma normal para um dado de cauda pesada subestima justamente os cenários extremos.
O segundo passo sorteia trajetórias completas. Cada cenário é uma sequência de doze variações mensais, compostas mês a mês até formar o acumulado do ano.
O terceiro passo é uma contagem simples: quantos desses cenários terminam acima do teto.
O resultado: uma distribuição inteira
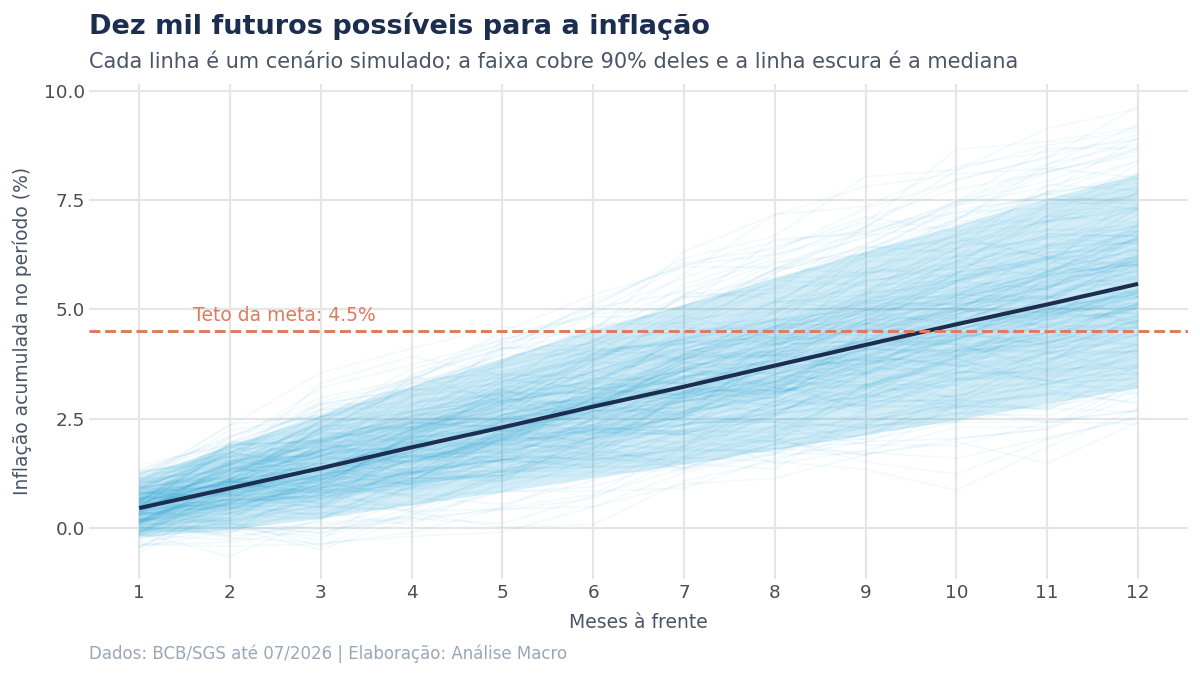
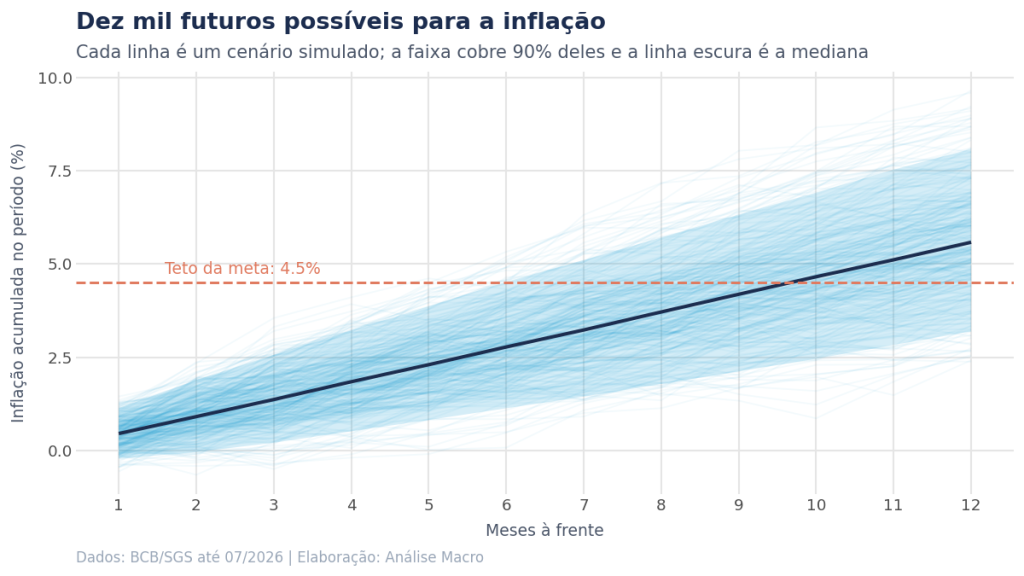
Cada linha tênue do gráfico é uma das trajetórias simuladas. A faixa central, mais escura, cobre a maior parte delas; a linha que a atravessa marca a mediana, ou seja, o valor que divide os cenários ao meio em cada mês.
O desenho torna visível o crescimento da incerteza ao longo do horizonte. No primeiro mês os cenários são quase indistinguíveis entre si, porque diferem por uma única variação mensal sorteada. No décimo segundo mês, cada trajetória já acumulou doze sorteios independentes, e as diferenças entre elas se somaram. Por isso a faixa se abre.
A linha central do feixe é a mediana, e não a média, escolha que segue a lógica das estatísticas robustas quando a distribuição pende para um lado.
Projeções de longo prazo vêm com intervalos amplos por esse motivo. A largura reflete a natureza acumulativa do processo, e não uma deficiência do modelo.
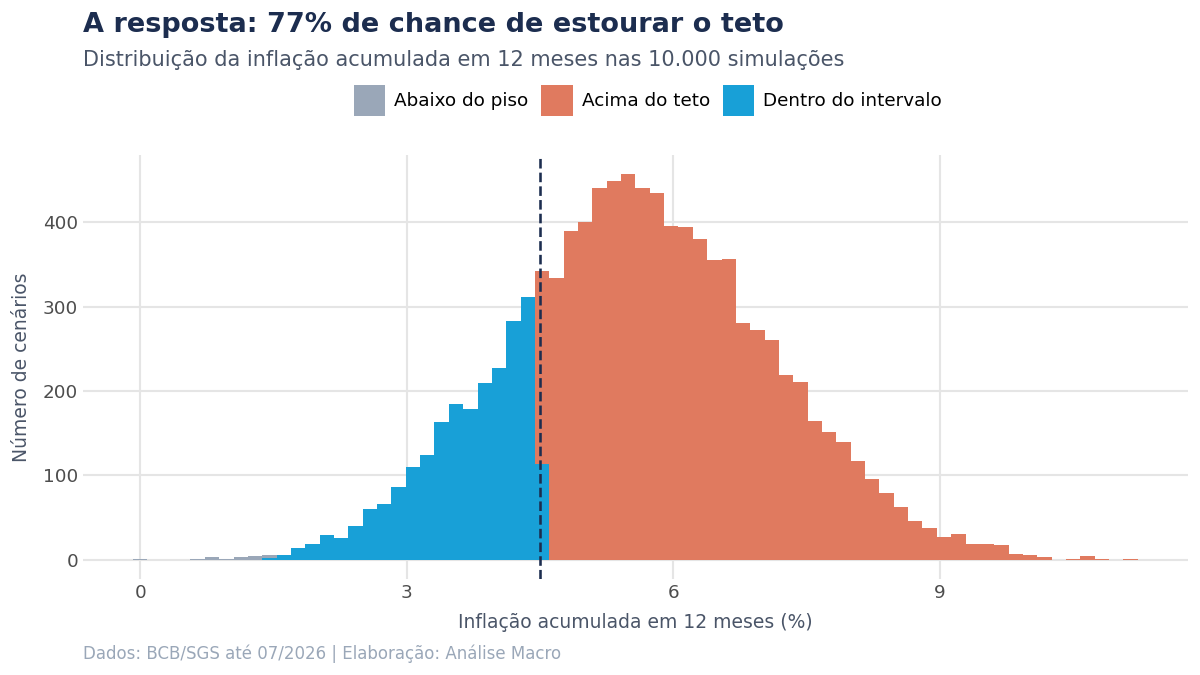
Olhando apenas o ponto final de cada trajetória, chegamos à resposta. A proporção de cenários que terminam acima do teto é a estimativa da probabilidade procurada.
Não obtivemos uma previsão pontual, e sim uma distribuição inteira de resultados possíveis, da qual se extrai qualquer probabilidade que interesse, para qualquer patamar.
Quantas simulações são suficientes?
Uma pergunta natural: dez mil cenários são muitos ou poucos? Não há número fixo, mas dá para descobrir experimentalmente. Como cada execução sorteia cenários diferentes, duas rodadas do mesmo procedimento devolvem respostas ligeiramente distintas. Rodamos a simulação várias vezes para cada tamanho e medimos o quanto essas respostas divergem entre si: quando param de divergir, o número de cenários já é suficiente.
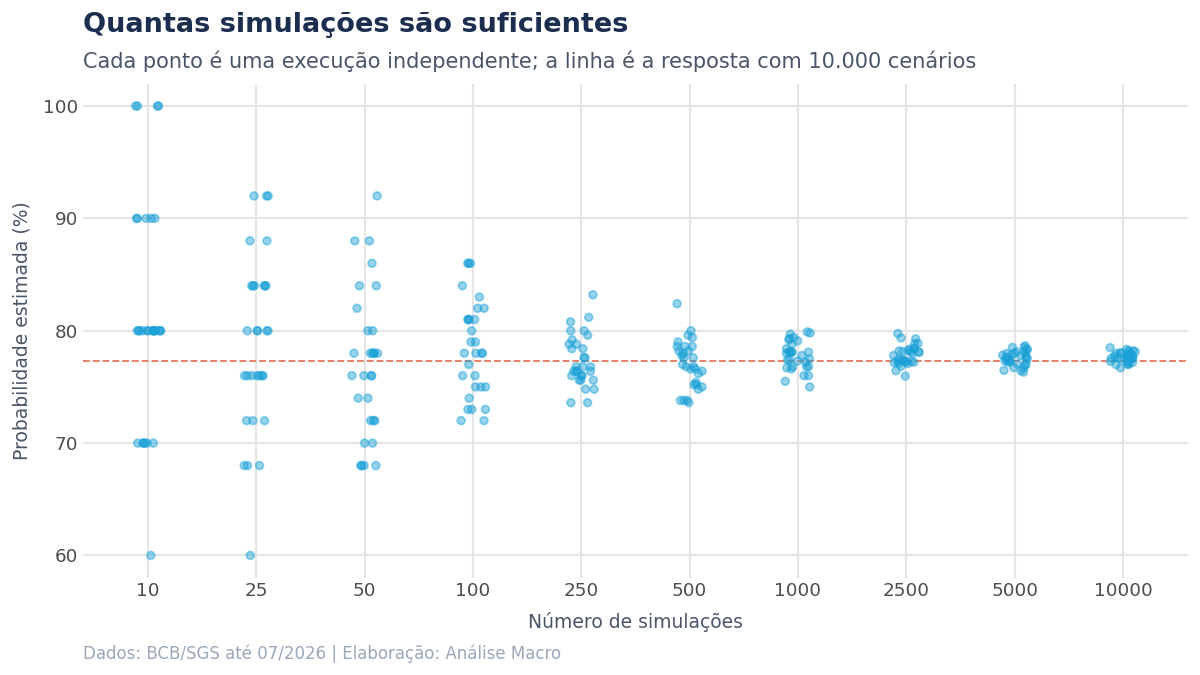
Amostras pequenas produzem respostas instáveis aqui pelo mesmo motivo que tornam frágil um teste qui-quadrado com poucas observações por célula.
Com poucas dezenas de cenários, a resposta varia tanto entre execuções que se torna inútil. Com algumas centenas, ainda oscila vários pontos percentuais. Com alguns milhares, estabiliza numa faixa estreita, e com dezenas de milhares as execuções praticamente coincidem.
Há uma regularidade por trás disso, a mesma que governa o tamanho de amostra numa pesquisa. Sendo P a probabilidade estimada e N o número de cenários, o erro do método é:
Como N entra sob a raiz, a precisão melhora com a raiz do número de simulações, e não na proporção direta. Multiplicar os cenários por cem reduz o erro por dez.
A raiz de N aparece aqui pela mesma razão que aparece no erro-padrão de uma pesquisa amostral, e o Teorema Central do Limite é o resultado que a sustenta nos dois casos.
Na prática, isso significa dois comportamentos:
- o retorno é grande no começo, porque sair de cem para mil cenários muda bastante a estabilidade;
- depois de certo ponto, aumentar mais quase não melhora nada.
Alguns milhares de cenários atendem à maioria das aplicações, e o custo computacional é tão baixo que não compensa economizar nesse ponto.
O que a simulação permite e a fórmula não
Até aqui, a simulação apenas substituiu uma conta difícil por uma contagem. O que a torna insubstituível aparece quando o problema passa a ter mais de uma fonte de incerteza.
No exercício acima, tratamos a média mensal da inflação como se fosse conhecida com certeza. Mas ela é uma estimativa, calculada a partir de um número limitado de observações, e portanto carrega erro próprio. Essa incerteza também deveria entrar no cálculo.
Numa fórmula fechada, incorporar essa segunda fonte de incerteza exigiria refazer toda a derivação. Na simulação, muda apenas um passo do procedimento: em vez de usar a mesma média em todos os cenários, sorteamos primeiro uma média plausível para aquele cenário e só depois sorteamos as doze variações mensais a partir dela.
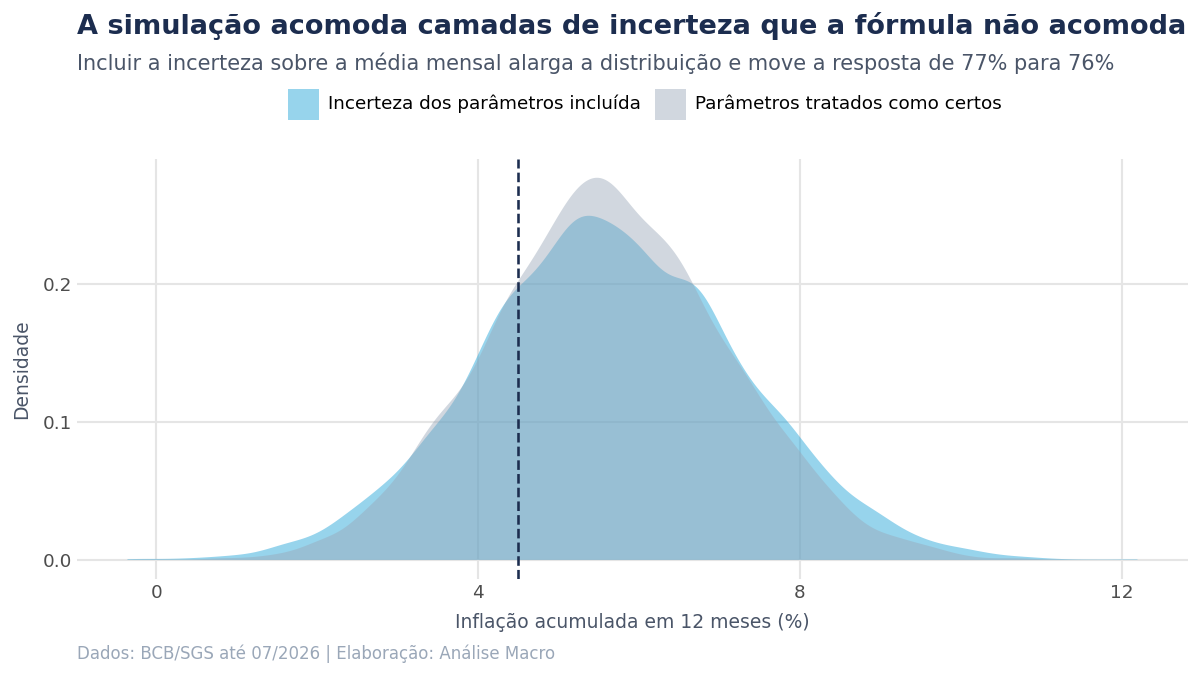
A distribuição resultante fica visivelmente mais larga. A razão é que agora dois sorteios independentes se acumulam em cada cenário: o da média e o das variações mensais. Cenários que combinam uma média alta com variações altas chegam a valores que a versão anterior nunca produzia, e a cauda direita se estende.
A probabilidade central muda pouco, o que torna o efeito difícil de perceber: quem olha apenas a projeção do meio não vê diferença. Quem dimensiona risco percebe, porque os extremos ficaram mais prováveis.
Levar essa ideia até o fim, atribuindo uma distribuição a cada variável de entrada de uma projeção, é o que fazemos em simulação de cenários com distribuição de probabilidades.
O padrão se repete para qualquer camada adicional. Incorporar incerteza sobre a dispersão, sobre a persistência da inflação ou sobre a própria meta custa mais um sorteio dentro do mesmo laço, e não uma nova derivação matemática.
Onde o método já é usado
O leque de aplicações é amplo, e algumas delas são conhecidas mesmo fora da estatística:
- o fan chart de inflação dos bancos centrais, aquele gráfico em leque que abre conforme o horizonte avança;
- o VaR de uma carteira, que responde qual a perda máxima esperada numa fração elevada dos dias;
- projeções de dívida pública com bandas de incerteza;
- cálculo de reservas em seguradoras e precificação de opções complexas.
Em todos eles o motivo é o mesmo: o resultado final depende de várias variáveis que interagem, como juros, câmbio, preços de ativos e frequência de sinistros, e a distribuição conjunta dessas interações não tem expressão fechada que se possa calcular.
Os limites do método
O que a simulação exige de nós é uma hipótese explícita sobre o processo gerador dos dados.
O primeiro limite é sobre a origem do resultado. A simulação não cria informação. O resultado vale exatamente o quanto vale a suposição sobre o processo gerador. Aqui, supusemos inflação mensal normal e independente, o que ignora a persistência inflacionária e a possibilidade de choques. A saída herda toda limitação da entrada.
O segundo diz respeito à visibilidade do modelo. A simulação não elimina as escolhas do analista, apenas as torna menos visíveis. É fácil rodar dez mil cenários e apresentar o resultado como se fosse dado observado, quando a escolha do processo gerador continua sendo uma decisão do analista.
O terceiro é sobre o erro do próprio método. O sorteio introduz um ruído que não vem dos dados. A resposta muda um pouco a cada execução, e essa variação nada tem a ver com a incerteza do fenômeno: é consequência de usarmos um número finito de cenários. A curva de convergência mostra quando esse ruído já ficou pequeno o bastante para ser ignorado.
Há ainda um quarto ponto, específico deste exercício. A meta de inflação e a banda de tolerância são definidas pelo Conselho Monetário Nacional e podem mudar ao longo do tempo. Como o teto é o patamar contra o qual os cenários são comparados, uma alteração na meta muda a resposta sem que nada tenha mudado na inflação.
O roteiro completo
| Passo | O que fazer |
|---|---|
| 1 | Descreva o processo que gera o resultado que te interessa. |
| 2 | Escolha as distribuições dos componentes e justifique a escolha. |
| 3 | Sorteie muitos cenários — alguns milhares costumam bastar. |
| 4 | Conte a proporção que satisfaz a condição. |
| 5 | Verifique a convergência, rodando com tamanhos diferentes. |
| 6 | Teste a sensibilidade às suposições e reporte o resultado. |
O último passo é o teste de sensibilidade, e costuma ficar de fora. Consiste em repetir toda a simulação trocando a distribuição de entrada por outra plausível e comparar as respostas. Se elas divergirem muito, a conclusão depende mais da escolha inicial do que dos dados, e isso precisa ser reportado junto com o resultado.
Você simulou cenários; aprenda a construir modelos
Da geração de cenários à modelagem e previsão de séries econômicas, com Python aplicado a dados reais desde a primeira aula. Quem quer acesso a todas as formações tem o AM Black, a assinatura anual.
Referências
GLASSERMAN, P. Monte Carlo methods in financial engineering. New York: Springer, 2003.
METROPOLIS, N.; ULAM, S. The Monte Carlo method. Journal of the American Statistical Association, v. 44, n. 247, p. 335-341, 1949.
ROBERT, C. P.; CASELLA, G. Monte Carlo statistical methods. 2. ed. New York: Springer-Verlag, 2004.
RUBINSTEIN, R. Y.; KROESE, D. P. Simulation and the Monte Carlo method. 3. ed. Hoboken: John Wiley & Sons, 2016.
Leia também: Variáveis quantitativas e qualitativas: o que são e como analisar · Como gerar sumários de estatísticas descritivas