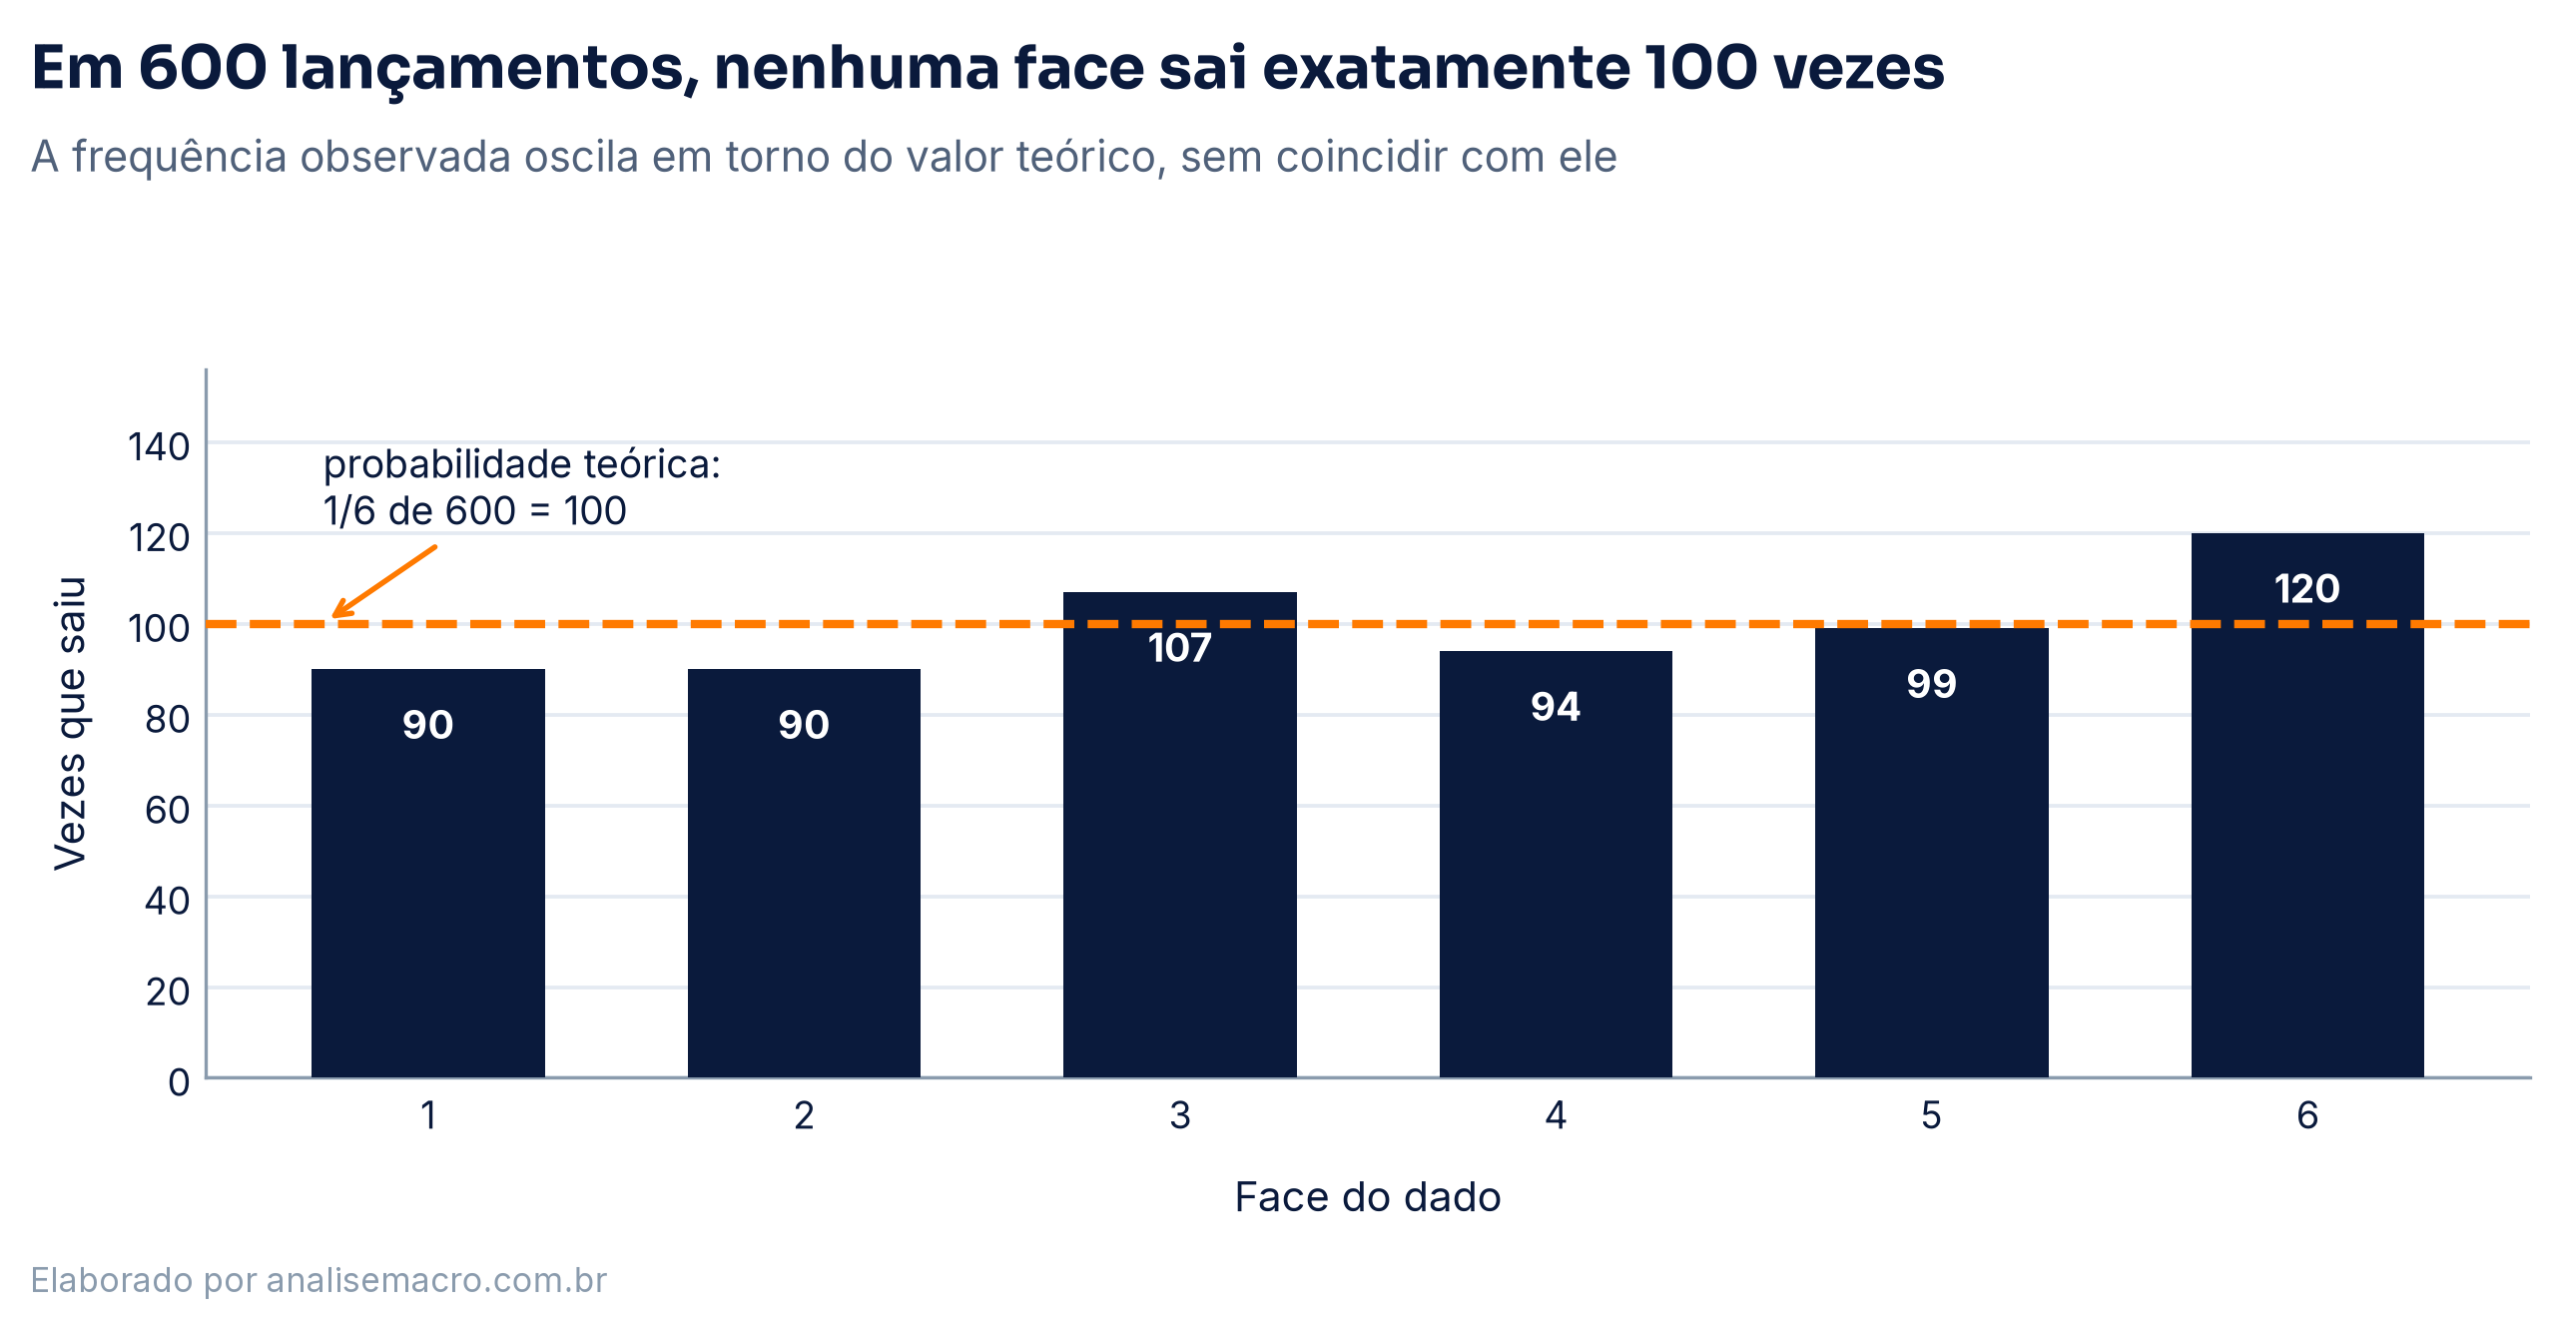
Probabilidade é a medida da chance de um evento acontecer, num número entre 0 e 1. O que a torna útil na análise de dados não é a definição, e sim o que ela permite: separar o que é padrão do que é acaso, e dizer o quanto podemos confiar numa conclusão tirada de uma amostra. Neste artigo percorremos os conceitos que sustentam esse raciocínio, do espaço amostral ao teorema central do limite, usando simulações em R para ver cada ideia funcionando. Um experimento aleatório é aquele cujo resultado não conseguimos prever com certeza, ainda que conheçamos todos os resultados possíveis. O lançamento de um dado é o exemplo clássico: sabemos que sairá um número de 1 a 6, mas não qual. O conjunto de todos os resultados possíveis é o espaço amostral. Para o dado, são seis elementos. Um evento é qualquer subconjunto desse espaço: "sair 6" é um evento, "sair número par" é outro. Quando todos os resultados são igualmente prováveis, a probabilidade de um evento é a razão entre os casos favoráveis e os casos possíveis: No dado, a probabilidade de sair 6 é 1/6, aproximadamente 0,167. A de sair número par é 3/6, ou 0,5. A soma das probabilidades de todos os resultados do espaço amostral é sempre 1. A probabilidade teórica de cada face é 1/6. Em 600 lançamentos, isso levaria a esperar 100 ocorrências de cada número. Simulamos exatamente esse experimento em R. Nenhuma face saiu exatamente 100 vezes. O 6 apareceu 120 vezes e o 1 apenas 90, uma diferença de 30 ocorrências entre faces que têm a mesma probabilidade. Isso não contradiz a teoria. A probabilidade descreve o comportamento no longo prazo, não a garantia de um resultado específico numa quantidade finita de tentativas. A pergunta seguinte é: quão longo precisa ser esse prazo? A lei dos grandes números afirma que, conforme o número de repetições cresce, a frequência observada de um evento converge para sua probabilidade teórica. Podemos ver isso acompanhando a proporção acumulada ao longo de 5.000 lançamentos. Ao final dos 5.000 lançamentos, a proporção de seis é 0,1696, contra o valor teórico de 0,1667. A diferença caiu para menos de três milésimos. Nas primeiras dezenas de lançamentos a proporção varia de forma violenta, chegando perto de 0,30. Conclusões tiradas de amostras pequenas merecem desconfiança por essa razão, e é esse o problema que a inferência estatística trata.Aleatoriedade e espaço amostral
O que a teoria diz e o que os dados mostram
set.seed(1234)                      # fixa a semente: o resultado é reproduzível

table(                              # conta quantas vezes cada face apareceu
  sample(1:6, 600, replace = TRUE)  # sorteia 600 lançamentos, com reposição
)
A lei dos grandes números
set.seed(1234)                           # fixa a semente para reprodutibilidade

lancamentos <- sample(                   # sorteia a sequência de lançamentos
  1:6,                                   # as faces possíveis
  size    = 5000,                        # cinco mil repetições
  replace = TRUE                         # com reposição: cada lançamento é independente
)

convergencia <- data.frame(              # monta a tabela da frequência acumulada
  n    = 1:5000,                         # quantos lançamentos até cada ponto
  freq = cumsum(lancamentos == 6) / 1:5000  # proporção de seis até aquele ponto
)

mean(lancamentos == 6)                   # a proporção ao final dos 5.000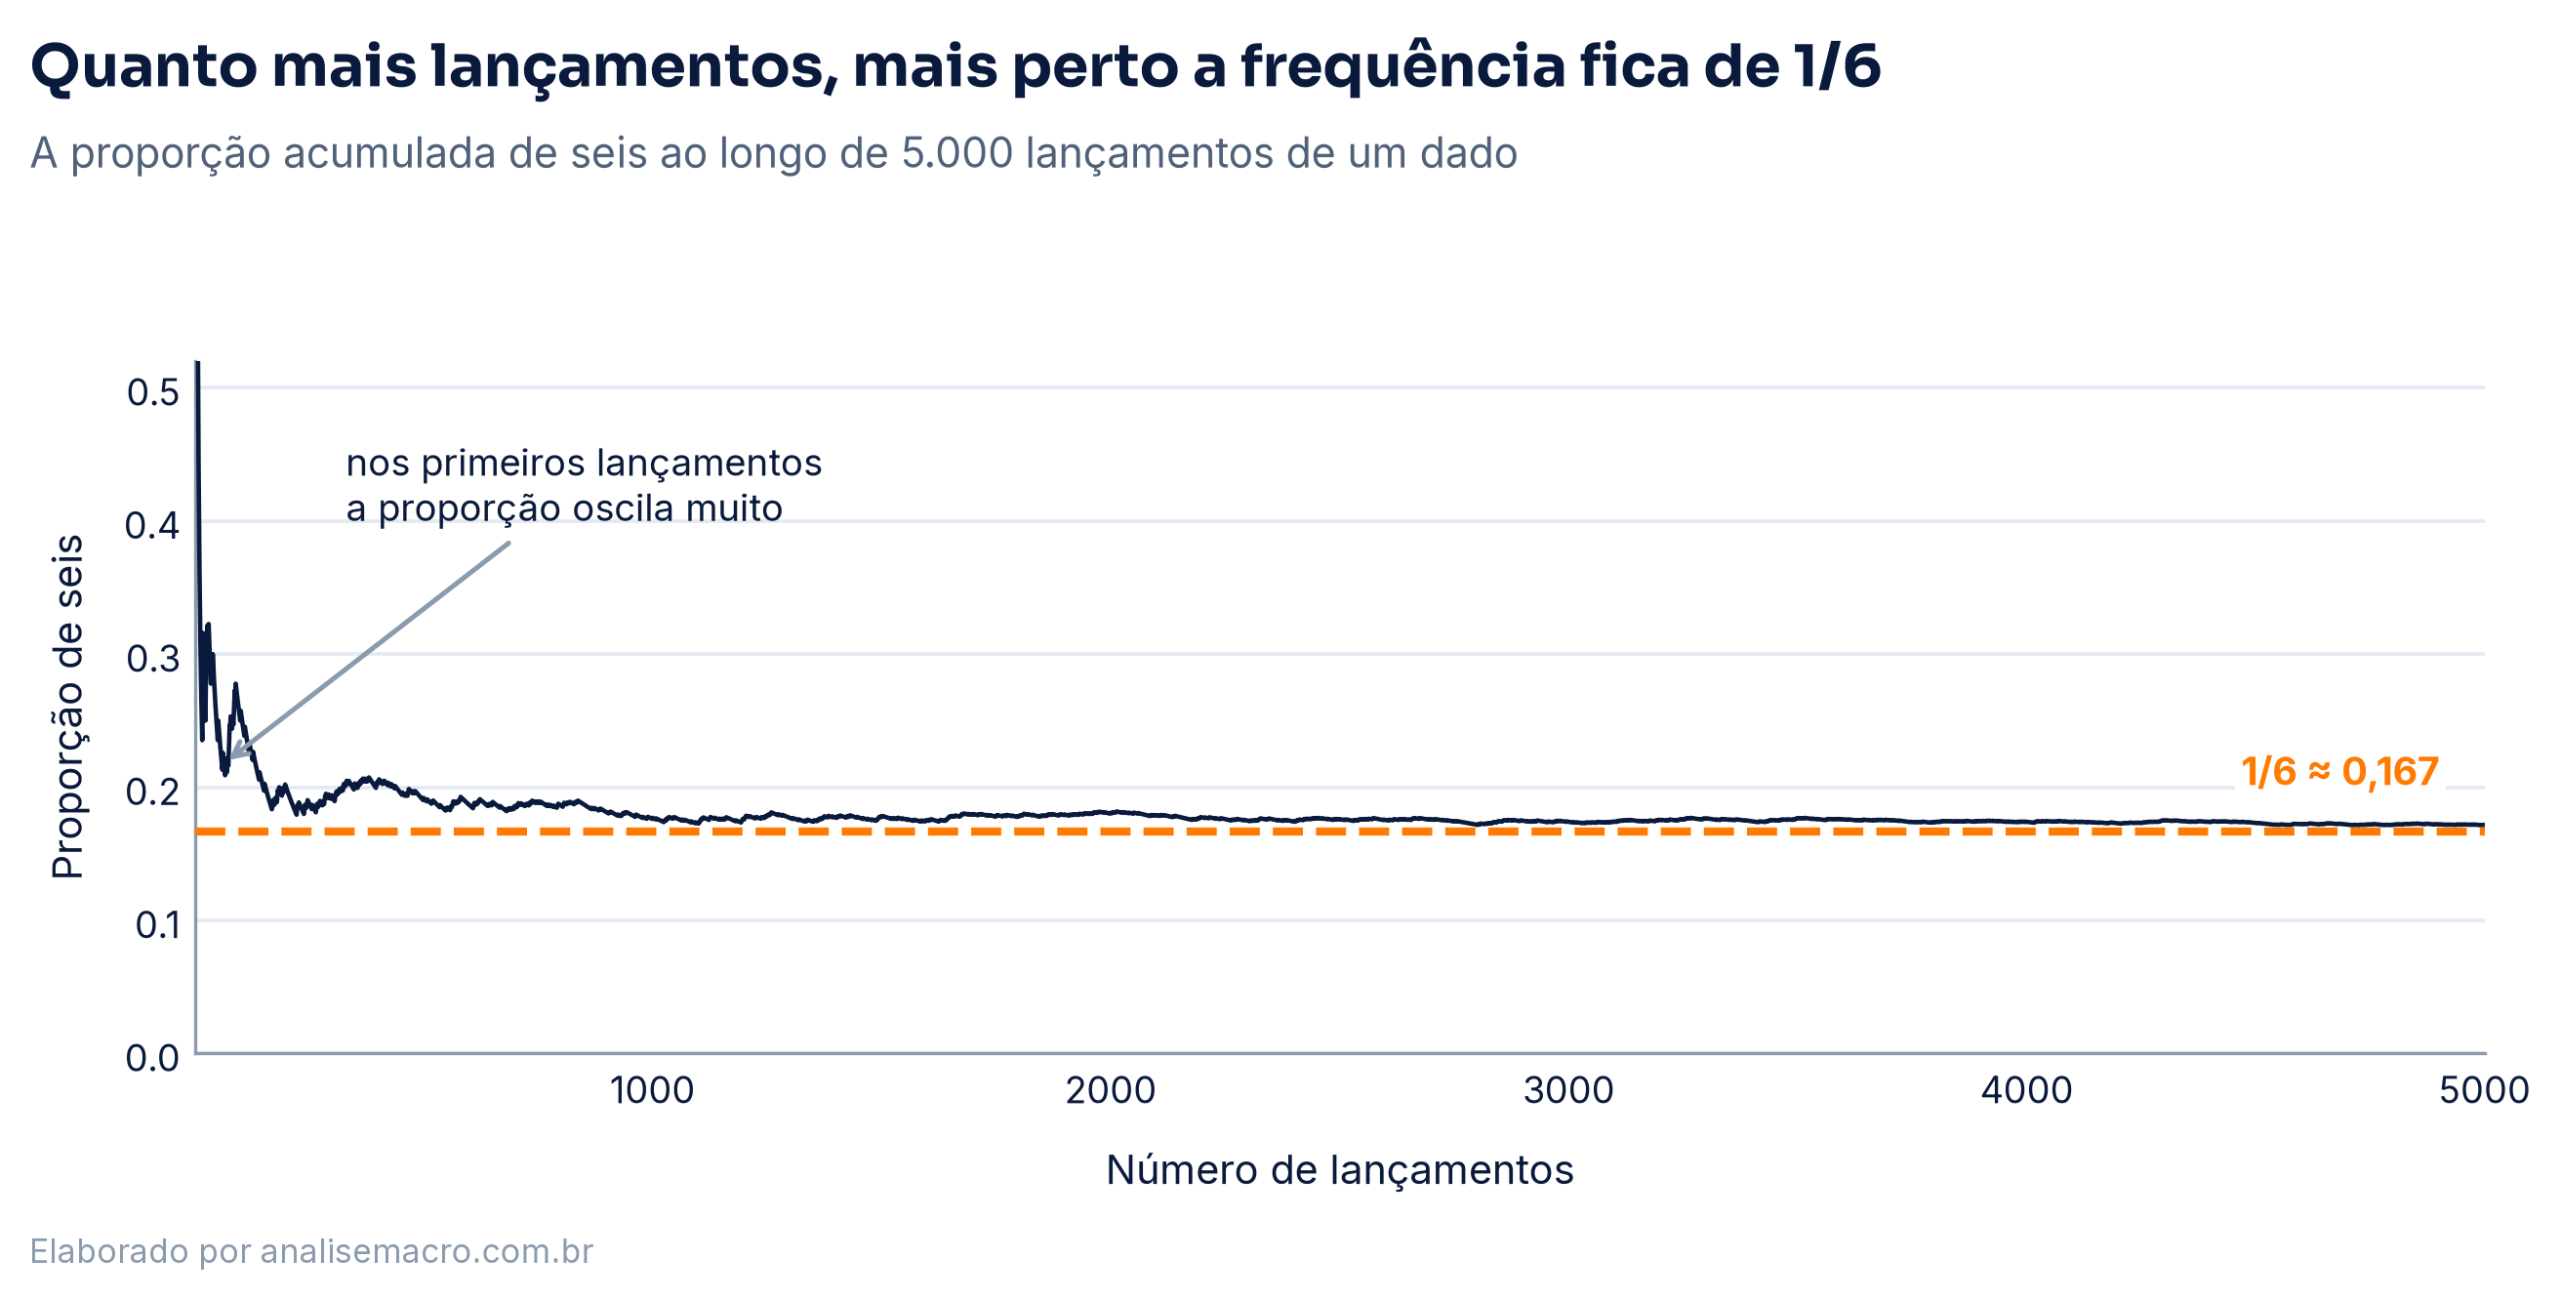
📩 Acompanhe nossas análises
O Boletim AM traz análises de conjuntura, exercícios em R e Python e material de estudo, direto no seu e-mail.
Eventos independentes e dependentes
Dois eventos são independentes quando a ocorrência de um não altera a probabilidade do outro. Lançamentos sucessivos de um dado são independentes: o dado não guarda memória do resultado anterior.
Para eventos independentes, a probabilidade de os dois ocorrerem é o produto das probabilidades individuais:
A chance de sair 6 duas vezes seguidas é, portanto, 1/6 × 1/6 = 1/36, cerca de 2,8%.
Eventos dependentes são o oposto: o primeiro resultado muda as condições do segundo. Sortear duas cartas de um baralho sem devolver a primeira é o caso típico, porque a segunda extração ocorre num baralho de 51 cartas.
No R, a diferença entre os dois casos está num único argumento.
# Sem reposição: o primeiro sorteio altera o que resta para o segundo
sample(1:6, size = 2, replace = FALSE)   # duas faces necessariamente distintas

# Com reposição: cada sorteio é independente do anterior
sample(1:6, size = 2, replace = TRUE)    # pode repetir a mesma face
Confundir os dois casos é um erro com consequência prática. Supor independência onde ela não existe leva a subestimar a probabilidade de eventos conjuntos, problema frequente em análise de risco.
Os dois tipos de distribuição
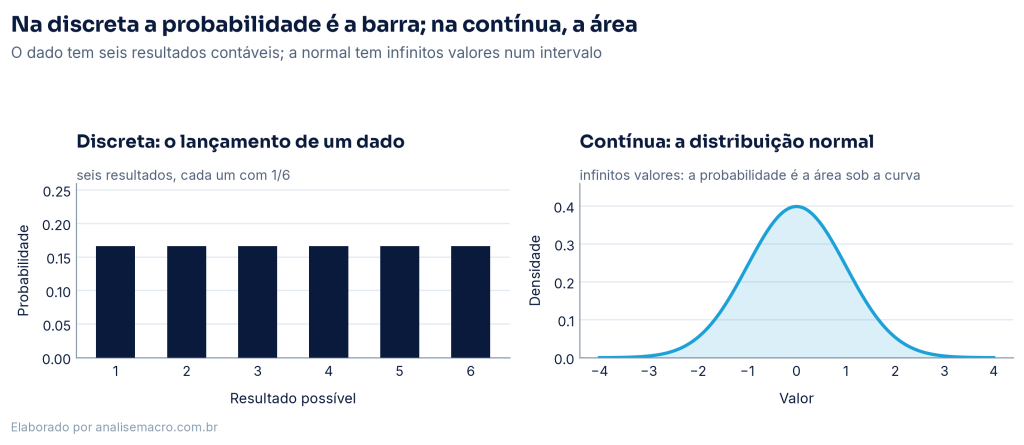
Uma distribuição de probabilidade descreve como a chance total se reparte entre os resultados possíveis. Ela pode ser discreta ou contínua, e a diferença muda a forma de calcular.
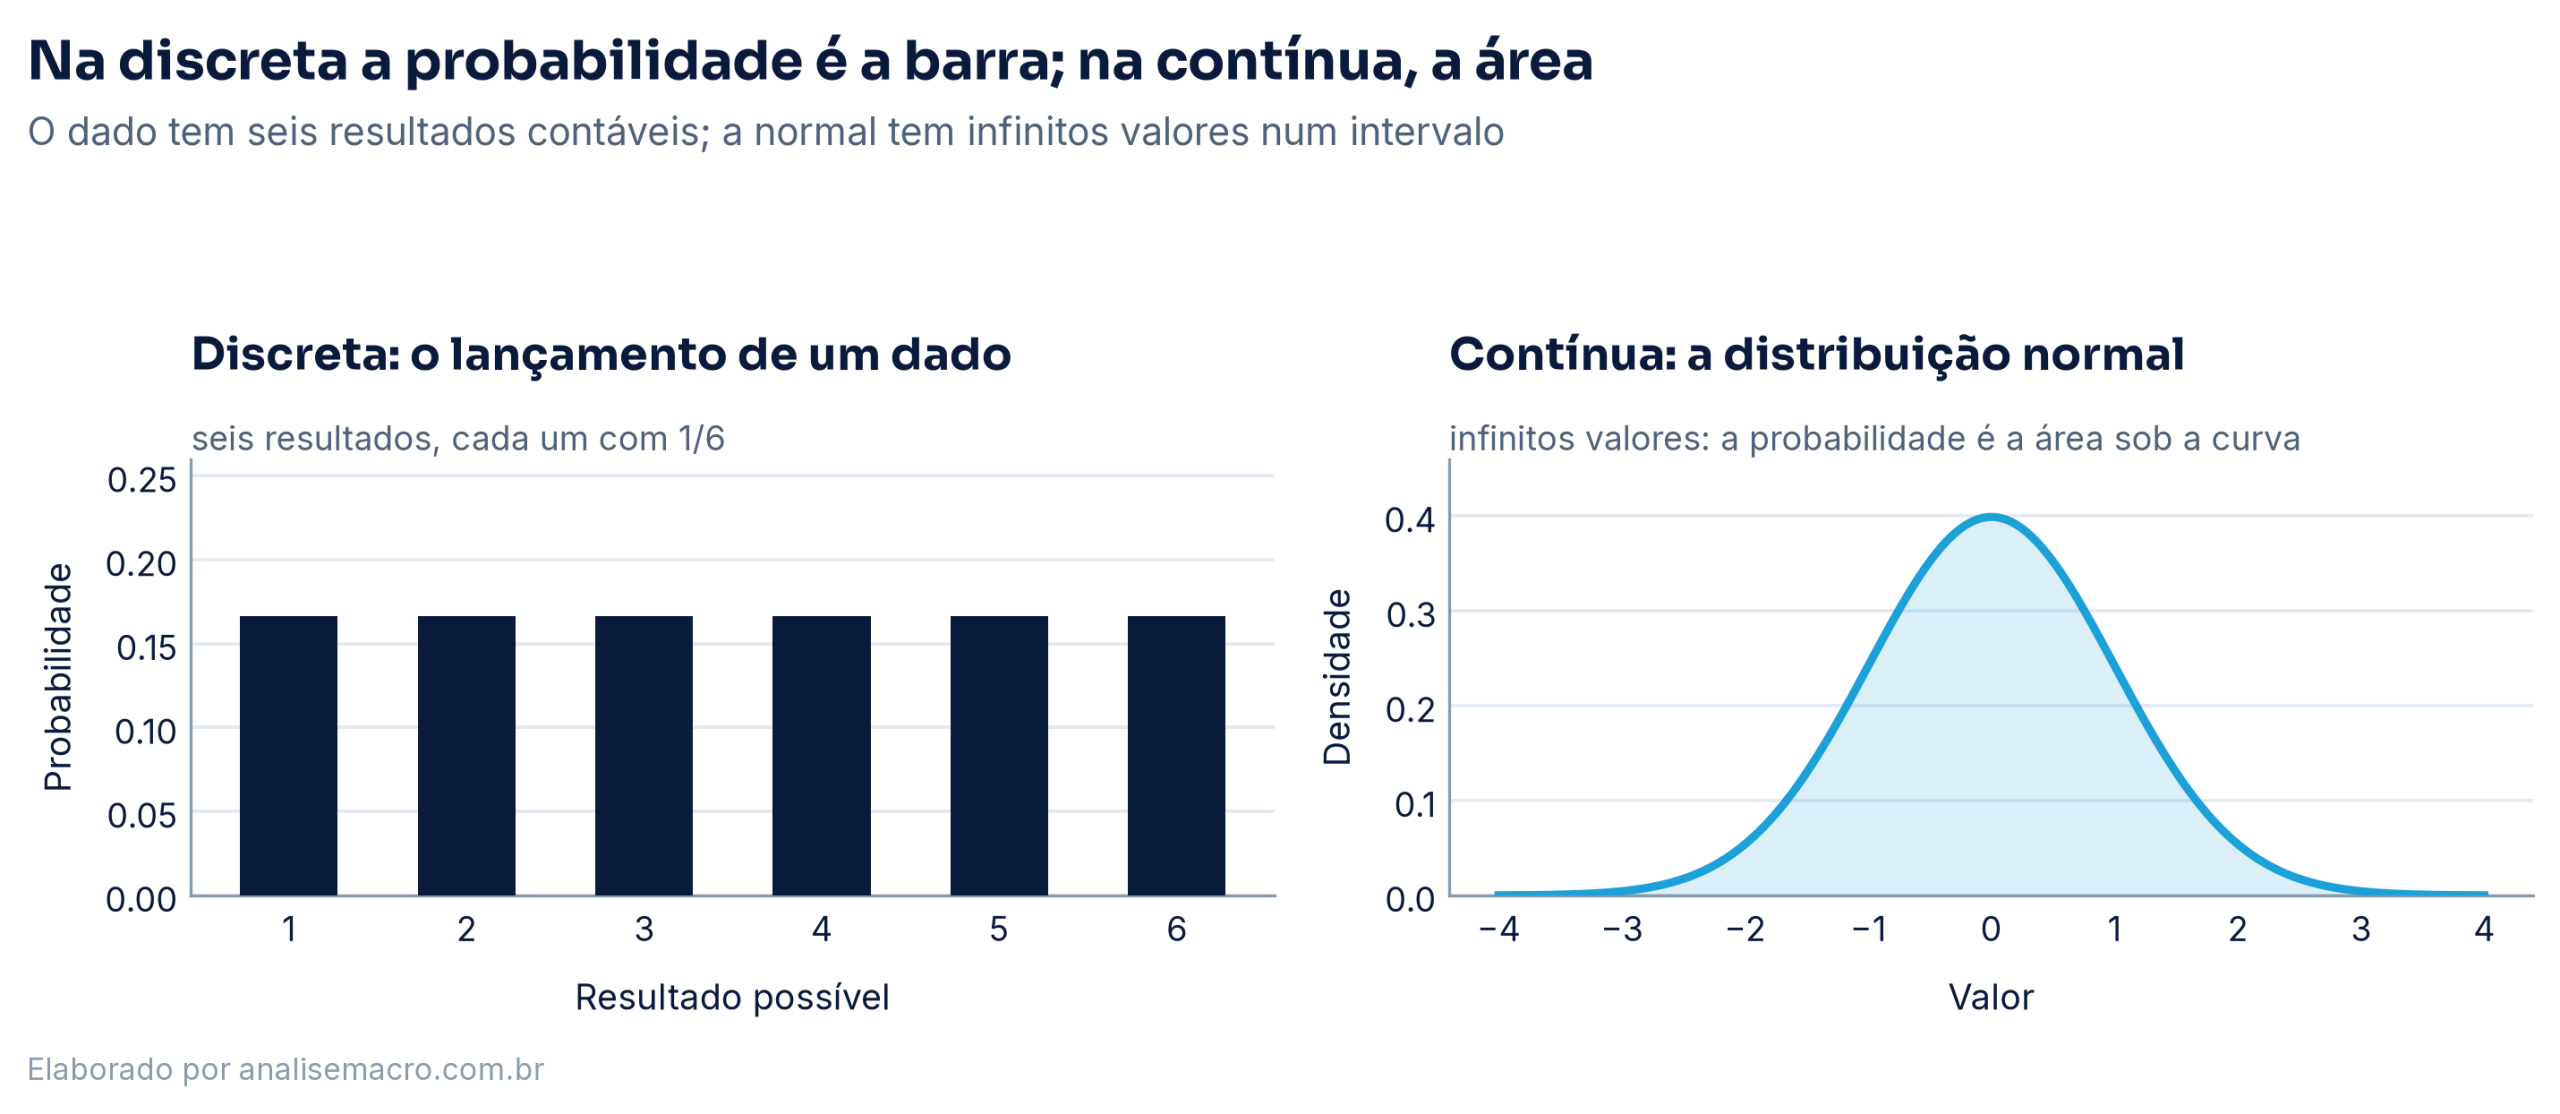
Numa distribuição discreta, os resultados são contáveis e cada um tem sua própria probabilidade. O dado é o exemplo: seis resultados, cada um com 1/6. Para saber a chance de sair 5 ou 6, basta somar: 1/6 + 1/6 = 1/3.
Numa distribuição contínua, a variável assume infinitos valores dentro de um intervalo, e a probabilidade de um valor exato é zero. O que medimos é a área sob a curva num intervalo. A altura da curva indica densidade, ou seja, o quanto a probabilidade se concentra em torno daquele ponto.
A distribuição normal é a contínua mais conhecida, e o R permite verificar suas propriedades por simulação.
set.seed(1234)                   # fixa a semente para reprodutibilidade

amostra_grande <- rnorm(100000)  # sorteia 100 mil valores da normal padrão

mean(amostra_grande)             # a média se aproxima de zero
sd(amostra_grande)               # o desvio padrão se aproxima de um
A média da amostra deu 0,0029 e o desvio padrão 0,9995, contra os valores teóricos de 0 e 1. Com cem mil observações, a simulação praticamente reproduz a distribuição de origem. Se quiser ir adiante, temos um post sobre como identificar a distribuição dos seus dados.
O teorema central do limite
O teorema central do limite é o resultado que conecta tudo o que vimos até aqui. Ele afirma que a distribuição das médias amostrais se aproxima de uma normal conforme o tamanho da amostra cresce, mesmo que a variável original não seja normal.
O dado serve de demonstração justamente porque sua distribuição é plana, o mais distante possível de um sino. Calculamos a média de n lançamentos, repetimos quatro mil vezes e observamos a distribuição dessas médias.
set.seed(1234)                              # fixa a semente para reprodutibilidade

medias_30 <- replicate(                     # repete o experimento muitas vezes
  4000,                                     # quatro mil repetições
  mean(sample(1:6, 30, replace = TRUE))     # em cada uma, a média de 30 lançamentos
)

mean(medias_30)                             # o centro da distribuição das médias
sd(medias_30)                               # a dispersão das médias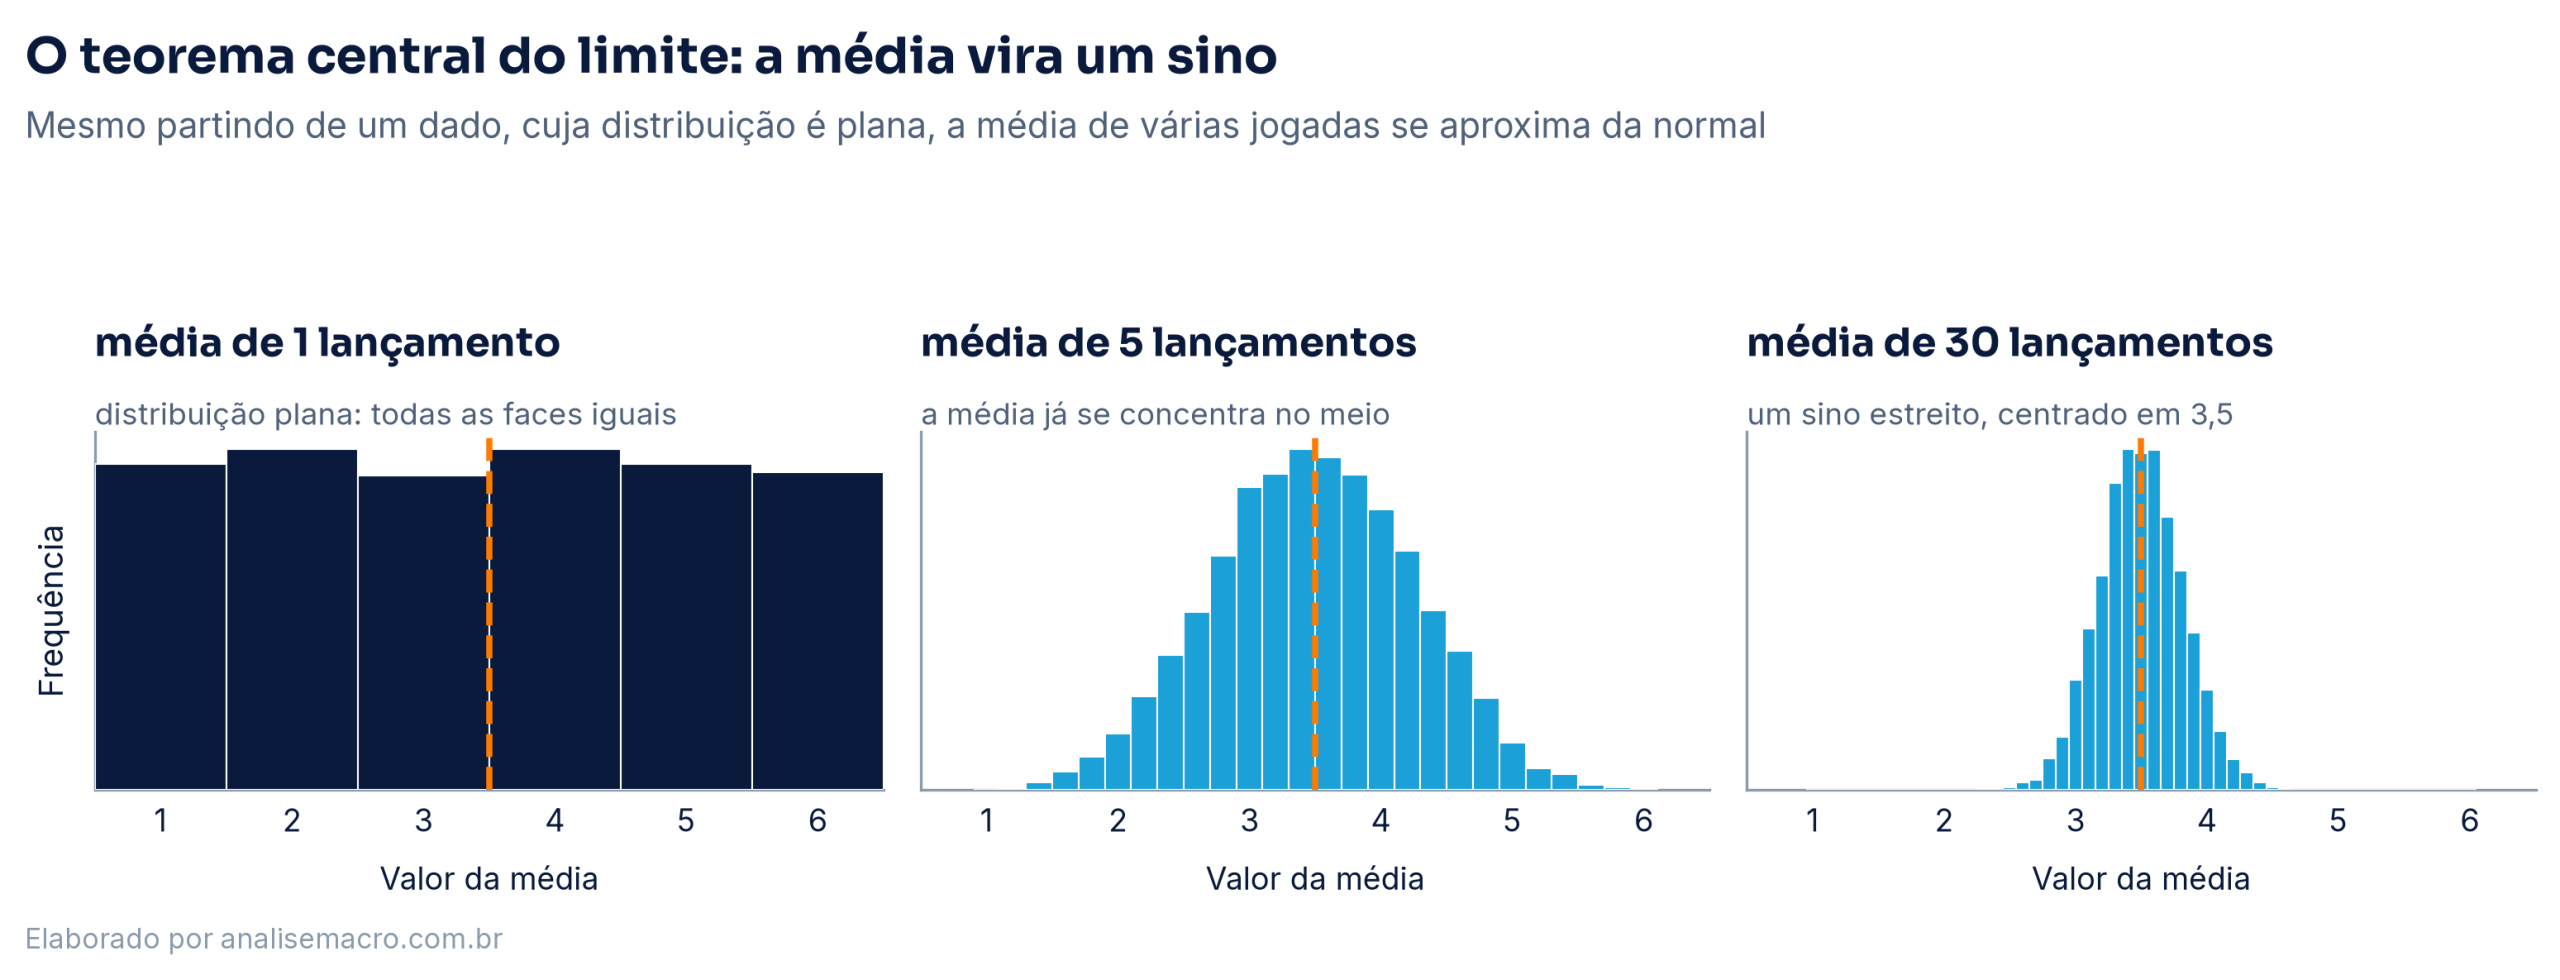
A média das médias deu 3,497, praticamente o valor esperado de um dado, que é 3,5. O desvio padrão caiu para 0,311, bem abaixo do desvio de um lançamento individual.
Com uma jogada, a distribuição das médias é plana, igual à do próprio dado. Com cinco, já se concentra no meio. Com trinta, é um sino estreito, e o formato plano de onde partimos desapareceu.
É daí que vem a utilidade prática: podemos usar a normal para calcular margens de erro sobre médias amostrais sem conhecer a distribuição da população. Esse resultado tem post próprio, com a demonstração detalhada: Teorema Central do Limite: o que é?
Onde a probabilidade entra no dia a dia
Na análise de risco, a probabilidade quantifica a chance de perda além de um limite. O cálculo de Valor em Risco parte da distribuição dos retornos para responder quanto se pode perder num cenário ruim.
Na inferência, ela sustenta toda conclusão tirada de amostra. O intervalo de confiança e o teste de hipóteses são aplicações diretas do que vimos no teorema central do limite.
Na previsão, modelos probabilísticos entregam não um número, mas uma distribuição de cenários possíveis, com a chance associada a cada um. É o que permite dizer que a inflação tem tal probabilidade de ficar acima da meta.
Na simulação, repetimos um experimento aleatório milhares de vezes para responder perguntas que a fórmula fechada não alcança. É o método de Monte Carlo, que usa exatamente a lei dos grandes números que vimos aqui.
Considerações finais
Percorremos o espaço amostral, a diferença entre eventos independentes e dependentes, os dois tipos de distribuição, a lei dos grandes números e o teorema central do limite. Em todos os casos, a simulação em R serviu para ver o conceito funcionando, em vez de apenas aceitá-lo.
Dominar esse raciocínio muda o trabalho de quem lida com dados, de formas diferentes conforme a área:
- Analista de dados: distingue padrão real de flutuação amostral antes de reportar um achado.
- Economista: interpreta corretamente a margem de erro de uma projeção ou de uma pesquisa.
- Profissional de risco: calcula probabilidade de perda sem supor independência onde ela não existe.
- Gestor de investimentos: avalia se um retorno acima do mercado é habilidade ou sorte numa amostra curta.
- Pesquisador: dimensiona a amostra necessária para que a conclusão se sustente.
Da probabilidade à inferência
Entender a aleatoriedade é o primeiro passo; o seguinte é estimar e testar. O AM Black é a assinatura anual que dá acesso a todos os cursos da Análise Macro, em R e em Python, da estatística básica à econometria aplicada.