
Com uma matéria-prima em comum, a mineração de textos e a inteligência artificial generativa usam grandes volumes de dados não estruturados para fins distintos, com aplicações em Economia, Finanças, Marketing e outras áreas. Mas o que é, afinal, mineração de textos, e o que dá para fazer com ela? Quando devemos usar uma técnica e não a outra? Neste artigo apresentamos esses tópicos e mostramos alguns exemplos de aplicação.
Atas do Banco Central, cartas de gestores, notícias e avaliações de clientes carregam informação que não cabe numa planilha, e é justamente essa informação que as técnicas de mineração de textos conseguem extrair e transformar em medida.
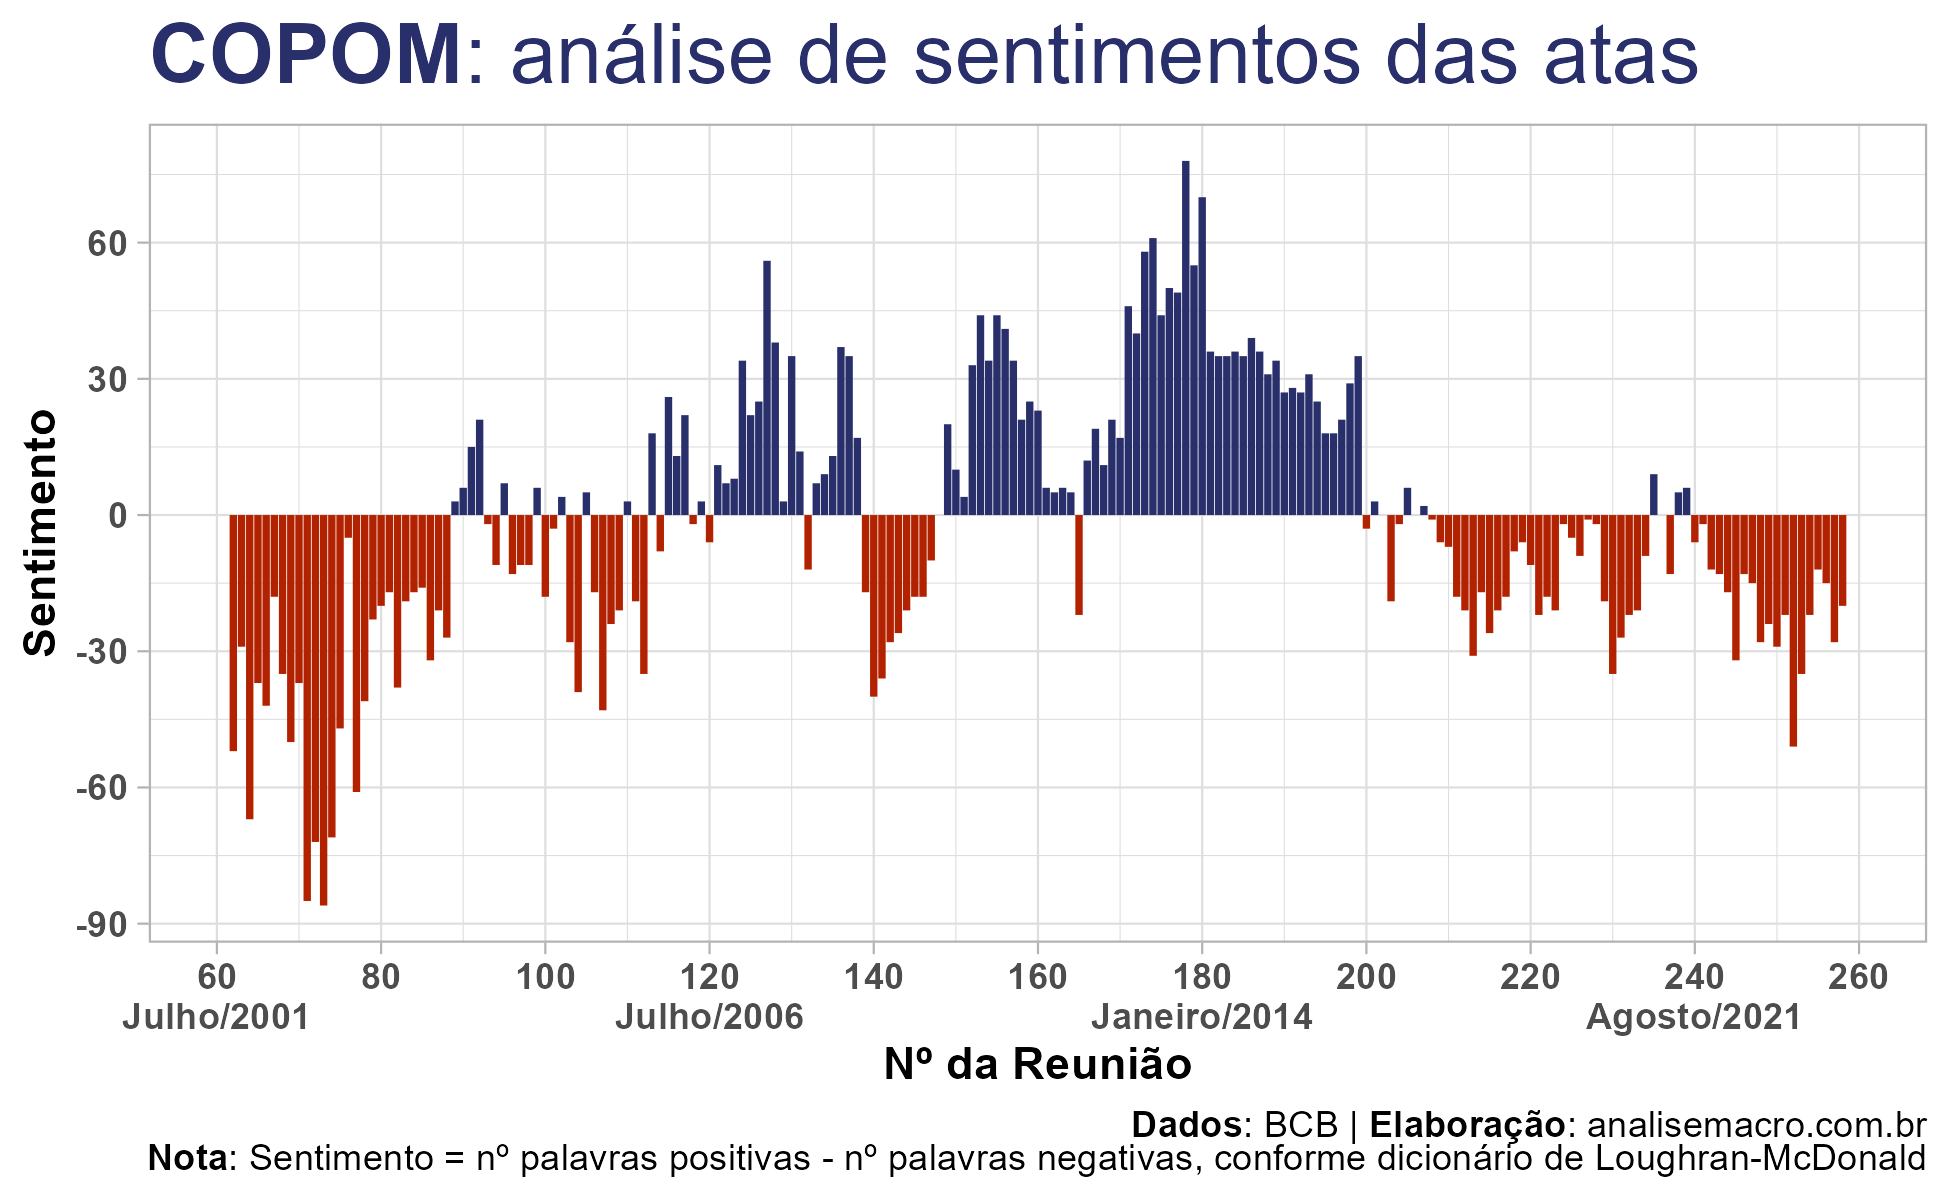
O gráfico acima resume cerca de 260 atas do COPOM em uma série numérica, em que cada barra é uma reunião e a altura vem da contagem de palavras positivas menos as negativas no texto daquela ata. Os períodos em vermelho concentram-se no início dos anos 2000 e voltam a partir de 2015, enquanto o intervalo entre 2009 e 2014 aparece predominantemente em azul.
Nenhum número desse gráfico existia antes de alguém processar os documentos: ele foi construído a partir de arquivos em PDF que, até então, só podiam ser lidos. É isso que a mineração de textos faz.
📬 Estatística, econometria e IA aplicada. Todo dia, no seu e-mail.
O Boletim AM traz modelos estatísticos, econometria e LLMs aplicados a Economia, Finanças e análise de dados, com exemplos em R e Python. Todo domingo, às 20h, uma leitura mais longa que reúne as fontes da semana.
O que é mineração de textos
A mineração de textos, ou text mining, obtém informação qualificada a partir de dados textuais. Marti Hearst, professora na UC Berkeley, define o campo como a descoberta digital de informações novas e até então desconhecidas, extraídas automaticamente de diferentes dados textuais.
O termo cobre um conjunto variado de técnicas que identificam e exploram padrões em documentos escritos. O que elas têm em comum é o ponto de partida: um texto que nenhuma ferramenta estatística consegue processar do jeito que está.
A matéria-prima são os dados textuais em suas várias formas: websites, livros, e-mails, avaliações de produtos, artigos acadêmicos, postagens em redes sociais e documentos oficiais.
Esses dados chegam de forma não estruturada, ou seja, sem linhas e colunas que digam o que é cada coisa. Uma ata do COPOM é um bloco contínuo de parágrafos, enquanto uma planilha de inflação já vem com data, código e valor em campos separados, prontos para qualquer cálculo.
Por isso, antes da análise, o texto precisa ser coletado e processado até virar uma representação que aceite contagem e comparação.
Esse processamento tem etapas próprias: separar o texto em palavras, remover os termos que não carregam conteúdo e reduzir as variações de uma mesma palavra a uma forma única. Tratamos dessas etapas em Introdução a pré-processamento de dados textuais para mineração de textos.
As quatro aplicações principais
Ao coletar, processar e analisar textos de diferentes fontes, conseguimos responder perguntas sobre padrões de consumo, tendências e outros fenômenos sociais. A técnica é usada em Economia, Finanças, Marketing, segurança da informação e Sociologia.
Quatro aplicações concentram a maior parte dos usos:
🗂️
🏷️
📊
✂️
Agrupamento de textos
O agrupamento descobre quais assuntos existem em uma coleção de documentos que ninguém leu. Ele compara os textos entre si e forma grupos com os que tratam do mesmo tema, sem que as categorias tenham sido definidas de antemão.
Os tópicos em alta de uma rede social funcionam assim. Milhões de publicações são comparadas entre si, e os assuntos aparecem porque muitas pessoas escreveram sobre a mesma coisa ao mesmo tempo, não porque alguém cadastrou uma lista de temas.
Medir o quanto dois textos se parecem é o problema central dessa aplicação, e existem índices próprios para isso. Mostramos um deles, aplicado a um caso real de suspeita de plágio, em O que é análise de similaridade e como aplicar no Python?.
Categorização de textos
A categorização aplica a milhares de documentos uma triagem que alguém faria à mão. As categorias já existem e o modelo aprende a reconhecê-las a partir de exemplos que uma pessoa classificou antes.
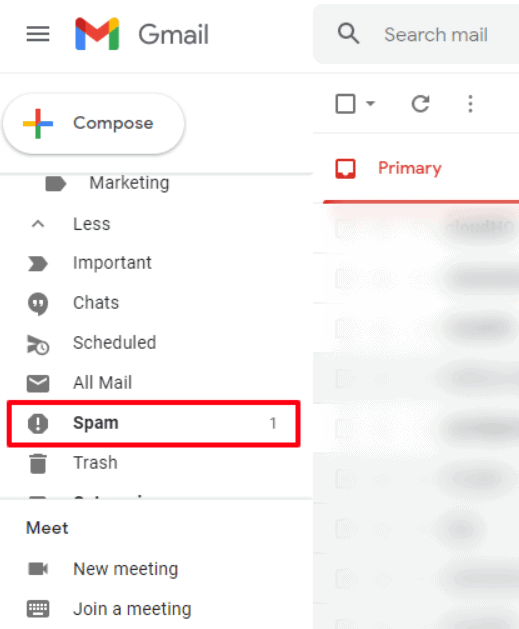
A caixa de spam é o exemplo que todo mundo usa sem perceber. O filtro aprendeu, a partir de mensagens que já foram marcadas como indesejadas, quais palavras e combinações aparecem com mais frequência nelas, e passa a aplicar esse aprendizado em cada mensagem nova.
O algoritmo por trás desse filtro costuma ser o Naive Bayes, um classificador que calcula a probabilidade de um documento pertencer a cada categoria a partir das palavras que ele contém.
Explicamos o método e o aplicamos a um caso de detecção de golpes em Naive Bayes.
Análise de sentimento
A análise de sentimento determina a emoção textual de um documento, em termos de negatividade, neutralidade e positividade, ou ainda em escalas numéricas que permitem comparar documentos entre si.
O indicador do COPOM mostrado no início do post é uma aplicação direta. O cálculo compara as palavras de cada ata com um dicionário de sentimento, uma lista que classifica cada termo como positivo ou negativo.
O dicionário usado ali é o de Loughran-McDonald, construído especificamente para textos financeiros. A diferença entre o número de termos positivos e negativos vira o valor daquela reunião.
Um dicionário de uso geral erraria nesse contexto. Palavras como "passivo", "obrigação" ou "custo" carregam sentido negativo na linguagem comum e são termos neutros em um texto de economia, o que motivou a construção de dicionários específicos para a área.
O passo a passo completo desse indicador, da coleta dos PDFs ao gráfico final, está em O que é e como aplicar análise de sentimentos no Python?.
Sumarização de documentos
A sumarização reduz um documento textual a um resumo com seus pontos principais, preservando o que interessa e descartando o restante.
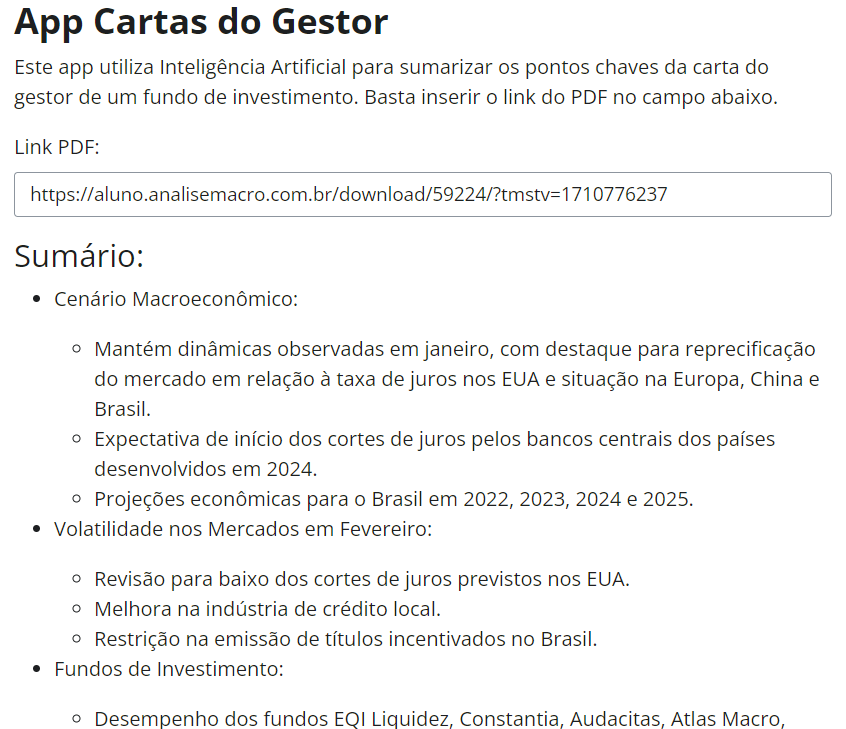
O aplicativo acima recebe o link de uma carta de gestor e devolve os pontos principais separados por tema, de cenário macroeconômico a desempenho dos fundos. Quem acompanha dezenas de fundos lê o resumo antes de decidir quais cartas merecem a leitura integral.
O que é inteligência artificial
Inteligência artificial é a capacidade que as máquinas possuem de fazer coisas que normalmente exigiriam inteligência humana, como compreender informações, resolver problemas e tomar decisões. As tecnologias disponíveis hoje, a exemplo do ChatGPT e do Google Gemini, interpretam textos, resolvem problemas matemáticos e encadeiam etapas de raciocínio até chegar a uma conclusão, de forma similar a um ser humano.
Como a IA generativa se relaciona com a mineração de textos
A inteligência artificial generativa é o ramo da IA que produz textos, imagens e outros formatos a partir de uma instrução escrita, chamada de prompt. Esses modelos são treinados com grandes volumes de dados, boa parte deles não estruturados, para aprender padrões e, a partir deles, gerar conteúdo novo com características semelhantes.
A forma de escrever essa instrução altera bastante o resultado, o que deu origem a um conjunto de práticas próprias. Reunimos as principais em Introdução a Prompt Engineering para Inteligência Artificial.
Os modelos de linguagem de grande porte, conhecidos pela sigla LLM, são a família por trás dessas ferramentas. Detalhamos o funcionamento deles em O que são LLMs?.
As duas abordagens partem da mesma matéria-prima. Em várias tarefas elas competem diretamente, e a classificação de textos é o caso mais claro: tanto um classificador estatístico quanto um modelo generativo conseguem rotular um documento.
Quando usar cada uma
A escolha depende de três fatores: volume, transparência e custo.
| Critério | Mineração de textos | IA generativa |
|---|---|---|
| Como chega ao resultado | Regra explícita: dicionário, contagem, modelo estatístico | Padrões aprendidos durante o treinamento |
| Reprodutibilidade | O mesmo texto devolve sempre o mesmo número | A resposta pode variar entre execuções |
| Auditoria | Dá para apontar quais palavras produziram o resultado | Exige validação contra uma amostra classificada à mão |
| Custo por documento | Processamento local, sem custo por chamada | Cobrança por requisição, quando via API |
| Linguagem específica | Precisa de dicionário ou modelo treinado para a área | Interpreta o contexto sem preparação prévia |
Uma série histórica longa favorece as técnicas de mineração de textos, porque a regra de cálculo permanece a mesma da primeira à última observação e cada leitura fica comparável com as anteriores. Já uma pergunta que exige interpretação de contexto, como distinguir uma ressalva de uma sinalização de política, aproveita melhor um modelo generativo.
As duas abordagens também se combinam: um modelo generativo lê as atas e atribui um rótulo a cada uma, e esse rótulo entra depois em uma série temporal tratada com as ferramentas estatísticas de sempre.
Foi esse caminho que seguimos em Como Construir um Índice de Sentimento do COPOM usando LLMs.
As técnicas de mineração de textos formam uma boa base para aprender IA generativa. Quem entende como um texto vira número reconhece mais rápido o que um modelo de linguagem está fazendo por baixo, e avalia melhor quando a resposta dele merece confiança.
Considerações finais
Com uma matéria-prima em comum, a mineração de textos e a inteligência artificial generativa usam grandes volumes de dados não estruturados para fins distintos. A diferença prática entre elas está na forma como cada uma chega ao resultado: a mineração de textos aplica uma regra explícita, que pode ser auditada e repetida, enquanto o modelo generativo responde a partir de padrões aprendidos no treinamento.
Em Economia e Finanças, o uso mais consolidado das técnicas de mineração de textos é o acompanhamento da comunicação de bancos centrais, porque atas, comunicados e discursos saem em datas conhecidas e seguem estrutura parecida, o que permite medir o que mudou de uma reunião para a seguinte. Na gestão de recursos, cartas de gestores e relatórios de resultados chegam em volume grande demais para a leitura integral, e a sumarização entrega o essencial de cada documento enquanto a análise de sentimento aponta quais merecem atenção completa.
Em previsão macroeconômica, indicadores construídos a partir de texto entram como variáveis explicativas ao lado das séries tradicionais, com a vantagem de ficarem disponíveis antes da divulgação dos dados oficiais. Fora do mercado financeiro, as mesmas técnicas aparecem em avaliações de clientes, chamados de atendimento, respostas abertas de pesquisas e classificação de documentos jurídicos.
Quem quiser percorrer esse caminho encontra uma ordem natural nas etapas do trabalho: primeiro a manipulação de texto na linguagem escolhida, que tratamos em Introdução a dados textuais no Python; depois a coleta, com as bases públicas e as bibliotecas que as acessam, em Onde encontrar dados e ferramentas para text mining?; e então as medidas que identificam as palavras características de um documento, em Técnicas de extração de informação com text mining.
Python reúne todas essas etapas em um só lugar, já que a mesma linguagem baixa os documentos, trata o texto, calcula o indicador e produz o gráfico, e o processo roda de novo a cada nova ata sem retrabalho. O percurso é sempre parecido, e o que muda de uma área para outra é a aplicação:
- Economista: acompanha a comunicação do Banco Central e constrói indicadores antecedentes a partir de notícias e documentos oficiais.
- Analista de investimentos: processa cartas de gestores, relatórios de resultados e transcrições de teleconferências em volume que não caberia na leitura manual.
- Gestor de risco: monitora mudanças de tom em comunicados regulatórios e identifica sinais antes que apareçam nos preços.
- Cientista de dados: aplica as mesmas técnicas a avaliações de clientes, chamados de suporte e respostas abertas de pesquisas.
- Pesquisador: mede fenômenos sem estatística oficial, como incerteza de política econômica, a partir de arquivos de notícias.
Aprender a linguagem é o que abre a porta para todas essas frentes.
Linguagem Econômica: mineração de textos de Bancos Centrais
Os dez capítulos do livro digital percorrem o caminho completo: dos primeiros tratamentos de texto ao indicador de sentimentos do COPOM e à classificação do tom da política monetária com IA generativa. Exercícios aplicados, em Python.
Leia também: